Home
» domini
»
Ollama vs LM Studio: Which Is Better for Local AI Agent Development in 2026?
Ollama vs LM Studio: Which Is Better for Local AI Agent Development in 2026?
The answer changed in 2026. Ollama is no longer just a small command-line model runner, and LM Studio is no longer just a desktop GUI for chatting with local models. Ollama added Anthropic-compatible APIs and a one-command ollama launch workflow for coding tools such as Claude Code, Codex, and OpenCode. LM Studio 0.4.0 introduced llmster for true headless deployment, a stateful REST API, parallel serving, and MCP access through the API. For local AI agent development, both are now serious developer platforms.
Short answer: choose Ollama when you want the shortest path from terminal to local model server, already have your own agent framework, or want easy integration with coding agents and automation scripts. Choose LM Studio when you want built-in model discovery plus a developer server with stateful chats, MCP integrations, first-party Python/TypeScript SDKs, and an automatic multi-round agent API. Neither is universally better; the right choice depends on which layer of the agent stack you want the runtime to manage.
This comparison was checked against current Ollama and LM Studio documentation on September 13, 2026.
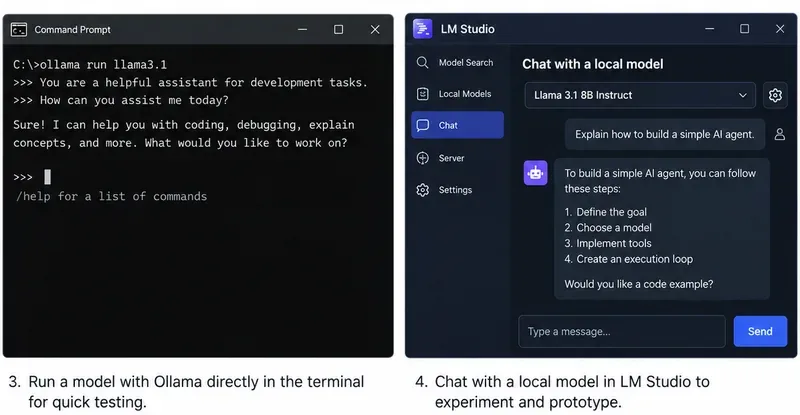
Ollama remains naturally terminal-first, while LM Studio combines a desktop workflow with a full developer server. The image is a workflow illustration rather than a version-specific benchmark.
What changed enough in 2026 to affect the decision?
Two updates narrowed the gap substantially.
First, Ollama added Anthropic Messages API compatibility in January 2026 and then introduced ollama launch, which can configure and start supported coding tools with Ollama models without manually editing environment variables or configuration files. Ollama’s current integrations documentation includes Claude Code, Codex, OpenCode, Copilot CLI, Cline, Roo Code, JetBrains, VS Code, n8n, and other tools. See Ollama’s announcement of ollama launch, Ollama’s Anthropic compatibility documentation, and Ollama integrations.
Second, LM Studio 0.4.0 separated the core runtime from the desktop app through llmster, making headless use on servers and CI a first-class option. Its native v1 REST API now supports stateful conversations, authentication, model download/load/unload operations, and MCP integrations. LM Studio also exposes OpenAI-compatible and Anthropic-compatible endpoints. See LM Studio 0.4.0 release notes and LM Studio v1 REST API documentation.
Practical consequence: “CLI versus GUI” is no longer an adequate comparison. The more useful question is whether you want a lean inference runtime that plugs into an existing agent stack, or a local AI development environment that also provides agent-oriented orchestration features.
Which is easier if you already have an agent framework?
Ollama usually wins for simplicity. Its native API runs at http://localhost:11434, and it also implements OpenAI-compatible and Anthropic-compatible endpoints. If your code already uses an OpenAI client, a framework that accepts a configurable base URL, or a coding tool supported by Ollama, switching the backend can be a small configuration change.
Ollama’s tool-calling API supports single tool calls, parallel tool calls, streaming tool calls, and multi-turn tool-calling loops. The documentation shows an agent loop where your Python or JavaScript code executes the requested function, returns the result to the model, and repeats until the model stops asking for tools. See Ollama tool-calling documentation.
A minimal OpenAI-compatible connection looks like this:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"
)
Best fit: LangChain-style applications, your own Python agent loop, coding assistants, CI jobs, shell automation, or any project where you mainly need a dependable local model endpoint and prefer to own the orchestration logic yourself.
Which is better if you want agent orchestration built into the local stack?
LM Studio has the clearer advantage here. Its Python and TypeScript SDKs include an .act() API specifically designed for multi-round tool use. You give the model a task and tools; the SDK can execute requested tools, pass results back to the model, and continue for additional rounds until the model returns a final response or the process ends.
LM Studio’s documentation describes this as an automatic multi-round tool-calling API and provides hooks for progress, invalid tool requests, and parallel tool execution. The Python SDK can also accept ordinary type-annotated Python functions as tool definitions. See LM Studio .act() documentation.
That does not automatically make an LM Studio agent more capable. Tool-use quality still depends heavily on the model, tool descriptions, context length, and your safety controls. It does reduce the amount of agent-loop plumbing you have to write yourself.
Best fit: prototypes where you want to define Python or TypeScript functions and immediately test autonomous multi-step behavior without bringing in a separate agent framework.
Do you need MCP as a first-class part of the agent architecture?
If Model Context Protocol is central to your project, LM Studio is currently the stronger native choice. LM Studio can act as an MCP host in the app, and its API supports both configured MCP servers and per-request remote MCP servers. Its current v1 REST API and OpenAI-compatible Responses endpoint can expose MCP integrations to calling applications.
For example, LM Studio can define an ephemeral remote MCP server in a request or call MCP servers configured in mcp.json. The server settings include explicit permissions for per-request MCPs and locally configured MCP servers. See LM Studio MCP via API.
Ollama has extensive integrations with agent applications that may themselves support MCP, but Ollama’s current core documentation emphasizes function/tool calling and external integrations rather than presenting Ollama itself as an MCP host equivalent to LM Studio.
Choose LM Studio if: you want your local inference server to be the place where MCP tools are configured and exposed to agent requests.
Choose Ollama if: your higher-level agent application already owns the MCP layer and you only need Ollama to supply inference and tool-call outputs.
Which has the better API surface for stateful agents?
LM Studio currently offers more built-in state management. Its native /api/v1/chat endpoint can store a response and continue the conversation with a previous_response_id. Its OpenAI-compatible Responses API also supports stateful continuation. That can reduce how much conversation history your application has to resend for long-running workflows.
Ollama supports the OpenAI Responses API, but its current compatibility documentation states that only the non-stateful flavor is supported and that previous_response_id and conversation-based state are not supported. Your application can still maintain state by keeping the message history and sending it with later requests.
Recommendation: if server-managed conversational state is important to your architecture, LM Studio has an edge. If you already persist agent memory in your own database, message store, or framework, Ollama’s stateless approach is not a major disadvantage.
Which is better for coding agents such as Claude Code or Codex?
Ollama is especially convenient if your main goal is running existing coding agents. The current quickstart exposes ollama launch shortcuts for supported tools, and Ollama has dedicated integration documentation for Claude Code, Codex, OpenCode, Cline, Roo Code, and others. Its Anthropic-compatible Messages API supports streaming, tools, tool results, vision, and thinking-related fields for supported models.
LM Studio supporta anche Claude Code tramite il suo endpoint compatibile con Anthropic /v1/messagese Codex tramite il suo endpoint Responses compatibile con OpenAI. Nel gennaio 2026, LM Studio 0.4.1 ha aggiunto l'endpoint compatibile con Anthropic specificamente per consentire l'utilizzo di modelli locali con Claude Code.
Bisogno
Migliore impostazione predefinita
Motivo
Configurazione con un solo comando per più agenti di codifica
Ollama
ollama launchè progettato attorno alle integrazioni con agenti supportati.
Claude Code con un backend locale
O
Entrambi espongono API di messaggistica compatibili con Anthropic.
Codex con backend locale
O
Entrambi supportano API compatibili con OpenAI, adatte ai flussi di lavoro di Codex.
Agente più strumenti MCP gestiti dal server locale
LM Studio
MCP è integrato nell'attuale architettura server/API di LM Studio.
Quale metodo è più semplice per trovare, testare e sostituire i modelli?
LM Studio è più adatto all'esplorazione visiva. La sua applicazione desktop include la scoperta di modelli e può cercare modelli supportati da Hugging Face. La sua interfaccia a riga di comando può anche cercare e scaricare modelli con lms get, inclusi i formati GGUF e MLX ove supportati. È possibile scegliere la quantizzazione, ispezionare i modelli locali, stimare i requisiti di memoria prima del caricamento e configurare le impostazioni di caricamento per singolo modello, come la lunghezza del contesto, l'offload GPU e Flash Attention.
Questo è utile quando si testano diversi modelli di agenti di piccole dimensioni e si desidera confrontarli in modo interattivo prima di finalizzarne uno nel codice.
Il flusso di lavoro del modello di Ollama è più orientato e programmabile: si possono usare comandi come ollama pull, ollama list, ollama run, e ollama create. Un Modelfilepuò definire un modello base e impostazioni per varianti riutilizzabili. Questo è comodo per configurazioni in stile infrastruttura-come-codice perché la preparazione del modello può risiedere in script di shell, flussi di lavoro Docker o automazione del deployment.
Raccomandazione: LM Studio per la navigazione e la sperimentazione interattiva; Ollam per un flusso di lavoro di modellazione riproducibile guidato da terminale.
Entrambi possono essere eseguiti in modalità headless su un server o in un ambiente di integrazione continua (CI)?
Sì. In passato Ollama godeva di un vantaggio più evidente in questo senso, ma LM Studio 0.4.0 ha cambiato le carte in tavola.
Ollama è intrinsecamente orientato ai servizi. Su Linux, la guida di installazione ufficiale raccomanda di eseguire Ollama come servizio systemd ed ollama serveespone l'API locale. Offre inoltre supporto per Docker e variabili d'ambiente per il comportamento del server.
LM Studio ora offre llmsterun demone autonomo che non dipende dall'interfaccia grafica. La documentazione attuale lo indica esplicitamente per server Linux, istanze cloud, macchine GPU e CI. Avvialo con lms daemon upe avvia il server API con lms server start.
Raccomandazione: se si desidera la struttura concettuale più semplice, Ollama risulta ancora più efficace. Se invece si desidera un'implementazione headless mantenendo l'API di gestione dei modelli, la chat con stato, l'autenticazione, il supporto MCP e l'ecosistema SDK di LM Studio, quest'ultimo llmsterrappresenta una soluzione pienamente valida.
Non esiste un vincitore universale responsabile. Le prestazioni dipendono dal formato del modello, dalla quantizzazione, dalla lunghezza del contesto, dalla CPU/GPU, dallo stack dei driver, dal batching, dalla pressione della memoria e dalle impostazioni di runtime.
Ollama espone controlli di pianificazione per richieste parallele e modelli caricati, e il suo lavoro su Apple Silicon del 2026 include un motore basato su MLX in anteprima. LM Studio 0.4.0 ha introdotto il batching continuo per le richieste parallele e supporta sia i runtime llama.cpp che MLX su Apple Silicon. LM Studio espone anche controlli di carico espliciti come l'offload GPU, la lunghezza del contesto, Flash Attention e il posizionamento della cache KV per i runtime applicabili.
Azione: eseguire un benchmark con il modello e la dimensione del contesto esatti che il vostro agente utilizzerà. Misurare almeno il tempo di generazione del primo token, i token al secondo, il consumo di memoria e il throughput multi-richiesta. Non scegliere un runtime basandosi su un benchmark generico che utilizza impostazioni di quantizzazione o contesto diverse.
E per quanto riguarda la compatibilità hardware?
Entrambi supportano le principali piattaforme di IA locali, ma i dettagli differiscono. Ollama supporta macOS, Windows e Linux, con opzioni di accelerazione nativa documentate per NVIDIA, AMD, Apple Metal e percorsi sperimentali Vulkan. LM Studio supporta Mac con processori Apple Silicon, sistemi Windows x64/ARM e configurazioni Linux x64/ARM64; i requisiti attuali per macOS non supportano i Mac con processori Intel.
Se si dispone di hardware insolito, verificare l'esatta combinazione di GPU e sistema operativo prima di scegliere uno dei due runtime.
Quale metodo è più sicuro per gli agenti locali: utilizzare strumenti basati su file o strumenti basati su browser?
L'ambiente di runtime per l'inferenza rappresenta solo una parte del perimetro di sicurezza. Una volta che un agente riceve strumenti in grado di scrivere file, eseguire comandi, navigare su siti web autenticati o chiamare API interne, il rischio deriva tanto dalle autorizzazioni degli strumenti quanto dal server del modello.
LM Studio avverte esplicitamente che i server MCP possono eseguire codice arbitrario, accedere a file locali e utilizzare la rete, e fornisce impostazioni del server per l'autenticazione e le autorizzazioni MCP. L'API dello strumento Ollama lascia l'esecuzione delle funzioni alla tua applicazione, il che ti offre il controllo diretto su ciò che ogni funzione è autorizzata a fare.
Raccomandazione: utilizzare schemi di strumenti ristretti, convalidare gli argomenti, separare gli strumenti di sola lettura da quelli distruttivi, richiedere una conferma per le azioni ad alto impatto e non esporre un'API del modello locale o un server MCP a una rete non attendibile senza adeguati controlli di accesso.
Quale dovrebbe scegliere uno sviluppatore Python?
Scegli Ollama se la tua applicazione Python dispone già di un ciclo di agenti o utilizza un framework in grado di interagire con API compatibili con OpenAI. L'SDK Python può anche accettare direttamente funzioni Python come strumenti, in modo che il flusso di lavoro di base per la chiamata degli strumenti rimanga compatto.
Scegli LM Studio se desideri che l'SDK del runtime gestisca l'esecuzione di strumenti in più fasi. L' lmstudio-pythonSDK include caricamento/scaricamento del modello, embedding, risposte strutturate, flussi agentici e definizioni degli strumenti, tutto nello stesso pacchetto.
Una regola utile è:
La tua orchestrazione: Ollama è solitamente più pulita.
Se desideri utilizzare gli strumenti di orchestrazione dell'SDK di runtime, LM Studio è generalmente più produttivo.
Quale scegliere per il tuo primo progetto come agente locale?
La tua situazione
Punto di partenza consigliato
Desideri un'API locale attiva in pochi minuti e preferisci i flussi di lavoro da terminale.
Ollama
Vuoi sfogliare i modelli visivamente prima di sceglierne uno
LM Studio
Utilizzi già LangChain, LlamaIndex, un tuo ciclo personalizzato o un altro livello di orchestrazione.
Ollama
Desideri utilizzare gli strumenti MCP direttamente nel flusso di lavoro del server/API locale.
LM Studio
Desideri un helper per agenti multi-round di prima parte in Python/TypeScript
LM Studio
Principalmente ti servono integrazioni con Claude Code, Codex, OpenCode o simili agenti di programmazione.
Ollama, con LM Studio anch'esso valido
È necessario eseguire i test dell'interfaccia grafica in locale, ma in seguito sarà possibile utilizzare il servizio headless.
LM Studio
Preferisci un servizio minimale, facile da programmare e implementare.
Ollama
In conclusione
Ollama è la scelta migliore per gli sviluppatori che desiderano un runtime minimale, incentrato sul terminale, che si integri con un ecosistema di agenti esistente. Le sue API, le chiamate di funzione, la compatibilità con OpenAI/Anthropic e le integrazioni con 2026 agenti di codifica lo rendono particolarmente conveniente quando l'applicazione o il framework esterno gestiscono già memoria, MCP, pianificazione, tentativi ed esecuzione degli strumenti.
LM Studio è la scelta migliore quando si desidera avere a disposizione più funzionalità dello stack di sviluppo di agenti in un unico ambiente locale. Il suo demone headless 2026 ha eliminato il vecchio limite dell'interfaccia grafica, mentre l'API REST con stato, il supporto MCP, gli endpoint per la gestione dei modelli, la compatibilità con OpenAI/Anthropic e .act()l'SDK offrono un netto vantaggio agli sviluppatori che desiderano un'orchestrazione integrata e una sperimentazione interattiva dei modelli.
Se hai ancora dei dubbi, la scelta pratica è semplice: prototipa la stessa attività di chiamata degli strumenti su entrambi i sistemi utilizzando lo stesso modello e la stessa quantizzazione. Se il framework dell'agente fa già tutto ciò di cui hai bisogno, mantieni il runtime più semplice di Ollama. Se invece ti trovi a dover costruire da zero la gestione dello stato, l'infrastruttura MCP, i controlli di gestione del modello e i cicli di strumenti multi-rotazione, LM Studio potrebbe farti risparmiare più tempo di progettazione.