Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
自動請求書処理エージェントは、最初から大規模な自律型AIシステムである必要はありません。最初の実用的なバージョンとしては、請求書を受け取り、適切なドキュメントとAIツールを呼び出し、結果を検証し、人間によるレビューが必要かどうかを判断し、承認されたデータのみを保存またはエクスポートする、制御されたソフトウェアワークフローとして考えてください。
その区別は財務において重要です。言語モデルは、乱雑な請求書レイアウトを構造化されたフィールドに変換するのに役立ちますが、請求書が有効か、安全に記帳できるかを判断する唯一の要素であってはなりません。このガイドの初心者向けの設計では、抽出は確率的に、重要な会計チェックは決定論的に行われます。
最終的には、PDFまたは画像形式の請求書を受け付け、仕入先、請求書番号、日付、通貨、合計金額、明細項目などのフィールドを抽出し、それらのフィールドをルールに基づいて検証し、疑わしい文書をレビューに回し、監査証跡を保存し、APIを通じてプロセスを公開するローカルプロトタイプが完成します。
知っておくべき用語が4つあります。
2026年9月現在、これらのレイヤーをカバーする複数のオープンソースプロジェクトが活発にメンテナンスされています。DoclingはPDF、画像、オフィス文書、その他の文書形式をサポートし、PaddleOCRはOCRと文書理解パイプラインを提供し、Apache 2.0ライセンスでリリースされています。また、Tesseractプロジェクトは、公式のTesseractマニュアルで、現在の5.x系をオープンソースOCRエンジンとして文書化しています。
ローカルモデル推論に関しては、llama.cppのサーバードキュメントにOpenAI互換のエンドポイントとスキーマ制約付きJSON出力について記載されています。これにより、ローカルでホストされているモデルに制約のない文章ではなく定義済みのオブジェクトを返すように要求できるため、抽出サービスに便利です。
ライセンスに関する重要な注意点が1つあります。オープンソースの推論エンジンだからといって、すべてのモデルの重みが自動的にオープンソースになるわけではありません。特に商用利用の場合は、デプロイするモデルのチェックポイントごとにライセンスを確認してください。
| 層 | 実用的な選択 | なぜここにあるのか |
|---|---|---|
| 文書変換 | ドクリング | PDFファイルや画像を、構造化された文書形式とエクスポート可能なテキストに変換します。 |
| OCRフォールバック | PaddleOCRまたはTesseract | 請求書がスキャン画像や写真で、テキスト抽出にOCRが必要な場合に便利です。 |
| ローカルAI抽出 | llama.cpp + 適切な命令モデル | 請求書の可変テキストを安定したJSONスキーマにマッピングしつつ、推論処理をローカルに維持します。 |
| スキーマ検証 | ピダンティック | 宣言されたフィールド型と制約に対して、Pythonデータを検証します。 |
| API | FastAPI | 請求書のアップロードを受け付け、処理結果を返します。 |
| ストレージ | プロトタイプにはSQLite、共有サービスにはPostgreSQLを使用 | 正規化されたデータ、レビュー状況、ソースファイル識別情報、および監査イベントを保存します。 |
| オーケストレーション | まずはプレーンなPython、LangGraphは後からオプションで。 | 決定論的な関数はデバッグが容易です。分岐や人間によるレビューが複雑になる場合は、ステートフルなエージェントフレームワークを追加してください。 |
Pydantic の公式ドキュメントでは、モデルは を継承しBaseModel、受信データを検証し、 を介して JSON スキーマを出力できることが説明されていますmodel_json_schema()。Pydanticモデルの検証を参照してください。後で永続的で状態のある分岐が必要になった場合は、LangGraph のリファレンスで、長時間実行される状態のあるエージェント、永続性、およびヒューマン・イン・ザ・ループのワークフローのサポートについて説明されています。
「買掛金の自動化」から始めないでください。まずは、1つの文書クラスと1つの出力契約から始めましょう。優れたMVP(最小実行可能製品)は、英語の仕入先請求書、PDFまたは画像入力、1つの法人、1つの通貨セット、そして自動支払実行なし、といったものです。
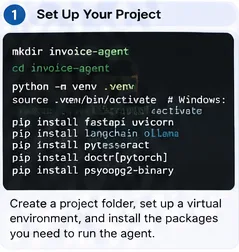
mkdir invoice-agent
cd invoice-agent
python -m venv .venv

# Linux/macOS
source .venv/bin/activate

pip install docling pydantic fastapi uvicorn httpx python-multipartOCRエンジンが必要な場合は、別途インストールしてください。Doclingの最新インストールガイドではpip install docling、基本OCRパッケージとオプションのドキュメント解析および情報抽出依存関係グループを区別して説明しています。古い依存関係リストをコピーするのではなく、DoclingのインストールガイドまたはPaddleOCR 3.xのインストールガイドを参照してください。
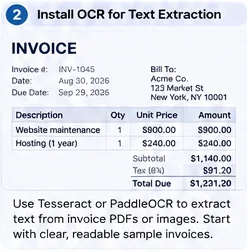
デジタルネイティブのPDFファイルには、既に使用可能なテキストが含まれている場合があります。スキャンされたPDFファイルや写真はOCR処理が必要です。パーサーは、この違いをパイプラインの他の部分から隠蔽する必要があります。後続の段階では、正規化されたドキュメントテキストに加え、有用なレイアウト情報や表情報を受け取るようにします。
Doclingの最小限の変換例は次のようになります。
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
return result.document.export_to_markdown()Doclingの公式クイックスタートガイドでは、変換してからエクスポートするという同じ手順が採用されています。OCR処理を多用するコレクションの場合は、PaddleOCRまたはTesseractをスキャンしたデータでテストしてください。PaddleOCRのプロジェクトドキュメントでは、文書解析には最新のPP-StructureV3ファミリーを推奨していますが、Tesseractは印刷テキストのOCR処理にコマンドラインまたはAPIから呼び出すことができます。
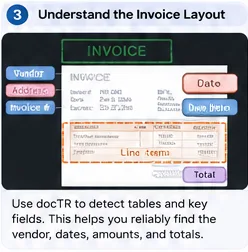
抽出スキーマは、AIと会計ロジック間の契約です。「請求書に記載される可能性のあるあらゆる項目」を網羅するような巨大なスキーマは避けましょう。検証可能なフィールドから始めるのが賢明です。
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
line_items: list[LineItem] = []extra="forbid"この文脈では、予期しないLLMフィールドが会計記録に紛れ込んでしまうことを防ぐために、この機能が役立ちます。また、Pydanticの検証は構造と型を確認するものであり、抽出された仕入先や金額が請求書画像と一致することを証明するものではないことに注意してください。
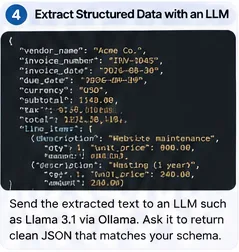
llama.cppのHTTPサーバーの背後で、適切な命令モデルを実行してください。モデルの正確なサイズは、ハードウェアと請求書の複雑さによって異なります。モデルが大きいほど必ずしも優れているとは限らないため、ご自身の請求書セットでフィールド精度、レイテンシ、メモリ使用量をベンチマークしてください。
llama.cpp は現在、スキーマ制約付き JSON レスポンスをサポートしています。Pydantic からスキーマを取得し、抽出リクエストとともに送信できます。
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
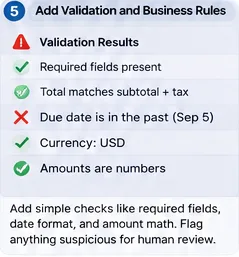
スキーマ制約付き生成は有効な構造の確保に役立ちますが、意味的な正しさを保証するものではありません。完全に有効なJSONオブジェクトであっても、合計金額が間違っている可能性があります。そのため、次のステップは必須となります。
LLM(法務修士)に「自信はありますか?」と尋ねて、その答えを鵜呑みにしてはいけません。自己申告によるモデルの自信は、検証済みのコントロールではありません。抽出したデータとシステムから再計算できる検証方法を構築してください。
役立つ最初のルールは次のとおりです。
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

return errorsチェックに失敗したすべての項目をレビューキューに振り分けます。初回導入時には、抽出品質を測定しながらすべての請求書をレビューキューに振り分けるのが妥当です。自動化のしきい値は、他のシステムからコピーした一般的なパーセンテージではなく、自社でラベル付けした請求書から収集した証拠に基づいて設定する必要があります。
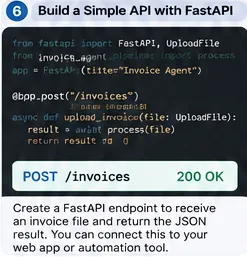
API を使用すると、アップロードフォーム、メールワーカー、共有フォルダ監視ツール、または会計統合ツールから同じ処理関数を呼び出すことができます。FastAPI の公式ファイルアップロードガイドでは、UploadFileアップロードされたファイルに対して、大きなファイルをすべてメモリに読み込むよりも適したスプールファイルを使用することを推奨しています。
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
return resultサポートされているアップロードパターンについては、最新のFastAPIリクエストファイルに関するドキュメントを参照してください。本番環境では、ファイルサイズ制限、必要に応じたマルウェアスキャン、認証済み呼び出し元、リクエストID、および安全な一時ファイルのクリーンアップも適用してください。
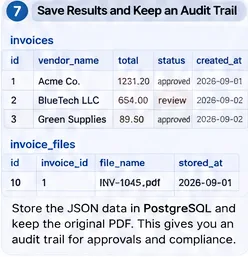
最終的なJSONだけを保存してはいけません。何が起こったのかを再現できるだけの十分な証拠を保持してください。具体的には、元のファイルID、ハッシュ値、パーサーバージョン、モデル識別子、プロンプトバージョン、抽出されたJSON、検証結果、レビュー結果、タイムスタンプ、変更を承認したユーザーまたはサービスなどです。
シンプルなプロトタイプであればSQLiteを使用できます。マルチユーザーサービスであれば、一意性制約と外部キー制約を備えたPostgreSQLを使用できます。PostgreSQLの最新ドキュメントにはテーブル制約に関する記述があり、これはAIパイプラインとは独立してキーとリレーションシップを保護するのに役立ちます。
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
ソースハッシュは、誤って再送信されたファイルを検出する2つ目の手段となります。請求書には住所、銀行口座情報、納税者番号、その他の機密性の高いビジネスデータが含まれていることが多いため、ファイル保存権限は一般的なアプリケーションログよりも厳しく設定してください。
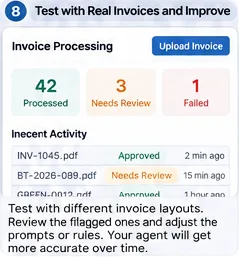
5つのクリーンなPDFファイルで動作するプロトタイプは、製品版として使用できる状態ではありません。実際に受け取る入力データ(異なるベンダー、スキャン画像、回転したページ、小さなフォント、複数ページの請求書、割引、マイナスの行、税金、送料、複数の通貨、発注書の欠落、重複提出など)を反映した、ラベル付きの評価セットを作成してください。
フィールドレベルの指標は個別に追跡してください。「請求書の正確性」という指標は、ベンダー名は簡単に特定できるものの、明細項目の数量は信頼性に欠けるという事実を覆い隠してしまう可能性があります。最低限、以下の項目を測定してください。
失敗した箇所はテストケースとして保存してください。パーサールール、プロンプト、スキーマ、またはモデルを修正するたびに、評価セット全体を再実行してください。これにより、あるベンダーの改善が別のベンダーのレイアウトを意図せず壊してしまうことを防ぎます。
状態遷移機械は明示的に記述してください。「エージェント」は最初は単純なPython関数で構いません。
def process_invoice(path: str) -> dict:
    text = parse_document(path)
    invoice = extract_invoice(text)
    errors = validate_business_rules(invoice)

    if errors:
        status = "needs_review"
    else:
        status = "validated"

    record_id = save_invoice(
        source_path=path,
        invoice=invoice,
        validation_errors=errors,
        status=status,
    )

    return {
        "id": record_id,
        "status": status,
        "invoice": invoice.model_dump(mode="json"),
        "validation_errors": errors,
    }
これは既にエージェントのような働きをします。なぜなら、ツールを調整し、分岐を選択するからです。すべての次のステップを選択するためにLLMは必要ありません。永続的な複数段階のレビュー、再試行、非同期コールバック、または実行順序がケースによって変わる複数の特殊ツールが必要な場合は、LangGraphなどのオーケストレーションフレームワークを追加してください。
モデルはデータを抽出して正規化し、コードと信頼できるシステムデータで検証を行う必要があります。算術演算、重複チェック、ベンダーステータス、発注書の照合、承認限度額などは、決定論的ロジックで処理されます。
元の請求書、またはそれへの参照情報を保管してください。レビュー担当者は証拠を必要としており、モデルやパーサーのアップグレード後に発生した不具合を再現できる手段が必要です。
処理済みの請求書ごとに、プロンプトのバージョンとモデル識別子を保存してください。そうしないと、数か月間隔で処理された2つの請求書の動作が異なる理由を説明できません。
JSONの妥当性は請求書の妥当性とは異なります。まずは人間によるレビューを行い、評価の結果、許容できるパフォーマンスが確認された後、リスクの低いケースのみ自動化を進めてください。
ライブラリとモデルの重みには、それぞれ異なるライセンスが適用される場合があります。PaddleOCRとTesseractはオープンソースライセンスを公開していますが、llama.cppで実行するモデルのライセンスは、その特定のチェックポイントによって異なります。デプロイ前に必ず確認してください。
洗練されたダッシュボードでは、金額の誤りを補うことはできません。まずは文書解析、スキーマ抽出、検証のテストを行い、レビュー担当者が実際に何を見る必要があるかを把握してから、レビューインターフェースを追加してください。
| アプローチ | 最適なフィット感 | 主な制限事項 |
|---|---|---|
| OCR + ルール | 非常に安定したベンダーテンプレートが少数存在する。 | レイアウトが変化すると、ルールは脆弱になる。 |
| 文書レイアウトモデル | 位置が重要なテーブル、フォーム、フィールド | 作業内容に応じたトレーニングや後処理が必要になる場合があります。 |
| OCR/文書解析器 + ローカルLLM | 共通のターゲットスキーマを持つ多数の請求書フォーマット | 制約と検証が必要であり、推論にはより多くの計算コストがかかる。 |
| 視覚言語モデル | テキストとビジュアルレイアウトが密接に結びついた複雑な文書 | より高いハードウェア要件と、評価の複雑さの増加。 |
Hugging Faceの最新のLayoutLMv3ドキュメントでは、テキストと視覚的なレイアウト情報を組み合わせたドキュメントAIモデルについて説明しています。PaddleOCRのPP-StructureV3ドキュメントも同様に、レイアウト、表、構造化ドキュメント分析に焦点を当てています。これらは、プレーンテキストとLLMだけでは不十分な場合の選択肢となります。
段階的に進めてください。まず、ラベル付き請求書のフォルダでローカル環境で実行します。次に、APIと永続ストレージを追加します。3番目に、人間によるレビューキューを導入します。4番目に、仕入先マスタや発注書などの読み取り専用ルックアップを統合します。5番目に、会計ステージングエリアへの制御されたエクスポートを許可します。監視によって制御が有効であることが確認された後にのみ、厳密に定義された低リスクのケースについて自動転記を検討してください。
あらゆる段階で、次の3つのものを保持してください。証拠(元の文書と抽出されたソース)、決定性(再実行可能なビジネスルール)、およびトレーサビリティ(どのパーサー、モデル、プロンプト、およびレビュー担当者が最終レコードを生成したか)。
これらの制御が適切に実施されていれば、単なるOCRデモ以上のもの、つまり信頼性の高い請求書処理エージェントの基盤が構築されます。オープンソースのコンポーネントは時間の経過とともに変化する可能性がありますが、アーキテクチャは永続的です。証拠を解析し、スキーマに抽出し、コードで検証し、不確実な情報を担当者にルーティングし、すべての決定を記録します。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








