Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
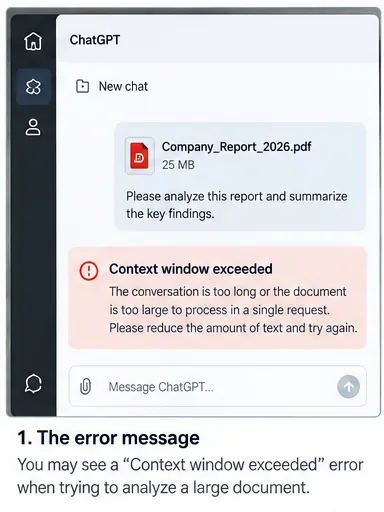
長文のレポートをアップロードして詳細な分析を依頼しても、回答の代わりに「コンテキストウィンドウを超えました」「コンテキストの最大長を超えました」といったメッセージや、リクエストが大きすぎるという警告が表示されることがあります。さらに厄介なのは、ファイル自体は正常にアップロードされている可能性があり、同じドキュメントでももっと絞り込んだ質問であれば問題なく処理できたかもしれないということです。
理由は単純だが見落としやすい。アップロード制限とモデルのコンテキストウィンドウは同じものではない。モデルは、現在検討している資料を限られたトークン予算内に収める必要がある。その予算には、指示、会話履歴、ファイルから取得したテキスト、ツール定義、取得した文章、推論トークン、そして回答のためのスペースが含まれる。したがって、ドキュメントはアップロードが許可されていても、一度に分析するには大きすぎる場合がある。
最善の解決策は、同じ巨大なプロンプトを何度も再試行しないことです。まずは影響の少ない変更から始め、それでも解決しない場合にのみ、チャンキング、データ取得、またはより大規模なコンテキストのワークフローへと移行してください。
ドキュメントを変更する前に、コンテキストエラーとアップロードまたはストレージの制限を区別してください。OpenAIの現在のファイルアップロードに関するガイドラインでは、ChatGPTまたはGPTにアップロードされるファイルは1ファイルあたり512MBの厳密な制限があり、テキストファイルとドキュメントファイルは1ファイルあたり200万トークンに制限されています。これらはアップロード制限であり、すべてのテキストが一度にモデルのアクティブコンテキストに配置されるという保証ではありません。
OpenAIのファイルアップロードに関するFAQは、現在のアップロード制限を確認するための信頼できる情報源です。正確な制限は製品、プラン、モデル、プロバイダーによって異なるため、古い記事からコピーした数値が現在も適用されるとは限りません。
| あなたが見るもの | ボトルネックになりそうなもの | 最良の最初の行動 |
|---|---|---|
| 分析開始前にファイルが拒否されました | ファイルサイズ、ファイルタイプ、ストレージ容量、またはアップロード制限 | 現在のアップロードルールを確認してください |
| ファイルはアップロードされるが、長いプロンプトがコンテキストエラーで失敗する | アクティブなリクエストがモデルのコンテキスト予算を超えています | リクエストを短縮し、アクティブなコンテキストを削減する |
| 回答は最初のページはカバーしているが、後の部分はカバーしていない。 | すべての資料が直接文脈に沿って配置されたわけではなく、検索時に関連する箇所が見落とされた。 | より具体的な質問をするか、セクションごとに分割してください。 |
| 会話は以前はうまくいっていたが、何度もやり取りを重ねた末に失敗に終わった。 | 蓄積されたチャット履歴はコンテキストを消費しています | 簡潔な引き継ぎ概要から新しい分析スレッドを開始します |
ページ数やメガバイト数は有用な手がかりとなりますが、テキストの文脈を理解する上で重要なのはトークン数です。トークン化は言語、書式設定、句読点、そしてモデルのエンコーディングに依存するため、100ページの技術マニュアルと100ページのスライド資料では、消費されるトークン数が大きく異なる場合があります。
OpenAIのトークンカウントに関するガイダンスでは、対象モデルのコンテキストウィンドウを確認し、出力のためのスペース、そして推論モデルの場合は推論トークンのためのスペースを確保することを推奨しています。また、メッセージ構造、ツール、ファイル、画像、スキーマによって、カウント対象のプレーンテキスト以外にもトークンが追加される可能性があることも指摘しています。
迅速なトリアージのために、ファイルのページ数、おおよその単語数、主要なセクションの数、およびタスクに実際には必要のない付録、繰り返し出てくる法律用語、生ログ、トランスクリプト、表、または参考文献が含まれているかどうかを記録してください。

文書のサイズが極端に大きくない場合は、ファイルを分割するよりも、蓄積されたコンテキストを削除する方が費用対効果が高い場合があります。新しいチャットまたはリクエストを開始し、重要な指示のみを引き継ぎます。長々とやり取りする代わりに、「添付のレポートを分析し、収益の要因、重要なリスク、および経営上の指針を特定してください。ページまたはセクションの参照を添えて、5つの調査結果を返してください。」といった短い指示で済ませましょう。
また、重複する背景情報、不要になった例、重複して貼り付けられたテキスト、以前のドラフト出力なども削除してください。APIワークフローを使用している場合は、ドキュメント単体ではなく、リクエスト全体をカウントしてください。ギリギリ収まるリクエストでは、回答のためのスペースがほとんどなく、指示やツールのスキーマが大きくなるにつれて予期せぬエラーが発生する可能性があります。
成功の兆候:同じファイルが、フォーカスされたプロンプトを備えた新しいスレッドで正常に動作する。もしそうであれば、問題は少なくとも部分的には蓄積されたコンテキストにあり、ドキュメント自体に問題があったわけではない。
「この400ページの文書のすべてを分析し、包括的なレポートを作成せよ」という指示は、システムに一度に多くの項目を検討させることになります。代わりに、一度に1つの質問をしてください。例えば、まず文書の主なリスクを尋ね、次に財務上の前提条件を尋ね、最後に経営陣の主張と裏付けとなるデータとの矛盾点を尋ねる、といった具合です。
回答の形式は簡潔にまとめてください。20ページにわたる出力は、10行の証拠表の要求よりもはるかに多くの出力予算を消費します。証拠が収集された後であれば、最終的な回答を拡張することはいつでも可能です。
効果的な焦点を絞った指示としては、「この文書のみを使用して、顧客離脱に関連する主張を最大8つ特定してください。それぞれの主張について、該当箇所またはページ番号、1文の説明、および記載されている制限事項を明記してください。文書に十分な証拠が含まれていない場合は、その旨を述べてください。」というものがあります。
次に進むべきタイミング:焦点を絞った質問でも同じエラーが発生する場合、または1つのトピックではなくドキュメント全体を確実にカバーする必要がある場合は、ソースを分割します。
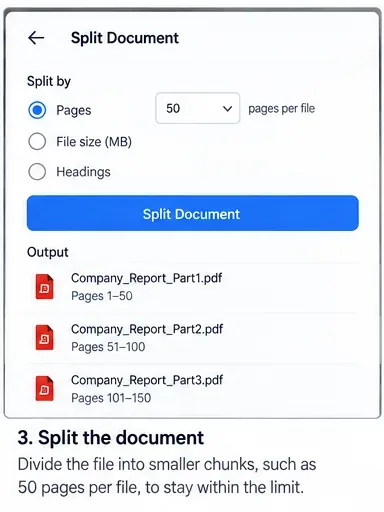
チャンキングは、非常に長い文書を処理するための最も信頼性の高い汎用的な解決策です。章、レポートのセクション、契約書、付録、日付範囲、話者の交代など、自然な境界でファイルを分割します。論理的なチャンクは、50ページごとに恣意的に分割するよりも、文脈をより良く保持します。
あるセクションが前のセクションに大きく依存している場合は、前のセクションを説明する短い補足説明やブリッジノートを少し追加してください。各セクションには、例えば、、、、といったように明確な名前を付けてください01_Executive_Summary.pdf。02_Financial_Results.pdf最終03_Risk_Factors.pdf的な要約を検証できるように、可能な限り元のページ番号を保持してください。
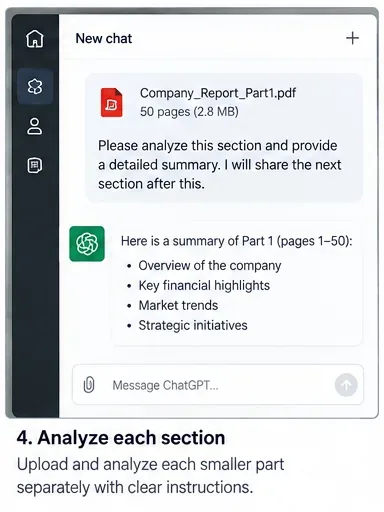
各部分について自由形式の要約を求めるだけではいけません。すべての部分で同じ構造を使用し、重要な相違点を失うことなく出力を統合できるようにしてください。実用的なスキーマには、セクション名、主要な調査結果、裏付けとなる証拠、ページまたは見出しの参照、不確実性、未解決の疑問などが含まれるでしょう。
例えば、「パート3のみを分析してください。以下の項目を報告してください:(1)5つ以下の重要な発見事項、(2)各発見事項の根拠、(3)元のページまたはセクションの参照、(4)著者が述べた注意書き、(5)他のセクションで確認する必要のある質問。このパートに記載されていない事実を推測しないでください。」
このアプローチにより、品質の判断も容易になります。チャンクサマリーにソースの場所が明記されていない記述が含まれている場合は、最終的な統合で修正されることを期待するのではなく、先に進む前にそのチャンクを修正してください。
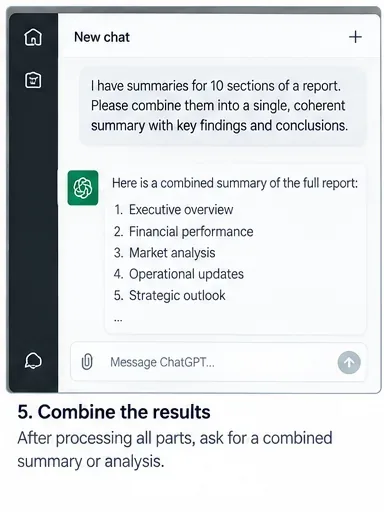
部品の分析が完了したら、チャンクの出力からコンパクトな証拠パックを作成し、それを統合します。元のチャンクとすべての要約を自動的に1つの最終リクエストにまとめて送信しないでください。そうすると、同じコンテキストの問題が再現される可能性があります。
統合プロンプトでは、モデルに対して意見の相違やギャップを保持するように指示する必要があります。例えば、「これらのセクション分析を1つのレポートに統合します。重複する調査結果を統合し、矛盾する証拠は個別のポイントとして保持し、すべての出典情報を保持し、要約から解決できない疑問点にはフラグを付けます。」といった具合です。
この階層的な方法は、書籍、規制当局への提出書類、証拠開示資料、長時間のインタビュー記録、複数文書にわたる調査などに特に有効です。主な制約は情報圧縮です。要約時に省略された詳細は、後から魔法のように復元されることはありません。そのため、証拠スキーマと出典参照が重要になります。
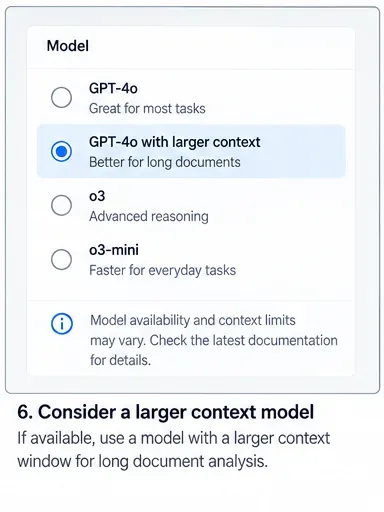
コンテキストウィンドウが大きいモデルを使用すると、チャンク分割の頻度を減らすことができます。OpenAIの現在のモデルドキュメントには、APIモデルのコンテキストウィンドウと最大出力の制限値が記載されていますが、これらの数値はモデルの更新に伴って変更される可能性があります。
ただし、モデルの見出しコンテキストサイズは、製品がプロンプトに直接配置するアップロード済みファイルの量と必ずしも一致するわけではありません。OpenAI の Enterprise 固有のファイルガイダンスでは、アップロードされたテキスト ドキュメントに対して、別の「コンテキスト スタッフィング」プロセスが説明されています。アップロードされたドキュメントから最大 110,000 トークンがコンテキストに直接配置され、追加の資料はプライベート検索インデックスを通じて利用できます。OpenAI は、この動作は現在開発中で変更される可能性があると明言しています。詳細については、「ChatGPT Enterprise でのファイルアップロードの最適化」を参照してください。
実践的な教訓としては、ワークフローを大幅に簡素化できる場合には、より広いコンテキストのモデルを選択すべきだが、関連するセクションが実際に考慮されているかどうかを必ず確認する必要がある。より広いコンテキストを採用しても、適切なスコープ設定、出典の明示、検証の必要性がなくなるわけではない。
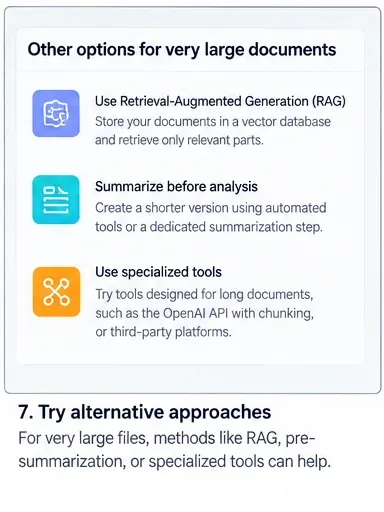
数百ページ、あるいは数千ページにも及ぶタスクの場合、コーパス全体を一つのプロンプトに当てはめようとするよりも、検索方式の方が一般的に優れたアーキテクチャとなります。検索システムはソースをインデックス化し、現在の質問に関連する箇所を検索し、それらの箇所のみを適切な文脈に配置します。
OpenAIのファイル検索に関するドキュメントには、ベクターストアを通じてアップロードされたファイルを検索するためのホスト型ツールについて説明されています。このツールは、「便宜上の終了について定義されているセクションはどれですか?」や「レポートのどこでサプライチェーンの集中について説明していますか?」といった、特定の質問に対して特に効果を発揮します。
タスクがすべてのパッセージを同時に把握することを真に必要とする場合、例えば、あるトピックが全く出現しないことを証明する場合、膨大なコレクション全体にわたってすべての表のセルを比較する場合、あるいは網羅的な行単位の変換を行う場合などは、検索の信頼性は低下します。そのような場合は、検索に加えて、体系的なバッチ処理またはコードベースの前処理を使用してください。
OpenAI Responses API を使用する開発者には、追加の選択肢があります。API リファレンスにはtruncation、設定に関するドキュメントがあります。 はdisabled、ドキュメントに記載されているデフォルト値で、モデルのコンテキスト ウィンドウを超えるリクエストは失敗します。 を使用するとauto、リクエストが収まるように、以前の会話項目を削除できます。Responses API リファレンスを参照してください。
自動切り捨ては重大な障害を防ぐことができますが、モデルが利用できる情報が変更されます。文書分析の場合、初期のコンテキストを黙って削除することは、エラーが発生するよりも悪い結果を招く可能性があります。古い会話項目が不要であるか、既に他の場所で要約されているようなアプリケーション設計の場合にのみ使用してください。
申請が承認されただけでは十分ではありません。目標は、適切な資料を網羅しつつ、証拠をうっかり失うことなく、正当性を証明できる分析を行うことです。問題が解決したと判断する前に、結果を検証してください。
同じサイズの要求を繰り返し送信して、トークン制限が変わると期待しないでください。チャンキング中にソース参照を削除しないでください。ファイルが受け入れられたからといって、すべてのページがコンテキスト内でアクティブになっていると想定しないでください。また、分析がタスクを満たせなくなるほど回答を短くすることでエラーを解決しないでください。
また、自動切り捨てを魔法のように扱うのは避けてください。システムが古い項目を削除すると、重要な指示や証拠が失われる一方で、要求は成功する可能性があります。重要な分析においては、明示的なチャンキングと検索の方が監査が容易な場合が多いです。
新しいスレッドとより絞り込んだ質問でうまくいく場合は、ワークフローをシンプルに保ちましょう。タスクで1つの長いドキュメントを広範囲にカバーする必要がある場合は、ドキュメントを論理的なセクションに分割し、構造化されたチャンク分析を統合します。非常に大きなドキュメントコレクションを繰り返しクエリする場合は、検索機能を使用します。APIを制御しているにもかかわらず制限に近づく場合は、トークンを測定し、出力領域を確保し、適切なモデルを選択し、切り捨て動作を明確な設計上の決定事項とします。
最も優れた結果は、単一のリクエストに最も多くのテキストを詰め込んだものではありません。必要な証拠を網羅し、追跡可能性を維持し、情報が入手できなかった場合を明確に示す結果です。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。







