Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
公開準備が整った製品ページ、ドキュメントページ、ブログページが300ページもあるのに、メタデータ欄がまだ空白のまま。タイトルやメタディスクリプションを一つ一つ手作業で作成するのは時間がかかり、サイト全体に同じパターンをコピーすると同じような結果しか得られず、ローカル言語モデルに「SEOタイトル」を依頼すると、余分なコメントやでっち上げの主張、あるいは一貫性のないフォーマットが返ってくることも少なくありません。
より良いアプローチは、メタデータ生成を小規模なデータパイプラインとして扱うことです。モデルにはページ固有の証拠のみを与え、構造化された出力を要求し、コードで検証し、公開前に例外を確認します。Ollamaはhttp://localhost:11434/api、インストール後にローカルAPIが利用可能で、JSONスキーマ構造化出力をサポートしているため、このワークフローに最適です。ここで参照されているOllamaとGoogle検索のドキュメントは、2026年9月13日に確認されました。
ほとんどの失敗は、単一の「不適切なプロンプト」ではなく、モデルを取り巻くワークフローに起因します。一般的な原因としては、ページコンテンツの入力量が少なすぎる、モデルに自由形式の文章で回答させてしまう、すべてのURLに同じキーワード式を適用する、サイトレベルでの重複チェックを行わずに出力を公開する、などが挙げられます。
文字数制限に関する誤解も根強く残っています。Googleによると、ページの<title>要素やメタディスクリプションに固定の長さ制限はなく、タイトルリンクやスニペットは必要に応じて切り詰められ、通常はデバイスの画面幅に応じて調整されます。また、Googleのシステムが別の表現の方がより有用だと判断した場合、ページコンテンツから別のタイトルリンクやスニペットを生成することもあります。タイトルリンク、スニペット、メタディスクリプションに関するGoogleの公式ガイダンスをご覧ください。
つまり、スクリプトは一貫性を保つために編集上の文字数制限を設けることはできますが、それらの文字数をGoogleの要件として明示すべきではありません。以下の例では、タイトルの65文字と説明文の165文字はあくまで内部的な制限です。CMS、ブランド、ローカライズのニーズ、審査プロセスに合わせて変更してください。
Ollamaの公式クイックスタートガイドには、macOS、Windows、Linuxのサポートが記載されています。インストール後、ローカルモデルをダウンロードしてください。Ollamaの現在のドキュメントでは、gemma3APIの例として頻繁に使用されているため、このチュートリアルでは便利な中立的な例として使用できます。
ollama pull gemma3次に、ローカルエンドポイントをテストします。
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'Ollama API のドキュメントには、ローカル API は で提供されると記載されていますhttp://localhost:11434/api。また、このアドレスへのローカル アクセスには認証は不要であるとも記載されています。ローカル サービスが実行されていない場合は、 が起動するためのドキュメントに記載されている CLI コマンドです。真のローカル推論が目的の場合は、モデルollama serveを置き換えることは避けてください。-cloud
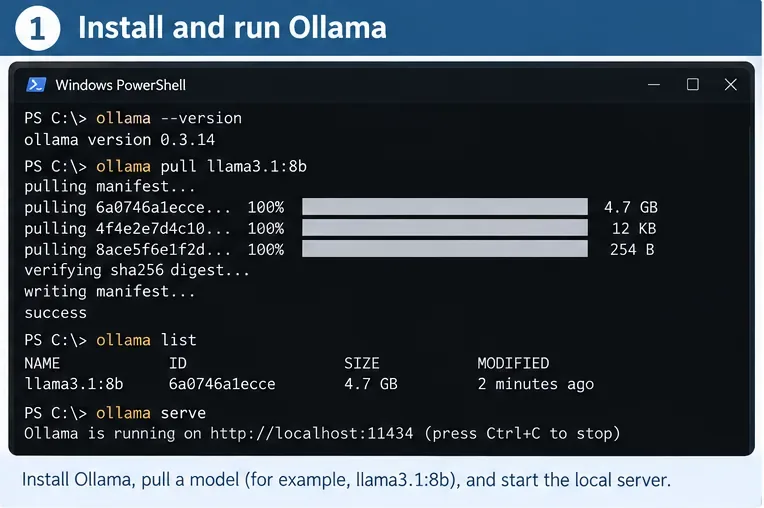
この記事は、SEOメタデータに関して、どのモデルが普遍的に最適であるかを断言するものではありません。モデルの可用性やハードウェアへの適合性は時間とともに変化し、大規模なモデルはより多くのメモリを必要とし、一般的に応答速度も遅くなります。まずは、お使いのマシンで快適に動作するモデルから始め、小規模なレビューセットを生成し、数千ページを処理する前に、事実の正確性、独自性、レイテンシ、一貫性を比較検討してください。
自由形式のテキストは自動化には不向きです。「ここに3つの素晴らしい選択肢があります…」のような応答では、プログラムは実際のタイトルがどこから始まるかを推測しなければなりません。Ollamaの構造化出力に関するドキュメントでは、フィールドにJSONスキーマを渡すことがサポートされていますformat。また、このドキュメントでは、PythonのPydanticを介して再利用可能なスキーマを使用することを推奨しており、などの低温設定によって0決定性が向上する可能性があることも指摘しています。
この例で使用されている2つのPythonパッケージをインストールしてください。
python -m pip install -U ollama pydantic次に作成しますgenerate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
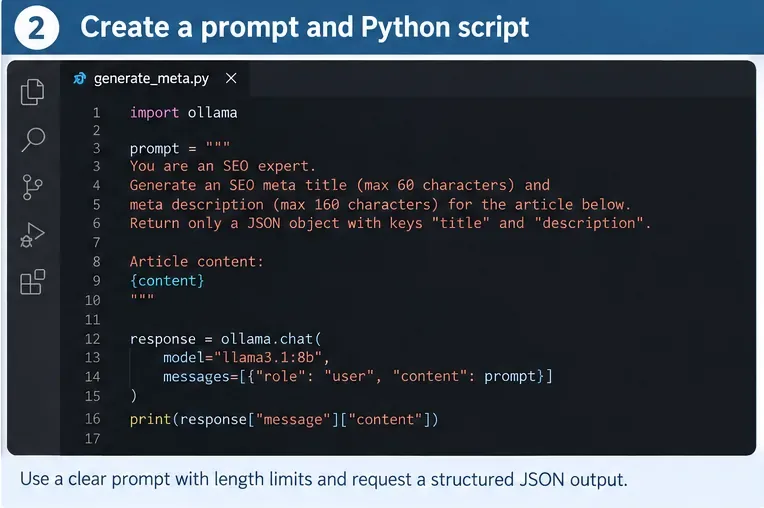
Googleによると、同社のタイトルリンクシステムは、ページの<title>メインビジュアルタイトル、見出し(例:)<h1>、og:title目立つテキスト、アンカーテキスト、その他のシグナルを考慮できるとのことです。ローカルジェネレーターはGoogleのシステムを再現する必要はありませんが、ソースタイトル、H1タグ、URL、代表的な本文テキストを指定することで、提案されたメタデータを読者が実際に目にするページと一致させることができます。
無関係なキーワードリストをモデルに入力して「それらを当てはめてください」と指示しないでください。Googleは、簡潔で分かりやすいタイトルを推奨し、キーワードの詰め込みや定型文の繰り返しを避けるよう警告しています。説明文については、Googleは、説明文が正確で、人間が読みやすく、かつ多様であれば、大規模なデータベース駆動型サイトにおいてページ固有のプログラムによる生成が適切であると述べています。
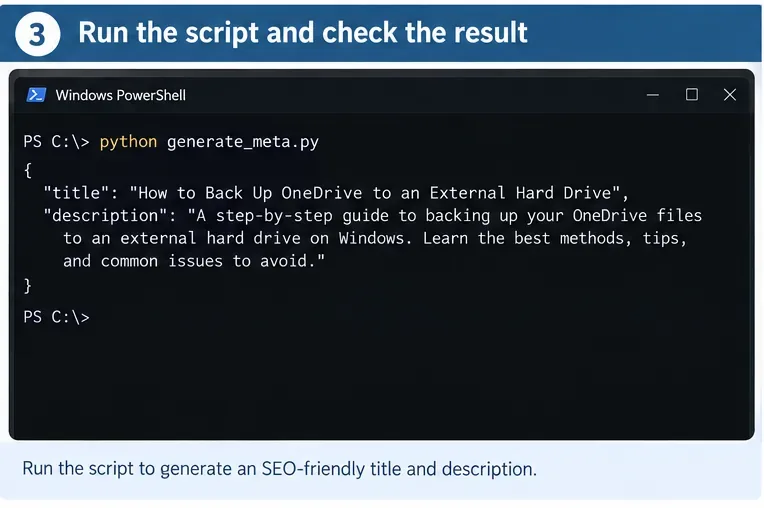
スクリプトを実行します。
python generate_meta.py成功した結果とは、Pydanticが検証できるJSONオブジェクトであるべきです。さらに重要なのは、人間のレビュー担当者がそれをソースページと比較し、次の4つの質問に迅速に答えられることです。
スキーマはデータ型や長さを制限することはできますが、文が真実であることや十分に具体的であることを保証することはできません。測定可能なチェックに基づいて再試行ロジックを構築してください。たとえば、空のフィールド、重複したタイトル、禁止されている定型文、タイトルとほぼ同じ内容の説明などを拒否します。ページに規制対象または重大な主張が含まれている場合は、信頼性を自動化しようとするのではなく、人間のレビューを必須としてください。
再試行を促すメッセージは簡潔にしましょう。「改善する」という指示で全てを再生成するのではなく、何が失敗したのかをモデルに伝えましょう。「提案されたタイトルは別のページと重複しています。H1タグ内の固有のトピックを使用して書き直し、すべての主張が提供されたコンテンツに基づいているようにしてください。」こうすることで、失敗箇所の監査が容易になります。
1ページテストが信頼できるものになったら、入力データを、、、、などの列を含むCSVファイルに保存しますurl。コンテンツフィールドには、ナビゲーションメニュー、Cookie通知、または無関係なフッターリンクが何千個も含まれているのではなくsource_title、クリーンアップされたページテキストを含める必要があります。h1content
このバッチ処理ロジックをジェネレーター関数の下に追加するか、別のスクリプトに配置してください。
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
出力されたCSVファイルは、Excel、LibreOffice、データベースインポートツール、またはCMSワークフローで確認できます。初回実行時にライブメタデータを自動的に上書きしないでください。レビュー担当者が比較できるように、またロールバックが容易になるように、生成された提案書と元のタイトルおよび説明を併記してください。
| チェック | 警告すべき事項 | なぜそれが重要なのか |
|---|---|---|
| スキーマ検証 | 入力漏れまたは無効なフィールド | 不正な形式の出力がCMSに入力されるのを防ぎます。 |
| 重複タイトルチェック | 2つのURLに同じ正規化されたタイトル | ページを区別しやすくするのに役立ちます。 |
| 言語チェック | メタデータの言語はページの言語とは異なります | Googleは、ページの主要言語と表記体系に合わせることを推奨しています。 |
| 証拠確認 | 情報源に番号、価格、日付、ブランド、保証などが記載されていない | 虚偽の請求を減らす。 |
| 定型文チェック | サイト全体で繰り返される長いフレーズ | Googleは、定型文のタイトルを繰り返し使用しないよう推奨しています。 |
| 編集の長さチェック | 選択した住宅範囲外 | CMSの出力の一貫性を保つためのものであり、Googleの文字数制限ルールではありません。 |
| 人間によるレビュー | 戦略的、機密性、アクセス数が多い、または曖昧なページ | 自動化は例外を隠すのではなく、明らかにするべきである。 |
まず、Ollamaが実行されており、http://localhost:11434アクセス可能であることを確認してください。公式の認証ドキュメントには、ローカルAPIでは認証は不要であると記載されています。スクリプトが誤って を指している場合はhttps://ollama.com/api、それは別のホスト型エンドポイントであり、認証が必要です。
自然言語でJSONだけを要求するのではなく、スキーマを通して出力してくださいformat=SeoMeta.model_json_schema()。構造化された出力は、本番環境のパイプラインにとって適切な制御層です。
ページ固有のH1テキストと意味のある本文コンテンツを入力し、グローバルなナビゲーションノイズを除去し、ページ固有の説明を明示的に要求します。その後、ページ間の重複と類似性のチェックを実行します。繰り返しは、モデルの問題である前に、入力の問題であることが多いのです。
入力内容を信頼できるページテキストに限定し、根拠となるルールを強化します。提供されたコンテンツ以外の事実に関する主張は行わないでください。重要なページについては、生成されたアサーションを承認前に構造化されたソースフィールドと比較します。ソース自体が曖昧な場合は、モデルに繰り返し推測させるのではなく、行を人間のレビューに回してください。
アーキテクチャを変更する前に測定を行いましょう。ページごとの生成時間、入力サイズ、モデル名、および失敗率を記録します。無関係な本文を切り捨て、安定したページセクションを処理し、品質が許容範囲内であれば、より小さなローカルモデルをテストします。メタデータによってレビュー作業が削減されるよりも増えるのであれば、最速のモデルは役に立ちません。
既にOpenAI互換クライアント用のコードをお持ちの場合は、Ollamaのドキュメント(OpenAI APIの部分的な互換性について)http://localhost:11434/v1/を参照してください。これにより、移行作業を軽減できます。ローカル専用の新しいメタデータツールの場合は、OllamaのネイティブPythonクライアントの方がシンプルで、Ollamaのドキュメントに構造化出力の例が直接記載されています。
自動化が完了したと判断する前に、短い記事、長いガイド、製品ページ、カテゴリページ、数値を含むページ、およびサポートされているすべての言語のページなど、さまざまな種類のコンテンツを含むレビューセットを作成します。それらすべてに対して同じモデルとプロンプトを実行し、次のチェックリストを確認します。
localhost、選択されたモデルはローカルモデルであり、クラウドタグ付きモデルではありません。最後に、自動化で制御できるものとできないものを覚えておきましょう。優れた<title>メタディスクリプションは検索エンジンに役立つページレベルのシグナルを提供しますが、Googleは他のページコンテンツからタイトルリンクやスニペットを生成できます。したがって、特定の検索結果の表示を強制することが目的ではありません。目的は、正確で明確かつ有用なメタデータを大規模に生成しつつ、本番環境に到達する前に間違いを検出するための十分な検証とレビューを維持することです。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








