Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
最もシンプルで実用的な解決策は、言語モデル、埋め込みモデル、ドキュメントインデックス、チャットインターフェースを自分のコンピュータ上で実行することです。シンプルな構成としては、ローカルモデル配信にOllama、ドキュメント取り込み、検索拡張生成(RAG)、チャットにセルフホスト型のAnythingLLMを使用するのが良いでしょう。ベクトルデータベースはローカルに保持し、永続ストレージを使用し、クラウドモデルプロバイダーは避け、回答が実際に自分のファイルに基づいていることをテストしてください。
具体例:このガイド全体を通して、ジョーダンという人物が、家庭用マニュアル、保険関連のPDFファイル、会議の議事録、個人財務に関する参考書、そしていくつかのプロジェクトレポートを含む私的な資料を整理していると想像してください。ジョーダンは架空の人物です。以下に説明するファイル、質問、回答、および結果は、ワークフローを説明するための例であり、テスト結果やお客様の声ではありません。
このガイドでは、プライバシーの境界が分かりやすいように4段階のセットアップ手順を採用しています。ローカルでの文書検索や質問応答を必要とする個人または少人数の信頼できる家庭に適しています。エンタープライズレベルのID管理、マルチノード可用性、集中監査、または規制上の保証が必要な場合は、これを完全なコンプライアンスソリューションではなく、あくまでも出発点となるアーキテクチャとして捉えてください。
ローカル知識ベースは、ドキュメントに基づいてモデルをトレーニングすることとは異なります。一般的なRAGワークフローでは、システムはファイルからテキストを抽出し、テキストをチャンクに分割し、それらのチャンクを数値埋め込みに変換し、ベクトルデータベースに保存し、各質問に関連するチャンクを取得し、それらのチャンクのみをコンテキストとして言語モデルに送信します。
AnythingLLM の現在のドキュメントでは、添付ドキュメントと埋め込みドキュメントの両方のワークフローについて説明しています。添付ドキュメントは、コンテキストウィンドウが許可する場合に全文をチャットに挿入できますが、RAG は埋め込みドキュメントから関連する小さな部分を取得します。また、現在のローカル LanceDB のドキュメントでは、デフォルトのインスタンス上の LanceDB はドキュメントのテキストと埋め込みを AnythingLLM アプリケーション内に保持すると記載されています。AnythingLLMのドキュメントワークフローのドキュメントとAnythingLLM LanceDB のドキュメントを参照してください。
| 成分 | ローカルスタックにおける役割 | プライバシーに配慮した選択 |
|---|---|---|
| オラマ | お使いのマシン上でチャットモデルと、必要に応じて埋め込みモデルを実行します。 | クラウドホスト型モデルエンドポイントではなく、ローカルモデルを使用してください。 |
| AnythingLLM | UI、ドキュメント管理、チャンキング、RAG、ワークスペース構成を提供します。 | ローカルで実行し、ストレージディレクトリを永続的に保持する |
| 埋め込みモデル | 文書の断片とクエリを意味検索のためのベクトルに変換する | ドキュメントを外部サービスに送信してはいけない場合は、ローカル埋め込み機能を使用してください。 |
| LanceDB | 関連する文章を見つけるために使用されるベクトルを格納します。 | 意図的にリモートデータベースが必要な場合を除き、デフォルトのローカルインスタンスを使用してください。 |
| オリジナルファイルとバックアップ | 権威ある情報源であり続ける | 通常のOSアクセス制御、暗号化、バックアップで保護してください。 |
重要なのは「アプリはローカルか?」ではなく、「どのコンポーネントがドキュメントのテキストやプロンプトをマシン外に送信できるか?」という点です。ローカルUIであっても、クラウドLLM、クラウド埋め込みAPI、Web検索、またはリモートツールを呼び出すように構成できます。プライベートな設定の場合は、外部プロバイダーのデータ共有に関する影響を意図的に受け入れた場合を除き、LLM、埋め込みツール、およびベクターデータベースをローカルに保持してください。
AnythingLLMは匿名テレメトリに関するドキュメントを作成し、それを無効にする方法を提供しています。また、プライバシーに関するドキュメントでは、ワークスペースからドキュメントを削除することと、ドキュメントライブラリから完全に削除することとを区別しています。AnythingLLM内で完全に削除するには、現在のドキュメントでは「マイ ドキュメント」からドキュメントを削除するように指示されています。これにより、解析されたソース、キャッシュされた埋め込み、ワークスペースへの参照が削除されます。機密性の高い資料を追加する前に、 AnythingLLMのプライバシーとデータ処理に関するドキュメントを確認してください。
選択したローカルモデルには十分なメモリ容量が必要です。CPU、GPU、RAMまたはVRAM、量子化、コンテキスト長、取得するドキュメント数などによって処理速度が異なるため、最適なモデルサイズは一つではありません。マシンがかろうじて読み込める最大のモデルを選択するのではなく、無理なく収まるモデルから始めることをお勧めします。
お使いのオペレーティングシステムに対応した最新の手順に従って、Ollamaをインストールしてください。OllamaはmacOS、Windows、Linuxに対応しており、ローカルAPIはデフォルトでポート11434で提供されます。最新のインストール方法とコマンド構文については、Ollama公式クイックスタートガイドをご覧ください。
インストール後、お使いのハードウェアに適したチャットモデルをダウンロードしてください。モデルカタログは変更される可能性があり、ハードウェア要件も異なるため、ここでは具体的なモデルをあえて固定していません。一般的なコマンドは次の形式です。
ollama pull <chat-model-name>RAG の場合、埋め込みモデルも必要です。2026 年 9 月に確認された Ollama の最新の埋め込みに関するドキュメントにはembeddinggemma、、、qwen3-embeddingなどのモデルが推奨される埋め込みオプションとして記載されています。最新のリストは、Ollama の埋め込みに関するドキュメントall-minilmで確認できます。例:
ollama pull embeddinggemma通常のチャットモデルがモデルドロップダウンに表示されているからといって、それを埋め込みモデルとして使用しないでください。AnythingLLMの最新のOllama埋め込み機能のドキュメントには、Ollamaが同じリストにチャットモデルと埋め込みモデルの両方を表示する可能性があることが明記されています。ドキュメントのインデックス作成には、実際の埋め込みモデルを使用してください。AnythingLLM Ollama埋め込み機能の設定を参照してください。

ジョーダンの架空のシステム構成において、現段階での目標は単純だ。世帯文書をリモートAPIに送信することなく、生成と埋め込みの両方が可能になることである。
AnythingLLMはデスクトップ版とセルフホスト版を提供しています。このガイドでは、ストレージ境界が明確でバックアップが容易なため、Docker版を使用します。現在のローカルDockerドキュメントでは、イメージをプルするように指示し、永続ストレージが必要であり、そうでない場合はコンテナの再作成時にアプリケーションデータが失われる可能性があることを強調しています。また、Webアプリケーションは で利用可能であるとも記載されています。フォーラムから古いコマンドをコピーするのではなく、公式のAnythingLLMローカルDockerガイドをhttp://localhost:3001使用してください。
docker pull mintplexlabs/anythingllm:latestコンテナを実行する際は、ホストディレクトリをマウントしてAnythingLLMのストレージを保護してください/app/server/storage。ベンダーのドキュメントには、永続的なマウントが必要であると明記されています。そのストレージディレクトリは、バックアッププランに含まれるディスク上に配置してください。
次に、LLM プロバイダを Ollama として構成します。AnythingLLM がホスト上で直接実行されている場合、ドキュメントに記載されているデフォルトの Ollama アドレスは ですhttp://127.0.0.1:11434。AnythingLLM が Docker 内で実行され、Ollama がホスト上で実行されている場合は、localhostコンテナ内から を使用しないでください。AnythingLLM の Docker ネットワークに関するドキュメントでは、サポートされているデスクトップ プラットフォームでは を使用するように指示されていますhttp://host.docker.internal:11434。Linux では、このホスト接続パターンについてドキュメントに記載されています。AnythingLLMの localhost ネットワークに関する注記とOllama LLM 構成を172.17.0.1参照してください。
設定で、LLMプロバイダーとしてOllamaを選択し、必要に応じて埋め込みプロバイダーとしてもOllamaを選択してください。生成用のチャットモデルとインデックス作成用の埋め込みモデルを選択します。これらの役割を分離することで、よくある設定ミスを防ぐことができます。
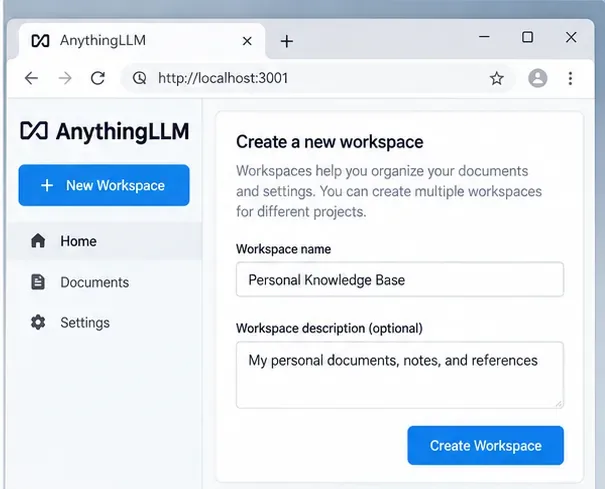
ジョーダンは「パーソナルナレッジベース」というワークスペースを作成し、クラウドモデルプロバイダーとの接続を避けています。これにより、ローカルUI、ローカルLLM、ローカル埋め込み、ローカルベクトルといった、意図した境界を後で簡単に監査できるようになります。
ドライブ全体をアップロードするのではなく、まずは内容をよく把握している少数の代表的なドキュメントからアップロードしてください。こうすることで、インデックスが大きくなる前に、抽出や取得に関する問題を確実に検出できます。
ジョーダンの例では、最初のバッチには、検索可能なPDFファイル1つ、DOCXファイル1つ、プレーンテキストまたはMarkdown形式のメモ1つが含まれると便利です。スキャンされたPDFに選択可能なテキストではなく画像が含まれている場合は、選択した文書処理パスが必要なテキストを実際に抽出していることを確認してください。人間には読みやすいファイルでも、RAGでは空のテキスト表現や不適切なテキスト表現が生成される場合があります。
AnythingLLMは現在、大きく分けて2つのドキュメント動作をサポートしています。
AnythingLLMの最新ドキュメントガイドには、ワークスペースに埋め込まれたドキュメントは、そのワークスペース内のスレッド間で利用可能になると記載されています。これは便利な機能ですが、同時に、ワークスペースのメンバーシップがマルチユーザー環境におけるプライバシーモデルの一部となることを意味します。個人用ワークスペースは、共有ワークスペースとは分けて管理してください。
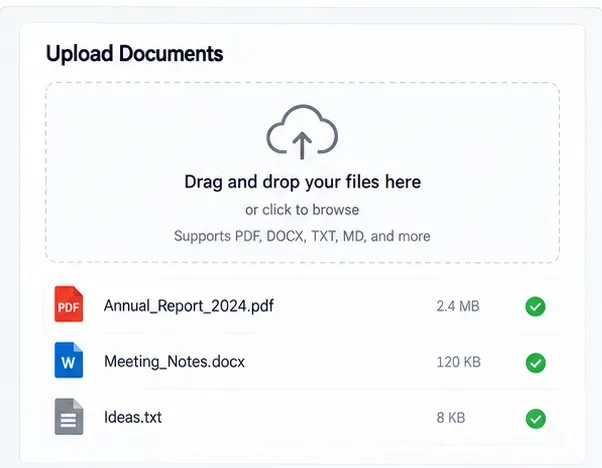
埋め込み後、まず1つのファイルにのみ回答が記載されている質問をします。次に、どのファイルにも記載されていない詳細情報を尋ねます。最初の質問は検索能力をテストし、2番目の質問はモデルが回答を捏造するのではなく、不確実性を認めるかどうかをテストします。
AnythingLLMは、検索設定、コンテキストスニペットの最大数、文書類似度しきい値など、ワークスペースレベルのRAG制御機能を提供します。ドキュメントでは、ベースモデルに問題があると想定するのではなく、ワークスペースの設定から始めることを推奨しています。回答が複数のセクションにまたがる場合は、取得するコンテキストを増やすと効果的ですが、送信するチャンクが多すぎると、無関係なテキストが追加されたり、コンテキストウィンドウの容量を消費したりする可能性もあります。
インデックス作成後に埋め込みモデルを変更する場合は、影響を受けるドキュメントを再埋め込みして、保存されているベクトルとクエリベクトルが同じ埋め込み空間から取得されるようにしてください。異なるモデルの埋め込みを混在させることは、意味のある検索戦略ではありません。
知識ベースは、誤りを検出できる場合にのみ有用です。直接検証できる事実から、小さな評価リストを作成しましょう。例えば:
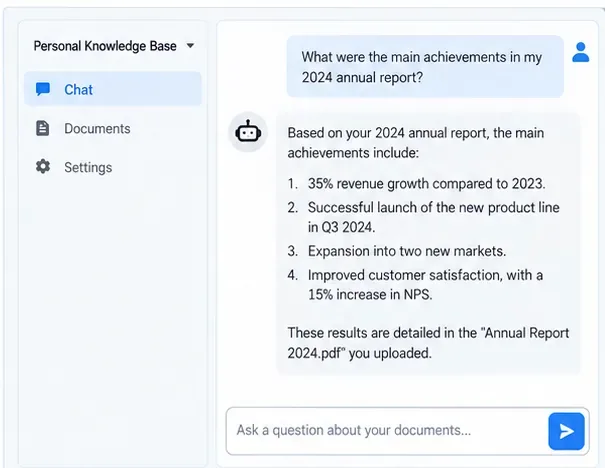
ジョーダンにとって、適切な受け入れ基準とは「答えがもっともらしく聞こえる」ことではない。それは「答えが情報源と一致し、必要な文脈を含み、情報源に情報が含まれていない場合は安全にエラーとなる」ことである。この基準は、税金、保険、法的文書、医療記録、あるいは財務上の意思決定において特に重要となる。
ローカル推論はデータ漏洩のリスクを低減しますが、プライバシーは依然として設定に依存します。以下のコントロールを実用的なチェックリストとして活用してください。
オリジナルのドキュメントは依然として信頼できる情報源ですが、AnythingLLM ストレージ ディレクトリには、アプリケーション データベース、解析済みドキュメント、ベクター データ、およびディスク障害後にすべてを再構築する必要を回避するために必要な構成情報が含まれています。オリジナルのドキュメント フォルダと AnythingLLM の永続ストレージの両方をバックアップしてください。バインド マウントされたホスト ディレクトリではなく Docker ボリュームを使用する場合は、Docker の公式ボリューム バックアップおよび復元に関するドキュメントを参照してください。
バックアップの作成だけでなく、復元テストも行うべきです。バックアップが実際に機能することを証明できるのは、別のディレクトリやマシンに復元し、ローカルスタックを起動し、ワークスペースを開き、既知の事実を正しく取得できた場合のみです。
このアーキテクチャは、個人文書を自分で管理するハードウェアに保存することを最優先事項とし、ローカルソフトウェアの実行に抵抗がなく、小規模な文書ライブラリに対して意味検索と自然言語による回答を求める場合に最適です。また、インターネット接続が不安定な場合や、モデルをダウンロードした後のローカルコストを予測したい場合にも役立ちます。
お使いのコンピュータで適切なローカルモデルを実行できない場合、ホームネットワーク外の多数のデバイスからシームレスなアクセスが必要な場合、またはエンタープライズグレードのID管理、監査、法的保留、集中型キー管理、保証付きサポートが必要な場合は、この方法は適していません。そのような場合は、単一PC構成ではなく、マネージドプライベートデプロイメントまたはエンタープライズRAGプラットフォームが適切な解決策となる可能性があります。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。







