Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
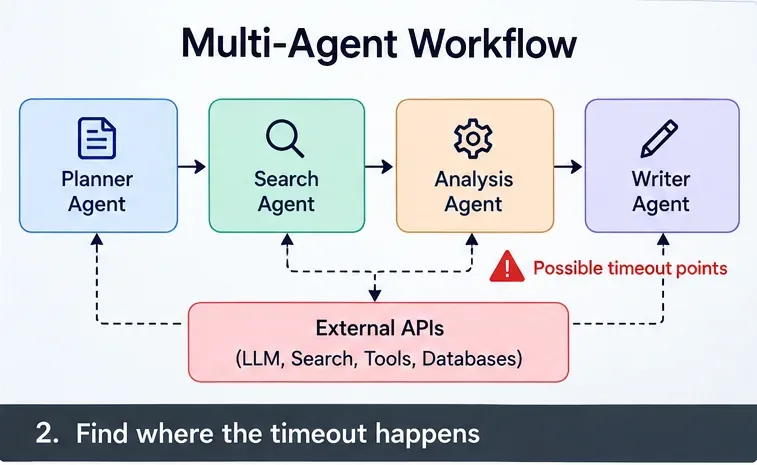
マルチエージェントワークフローにおける「APIタイムアウトエラー」は、数値を1つ変更するだけでは解決できないことがほとんどです。プランナーは3つのエージェントを呼び出す可能性があり、各エージェントはLLM、検索サービス、データベース、またはツールAPIを呼び出す可能性があり、各レイヤーは独自のタイムアウト、再試行ポリシー、接続プール、および同時実行制限を持つことができます。実際的な解決策は、どのレイヤーが最初にタイムアウトするかを特定し、待機時間を長くする、同時呼び出し数を減らす、よりスマートな再試行を行う、クリティカルパスを短くする、または非同期ジョブ設計を採用する、といった選択肢の中から適切なものを選ぶことです。
トレードオフは重要です。タイムアウトを長くするのは簡単ですが、リソースをより長く消費します。積極的な再試行は負荷とコストを増加させる可能性があります。同時実行数を減らすと安定性は向上しますが、ピークスループットが低下します。並列エージェントは、下流サービスがファンアウトを吸収できる場合にのみ、実時間遅延を削減します。すべてのマルチエージェントシステムに最適な設定は存在しません。
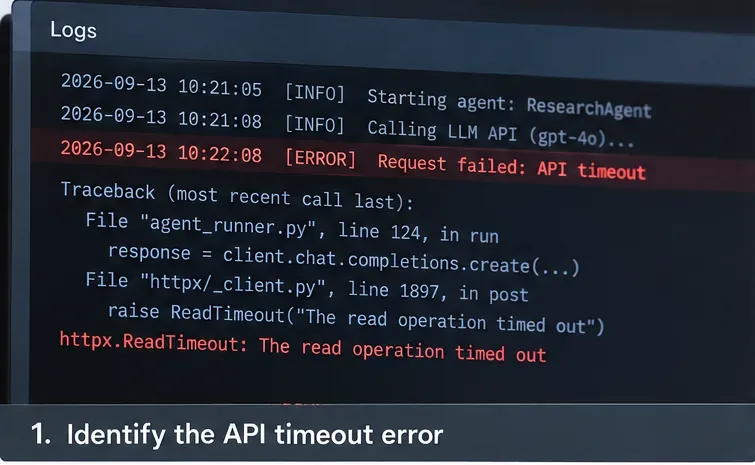
まず、タイムアウトを全て同じイベントとして扱うのではなく、障害の種類を分類することから始めましょう。HTTPクライアントは、接続中、読み取り中、書き込み中、またはプールからの接続待ち中にタイムアウトする可能性があります。たとえば、HTTPXでは、接続、読み取り、書き込み、プールという4種類のタイムアウトについて規定しています。デフォルトの動作では、ネットワークが5秒間非アクティブ状態になった後にタイムアウトが発生しますが、これは必ずしもリクエスト全体の所要時間が5秒経過した後ではありません。HTTPXの公式タイムアウトに関するドキュメントを参照してください。
OpenAI Python SDK を使用する場合、現在の公式 README には、リクエストのデフォルトのクライアントタイムアウトが 10 分であり、タイムアウト失敗はデフォルトで 2 回再試行されると記載されています。SDK はまた、接続エラーと HTTP 408、409、429、および 5xx レスポンスを短い指数バックオフで自動的に再試行します。これらは SDK のデフォルト設定であり、リクエストの前にあるすべてのプロキシ、ロードバランサー、ゲートウェイ、またはオーケストレーターが 10 分間待機することを保証するものではありません。詳細については、公式の OpenAI Python SDK README を参照してください。
| オプション | 最適なフィット感 | 主な利点 | 主なトレードオフ |
|---|---|---|---|
| リクエストのタイムアウト時間を長くする | 健全だが、正当な理由で遅いモデル/ツール呼び出し | コードとアーキテクチャの変更は最小限に抑える。 | ワーカーと接続はより長く占有されたままになる。上流のゲートウェイが最初にリクエストを終了する可能性もある。 |
| 指数バックオフを使用して再試行 | 一時的なネットワークエラー、レート制限、特定の5xxエラー | 短時間の障害から自動的に復旧します | トラフィック、遅延、コストが増加する可能性があり、慎重に設計しない限り、冪等性のない操作には安全ではありません。 |
| エージェントの同時実行数を減らす | 429エラー、プールタイムアウト、ダウンストリーム飽和 | バーストとキューの競合を軽減します | ピークスループットの低下、場合によってはワークフロー完了時間の延長 |
| 独立したエージェントを並列化する | 独立した分岐を持つシーケンシャルワークフロー | クリティカルパスを短縮する | 同時リクエスト数が増加し、レート制限または接続制限がトリガーされる可能性があります。 |
| ストリーム部分出力 | ファーストバイトのレイテンシが重要なインタラクティブUX | ユーザーはより早く進歩を実感できる | ハードインテグレーションのタイムアウトやダウンストリームサービスの過負荷を自動的に解決するものではありません |
| 作業を非同期ジョブ/キューに移行する | 数十秒から数分かかるワークフロー | HTTPリクエストのライフサイクルとワークフローのライフサイクルを分離する | ジョブの状態、ポーリング/Webhook、冪等性、永続性、および運用監視が必要です。 |
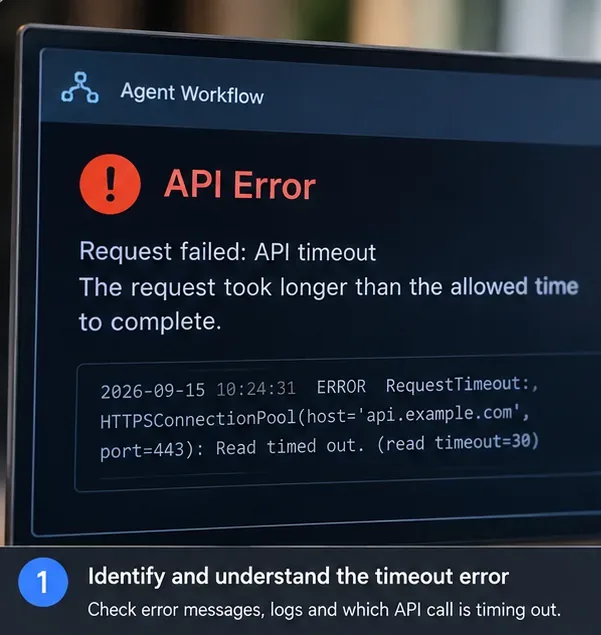
ワークフロー全体の相関IDと、各エージェントおよびツール呼び出しのスパンIDまたは子IDをログに記録します。開始時刻、終了時刻、エンドポイント、試行回数、例外タイプ、利用可能な場合は応答ステータス、およびキャンセルが呼び出し元またはダウンストリームサービスから発生したかどうかを記録します。
重要なのは「どちらが先に待機を停止したか」という点です。LLM 呼び出しが 42 秒で完了しても、API ゲートウェイが 30 秒で処理を中断した場合、LLM クライアントのタイムアウトを 60 秒から 120 秒に延長しても何も変わりません。Amazon の API Gateway HTTP API に関する現在のドキュメントでは、統合タイムアウトの最大値は 30 秒と記載されています。これは、チェーン内で最も短い期限が結果を決定することが多い理由の良い例です。Amazon API Gateway HTTP API のクォータを参照してください。
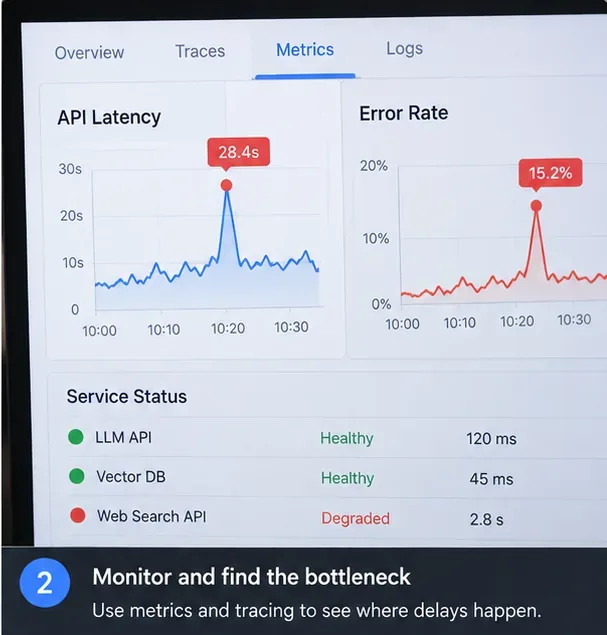
平均レイテンシは良好に見えるかもしれませんが、ごく少数の遅い呼び出しがワークフローの失敗の大部分を引き起こしている可能性があります。少なくとも依存関係ごとの成功率に加え、p50、p95、p99のレイテンシを追跡してください。ファンアウト段階では、キュー時間と接続プールの待機時間も記録してください。「遅いAPI」は、実際には空き接続を待っている過負荷状態のクライアントである可能性があるためです。
トレースを使用して、次の3つの実用的な質問に答えます。どの依存関係がクリティカルパスを支配しているか、複数の低速エージェントが並行して実行できるにもかかわらず順次実行されているか、並行処理の急増が429、プールタイムアウト、または5xxエラーと一致するか。
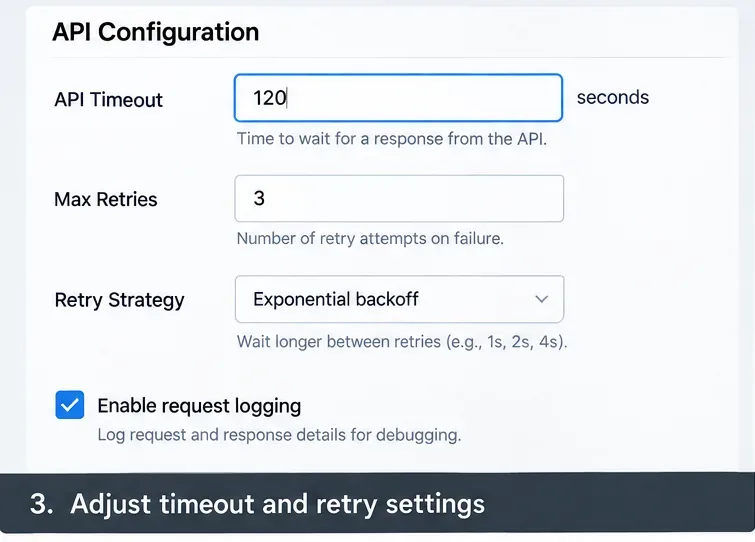
まず、エンドツーエンドのワークフローの期限を設定し、次に内部の期限を短く設定することで、下位レイヤーが早期に障害を起こした場合でもオーケストレーターが復旧できるようにします。例えば、ユーザー向けの期限を120秒に設定した場合、オーケストレーションと応答処理に10秒を割り当て、残りの110秒を実際の作業に充てることができます。個々のツール呼び出しには15秒、モデル呼び出しには観測されたテールレイテンシに応じて45秒または60秒を割り当てることができます。
これらの値を盲目的にコピーしないでください。これらは予算編成方法の一例であり、普遍的なデフォルト値ではありません。測定されたレイテンシ分布と製品のSLOに基づいて値を選択してください。外側の期限は、内側の呼び出し、許容される再試行、バックオフ遅延、およびクリーンアップ時間をすべて含むのに十分な長さである必要があります。
Python 3.11以降では、asyncio.timeout()非同期処理に期限を設定する機能を提供しています。期限が過ぎると、タスクはキャンセルされ、コンテキストマネージャがタイムアウトを通知します。公式のPython asyncioタイムアウトに関するドキュメントをTimeoutError参照してください。
import asyncio

async def run_stage():
    try:
        async with asyncio.timeout(90):
            return await run_agents()
    except TimeoutError:
        return {"status": "partial", "reason": "stage_timeout"}
マルチエージェントシステムは、ファンアウトが予想以上に速く拡大するため、しばしば失敗します。例えば、20件のユーザーリクエストがそれぞれ5つのエージェントを起動し、各エージェントが2つのツールを起動する場合、再試行が行われる前に最大200件のダウンストリーム呼び出しが発生する可能性があります。最初に再試行を追加すると、輻輳が再試行の嵐に発展する可能性があります。
429 エラー応答、プールタイムアウト、キュー時間の増加、または下流の依存関係が飽和状態になった場合、同時実行数制限器を使用するのが多くの場合、最善の策です。Python のセマフォは、保護されたセクションに同時に入るコルーチンの数を制限するシンプルなカウンターベースの方法を提供します。Pythonの公式セマフォドキュメントをasyncio.Semaphore参照してください。
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
このトレードオフは意図的なものです。制限値を低く設定すると下流のサービスが保護されますが、アプリケーション内部のキューイングが増加する可能性があります。マシンがスケジュールできる最大の数値を選択するのではなく、スループット、p95レイテンシ、レート制限、接続プール容量などを考慮して調整してください。
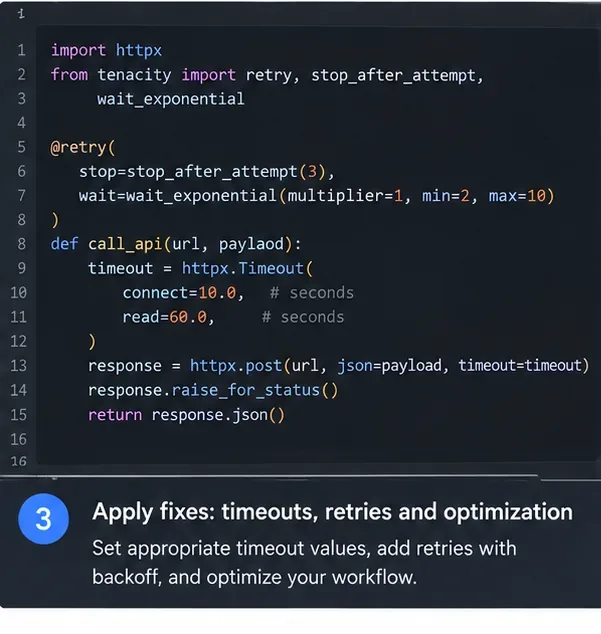
再試行は、一時的な接続障害、レート制限、特定のサーバーエラー、および操作の繰り返しが安全なリクエストタイムアウトの場合に有効です。しかし、検証エラー、認証失敗、決定論的なツールバグ、または冪等性保護のない副作用のあるアクションの場合には、デフォルトの動作として適切ではありません。
再試行回数の増加に注意してください。SDKが2回再試行する場合、1つの論理呼び出しに対して最大3回の試行が行われます。エージェント層も呼び出し全体を2回再試行する場合、理論上の最大試行回数は、その1つの論理操作に対して9回になります。これは、外部からの3回の試行とSDKからの3回の試行を掛け合わせた数です。オーケストレーターが5つのエージェントからなるステージ全体を再試行する場合、リクエストの量は急速に増加する可能性があります。
可能な限り、再試行の所有権を一元化してください。OpenAI Python SDK を使用する LLM 呼び出しの場合、現在の SDK はデフォルトで特定の種類の失敗を 2 回再試行することに注意してください。特定の理由があり、試行回数の上限を設定できる場合にのみ、外部再試行を追加してください。citeturn212133view0turn212133view1
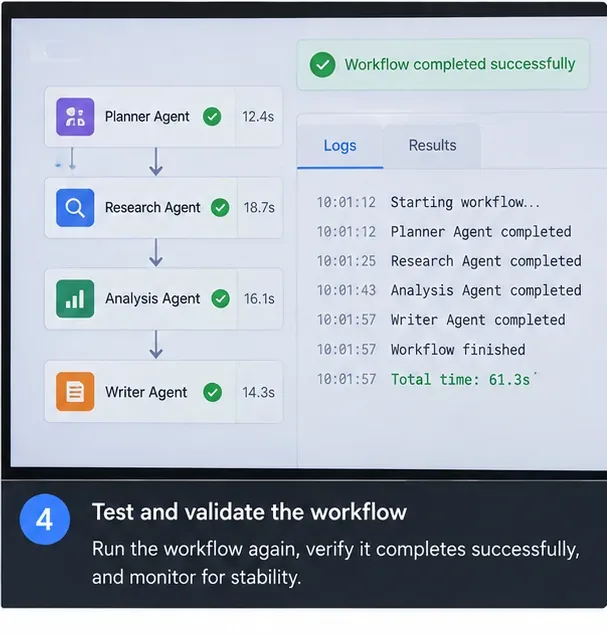
プランナー、リサーチャー、アベレージレーター、ライターの各エージェントが厳密に順番に実行される場合、全体の遅延時間はそれぞれの実行時間の合計にほぼ等しくなります。独立したブランチは同時に実行される場合もあり、その場合、実行時間はすべてのブランチの合計ではなく、最も遅いブランチの時間に近くなります。
Pythonのasyncio.TaskGroupTaskGroupは、関連するタスクを並行して実行するための構造化された方法です。現在のPythonドキュメントでは、TaskGroupはグループ内のタスクを待機し、いずれかのタスクがキャンセルされない例外で失敗した場合に残りのタスクをキャンセルするため、構造化されていないタスク生成よりも安全性が高いと説明されています。詳細については、Pythonの公式TaskGroupドキュメントを参照してください。
並列処理にはコストがかかります。プロバイダが1分あたりのリクエスト数や同時リクエスト数に厳しい制限を設けている場合、4つのエージェントを同時に実行すると、処理速度は遅いものの正常に動作していたワークフローが、429件もの応答が高速に発生する状態に変わってしまう可能性があります。真に独立した処理のみを並列化し、グローバルな同時実行数制限は維持してください。
通常のワークフローがネットワークパス内の最短リクエストタイムアウトを常に超える場合、タイムアウトを継続的に延長するよりも、非同期ジョブモデルに移行する方が通常はクリーンです。最初のHTTPリクエストは入力を検証し、永続的なジョブを作成して、すぐにジョブIDを返します。その後、ワーカーはリクエストライフサイクルとは別にマルチエージェントグラフを実行し、クライアントはポーリング、サーバー送信イベント、WebSocket、またはWebhookを通じて進捗状況を受け取ります。
ストリーミングは、サーバーが早期に意味のある出力の送信を開始できる場合に有効です。たとえば、OpenAI Python SDK は、Responses API 呼び出しのサーバー送信イベント ストリーミングをサポートしています。ストリーミングは、応答性の体感を向上させ、アクティブな接続を維持してデータを生成し続けることができますが、すべてのプロキシの最大リクエスト寿命を自動的に解決するわけではありません。詳細については、OpenAI の公式ストリーミング イベント リファレンスを参照してください。
一時的な簡便性よりも耐久性が重要な場合は、非同期ジョブを選択してください。例えば、長時間の調査タスク、人間の承認が必要なエージェントワークフロー、多数のツール呼び出し、繰り返したくない高コストな操作、クライアントとの接続切断後も処理を継続する必要のあるワークロードなどが挙げられます。ただし、ジョブの状態、チェックポイント、冪等性キー、キャンセル、結果の保存、再試行の所有権など、追加の状態管理が必要になります。
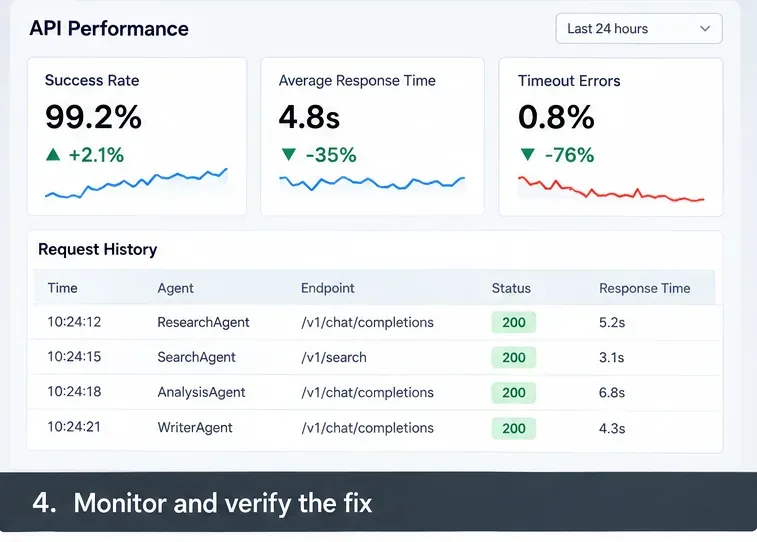
1つのリクエストが成功したからといって、修正が証明されたわけではありません。本番環境で想定される同時実行数でテストを行い、成功率、タイムアウト率、論理タスクごとの再試行回数、p95およびp99レイテンシ、キュー遅延、接続プール待機時間、ダウンストリームの429/5xxエラー発生率、および完了したワークフローあたりのコストを測定してください。
Kubernetesでエージェントを実行する場合、レディネスとライブネスは異なる目的で使用します。Kubernetesのドキュメントでは、レディネスプローブはPodがトラフィックを受信するかどうかを判断するメカニズムとして説明されており、ライブネスプローブはコンテナを再起動するタイミングを判断するメカニズムとして説明されています。ドキュメントには、ライブネスチェックの実装が不適切だと、負荷がかかった際に連鎖的な障害が発生する可能性があると明示的に警告されています。Kubernetesの公式プローブドキュメントを参照してください。
一時的な過負荷の場合、「準備完了状態ではない」状態にする方が、正常だが負荷の高いワーカーを繰り返し停止させるよりも安全な場合が多い。稼働停止は、プロセスを再起動することが真に適切な復旧措置である場合にのみ使用する。
| 観察されたパターン | 最も役立つ最初の変更 | まず最初にやってはいけないこと |
|---|---|---|
| 通話はクライアントの締め切り直後に終了し、下流工程は正常です。 | 具体的な内部タイムアウトを増やし、外部期限を再設定する | 再試行回数を増やす |
| 同時接続数の増加に伴い、429エラーとプールタイムアウトが増加する。 | 同時実行数を下げてキューイング/バックプレッシャーを追加する | より多くのエージェントを並行して起動する |
| 時折発生する408/5xxエラーまたはネットワーク障害 | 冪等演算には、制限付き指数バックオフ再試行を使用する | 例外が発生するたびに無期限に再試行する |
| ワークフローがゲートウェイの制限時間を超えることが頻繁に発生する | 非同期ジョブアーキテクチャまたはサポートされているストリーミング設計を使用する | SDKタイムアウトのみを延長し続ける |
| p99の潜伏期は、一つの遅い依存性によって支配される。 | その依存関係を最適化、キャッシュ、置換、または分離する。フォールバックを検討する。 | 無関係なエージェントのタイムアウトを調整する |
| 並列エージェントを追加した後にのみ障害が発生する | 有用な並列処理を維持しつつ、グローバルセマフォとプロバイダごとの制限を追加する | 並列処理は常に高速であると仮定する |
一般的なマルチエージェントAPIの場合、堅牢なベースラインとしては、すべてのワークフローに相関IDを割り当て、すべてのエージェントとツールの呼び出しをトレースし、エンドツーエンドの期限を1つ定義し、その中で呼び出しごとに短い期限を割り当て、ダウンストリームプロバイダごとにグローバルな同時実行制限を適用し、再試行を制限付きかつ冪等に保ち、再開または部分的な完了を報告するのに十分な状態を永続化することが挙げられます。
次に、測定値に基づいて調整します。システムが安定しているものの速度が遅い場合は、独立した処理を選択的に並列化します。低負荷時には高速だがピーク負荷時に失敗する場合は、ファンアウトを減らし、バックプレッシャーを追加します。ワークフローが正常に完了するまでに同期リクエストパスで許容される時間よりも時間がかかる場合は、すべてのプロキシの待機時間を長くしようとするのではなく、アーキテクチャを切り替えます。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








