Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
LLMの応答品質を測定する最も確実な方法は、評価を単一のスコアとしてではなく、再現可能なテストシステムとして扱うことです。アプリケーションにとって「良好」とは何を意味するのかを定義し、代表的な評価データセットを作成し、決定論的なチェックとモデルベースの判断および人間の判断を組み合わせ、すべての候補となる変更をベースラインと比較し、出荷前にカテゴリ別に不具合を検査します。
これは重要な点です。なぜなら、LLM(論理モデル)は、一見洗練された回答を生成するものの、実際には誤り、根拠の欠如、不完全さ、安全性の欠如、あるいは指示との矛盾を抱えている可能性があるからです。効果的な評価フレームワークは、こうした漠然とした懸念を明確な基準に変換し、プロンプトの変更、モデルのアップグレード、検索方法の変更、ツールの更新、または安全ポリシーの改訂後に再実行できるようにします。
ドキュメントに関する注記:以下に説明するフレームワークの機能は、2026年9月13日時点で入手可能な公式ドキュメントに基づいて検証されています。これらのツールは急速に進化するため、フレームワーク固有のコードを本番環境にコピーする前に、最新のAPIを確認してください。
ユーザーにとって最も重要な失敗から始めましょう。事実に基づいたサポートボットの場合、正確性とポリシーへの準拠が最優先事項となるでしょう。検索拡張型生成(RAG)の場合、流暢な回答であっても、検索されたコンテキストに裏付けられていない事実を捏造する可能性があるため、根拠の明確さと検索品質が重要になります。エージェントの場合、最終的な回答の品質だけでは不十分です。ツールの選択、ツールの引数、タスクの完了、不要な手順なども評価する必要があるかもしれません。
| 品質次元 | 質問内容 | 優れた評価者タイプ |
|---|---|---|
| 正確さ | その答えは事実として正しいのか、論理的に正しいのか? | 参照比較、コードチェック、LLM審査員、または人間によるレビュー |
| 以下の指示 | モデルは要求された制約を満たしていましたか? | 規則とルーブリックに基づく審査員 |
| 地に足の着いた感覚 | 主張は提示された文脈によって裏付けられているか? | RAG固有の裁判官または請求レベルのチェック |
| 関連性 | その回答は、本来の質問に的確に答えており、脱線していないか? | LLM裁判官または人間による審査 |
| フォーマット準拠 | 出力は有効なJSON形式ですか?スキーマに準拠していますか?それとも機械で利用可能な形式ですか? | 決定論的コード |
| 安全とポリシー | その回答は応募規約に違反していますか? | ポリシーチェック、LLM審査員、および対象を絞った人的レビュー |
| 効率 | 応答に必要な遅延時間、トークン使用量、およびコストはどのくらいでしたか? | テレメトリと追跡 |
これらを早々に平均化して一つの数値にしないでください。スタイル面で2ポイント向上した候補モデルでも、たとえ少数の重大な政策上の失敗があったとしても、リリースとしては劣る可能性があります。重要な側面は、個別のゲートとして明確に表示してください。
データセットには、現実的な入力値と、可能であれば期待される動作を含める必要があります。行によっては正確な参照回答を用意できる場合もありますが、単一の「正解」文ではなく、評価基準を示す必要がある場合もあります。タスクの種類、顧客セグメント、言語、難易度、検索条件、安全カテゴリなどのメタデータを追加することで、後で結果を細分化できます。
例えば、カスタマーサポートアシスタントを想像してみてください。有用な評価セットには、簡単なFAQ質問だけが含まれるべきではありません。曖昧な要求、ポリシー例外、コンテキストが欠落しているケース、敵対的なプロンプト、複数回のフォローアップ、そして回答が判断できないと答えるのが正しい動作となる例なども含まれるべきです。
LangSmithの現在の評価ガイドラインでは、まず良好な動作を示す手動で厳選された例から始め、次に本番環境で発見された履歴トレースや障害データを追加してデータセットを拡張することを推奨しています。LangSmithの評価システムは、入力、オプションの参照出力、メタデータを含むデータセットをサポートしています。詳細については、LangSmithの評価概念に関するドキュメントを参照してください。
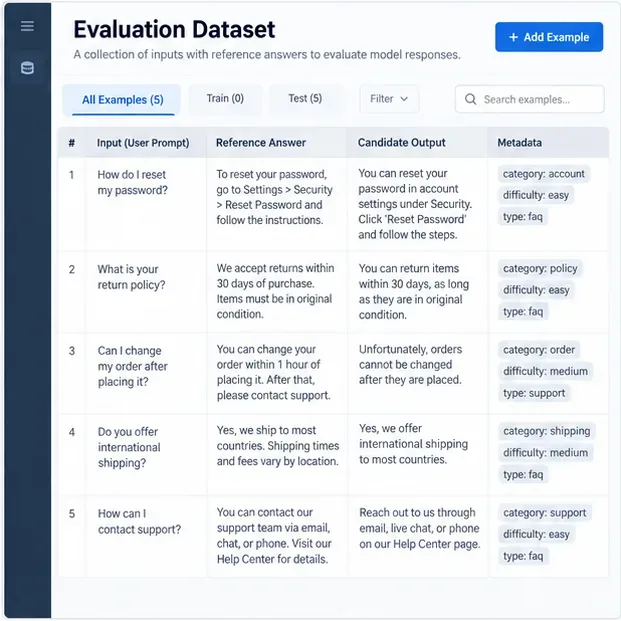
このアプローチが適している場合:ほぼ常に。本番環境での評価を使用する場合でも、回帰テストのために安定したオフラインデータセットが必要です。自由回答形式のタスクに対する参照回答がない場合は、代わりに評価基準、必須事項、禁止事項、またはペアワイズ選好を保存してください。
最も優れた評価システムは、複数の評価者タイプを組み合わせている。なぜなら、すべての問題に最適な単一の採点者は存在しないからである。
OpenAI の現在の Evals API は、評価をテスト基準とデータソーススキーマとして定義し、再利用可能なグレーダーをサポートしています。グレーダー API には、決定論的な文字列チェック、テキスト類似性グレーダー、モデルベースのグレーダーが含まれます。詳細は、 OpenAI Evals API リファレンスとOpenAI グレーダー リファレンスを参照してください。Google Cloud の Vertex AI Gen AI 評価サービスは、ポイントごとのモデルベースおよびペアごとのモデルベース指標と計算ベースの指標をサポートしています。その結果には、インスタンスごとのスコア、説明、集計平均、標準偏差、ペアごとの勝率が含まれます。詳細は、Vertex AI の評価結果に関するドキュメントを参照してください。
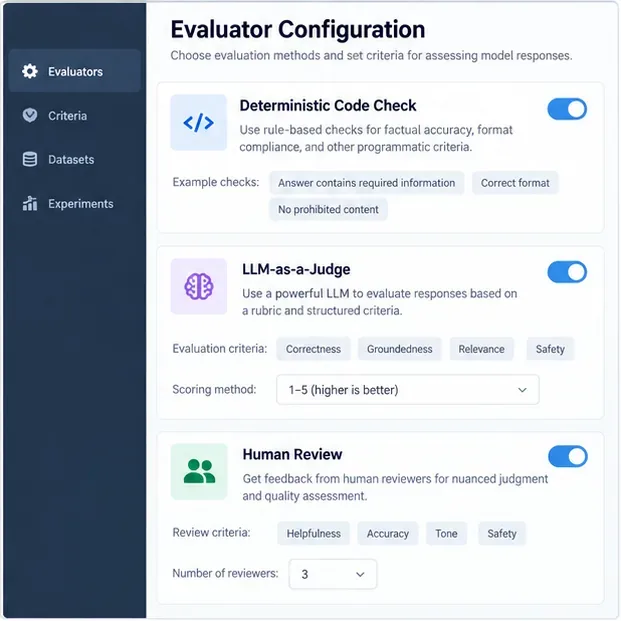
このアプローチが適している場合は、機械で検証可能な要件には決定論的チェックを、意味的品質にはLLMジャッジを、意見の相違がビジネス上または安全上の重大な影響を及ぼす場合には人間によるチェックを使用します。RAGシステムの場合、Ragasはコンテキスト精度、コンテキスト想起、応答関連性、忠実度などのメトリクスに加え、ツール呼び出し精度やエージェント目標精度などのエージェント/ツール使用メトリクスを公開します。Ragasメトリクスのドキュメントを参照してください。DeepEvalも同様に、タスク固有のメトリクスとカスタムLLMジャッジ評価(G-Evalスタイルのスコアリングを含む)を提供します。DeepEvalメトリクスのドキュメントを参照してください。
絶対スコアは有用ですが、リリース判断は、既に信頼しているバージョンと比較して新しい構成をテストした方が通常は明確になります。データセット、評価者定義、モデルパラメータ、サンプリング設定はできる限り安定させてください。そして、同じ例を並べて比較してください。
少なくとも3段階の結果を追跡する:
非決定論的なシステムの場合、重要なテストは、一度の完了でモデルが代表されると仮定するのではなく、変動性を理解するために十分な回数再実行してください。リリース決定が重要な場合は、平均値のわずかな変化だけに頼るのではなく、同じ例に対してペア比較を行い、不確実性を報告してください。
LangSmithは、バージョン比較やペアワイズ評価のためのオフライン実験をサポートしています。一方、MLflowの現在のGenAI評価スタックは、評価データセット、組み込みおよびカスタムスコアラー、LLMジャッジ、人間のフィードバック、トレース、および本番環境の監視をサポートしています。詳細は、LangSmithの評価およびMLflow LLMとエージェントの評価を参照してください。
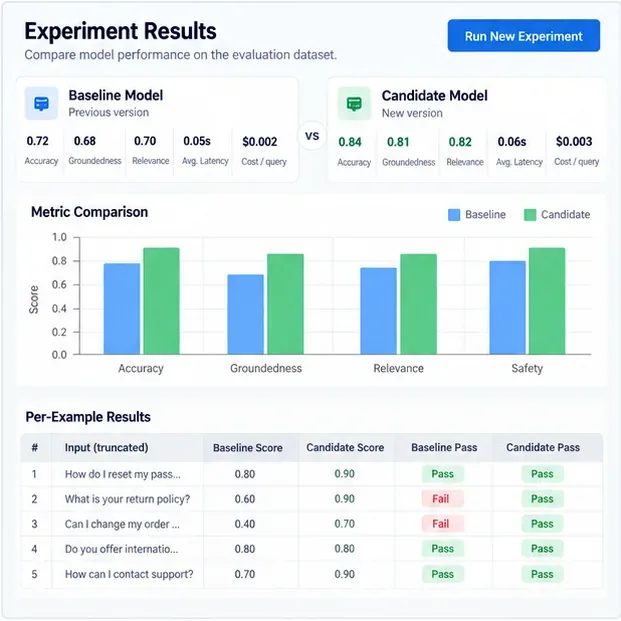
このアプローチが適しているのは、モデル、システムプロンプト、検索パイプライン、ツール実装、またはデコード設定を変更する場合です。候補は、集計指標が1つ上昇したという理由だけで昇格させるべきではありません。重要なディメンションでリリースしきい値を満たし、許容できないスライスレベルの回帰を回避する必要があります。
評価実行は、その後の行動を変える場合にのみ価値があります。失敗を深刻度と根本原因で分類してください。グラウンディングスコアが低い原因としては、検索能力の低さ、推測を促すプロンプト、曖昧すぎる評価基準、または誤った参照回答などが考えられます。モデルを変更する前に、基となる例をよく読んでください。
次に、重要な不具合を恒久的な回帰テストケースとして昇格させます。これにより、好循環が生まれます。本番環境で不具合が発見され、担当者がそれを確認し、ケースがオフラインデータセットに追加され、修正がテストスイート全体でテストされ、将来のリリースで同じ問題が再発しないようにします。
LLMの審査員も評価が必要です。Googleのドキュメントでは、モデルベースのメトリック出力と人間の評価を比較して、審査員が特定のユースケースに適しているかどうかを評価する方法が明確に説明されています。OpenAIのGDPvalも同様に、専門家によるペアワイズ評価を主要な基準として使用し、自動評価は専門家の判断の代替ではなく近似値として説明しています。審査員モデルの評価に関するVertex AIのガイダンスとOpenAIのGDPval手法を参照してください。
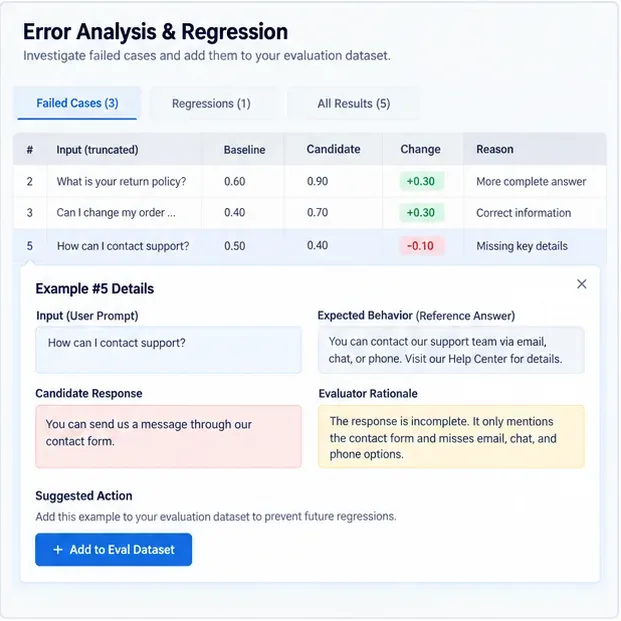
このアプローチが適している場合:重大なエラーが発生した場合、およびLLM審査員がリリースゲートに影響を与える場合は常に適用します。人間のレビュー担当者が審査員の判断に繰り返し同意しない場合は、評価基準を修正するか、より明確な参照情報を提供するか、審査員モデルを変更するか、またはその基準を人間のレビューに戻します。
LLM評価者は、人間によるレビューでは到底及ばない規模で自由形式の成果物を評価できるため、非常に強力です。オリジナルのG-Eval研究では、調査対象とした要約設定において、従来の自動評価指標よりも人間の判断との相関性が大幅に向上したと報告されています。ただし、同論文では、LLM評価者がLLM生成テキストを優遇する可能性があると警告しています。オリジナルのG-Eval論文を参照してください。
MT-BenchとChatbot Arenaに関する個別の研究では、優秀なLLMジャッジは人間の好みにうまく合致する一方で、立場、冗長性、自己顕示欲、推論に関連するバイアスも記録できることが分かりました。LLMをジャッジとして用いた元の研究を参照してください。
実践的な結論は「LLMジャッジを絶対に使用しない」ということではありません。重要なのは、ジャッジを適切に調整することです。人間がラベル付けしたサンプルを作成し、一致度を測定し、不一致のカテゴリーを精査し、位置効果が考えられる場合はペアワイズテストで回答順序をランダム化または入れ替え、曖昧なジャッジの指示がすべてのリリース決定を暗黙のうちに決定づけることを避けるべきです。
| フレームワーク | 最適なフィット感 | 特筆すべき強み |
|---|---|---|
| OpenAIの評価ツールと採点者 | 既にOpenAI APIを使用しており、APIネイティブな評価実行を希望するチーム | 決定論的およびモデルベースの採点者による再利用可能な評価定義 |
| ラングスミス | トレース、データセット、オフライン回帰テスト、オンライン評価を必要とするLLMアプリケーション | 強力な実験比較と生産フィードバックループ |
| ラガス | RAGパイプラインとエージェント/ツール使用状況の評価 | 目的に特化した検索、忠実度、関連性、およびツール指標 |
| DeepEval | テスト形式の評価とカスタマイズ可能なLLM審査員を求めるPython中心のチーム | 広範な指標カタログ、コンポーネント/エンドツーエンド評価、およびエージェント軌跡指標 |
| MLflow GenAI評価 | 既にMLflowを使用しているチーム、または評価をトレースとライフサイクル管理に関連付けたいチーム | データセット、スコアラー、人間のフィードバック、実験追跡、および生産監視 |
| Vertex AI Gen AI評価 | Google Cloud のデプロイメント | ポイントワイズ、ペアワイズ、モデルベース、および計算ベースの評価ワークフロー |
フレームワークの選択よりも、評価設計の方が重要です。高度なプラットフォームでも不十分な評価スイートを構築できますし、少数のスクリプトで強力な評価スイートを構築することも可能です。テストの再現性、バージョン管理、容易な検証、そして重要な変更を行う前に容易に実行できるツールを優先的に選択しましょう。
制作アシスタントにとって、有用なリリース決定は、単一の総合スコアではなく、一連のゲートとして表現できます。例えば、厳選された安全セットにおける重大な安全障害がゼロであること、タスクの正しさに統計的に意味のある低下がないこと、RAG質問に対する最低限のグラウンディング合格率、すべてのスキーマケースにおける有効な構造化出力、そして運用予算内でのレイテンシまたはコストなどが挙げられます。正確な閾値は、リスク許容度とユーザー要件に基づいて決定する必要があります。LLMが「十分」であると判断できる普遍的なパーセンテージは存在しません。
また、スコアの根拠となる生データも保存しておきましょう。リリースが0.84から0.86に改善した場合でも、どの2つのケースが変更されたのか、そしてそれらの変更が重要かどうかを知る必要があります。実際には、追跡可能性のない見栄えの良いダッシュボードの平均値よりも、明確に分類された少数の失敗事例からの方が、チームはより多くのことを学ぶことができます。
LLM応答品質の測定は、単なる雰囲気チェックではなく、工学的な専門分野です。まず代表的なデータセットを用意し、タスク固有の品質次元を定義し、要件が計算可能な箇所では決定論的なチェックを選択し、意味論的な判断が必要な箇所ではLLM判定者を使用し、その判定者を人間と照合してキャリブレーションを行い、候補となる変更点を安定したベースラインと比較します。そして、現実世界で発生した重要な不具合はすべて、将来の回帰テストに活用します。
そのループを辿っていくと、評価フレームワークは単なるレポートダッシュボード以上のものになります。プロンプト、モデル、検索の変更、またはエージェントの更新が実際に製品を改善したかどうかを教えてくれる品質管理システムになるのです。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








