Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
トラブルシューティングの前に、2026年版の重要な点を明確にしておきましょう。ElevenLabs Dubbingは現在、リップシンクを単独で実行しません。ElevenLabsによると、リップシンクはImage & Video、Flows、Studioで専用のサードパーティ製モデルを通じて別途利用可能です。一方、HeyGenは現在、翻訳をAudio Only、Speed lip sync、Precision lip syncに分けています。つまり、適切な解決策は、ワークフローのどの部分で実際に口の動きのアニメーションが作成されるかによって異なります。
ElevenLabsで音声を生成し、HeyGenでアバターをアニメーション化する場合は、ElevenLabsファイルを音声ソースとして、HeyGenをリップシンク段階として扱ってください。ElevenLabs Dubbingを使用して翻訳する場合、Dubbingステップだけで口の動きが変わるとは期待しないでください。完成した音声は後でリップシンクツールに送ってください。HeyGenで既存のビデオを翻訳する場合は、より高負荷なモードが常に必要だと決めつけるのではなく、映像に基づいてリップシンクエンジンを選択してください。
このガイドは、2026年9月13日時点のHeyGenおよびElevenLabsの最新ドキュメントに基づいて検証されています。製品の管理方法やクレジットレートは変更される可能性があるため、リンク先の公式ページが正確な情報源となります。
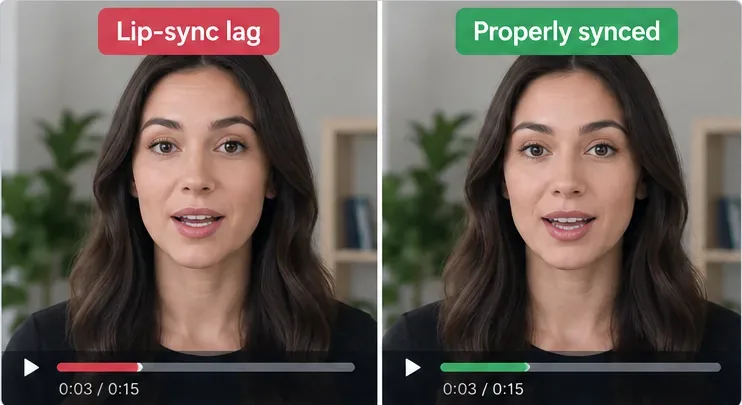
「リップシンクの遅延」は、いくつかの異なる状況を指す可能性があります。間違ったレイヤーを修正すると、世代とクレジットが無駄になります。
| あなたが見るもの | 考えられる問題 | 最良の最初の行動 |
|---|---|---|
| 口は最初から最後までほぼ同じ量だけ遅れている | 音声/映像のずれが一定、または先行する無音 | 動画全体を再生成する前に、音声をトリミングまたはシフトしてください。 |
| 最初の文は一致するが、時間の経過とともにずれがひどくなる。 | 音声の長さと動画のタイミングが乖離している | 再生速度を速める、シーンを分割する、または再生時間の調整を使用する |
| 特定の単語だけが間違っているように見える | 音素と発音の不一致 | 影響を受けた文を再生成するか、より高精度のリップシンクパスを使用してください。 |
| 正面からの写真はうまくいくが、横からの写真はうまくいかない | 視覚追跡の難しさ | HeyGen Precisionを使用するか、ソースショットを簡略化してください。 |
| ElevenLabsの吹き替えはタイミングが良いが、オリジナルの口の動きは変わらない | 吹き替えが口パクと間違えられた | 吹き替え音声を専用のリップシンクモデルまたはHeyGenに送信します |
よくあるワークフローのミスとして、ElevenLabsで音声を生成した後、ビデオツールでスクリプトを合成または再解釈してしまうことが挙げられます。これではタイミングの決定が2つ必要になり、1つで済むはずが2つになってしまいます。ElevenLabsで生成した音声が目的のものであるなら、まずその音声を完成させ、アバターシーンのソースとして一貫して使用してください。
HeyGenの現在のStudioドキュメントによると、カスタムオーディオは、事前に録音したファイルをアップロードするか、直接オーディオを録音することで追加できます。Studioはスクリプト中心のシステムであり、HeyGenは、アバターを生成する必要があるため、編集中はアニメーションアバターの完全なプレビューは利用できないと述べています。ただし、提出前にオーディオをプレビューすることは可能です。
推奨事項:高負荷なシーンや長時間のシーンの場合は、まず短いテストシーンを作成してください。フルランタイムを実行する前に、音声、顔の表情、口の動きを確認してください。
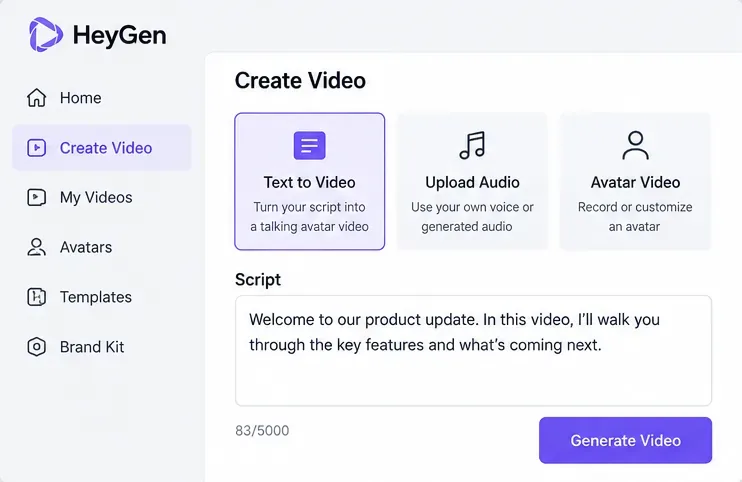
公式情報源:HeyGenヘルプセンター:Studioで最初のビデオを作成しましょう。
話し方が早口だったり、異常に遅かったり、不自然な間が多かったりすると、ビデオジェネレーターはそのタイミングに合わせてアニメーションを作成する必要があります。口の動きのアニメーションが既に生成された後に修正しようとする音声よりも、きれいな音声の方が同期が容易です。
ElevenLabsは現在、テキスト読み上げ機能において、音声速度を0.7から1.2の範囲で制御できると説明しており、1.0が標準速度としています。同社は、極端な値を設定すると品質が低下する可能性があると警告しています。また、ベストプラクティスに関するドキュメントでは、過剰なポーズマークアップは不安定性や予期せぬペースの変化を引き起こす可能性があるとも指摘しています。
トレードオフ:速度を変えることで文章を目標の長さに収めることはできますが、同時にパフォーマンスも変化します。声が早口になったり、不自然に引き伸ばされたりする場合は、速度をさらに上げるよりも、文章を書き直す方が通常は良いでしょう。
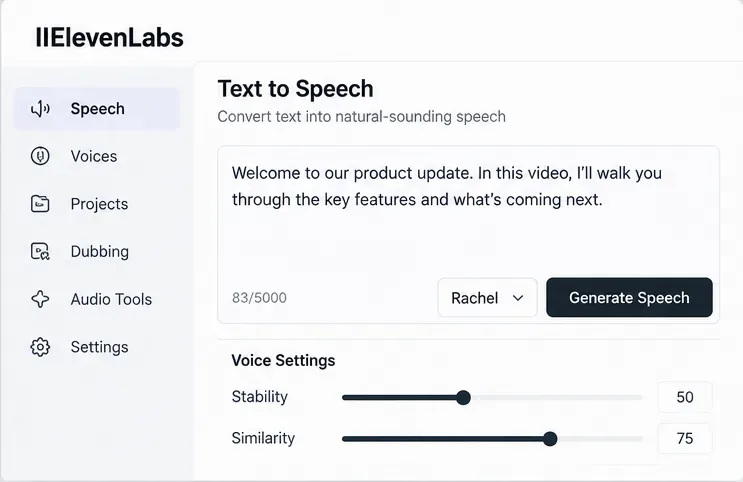
公式情報源:ElevenLabs:音声のペースを変更する、およびElevenLabsのテキスト読み上げのベストプラクティス。
ElevenLabsの公式ドキュメントには、現在1つの点で矛盾があります。ヘルプセンターでは、速度設定はすべての音声とモデルで利用可能と記載されている一方、テキスト読み上げ製品ガイドには、Eleven v3では速度設定が利用できないというモデル固有の注記があります。どちらの記述も公式であるため、速度スライダーが必ず表示されると決めつけるのではなく、選択したモデルに実際に表示されるコントロールを確認してください。
対処法:選択したモデルが Speed を公開していない場合は、存在しないコントロールに頼るのではなく、言葉遣い、句読点、モデル固有のオーディオ タグ、または別のサポートされているモデルを使用してタイミングを制御します。
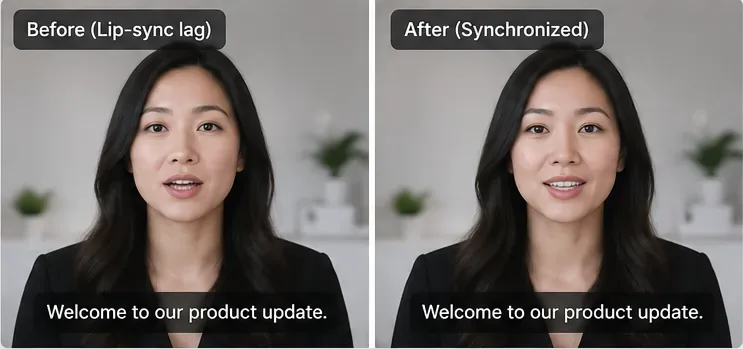
口の動きが常に同じ量だけ遅れたり早かったりする場合は、AIモデルを変更する必要がないかもしれません。タイムラインで音声ファイルを確認してください。最初の子音の前に少しだけ前置きがあったり、意図した開始位置から数フレーム離れたところに音声クリップが配置されていると、リップシンクが失敗したように見えることがあります。
例えば、30fpsで4フレームのずれは約133ミリ秒に相当します。これは、口の動き自体が内部的に一貫していても、クローズアップの会話シーンでは不自然に見えるほど大きなずれです。
対処法:最初の明瞭な音声トランジェントを、想定される映像の開始位置に合わせます。生成後もずれが解消されない場合は、すべてのアセットを再生成するのではなく、ビデオエディターで音声をシフトしてください。
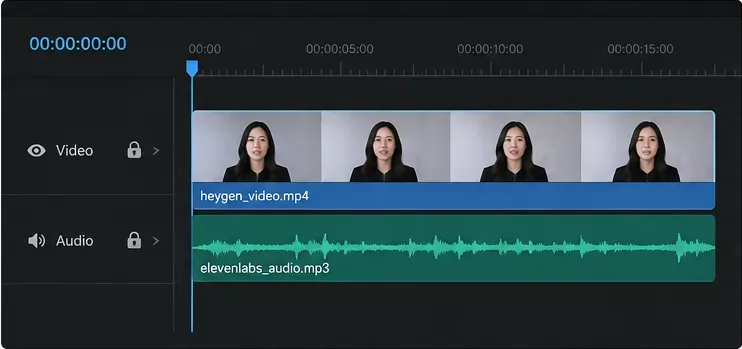
漸進的なずれは、固定的なずれとは異なります。最初の数秒間は正しく見えても、口の動きが徐々に遅れていく場合は、発話時間と映像のタイミングが十分に合っていないことを意味します。長い連続シーンでは、わずかなタイミングのずれも拡大されます。
長いナレーションを短い論理的な文章やショットに分割し、それぞれを個別に生成してから後で結合します。こうすることで、一部に誤りがあった場合でも、より小さな単位で再生成できます。HeyGenのVoice Mirrorのガイダンスでも、望ましいペース配分や処理動作を習得しながら、短いセグメントから始めることを推奨しています。
トレードオフ:セグメントを短くすると修復しやすくなりますが、カットが多すぎると音色や雰囲気が損なわれる可能性があります。スクリプトで指示されている場合を除き、隣接するセグメント間で同じ音声設定を維持し、パフォーマンススタイルを変更しないようにしてください。
公式情報源:HeyGenヘルプセンター:ボイスミラーとダイレクトボイス。
HeyGenの現在のビデオ翻訳システムでは、3種類のエンジンを選択できます。
2026年9月13日現在、HeyGenのヘルプセンターでは、現在のクレジットシステムにおいて、スピードは1分あたり6クレジット、精度は1分あたり10クレジットと記載されています。このレートはトレードオフを理解する上で役立ちますが、価格は変更される可能性があるため、生成前に製品情報を確認してください。
推奨事項:カメラから約45度以内の角度で、顔がはっきりと映っている話し手1名の場合は、スピードモードを使用してください。映像自体のトラッキングが難しい場合は、プレシジョンモードにアップグレードしてください。クレジットを追加しても、ソースオーディオの不具合は修正されませんので、まずはペース配分の問題を解決してください。
HeyGenはまた、翻訳のリップシンクを向上させるために、クローズアップ撮影、カメラカットの最小化、背景ノイズの低減、そして一度に一人だけが話すことを推奨している。
公式情報源:HeyGenヘルプセンター:ビデオ翻訳を始めましょう。
異なる言語では、同じ考えを伝えるのにかかる時間が全く同じになることはほとんどありません。HeyGenの現在の高度な設定には「動的再生時間を有効にする」という機能があり、セグメントの再生時間を最大±20%まで伸縮させて、より自然な翻訳音声を作成できます。HeyGenは、これにより動画全体の長さが変わる可能性があると注意を促しています。
ダイナミック・デュレーションを選択する場合:元の正確な実行時間を維持することよりも、自然な配信が重要な場合。
次のような場合は、この機能に頼らないようにしてください。動画が音楽、固定グラフィック、放送枠、または外部タイミングの合図にフレーム単位で正確に同期する必要がある場合。その場合は、まず翻訳を書き直すか、ElevenLabsの音声タイミングを調整してください。
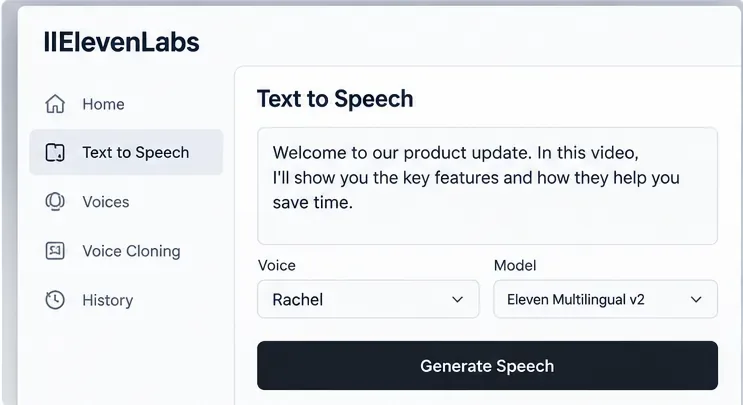
これは、両プラットフォーム間のワークフローにおける最も重要な違いです。ElevenLabsの現在のダビングに関するドキュメントには、ダビングにはリップシンク機能は含まれていないと明記されています。リップシンクツールは、ElevenLabs Image & Video、Flows、およびStudioにそれぞれ専用のモデルで別途提供されています。
ElevenLabs Dubbing v2は現在アルファ版として位置づけられています。タイミング、トーン、話者特性は保持されますが、デフォルトのv2ウェブワークフローは自動化されており、アプリ内での文字起こし編集機能は提供されていません。文字起こし編集とv2 APIによる音声再生成は、現在エンタープライズ版のみとなっています。v1をベースとしたDubbing Studioは引き続き利用可能ですが、メンテナンスモードとなっており、重大なバグ修正のみが行われています。
HeyGenとElevenLabsのワークフローの場合: ElevenLabsで最終的な音声を生成または吹き替えし、承認された音声をHeyGenにアップロードして口のアニメーションを作成します。
公式情報源:ElevenLabs:吹き替えにはリップシンクが含まれますか?およびElevenLabsの画像とビデオのドキュメント。
ElevenLabs Image & Videoは現在、ソース画像または動画と音声に対応した専用のリップシンクモデルを提供しています。ドキュメントには、HeyGen Avatar 4、Sync 3、Sync Lipsync 2 Pro、Veed Lipsyncなどのオプションが記載されています。モデルや地域によって利用可能状況が異なり、例えば、OmniHuman 1.5は米国では利用できないと記載されています。
トレードオフ: 1つのワークスペースに留まることでアセット管理は簡素化されますが、これらはそれぞれ独自のコストと制約を持つ、個別のポストプロセスまたはアバターモデルです。吹き替え機能自体と混同しないでください。
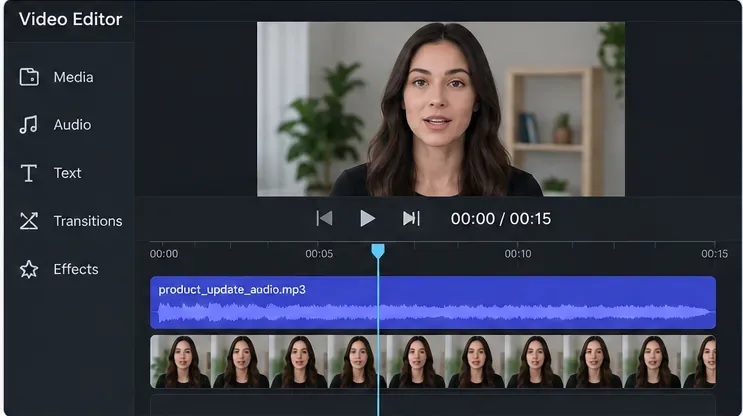
ペース、ソースオーディオ、リップシンクモードを調整した後でも、わずかなずれが残る場合があります。クリップ全体を通して口の動きが同じ量だけ早かったり遅かったりする場合は、タイムラインを再度フルジェネレーションするよりも、最終的なタイムライン調整の方がコストが安く、結果も予測しやすいことが多いです。
オーディオトラックを数フレーム移動させ、p、b、mなどの破裂音をプレビューし、開始、中間、終了の少なくとも3つのポイントを確認します。オフセットが時間とともに変化する場合は、トラック全体を微調整し続けないでください。これは固定オフセットではなく、ずれを扱っているためです。ペース配分またはセグメントの長さに戻ってください。
一時停止の処理方法はモデルによって異なります。ElevenLabsによると、Eleven v3はSSMLブレークタグではなく、オーディオタグと句読点を使用します。Multilingual v2、Flash v2、およびFlash v2.5は、<break time="1.5s" />最大3秒までのSSMLスタイルの一時停止をサポートしています。同社は、ブレークタグが多すぎると、速度の変化、ノイズ、その他の不具合が発生する可能性があると警告しています。
推奨事項:スクリプトを自然に表現するために必要な最小限のポーズマークアップを使用してください。翻訳された文章が、映像のタイミングに合わせるためだけに多くの人工的なポーズを必要とする場合は、文章を書き直すか、ショットを分割してください。
公式情報源:ElevenLabs:一時停止を追加する方法。
生成された音声がすべて不正確な場合(たとえ音声がクリアであっても)、問題は現在の音声ファイルではなく、アバターのトレーニング映像にある可能性があります。HeyGenのデジタルツインに関するガイドラインでは、音声と映像はシステムのリップシンク機能にとって非常に重要であるため、トレーニング映像には実際に話している人物が含まれている必要があると述べています。同社は、少なくとも1080p、30fps、明るく均一な照明、強いエコーや外部ノイズのないクリアな音声を推奨しています。
対策:アバターが複数のクリーンなスクリプトで一貫して苦戦する場合は、生成されたクリップを一つ一つ微調整する前に、より質の高いソース映像を使って再学習させることを検討してください。
公式情報源:HeyGen:Avatar IVでデジタルツインを作成。
| あなたの優先事項 | 推奨されるワークフロー | 主なトレードオフ |
|---|---|---|
| ElevenLabsが承認したナレーションによる、早口のトークビデオ | まずElevenLabsの音声を生成し、次にそれをHeyGen Studioにアップロードします。 | ワークフローはシンプルだが、最終的なアバターには世代交代が必要となる。 |
| シンプルな正面向きのソースビデオを翻訳する | HeyGenの高速動画翻訳 | Precisionよりもクレジットコストは低いが、複雑なショットにはあまり適していない。 |
| 横顔、遮蔽物、または複数話者の映像を翻訳する | HeyGenの高精度ビデオ翻訳 | より高いリップシンク精度と引き換えに、より多くのクレジットを利用できるようにする |
| 口の動きのない高品質な翻訳音声 | ElevenLabs ダビング | 吹き替えはタイミングと声の特徴を維持するが、それ自体は口パクではない |
| 音声とリップシンクはElevenLabs内で完結させる | ElevenLabs Image & Video社製、リップシンク専用モデル搭載 | モデルの入手可能性、価格、地域制限は異なります |
| わずかな固定オフセットのみが残る | 通常のビデオエディターでオーディオをシフトする | 高速かつ安価だが、一定のオフセットにのみ適しており、ドリフトには適さない。 |
リップシンクのずれを解消する最善の方法は、単一の設定変更ではなく、状況診断です。クリップ全体でずれが均一な場合は、ずれを修正してください。ずれが時間とともに大きくなる場合は、ペースやセグメントの長さを調整してください。難しいアングルでのみずれが発生する場合は、より強力なリップシンクモードを使用してください。ElevenLabs Dubbingを使用している場合は、Dubbing自体では口の動きがアニメーション化されないため、リップシンク用のステージを別途追加してください。
ほとんどのHeyGen + ElevenLabsワークフローでは、最も手間のかからない方法は、ElevenLabsでクリーンな音声を最終化し、HeyGenで短いセグメントをテストし、ソース映像に基づいてスピードまたは精度を選択し、生成後に残る小さな定数オフセットに対して外部タイムライン補正を使用することです。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








