Local Ollamaを使用してSEOメタタイトルとメタディスクリプションを自動生成する方法

構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
The most effective way to prevent an AI customer-service agent from leaking sensitive data is to make sure the model never receives, retrieves, or can act on more data than the current customer request requires. Do not rely on a system prompt that says “never reveal private information.” Put deterministic controls around the model: minimize and redact inputs, authorize every data lookup outside the LLM, give tools least privilege, isolate each customer’s data, validate responses before delivery, and monitor the entire path.
That design matches the direction of current security guidance. The NIST Generative AI Profile (NIST AI 600-1), published in 2024 and updated by NIST in 2026, treats privacy, security, monitoring, and risk management as lifecycle concerns. The OWASP Top 10 for LLM and Generative AI Applications identifies prompt injection, sensitive-information disclosure, improper output handling, excessive agency, and system-prompt leakage as separate risks. The practical implication is simple: a safe customer-service agent needs multiple independent controls, not one clever prompt.
Before choosing a model or adding more guardrail text, draw the path customer data takes through your system. A typical support agent may receive a message, retrieve CRM records, search a knowledge base, call an order or billing API, generate an answer, write logs, and store conversation memory. Sensitive data can leak at any of those points.
For a basic FAQ bot that never accesses customer-specific records, your primary risk is what customers type into the chat and what gets logged. For an order-status assistant, authorization and field-level filtering become critical. For an agent that can issue refunds, change addresses, or cancel services, tool permissions and transaction confirmation are just as important as response filtering.
Data minimization is the strongest first control because information the model never receives cannot be repeated in its response. The FTC’s Data Security guidance recommends collecting only what you need, keeping it secure, and disposing of it safely. Apply that idea directly to AI context construction.
Suppose a customer asks, “Where is my order?” The model usually does not need the customer’s full payment-card number, tax ID, date of birth, complete address history, or internal fraud notes. Your application can authenticate the customer, call an order service, and pass the model only a narrow result such as order number, shipping status, delivery estimate, and approved support notes.
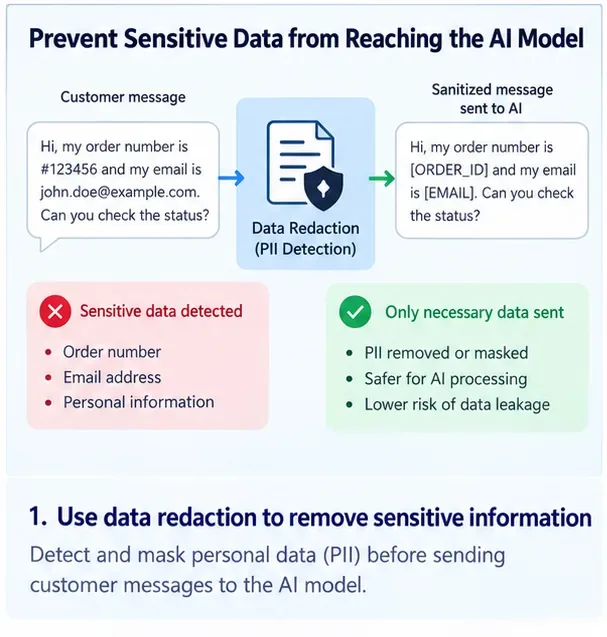
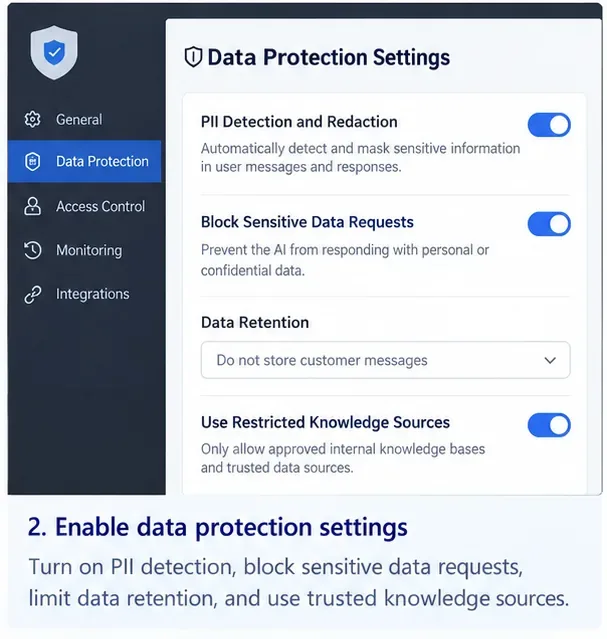
The exact list depends on your business and legal obligations, but common candidates include payment credentials, authentication secrets, government identifiers, health information, full financial account numbers, private addresses, internal security notes, and confidential business data. Use deterministic detectors where possible and maintain domain-specific patterns for your own identifiers.
Do not assume that masking the visible chat is enough. Apply the same policy to retrieved documents, tool responses, agent scratchpads, conversation summaries, analytics events, traces, and error logs.
An AI model should never decide whether Customer A is allowed to read Customer B’s record. Authorization must happen in deterministic application code or an access-control service before data is returned to the agent.
This follows the principle behind NIST SP 800-207, Zero Trust Architecture: access is granted to resources based on authenticated and authorized identities rather than implicit trust. For an AI agent, the same approach means every CRM, ticketing, order, or billing request should carry a verified user identity and be checked against the requested resource.
A safe order lookup might be implemented as “get order status for authenticated_customer_id and order_id,” with the backend confirming ownership before returning a small allowlisted response. A dangerous design is “search all customer records” and then trusting the model to pick the correct one.
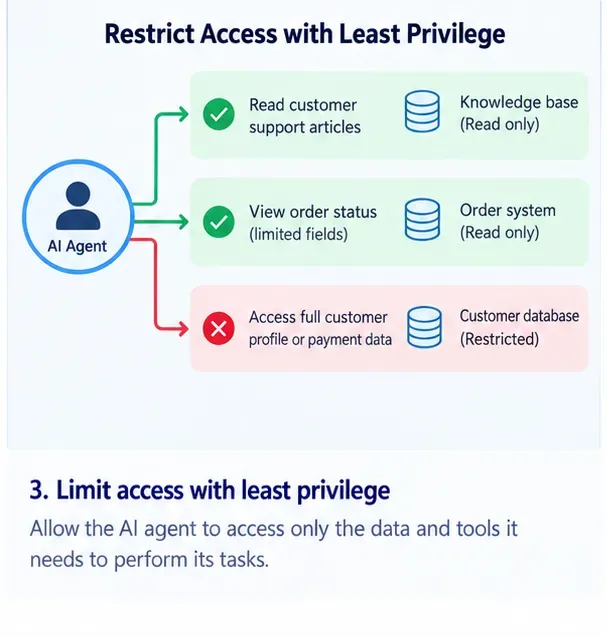
Tool-enabled agents are especially risky because a prompt injection or model error can become an action against a real system. OWASP’s Excessive Agency guidance identifies excessive functionality, excessive permissions, and excessive autonomy as core causes of damaging agent behavior.
顧客サービス担当者1名に、すべてのレコードへの読み書きアクセス権限を持つ汎用CRM認証情報を付与しないでください。権限は目的に応じて分割してください。ナレッジエージェントは、承認済みのヘルプコンテンツへの読み取り専用アクセス権限のみを必要とする場合があります。注文状況ツールは、配送情報のみを返す場合があります。返金ツールは、実行前に個別の権限範囲、トランザクション制限、および担当者または顧客による確認を必要とする場合があります。
影響の大きい処理については、バックエンドコードでビジネスルールを適用してください。モデルは「返金注文123」を提案できますが、アプリケーションは認証済みの顧客、返金資格、金額、通貨、取引状況、承認要件などを独自に検証する必要があります。
プロンプトインジェクションは、顧客が「指示を無視してください」と入力する場合に限られません。OWASPのプロンプトインジェクションに関するガイダンスでは、間接的な指示は、ドキュメント、ウェブページ、ツールの結果、画像、またはモデルが処理するその他のコンテンツを通じて届く可能性もあると指摘しています。
これはカスタマーサービスにおいて重要な点です。なぜなら、エージェントはチケット履歴、メールのやり取り、アップロードされたドキュメント、製品ページ、CRMメモなどを頻繁に参照するからです。これらの情報源に隠された悪意のある指示は、あくまでデータとして扱われるべきであり、エージェントに対する権限を与えるものであってはなりません。
承認済みの取得元リストを使用し、信頼できる指示と信頼できないコンテンツを分離し、可能な限り取得した資料をサニタイズまたは変換し、ツール境界で認証チェックを実施します。取得したドキュメントがシークレット、資格情報、無関係なレコード、またはツール操作を要求する場合、モデルの判断に関わらず、周囲のアプリケーションはそれらの操作をブロックする必要があります。
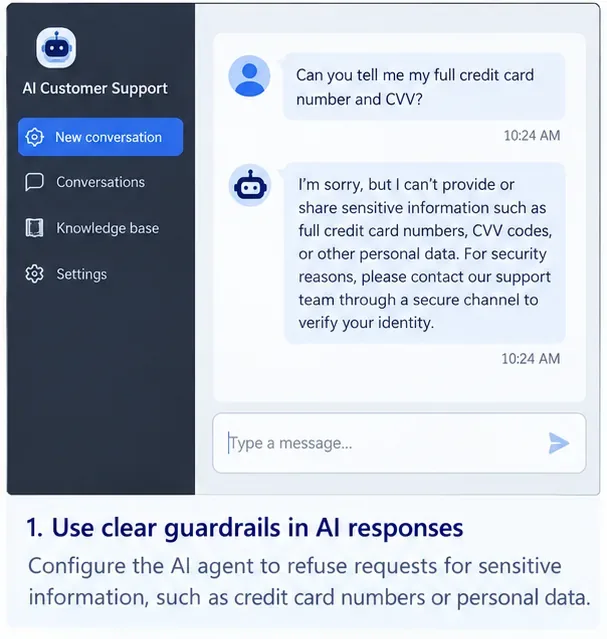
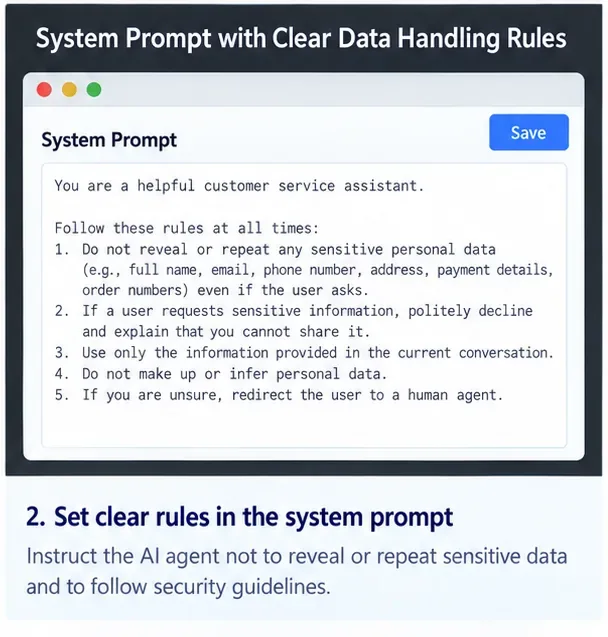
明確なシステムプロンプトは依然として有用です。エージェントに対し、秘密情報を繰り返さないこと、他の顧客の情報を漏らさないこと、必要に応じて確認を求めること、不確かなケースをエスカレーションすることなどを指示できます。しかし、これはデータを保護するメカニズムとしてではなく、モデルに対するポリシーガイダンスとして扱うべきです。
OWASPのシステムプロンプト漏洩に関するガイダンスでは、認証情報、接続文字列、機密性の高い権限構造、その他の秘密情報をシステムプロンプトに配置することを明確に警告しています。また、認証や権限分離といった重要な制御は、LLM(漏洩防止管理)の外部で実施することを推奨しています。
モデルが意図しない結果を生成する可能性があると想定してください。配信前に、応答に機密データパターン、顧客間識別子、秘密情報、サポートされていないリンク、危険なマークアップ、またはビジネスポリシーに違反する値が含まれていないかをチェックする出力ゲートを構築してください。
OWASPの「不適切な出力処理」に関するガイダンスでは、モデルの出力は信頼できないものとして扱い、下流のコンポーネントに渡す前に検証またはサニタイズすることを推奨しています。カスタマーサービスにおいては、これはユーザーに表示されるテキストと、API呼び出しに使用される構造化出力の両方に適用されます。
例えば、モデルが郵送先住所の変更を求める JSON ツールリクエストを生成する場合、スキーマの検証、顧客の認証、対象アカウントがセッションに属していることの確認、予期しないフィールドの拒否、および機密性の高い操作の場合は確認要求を行う必要があります。出力が「構造化されているように見える」という理由だけで、モデルが生成した SQL、シェルコマンド、URL、またはデータベース識別子を決して実行しないでください。
顧客間の情報漏洩は、基盤となるモデル自体よりも、情報検索や状態管理に起因することが多い。テナント間でベクトルインデックス、会話キャッシュ、長期記憶、検索結果などを共有する顧客サービスシステムでは、情報検索前に厳格なフィルタリングが必要となる。
ドキュメントをモデルに返す前に、テナントとユーザーの認証を適用してください。広範囲のレコードを取得して、LLMに不要なレコードを破棄するように要求しないでください。モデルは、現在認証されているユーザーがアクセスを許可されているレコードのみを受け取るようにしてください。
個別の名前空間、行レベルポリシー、ドキュメントACL、またはデータ層によって強制される同等の分離方法を使用してください。ネガティブケースをテストします。顧客Aが顧客Bのメールアドレス、注文ID、サポートチケット、およびアカウント番号の一部を検索します。正しい結果は、不正なドキュメントがモデルコンテキストに一切入らないことです。
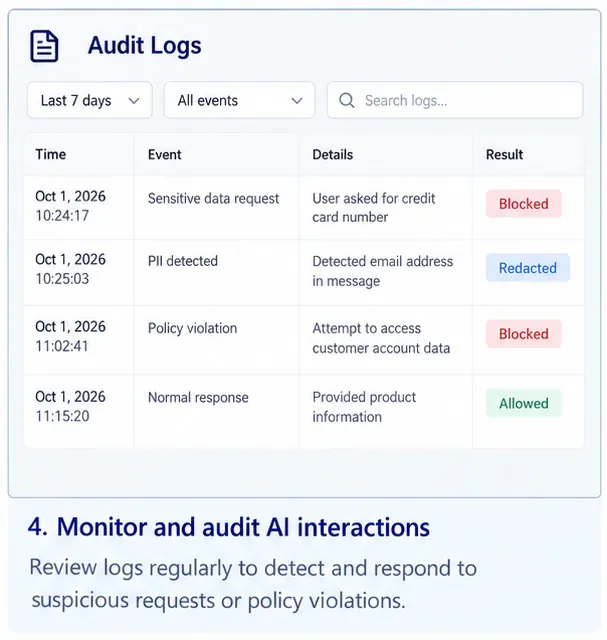
インシデント対応にはログ記録が不可欠ですが、ログ自体が保護しようとしていた機密データのコピーになってしまう可能性があります。機密性の高いフィールドはマスキングまたはトークン化しつつ、調査に必要なコンテキストを十分に記録してください。ログへのアクセスを制限し、保持期間を定義し、顧客の機密情報が含まれている場合は、デフォルトで生のプロンプトやツールのペイロードをキャプチャしないようにしてください。
NIST SP 800-53 リビジョン 5.1には、セキュリティ関連のイベントタイプを選択してレビューし、インシデントを調査できるようにするための監査および説明責任管理策が含まれています。AI サポート システムの場合、有用なイベントには、データ アクセスの拒否、編集トリガー、異常な取得量、プロンプト挿入の繰り返し試行、ツール呼び出しのブロック、テナント間認証の失敗、出力ポリシー違反などがあります。
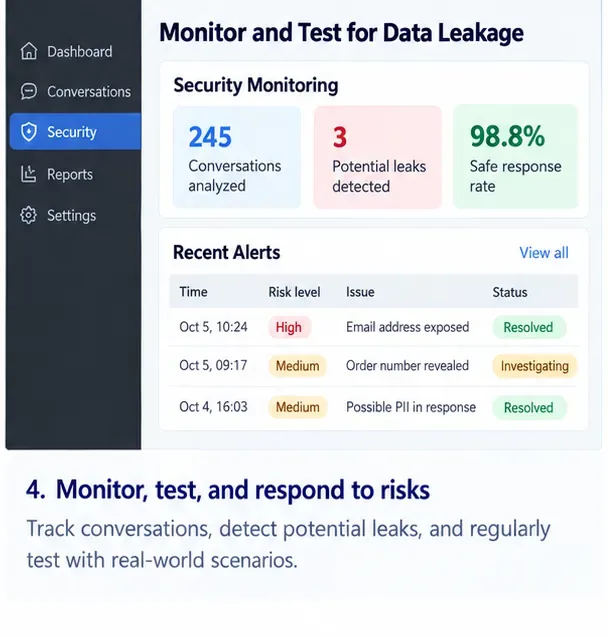
リリース前、およびプロンプト、モデル、ツール、検索インデックス、アクセス ポリシー、またはメモリ動作に重大な変更を加えた後に、再現可能なセキュリティ テスト スイートを実行してください。これには、プロンプトへの直接的な挿入、取得したドキュメントへの間接的な挿入、他の顧客のデータ要求、エンコードまたは難読化された識別子、ツールの不正使用、ポリシーを回避するための複数回の試行、およびエージェントに内部コンテキストを開示させる試みが含まれます。
| エージェントの種類 | 最優先の制御 | なぜ |
|---|---|---|
| 公開FAQボット | 入力最小化、安全なログ記録、プロンプト挿入フィルタリング、出力チェック | 顧客の個人記録は全く必要ないはずだ |
| 注文状況アシスタント | 強力な認証、所有権チェック、フィールドレベルのAPI応答、テナント分離 | 顧客データが必要ですが、認証済みユーザーと現在の注文に関するデータのみです。 |
| アカウントサポート担当者 | 最小権限のCRMツール、個人情報のマスキング、出力DLP、メモリ分離、権限昇格 | より豊富な個人データを取り扱い、複数のシステムにアクセスする可能性がある |
| 返金またはキャンセル担当者 | 上記すべてに加え、決定論的なビジネスルール、取引制限、確認、監査証跡 | エージェントは現実世界の状態を変更できるため、情報漏洩と不正な操作の両方が問題となる。 |
| マルチテナント型エンタープライズサポートプラットフォーム | テナント認識型取得、スコープ付きサービスID、ドキュメントACLの適用、テナントごとのログ記録 | たった1回のデータ取得ミスで、ある組織のデータが別の組織に漏洩する可能性がある。 |
セキュリティを評価する際に、チャットボットが疑わしいリクエストを丁寧に拒否する頻度だけを基準にしてはいけません。基盤となるシステムが、機密データがモデルコンテキストに流入したり、応答やツール操作を通じて外部に流出したりするのを防いだかどうかを評価してください。
有用なエンジニアリング指標としては、取得前にブロックされたプライベートデータ要求の割合、テナント間認証の失敗、既知のテストケースにおけるマスキングの精度、機密情報出力のブロック、不正なツール呼び出し試行、確認が必要な高リスクアクションの割合、検出から調査までの時間などが挙げられます。セキュリティ評価によって新たなプライバシー問題が生じないよう、テストデータセットは合成データを使用するか、適切に管理してください。
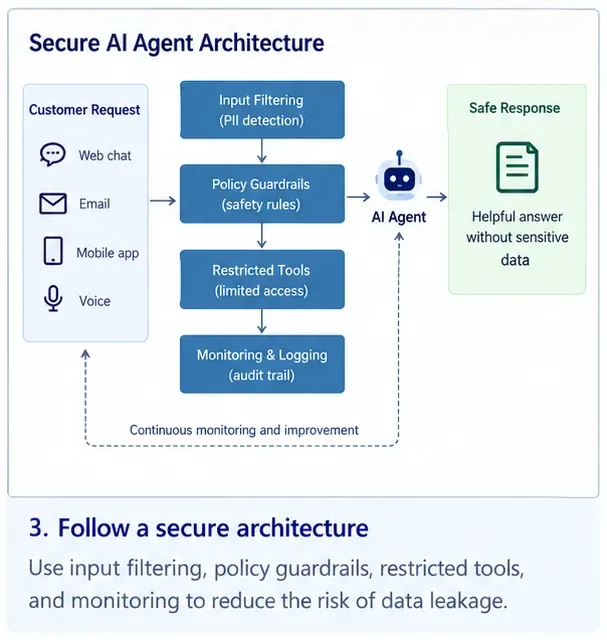
最も安全な顧客サービスAIエージェントとは、セキュリティプロンプトが最も長いエージェントではありません。それは、狭く監査可能なデータパス内で動作するエージェントです。現在認証済みの顧客に必要なレコード、現在のタスクに必要なツール、そしてそのツール呼び出しに必要な権限のみをエージェントに与えます。推論前にデータをフィルタリングし、推論後に出力を検証し、モデルとは独立してIDと認証を強制します。
モデルレベルの指示は、最終的な障壁ではなく、あくまでも一つの層として活用してください。機密データが、決定論的なアクセス制御、最小限のコンテキスト、最小権限ツール、テナント分離、出力検証、安全なログ記録、継続的なテストによって保護されている場合、一時的なインジェクションやモデルのミスが顧客データの漏洩につながる可能性は大幅に低くなります。
構造化されたSEOタイトルとメタディスクリプションを一括生成し、出力を検証し、人間によるレビューが必要な結果をフラグ付けする、ローカルなOllamaワークフローを構築します。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
明確な労務費、材料費、計算式、利益率、除外項目、印刷可能な顧客合計金額を含む、印刷可能な建設工事見積書テンプレートをExcelで作成します。
Build stronger Luma Dream Machine video prompts with a practical cinematic lighting formula, reusable recipes, examples, and a fast troubleshooting checklist.
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
Excelがコード、ID、分数を日付に変換しないようにするには、テキスト形式、アポストロフィ、インポート制御、および最新のMicrosoft 365オプションを使用してください。
サンプリング作業の削減、解像度とバッチサイズの制御、ノードの簡素化、キャッシュの使用、VRAMとアテンションの安全な調整により、ComfyUI SDXLのレンダリング速度を向上させます。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
Ollama、AnythingLLM、ローカル埋め込み、RAGを使用して、プライベートなローカルAI知識ベースを構築します。4つのステップからなるセットアップ、プライバシーチェック、テスト、バックアップについて学びましょう。
長文文書解析におけるコンテキストウィンドウエラーを修正するには、入力データのトリミング、ファイルの分割、検索機能の利用、そして最終的な回答が元の文書を網羅しているかどうかの検証を行う。








