Home
» Domeinen
»
Hoe de rendertijd in ComfyUI te verkorten voor een SDXL-workflow
Hoe de rendertijd in ComfyUI te verkorten voor een SDXL-workflow
De snelste manier om de rendertijd in een ComfyUI SDXL-workflow te verkorten, is meestal door de hoeveelheid diffusiewerk te verminderen voordat de opstartvlaggen op laag niveau worden gewijzigd: test op een redelijke SDXL-resolutie, houd de batchgrootte op 1 tijdens het afstemmen, gebruik minder samplingstappen wanneer de kwaliteit nog steeds goed is, en sla tijdelijk dure extra's zoals refiners, ControlNet-takken, upscale passes of preprocessors over. Pas daarna kunt u het VRAM-, attention-, preview- en cachegedrag afstemmen.
Deze volgorde is belangrijk omdat opstartvlaggen geen compensatie kunnen bieden voor een workflow die de GPU simpelweg twee of drie keer zoveel werk laat doen als nodig is. De huidige ComfyUI-documentatie adviseert ook om eerst de resolutie of batchgrootte te verlagen wanneer de generatie traag verloopt, en vervolgens geheugen- en aandachtoptimalisaties toe te passen waar nodig. De onderstaande richtlijnen zijn gecontroleerd aan de hand van de huidige ComfyUI- en PyTorch-documentatie op 13 september 2026.
Waarom SDXL-workflows traag worden in ComfyUI
Een SDXL-rendering kan op verschillende plekken plaatsvinden: het laden of verplaatsen van modelgewichten, CLIP-tekstcodering, herhaaldelijk ruisonderdrukken in KSampler, ControlNet of andere conditionering, VAE-decodering, opschaling en eventuele tweede renderpasses of verfijningsstappen. Als het VRAM-geheugen beperkt is, kunnen extra gegevensoverdrachten tussen CPU en GPU de latentie verder verhogen.
Dat betekent dat twee gebruikers met dezelfde GPU zeer verschillende rendertijden kunnen ervaren. Een eenvoudige tekst-naar-afbeelding-grafiek met 1024 klassen is niet vergelijkbaar met een workflow die een verfijner, twee ControlNets, een tweede verwerking met hoge resolutie en een grote batch toevoegt. Het doel is om te bepalen welk deel van uw grafiek veel rekenkracht vereist, en dat deel vervolgens te verwijderen of te optimaliseren zonder de uitvoerkwaliteit op te offeren die voor u van belang is.
1. Meet een zuivere nulmeting voordat u iets verandert.
Gebruik één vaste prompt, één vaste seed, batchgrootte 1 en dezelfde uitvoerresolutie. Voer de workflow minstens twee keer uit. De eerste keer uitvoeren kan het laden van checkpoints, compilatie, schijf-I/O of modeloverdrachten omvatten; een latere keer uitvoeren geeft een betere indicatie van de stabiele generatiesnelheid.
Controleer ook of de GPU het werk daadwerkelijk uitvoert. Op NVIDIA-systemen nvidia-smikan het VRAM-gebruik en de GPU-benutting worden weergegeven. Als de GPU-benutting laag blijft terwijl het systeem constant gegevens verplaatst of modellen laadt, kan de bottleneck eerder geheugendruk of I/O zijn dan de sampler zelf.
Controleer het GPU- en VRAM-gedrag voordat u ComfyUI optimaliseert. Beschouw de hier getoonde waarden als een voorbeeldlay-out, niet als een benchmarkdoel.
2. Begin met de kleinste SDXL-grafiek die het gewenste resultaat oplevert.
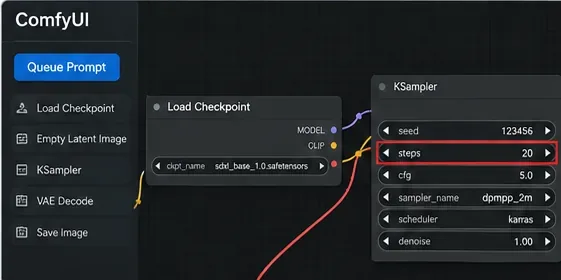
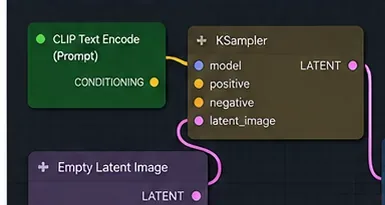
Voordat je een complexe workflow optimaliseert, vergelijk deze dan met een minimaal pad: checkpoint laden, prompt conditioneren, een lege latente afbeelding, KSampler, VAE-decodering en afbeelding opslaan. De officiële voorbeelden van ComfyUI laten zien dat het SDXL-basischeckpoint kan worden gebruikt als een regulier checkpoint. Als deze basisgrafiek snel is, maar je productiegrafiek traag, dan zijn de extra vertakkingen het probleem.
Schakel tijdens het ontwerpen tijdelijk componenten uit die niet essentieel zijn voor de huidige beslissing. Voorbeelden hiervan zijn een verfijner, een tweede opschalingsstap, beeldvoorverwerkers, meerdere ControlNets of optionele stijlvertakkingen. Schakel ze één voor één weer in zodra de basisafbeelding acceptabel is.
Een kleine SDXL-grafiek is de beste basis. Voeg pas tijdrovende vertakkingen toe nadat je weet hoeveel tijd elke vertakking kost.
3. Verlaag het aantal KSampler-stappen voordat u exotische snelheidsinstellingen probeert.
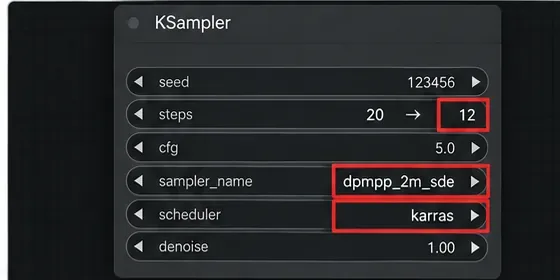
Het aantal samplingstappen is een van de duidelijkste factoren om de rendering te optimaliseren, omdat elke extra ruisonderdrukkingsstap extra werk met zich meebrengt. Als je het aantal stappen verlaagt, zou het samplinggedeelte van de rendering korter moeten worden, hoewel de totale rekentijd niet met exact hetzelfde percentage zal afnemen, omdat het laden van het model, promptcodering, VAE-decodering en andere knooppunten nog steeds tijd kosten.
Neem niet zomaar een universeel 'beste' aantal stappen van iemand anders over. Het juiste aantal hangt af van het checkpoint, de sampler, de scheduler, de prompt, de CFG en het kwaliteitsdoel. Een praktische methode is om de seed vast te houden en een kleine stap te testen – bijvoorbeeld je huidige instelling, dan een bescheiden reductie, en dan nog een reductie. Stop wanneer de texturen, anatomie, typografie of promptgetrouwheid meer achteruitgaan dan je acceptabel vindt.
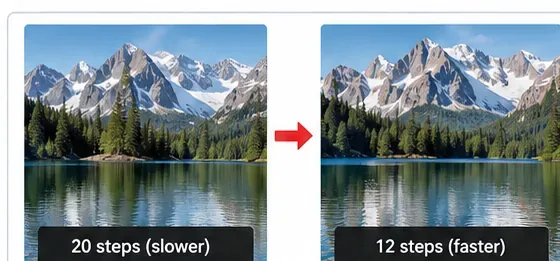
Het verlagen van de KSampler-stappen kan de ruisonderdrukkingstijd verkorten. De getoonde waarden zijn illustratief; controleer de kwaliteit met uw eigen checkpoint en vaste seed.
4. Houd de testresolutie en de batchgrootte onder controle.
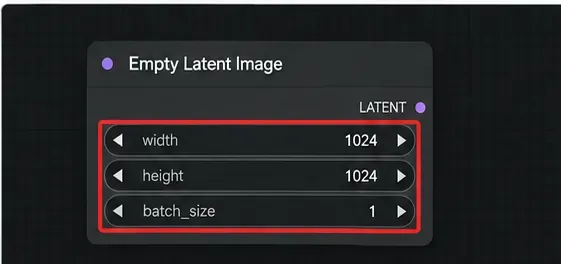
Voor SDXL-schermen adviseert ComfyUI in de officiële SDXL-voorbeelden een resolutie van 1024×1024 of andere beeldverhoudingen met ongeveer hetzelfde aantal pixels, zoals 896×1152 of 1536×640, voor optimaal gedrag van het basismodel. Een aanzienlijk hogere resolutie verhoogt de latentiegrootte en daarmee het reken- en geheugengebruik.
Houd de waarde tijdens het afstemmen van prompts en workflows batch_sizeop 1, tenzij u specifiek doorvoertests nodig hebt. Een batch van vier vraagt de pipeline om vier afbeeldingen in één keer te produceren; dat kan de doorvoer in sommige configuraties verbeteren, maar het is niet de manier om de tijd tot de eerste afbeelding te minimaliseren en het verhoogt de geheugenvereisten.
Als uw uiteindelijke resultaat groter moet zijn dan de normale basisresolutie van SDXL, overweeg dan om de "compositietests" te scheiden van de uiteindelijke bewerking in hoge resolutie. Zorg eerst dat de prompt, de seed, de conditionering en de compositie kloppen, en investeer vervolgens pas in de dure opschaling of tweede bewerking voor geselecteerde kandidaten.
Een latent model met 1024 klassen en een batchgrootte van 1 is een verstandige basislijn voor SDXL-afstemming voordat er met hogere resoluties of meerdere afbeeldingen wordt gewerkt.
5. Test de prestaties van samplers en schedulers in plaats van ervan uit te gaan dat er altijd één sneller is.
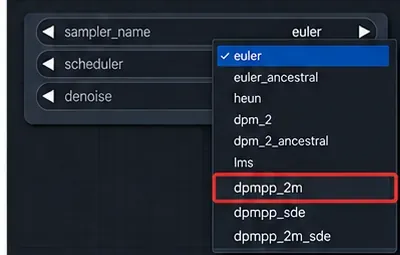
ComfyUI biedt in KSampler meerdere opties voor samplers en schedulers. Verschillende combinaties kunnen in verschillende aantallen stappen een acceptabele kwaliteit bereiken, dus "snelst" moet betekenen: de snelste met de gewenste kwaliteit , niet simpelweg de kortste enkele run.
Gebruik hetzelfde checkpoint, prompt, seed, resolutie en CFG bij het vergelijken. Wijzig alleen de sampler of scheduler en vergelijk vervolgens zowel de rendertijd als de zichtbare kwaliteit. Als een bepaalde combinatie aanzienlijk minder stappen vereist voor je checkpoint, terwijl het gewenste resultaat behouden blijft, is dat een echte snelheidswinst. Als er extra stappen nodig zijn om details te herstellen, kan het ogenschijnlijke voordeel verdwijnen.
Wijzig telkens één sampler-variabele en vergelijk de resultaten met een vaste seed. Ga er niet van uit dat een sampler sneller is voor elk SDXL-controlepunt of kwaliteitsdoel.
6. Elimineer overbodig grafiekwerk en maak optimaal gebruik van het uitvoeringsmodel van ComfyUI.
ComfyUI is ontworpen om alleen de delen van de grafiek uit te voeren die nodig zijn. De projectdocumentatie vermeldt dat ongewijzigde delen tussen uitvoeringen hergebruikt kunnen worden, en de huidige backend bevat configureerbare caching van knooppuntresultaten. Dit is handig wanneer u alleen een waarde verderop in de workflow wijzigt in plaats van de hele workflow opnieuw op te bouwen.
Zorg ervoor dat de laadknooppunten en de kostbare verwerking stroomopwaarts zo stabiel mogelijk blijven. Als u constant tussen checkpoints wisselt, grote afbeeldingen herhaaldelijk verkleint of stroomopwaartse knooppunten ongeldig maakt, verliest u het voordeel van gecachede gegevens.
ComfyUI beschikt ook over een gedocumenteerde functie voor gedeeltelijke uitvoering , waarmee alleen het deel van een workflow kan worden uitgevoerd dat nodig is voor een geselecteerd uitvoerknooppunt. Gebruik deze functie wanneer u een downstream-tak test en niet alle uitvoer in een grote grafiek opnieuw hoeft te worden gegenereerd.
Een overzichtelijke grafiek maakt knelpunten gemakkelijker te herkennen. Gebruik caching en gedeeltelijke uitvoering, zodat ongewijzigd werk stroomopwaarts niet onnodig wordt herhaald.
7. Optimaliseer de previews, caching, VRAM-modus en aandacht pas nadat de grafiek efficiënt is.
De huidige ComfyUI-opdrachtregelopties bieden verschillende mogelijkheden om de prestaties aan te passen. De effecten hiervan zijn afhankelijk van de hardware en het beschikbare geheugen, dus beschouw ze als benchmarkmogelijkheden in plaats van als verplichte instellingen.
Instelling
Wanneer het kan helpen
Belangrijkste afweging
--preview-method none
Als voorbeeldweergaven zijn ingeschakeld en u alleen geïnteresseerd bent in de uiteindelijke uitvoer.
Je verliest de live, latente previews. De huidige CLI gebruikt standaard al geen previews.
--highvram
Als je voldoende VRAM hebt en het herhaaldelijk ontladen en herladen van modellen tijd kost
Bewaart modellen in het GPU-geheugen en kan geheugenproblemen veroorzaken op grafische kaarten met een beperkter geheugen.
--lowvram
Als de workflow anderszins niet in het VRAM past
Dit is voornamelijk een geheugenbesparende modus, geen snelheidsmodus; CPU-gebruik of gegevensoverdracht kunnen de latentie verhogen.
--use-pytorch-cross-attention
Het is de moeite waard om dit te testen op moderne PyTorch/GPU-combinaties.
Combineer geen onderling uitsluitende aandachtmodusvlaggen zonder overleg.
--use-flash-attention
Het is de moeite waard om dit te testen als je hardware/software de geoptimaliseerde route ondersteunt.
Beschikbaarheid en nut zijn afhankelijk van de ondersteunde invoermethoden en kernels.
--cache-classicof--cache-lru N
Herhaalde workflows waarbij extra cachegeheugen acceptabel is.
Er kan meer RAM/VRAM worden gebruikt.
--cache-none
Alleen wanneer het verminderen van het cachegeheugen belangrijker is dan de snelheid.
Volgens de eigen CLI van ComfyUI wordt elk knooppunt bij elke run uitgevoerd, wat doorgaans nadelig is voor de rendertijd.
De huidige CLI biedt ook asynchrone weight offloading, en de helptekst geeft aan dat dit standaard is ingeschakeld op NVIDIA. Dat betekent dat het toevoegen van meer vlaggen niet automatisch een optimalisatie is; controleer eerst je huidige opstartopdracht en logbestanden.
De scaled dot-product attention van PyTorch kan automatisch geoptimaliseerde CUDA-implementaties selecteren, zoals FlashAttention of geheugenefficiënte attention, wanneer de inputs en hardware dit toelaten. Dat is de reden waarom moderne attention-paden ertoe kunnen doen, maar de exacte winst is hardware-afhankelijk. Vermijd het noemen van een algemeen percentage alsof dit van toepassing is op uw SDXL-workflow.
8. Zorg ervoor dat het gedrag van wachtrijen en batchverwerking aansluit bij uw doel.
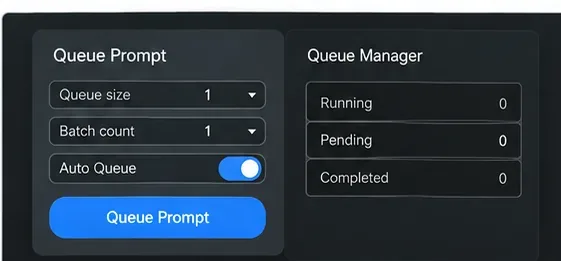
Als je prioriteit ligt bij een zo snel mogelijke feedbackloop, plaats dan één afbeelding tegelijk in de wachtrij tijdens het afstellen. Grote wachtrijen en batches zijn handig als je de instellingen al kent en een hoge doorvoer wilt, maar ze zorgen er niet voor dat de eerste afbeelding sneller aankomt.
Zodra de workflow is afgerond, kunt u de doorvoer afzonderlijk testen. Op dat moment kan een grotere batch zinvol zijn als het VRAM dit toelaat en als het totale aantal afbeeldingen per minuut belangrijker is dan de latentie per afbeelding.
Gebruik één afbeelding in de wachtrij en een batchgrootte van 1 voor interactieve afstemming; test later grotere batches wanneer doorvoer het doel is.
Hoe kun je zien of de optimalisatie daadwerkelijk gelukt is?
Een snellere run is alleen nuttig als de afbeelding nog steeds aan je doel voldoet. Vergelijk de beelden voor en na met dezelfde seed en prompt. Controleer de gebieden die het eerst mislukken wanneer de instellingen te agressief zijn: kleine tekst, handen en gezichten, herhalende patronen, fijne materialen, randdetails en het voldoen aan promptspecifieke kenmerken.
Noteer voor elke test ten minste deze vier items: totale uitvoeringstijd, aantal samplingstappen, resolutie en of het model is geladen. Als de eerste run 30 seconden duurt en de tweede 12 seconden, schrijf dan niet automatisch een wijziging van de sampler toe; de eerste run heeft mogelijk simpelweg de kosten voor het laden van het checkpoint gedekt.
Gebruik vergelijkingen met een vaste seed naast elkaar om te bepalen of een lager aantal stappen acceptabel is. De afgebeelde labels illustreren de methode en zijn geen benchmarkresultaten.
Een praktische optimalisatievolgorde
Voer een benchmarktest uit met een opgewarmde run. Houd de seed, prompt, resolutie en batchgrootte constant.
Verwijder onnodige vertakkingen. Test het basis-SDXL-pad zonder refiner, ControlNet, upscale of optionele preprocessors.
Verminder het aantal stappen. Zoek het laagste aantal stappen dat nog steeds aan uw kwaliteitseisen voldoet.
Houd de resolutie binnen de perken. Optimaliseer de resolutie binnen het bereik van de 1024 pixels van de SDXL-kaart voordat je overgaat op een hogere resolutie.
Houd de batchgrootte op 1 tijdens de iteratie. Optimaliseer de doorvoer pas nadat de workflow stabiel is.
Vergelijk de verschillende opties voor het bemonsteren/plannen van monsters. Beoordeel de snelheid bij een gelijkwaardige, acceptabele kwaliteit.
Gebruik caching en gedeeltelijke uitvoering. Vermijd het opnieuw uitvoeren van ongewijzigd werk uit eerdere projecten.
Vervolgens worden de opstartvlaggen van de benchmark getest. De preview, VRAM, cache en aandachtswijzigingen worden één voor één gecontroleerd.
Wanneer moet je je strategie aanpassen in plaats van harder te optimaliseren?
Als een SDXL-workflow na deze wijzigingen nog steeds te lang duurt, controleer dan wat de taak precies doet. Een productiegrafiek met meerdere ControlNets, een refiner en een upscale-stap is mogelijk gewoonweg rekenintensief. In dat geval hebt u drie eerlijke opties: de langere rendertijd voor de uiteindelijke afbeeldingen accepteren, een eenvoudigere conceptworkflow gebruiken voor iteratie, of de werklast overzetten naar snellere hardware.
Als je constant te weinig VRAM hebt, is het forceren van een "snellere" GPU-residentiemodus evenmin de juiste oplossing. Stabiele uitvoering met standaard dynamisch geheugenbeheer of een configuratie met minder VRAM is beter dan herhaalde geheugenproblemen. Geheugenbesparende instellingen kunnen de rendertijd verlengen, maar een langzamere, succesvolle rendering is nog steeds nuttiger dan een snelle crash.