Home
» Domeinen
»
Hoe los je de foutmelding "Context Window Exceeded" op bij de analyse van lange documenten zonder belangrijke bewijsgegevens te verliezen?
Hoe los je de foutmelding "Context Window Exceeded" op bij de analyse van lange documenten zonder belangrijke bewijsgegevens te verliezen?
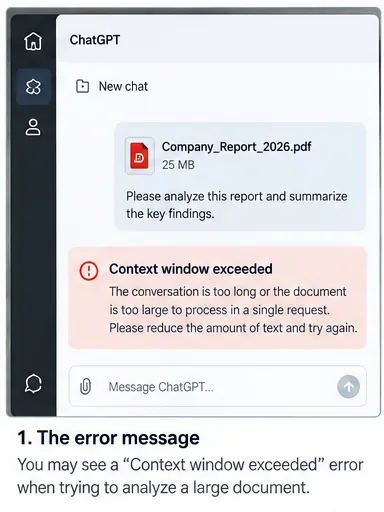
Je uploadt een lang rapport, vraagt om een grondige analyse, en in plaats van een antwoord krijg je een bericht zoals 'Contextvenster overschreden', 'Maximale contextlengte overschreden' of een andere waarschuwing dat het verzoek te groot is. Het frustrerende is dat het bestand mogelijk wel succesvol is geüpload en dat hetzelfde document wellicht zelfs wel had gewerkt voor een specifiekere vraag.
De reden is simpel, maar wordt vaak over het hoofd gezien: een uploadlimiet en het contextvenster van een model zijn niet hetzelfde. Een model moet het materiaal dat het actief verwerkt, in een beperkt aantal tokens kunnen verwerken. Dat budget kan instructies, gespreksgeschiedenis, tekst uit bestanden, tooldefinities, opgehaalde passages, redeneertokens en ruimte voor het antwoord omvatten. Een document kan dus legaal geüpload worden, maar toch te groot zijn om in één keer te analyseren.
De beste oplossing is meestal niet om steeds dezelfde grote prompt opnieuw te proberen. Begin met de minst ingrijpende wijzigingen en ga pas over op het opsplitsen in kleinere stukken, het ophalen van gegevens of een workflow met een grotere context als de eenvoudigere aanpak nog steeds niet werkt.
Controleer eerst of de fout daadwerkelijk een probleem met het contextvenster is.
Voordat je het document wijzigt, is het belangrijk om onderscheid te maken tussen een contextfout en een upload- of opslaglimiet. De huidige richtlijnen van OpenAI voor het uploaden van bestanden geven aan dat bestanden die naar ChatGPT of een GPT worden geüpload een strikte limiet van 512 MB per bestand hebben, terwijl tekst- en documentbestanden een limiet van 2 miljoen tokens per bestand hebben. Dit zijn uploadlimieten, geen garantie dat al die tekst tegelijkertijd in de actieve context van een model wordt geplaatst.
De FAQ over bestandsuploads van OpenAI is de meest betrouwbare bron voor actuele uploadlimieten. De exacte limieten variëren per product, abonnement, model en provider, dus ga er niet vanuit dat een getal uit een oud artikel nog steeds van toepassing is.
Wat je ziet
Waarschijnlijk een knelpunt
De beste eerste zet
Het bestand wordt afgewezen voordat de analyse begint.
Bestandsgrootte, bestandstype, opslagruimte of uploadquotum
Bekijk de actuele uploadregels.
Het bestand wordt geüpload, maar een lange prompt mislukt met een contextfout.
Het actieve verzoek overschrijdt het contextbudget van het model.
Verkort het verzoek en verminder de actieve context.
Het antwoord behandelt de eerste pagina's, maar laat latere gedeeltes buiten beschouwing.
Niet al het materiaal werd direct in de juiste context geplaatst, of relevante passages werden gemist tijdens het zoeken.
Stel specifiekere vragen of verdeel de vragen per onderdeel.
Een gesprek verliep eerder wel goed, maar loopt na meerdere pogingen vast.
De opgebouwde chatgeschiedenis verbruikt context.
Start een nieuwe analysethread met een beknopte overdrachtssamenvatting.
Een contextvensterfout kan optreden nadat een document succesvol is geüpload, omdat het actieve verzoek nog steeds binnen het tokenbudget van het model moet passen.
Stap 1: Meet het document op voordat u het wijzigt.
Het aantal pagina's en megabytes zijn nuttige aanwijzingen, maar tokens zijn de maatstaf die er echt toe doet voor de context van de tekst. Tokenisatie is afhankelijk van de taal, de opmaak, de interpunctie en de codering van het model, waardoor een technische handleiding van 100 pagina's een heel ander aantal tokens kan bevatten dan een presentatie van 100 pagina's.
De richtlijnen van OpenAI voor het tellen van tokens raden aan om het contextvenster van het doelmodel te controleren en ruimte over te laten voor uitvoer en, voor redeneermodellen, redeneertokens. Ook wordt opgemerkt dat berichtstructuur, tools, bestanden, afbeeldingen en schema's tokens kunnen toevoegen naast de platte tekst die wordt geteld.
Voor een snelle beoordeling kunt u het aantal pagina's, het geschatte aantal woorden, het aantal hoofdsecties en de aanwezigheid van bijlagen, herhalende juridische taal, ruwe logboeken, transcripten, tabellen of referenties die u niet daadwerkelijk nodig hebt voor de taak, noteren.
Controleer de schaal van het document voordat u problemen gaat oplossen. Bestandsgrootte en paginatelling zijn slechts indicaties; het gebruik van tokens is de relevantere limiet voor tekstanalyse.
Stap 2: Verlaag het actieve gesprek voordat u het bestand aanraakt.
Als het document niet buitengewoon groot is, is de goedkoopste oplossing wellicht om de opgebouwde context te verwijderen in plaats van het bestand op te splitsen. Start een nieuw gesprek of verzoek en neem alleen de relevante instructies over. Vervang een langdurig heen-en-weer gesprek door een korte overdracht, zoals: "Analyseer het bijgevoegde rapport op omzetfactoren, materiële risico's en managementrichtlijnen. Geef vijf bevindingen terug met pagina- of sectieverwijzingen."
Verwijder ook herhaald achtergrondmateriaal, voorbeelden die niet langer nodig zijn, dubbel geplakte tekst en eerdere conceptversies. Als u een API-workflow gebruikt, tel dan het volledige verzoek in plaats van alleen het document. Een verzoek dat nauwelijks past, laat weinig ruimte over voor het antwoord en kan onvoorspelbaar mislukken naarmate instructies of toolschema's complexer worden.
Succesvol resultaat: hetzelfde bestand werkt in een nieuw proces met een geselecteerde prompt. In dat geval lag het probleem in ieder geval gedeeltelijk bij de opgebouwde context, en niet bij het document zelf.
Stap 3: Verfijn de vraag en de gewenste output
De opdracht "Analyseer alles in dit document van 400 pagina's en schrijf een uitgebreid rapport" dwingt het systeem om veel onderwerpen tegelijk te behandelen. Stel in plaats daarvan één vraag tegelijk. Vraag bijvoorbeeld eerst naar de belangrijkste risico's in het document, vervolgens naar de financiële aannames en daarna naar tegenstrijdigheden tussen beweringen van het management en de onderbouwende gegevens.
Houd de antwoordindeling beperkt. Een verzoek om een output van 20 pagina's verbruikt veel meer outputbudget dan een verzoek om een bewijstabel van 10 rijen. Je kunt het uiteindelijke antwoord altijd uitbreiden nadat het bewijsmateriaal is verzameld.
Een nuttige, gerichte opdracht is: "Gebruik alleen dit document om maximaal acht beweringen te identificeren die relevant zijn voor klantverloop. Geef voor elke bewering de sectie- of paginaverwijzing, een korte uitleg van één zin en eventuele beperkingen. Als het document onvoldoende bewijsmateriaal bevat, vermeld dit dan."
Wanneer moet je verdergaan? Als een gerichte vraag nog steeds dezelfde fout oplevert, of als je een betrouwbare dekking van het hele document nodig hebt in plaats van slechts één onderwerp, splits dan de bron op.
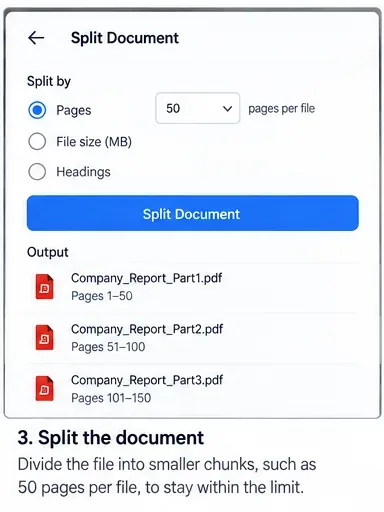
Stap 4: Splits het document op basis van betekenis, niet alleen op basis van gelijke paginaaantallen.
Het opdelen van documenten in stukken is de meest betrouwbare algemene oplossing voor zeer lange documenten. Verdeel het bestand op natuurlijke grenzen, zoals hoofdstukken, rapportsecties, contracten, bijlagen, datumbereiken of spreekbeurten. Logische stukken behouden de context beter dan willekeurige onderbrekingen om de 50 pagina's.
Als een onderdeel sterk afhankelijk is van het voorgaande, voeg dan een kleine overlap of een korte inleiding toe waarin het voorgaande onderdeel wordt beschreven. Benoem de onderdelen duidelijk, bijvoorbeeld 01_Executive_Summary.pdf, 02_Financial_Results.pdf, en 03_Risk_Factors.pdf. Behoud waar mogelijk de oorspronkelijke paginanummers, zodat de uiteindelijke samenvatting gecontroleerd kan worden.
Deel een zeer lange bron op in logische, duidelijk benoemde secties. Behoud de oorspronkelijke pagina- of sectieverwijzingen, zodat latere syntheses kunnen worden gecontroleerd aan de hand van de broncode.
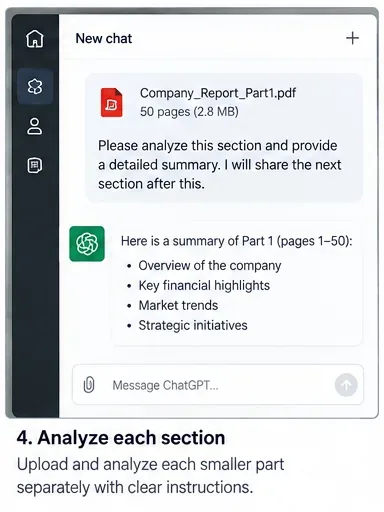
Stap 5: Analyseer elk fragment met hetzelfde bewijsschema.
Vraag niet zomaar om een vrije samenvatting van elk onderdeel. Gebruik dezelfde structuur voor elk deel, zodat de resultaten kunnen worden samengevoegd zonder belangrijke verschillen te verliezen. Een praktisch schema zou bijvoorbeeld de volgende onderdelen kunnen bevatten: sectienaam, belangrijkste bevindingen, ondersteunend bewijsmateriaal, pagina- of kopverwijzing, onzekerheden en open vragen.
Bijvoorbeeld: “Analyseer alleen deel 3. Geef het volgende terug: (1) maximaal vijf belangrijke bevindingen, (2) het bewijs voor elke bevinding, (3) de oorspronkelijke pagina- of sectieverwijzing, (4) eventuele kanttekeningen van de auteur en (5) vragen die in een andere sectie moeten worden gecontroleerd. Leid geen feiten af die niet in dit deel staan.”
Deze aanpak maakt het ook gemakkelijker om de kwaliteit te beoordelen. Als een chunk-samenvatting beweringen bevat zonder bronlocaties, corrigeer die chunk dan voordat u verdergaat, in plaats van te hopen dat de uiteindelijke synthese dit zal herstellen.
Analyseer één sectie tegelijk met een vast uitvoerformaat, zodat elk deelresultaat later kan worden gecombineerd en naar de bron kan worden herleid.
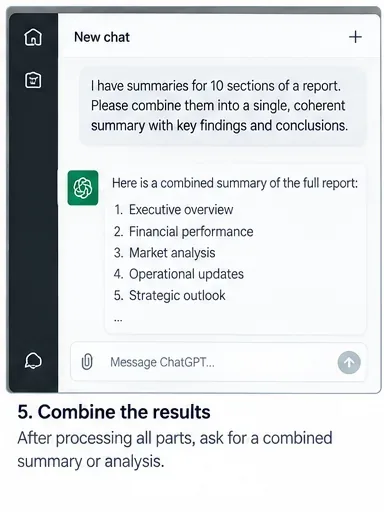
Stap 6: Maak een samenvatting van samenvattingen in plaats van elke volledige chunk opnieuw te laden.
Nadat de onderdelen zijn geanalyseerd, maak je een compact bewijspakket van de afzonderlijke outputs en synthetiseer je dat. Stuur niet automatisch elk origineel fragment plus elke samenvatting terug in één definitief verzoek; dat kan hetzelfde contextprobleem opnieuw veroorzaken.
De syntheseopdracht moet het model instrueren om meningsverschillen en hiaten te behouden. Bijvoorbeeld: "Combineer deze sectieanalyses in één rapport. Voeg dubbele bevindingen samen, behoud tegenstrijdig bewijs als aparte punten, behoud alle bronvermeldingen en markeer elke vraag die niet uit de samenvattingen kan worden beantwoord."
Deze hiërarchische methode is met name nuttig voor boeken, wettelijke documenten, bewijsmateriaal, lange interviewcollecties en onderzoek met meerdere documenten. De belangrijkste beperking is de informatiecompressie: details die tijdens een samenvatting worden weggelaten, kunnen later niet zomaar weer verschijnen. Daarom zijn het bewijsschema en de bronvermeldingen zo belangrijk.
Combineer compacte sectieanalyses in plaats van de volledige brontekst opnieuw te laden. Behoud citaten, meningsverschillen en onopgeloste vragen tijdens de synthese.
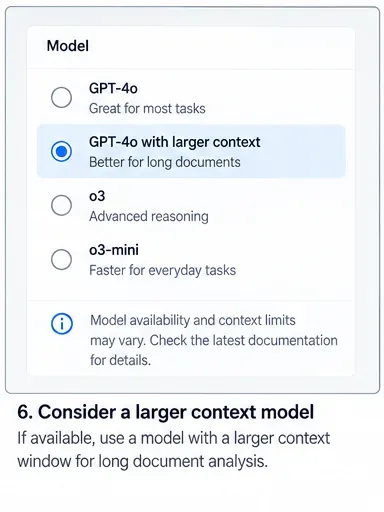
Stap 7: Overweeg een model met een bredere context, maar beschouw het niet als een complete oplossing.
Een model met een groter contextvenster kan de noodzaak tot agressieve chunking verminderen. De huidige modeldocumentatie van OpenAI vermeldt limieten voor het contextvenster en de maximale uitvoer voor API-modellen, en deze waarden kunnen veranderen naarmate modellen worden bijgewerkt.
De omvang van de koptekstcontext van een model is echter niet per se gelijk aan de hoeveelheid van een geüpload bestand die een product direct in de prompt plaatst. De specifieke bestandsrichtlijnen van OpenAI Enterprise beschrijven momenteel een apart proces voor het 'vullen van context' van geüploade tekstdocumenten: tot 110.000 tokens uit geüploade documenten kunnen direct in de context worden geplaatst, met aanvullend materiaal beschikbaar via een privézoekindex. OpenAI geeft expliciet aan dat dit gedrag in actieve ontwikkeling is en kan worden gewijzigd. Zie ' Bestandsuploads optimaliseren in ChatGPT Enterprise' .
De praktische les is om voor een model met een bredere context te kiezen wanneer dit de workflow aanzienlijk vereenvoudigt, maar toch te controleren of de relevante onderdelen daadwerkelijk worden meegenomen. Een bredere context neemt de noodzaak van een goede afbakening, bronvermeldingen en verificatie niet weg.
Een model met een bredere context kan helpen, maar controleer de beperkingen voor het specifieke model en productoppervlak dat u gebruikt, in plaats van te vertrouwen op een algemeen getal.
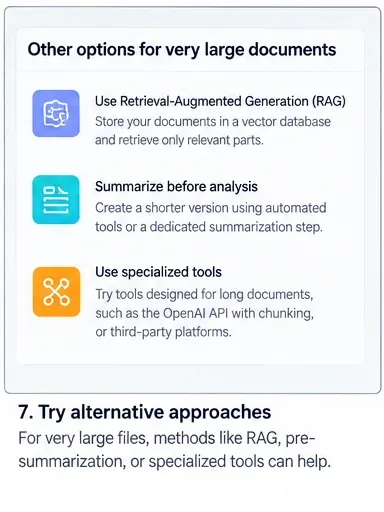
Stap 8: Schakel bij zeer grote corpora over van "alles erin stoppen" naar het ophalen van gegevens.
Als de taak honderden of duizenden pagina's omvat, is een zoeksysteem meestal een betere architectuur dan proberen de hele tekst in één zoekopdracht te persen. Zoeksystemen indexeren de bron, zoeken naar passages die relevant zijn voor de huidige vraag en plaatsen alleen die passages in de juiste context.
De documentatie van OpenAI over bestandszoekopdrachten beschrijft een gehoste tool voor het doorzoeken van geüploade bestanden via vectorarchieven. Het zoeken werkt met name goed voor gerichte vragen zoals "In welke secties wordt beëindiging voor het gemak gedefinieerd?" of "Waar wordt in het rapport de concentratie in de toeleveringsketen besproken?"
Het ophalen van informatie is minder betrouwbaar wanneer de taak daadwerkelijk vereist dat elke passage gelijktijdig wordt gecontroleerd, zoals het bewijzen dat een onderwerp nooit voorkomt, het vergelijken van elke tabelcel in een enorme verzameling of het uitvoeren van een uitputtende regel-voor-regel transformatie. In die gevallen is het raadzaam om naast het ophalen van informatie ook systematische batchverwerking of codegebaseerde voorbewerking te gebruiken.
Voor corpora die na het opdelen te groot blijven, kan het opvragen van gegevens alleen de meest relevante passages in de actieve context voor elke vraag weergeven.
Ontwikkelaars die de OpenAI Responses API gebruiken, hebben een extra keuze. De API-referentie beschrijft een truncationinstelling: met disabled, wat de gedocumenteerde standaardinstelling is, mislukt een verzoek dat het contextvenster van het model zou overschrijden; met auto, kunnen eerdere gespreksitems worden weggelaten om het verzoek passend te maken. Zie de API-referentie van Responses .
Automatische afkapping kan een harde fout voorkomen, maar het verandert de informatie die beschikbaar is voor het model. Voor documentanalyse kan het stilletjes weglaten van vroege context erger zijn dan het ontvangen van een foutmelding. Gebruik het alleen als uw applicatie zo is ontworpen dat oudere gespreksonderdelen overbodig zijn of al elders zijn samengevat.
Hoe kun je controleren of de oplossing daadwerkelijk werkt?
Een succesvol verzoek is niet voldoende. Het doel is een verdedigbare analyse die de juiste informatie bevat zonder stilletjes bewijsmateriaal te verliezen. Test het resultaat voordat u het probleem als opgelost beschouwt.
Controle op volledigheid: bevestig dat elk vereist hoofdstuk, datumbereik of bronbestand voorkomt in het analyseplan of de uiteindelijke bewijstabel.
Traceerbaarheidscontrole: selecteer belangrijke beweringen en controleer of de pagina-, sectie- of bestandsverwijzingen overeenkomen met de oorspronkelijke bron.
Grenscontrole: inspecteer de bevindingen nabij de grenzen van de chunks om er zeker van te zijn dat een concept niet is opgesplitst of tegengesproken in de verschillende delen.
Negatieve controle: stel een vraag waarvan bekend is dat het antwoord ontbreekt. Een goede workflow moet erkennen dat het bewijs niet aanwezig is, in plaats van het te verzinnen.
Herhaalbaarheidscontrole: herhaal een paar representatieve vragen. Grote veranderingen in aangehaald bewijsmateriaal kunnen wijzen op een zwakke herinnering of een te algemene vraagstelling.
Budgetcontrole: als u een API gebruikt, controleer dan het werkelijke gebruik van invoer- en uitvoertokens in plaats van alleen te vertrouwen op ruwe schattingen van het aantal woorden.
De laatste stap is verificatie: controleer de dekking, bronverwijzingen, chunkgrenzen en niet-onderbouwde beweringen voordat u de gecombineerde analyse vertrouwt.
Wat je vooral niet moet doen
Dien niet steeds hetzelfde, te grote verzoek opnieuw in en verwacht dan geen andere tokenlimiet. Verwijder geen bronverwijzingen tijdens het opsplitsen in stukken. Ga er niet van uit dat een geaccepteerd bestand betekent dat elke pagina in de context actief is. En los de fout niet op door het antwoord zo drastisch in te korten dat de analyse de taak niet meer kan uitvoeren.
Vermijd ook om automatische afkapping als onzichtbare magie te beschouwen. Als het systeem oudere items verwijdert, kan het verzoek weliswaar slagen, maar gaan er instructies of bewijsmateriaal verloren die van belang waren. Voor analyses met hoge inzet is expliciete segmentering en retrieval doorgaans gemakkelijker te controleren.
Een praktische beslissingsregel
Als een nieuwe discussie en een specifiekere vraag werken, houd de workflow dan eenvoudig. Als de taak een brede analyse van één lang document vereist, verdeel het dan in logische secties en voer gestructureerde chunk-analyses uit. Als u herhaaldelijk een zeer grote documentverzameling opvraagt, gebruik dan retrieval. Als u de API beheert en toch de limiet nadert, meet dan het aantal tokens, reserveer uitvoerruimte, selecteer een geschikt model en maak truncatiegedrag een expliciete ontwerpbeslissing.
Het sterkste resultaat is niet het resultaat dat de meeste tekst in één verzoek propt. Het is het resultaat dat het vereiste bewijsmateriaal bevat, de traceerbaarheid waarborgt en duidelijk aangeeft wanneer informatie niet beschikbaar was.