Home
» Domeinen
»
Hoe u een privé, lokale AI-kennisbank voor persoonlijke documenten kunt opzetten
Hoe u een privé, lokale AI-kennisbank voor persoonlijke documenten kunt opzetten
Het eenvoudigste praktische antwoord: voer het taalmodel, het embeddingmodel, de documentindex en de chatinterface uit op je eigen computer. Een eenvoudige combinatie is Ollama voor het lokaal serveren van het model, plus een zelfgehoste AnythingLLM voor documentinvoer, retrieval-augmented generation (RAG) en chat. Houd de vectordatabase lokaal, gebruik permanente opslag, vermijd cloudproviders voor modellen en test of de antwoorden daadwerkelijk gebaseerd zijn op je bestanden.
Illustratief voorbeeld: stel je in deze handleiding voor dat Jordan een privécollectie organiseert met onder andere handleidingen voor het huishouden, pdf's van verzekeringen, notulen van vergaderingen, een naslagwerk over persoonlijke financiën en een paar projectrapporten. Jordan is een fictief personage. De bestanden, vragen, antwoorden en resultaten die hieronder worden beschreven, dienen als voorbeelden om de workflow te verduidelijken, en zijn geen testresultaten of een getuigenis.
Deze handleiding maakt gebruik van een installatie in vier stappen, zodat de privacygrenzen begrijpelijk blijven. Het is geschikt voor één persoon of een klein, vertrouwd huishouden dat lokaal documenten wil doorzoeken en vragen wil beantwoorden. Als u identiteitscontrole op bedrijfsniveau, beschikbaarheid op meerdere locaties, gecentraliseerde audits of wettelijke garanties nodig hebt, dient u dit te beschouwen als een basisarchitectuur en niet als een complete compliance-oplossing.
Wat "privé lokale AI-kennisbank" nu eigenlijk betekent
Een lokale kennisbank is niet hetzelfde als het trainen van een model op basis van uw documenten. In een typische RAG-workflow extraheert het systeem tekst uit uw bestanden, verdeelt de tekst in stukken, zet die stukken om in numerieke embeddings, slaat ze op in een vectordatabase, haalt relevante stukken op voor elke vraag en stuurt alleen die stukken naar het taalmodel als context.
De huidige documentatie van AnythingLLM beschrijft zowel workflows voor bijgevoegde documenten als voor ingesloten documenten. Bijgevoegde documenten kunnen de volledige tekst in een chat worden geplaatst wanneer het contextvenster dit toelaat, terwijl RAG kleinere relevante delen uit ingesloten documenten ophaalt. De huidige lokale LanceDB-documentatie vermeldt ook dat de standaard LanceDB op de applicatie-instantie documenttekst en ingesloten gegevens binnen de AnythingLLM-applicatie bewaart. Zie de AnythingLLM-documentworkflowdocumentatie en de AnythingLLM LanceDB-documentatie .
component
Rol in de lokale stack
Privacyvriendelijke keuze
Ollama
Voert het chatmodel en, optioneel, een inbeddingsmodel uit op uw computer.
Gebruik een lokaal model, niet een in de cloud gehost model-eindpunt.
AnythingLLM
Biedt de gebruikersinterface, documentbeheer, chunking, RAG en werkruimteorganisatie.
Voer het lokaal uit en bewaar de opslagmap permanent.
Inbeddingsmodel
Zet documentfragmenten en zoekopdrachten om in vectoren voor semantisch zoeken.
Gebruik een lokale embedder als documenten niet naar een externe service verzonden hoeven te worden.
LanceDB
Slaat vectoren op die worden gebruikt om relevante passages te vinden.
Behoud de standaard lokale instantie, tenzij u bewust een externe database nodig hebt.
Originele bestanden en back-ups
Blijf de gezaghebbende bron
Bescherm ze met de gebruikelijke toegangsbeheerfuncties van het besturingssysteem, versleuteling en back-ups.
Voordat je begint: bepaal de privacygrens.
De belangrijkste vraag is niet "Is de app lokaal?", maar "Welke componenten kunnen documenttekst of prompts vanaf de computer verzenden?". Een lokale gebruikersinterface kan nog steeds worden geconfigureerd om een cloud-LLM, een cloud-integratie-API, webzoekopdrachten of tools op afstand aan te roepen. Voor een privé-omgeving is het raadzaam om de LLM, de integratietool en de vectordatabase lokaal te houden, tenzij u bewust de implicaties van gegevensdeling met een externe provider hebt geaccepteerd.
AnythingLLM documenteert anonieme telemetrie en biedt een manier om dit uit te schakelen. De privacydocumentatie maakt ook onderscheid tussen het verwijderen van een document uit één werkruimte en het volledig verwijderen ervan uit de documentbibliotheek. Voor volledige verwijdering binnen AnythingLLM adviseert de huidige documentatie om het document te verwijderen uit Mijn documenten . Hiermee worden de geparseerde broncode, de in de cache opgeslagen embeddings en de verwijzingen naar de werkruimte verwijderd. Raadpleeg de privacy- en gegevensverwerkingsdocumentatie van AnythingLLM voordat u gevoelig materiaal toevoegt.
Je hebt ook voldoende geheugen nodig voor het lokale model dat je hebt gekozen. Er is geen eenduidig juiste modelgrootte, omdat de bruikbare snelheid afhangt van de CPU, GPU, RAM of VRAM, kwantisering, contextlengte en het aantal opgehaalde documenten. Begin met een model dat comfortabel past, in plaats van het grootste model te kiezen dat je computer nauwelijks kan laden.
Stap 1: Installeer Ollama en bereid de lokale chat en de ingebedde modellen voor.
Installeer Ollama volgens de actuele instructies voor uw besturingssysteem. Ollama is beschikbaar voor macOS, Windows en Linux, en de lokale API is standaard beschikbaar op poort 11434. De officiële Ollama-snelstartgids is de beste bron voor actuele installatie-instructies en commandosyntaxis.
Na de installatie kunt u een chatmodel selecteren dat bij uw hardware past. Het exacte model is hier niet vastgelegd, omdat de modelcatalogus verandert en de hardwarevereisten variëren. Een typisch commando heeft de volgende vorm:
ollama pull <chat-model-name>
Voor RAG heb je ook een embedding-model nodig. De huidige documentatie van Ollama over embeddings, geraadpleegd in september 2026, noemt modellen zoals embeddinggemma, qwen3-embedding, en all-minilmals aanbevolen embedding-opties. Je kunt de huidige lijst bekijken in de Ollama-documentatie over embeddings . Bijvoorbeeld:
ollama pull embeddinggemma
Gebruik geen standaard chatmodel als inbeddingsmodel, alleen omdat het in een modelkeuzelijst verschijnt. De huidige documentatie van AnythingLLM over de Ollama-inbeddingsmodule waarschuwt expliciet dat Ollama zowel chatmodellen als inbeddingsmodellen in dezelfde lijst kan weergeven. Gebruik een daadwerkelijk inbeddingsmodel voor documentindexering. Zie de installatiehandleiding voor de AnythingLLM Ollama-inbeddingsmodule .
Illustratieve terminalflow voor het ophalen van een lokaal model met Ollama. Het versienummer dat in dit voorbeeld wordt weergegeven, is geen aanbeveling voor de huidige versie; controleer de geïnstalleerde versie in de officiële Ollama-documentatie.
Voor Jordans fictieve opzet is het doel in deze fase eenvoudig: zowel het genereren als het inbedden moet mogelijk zijn zonder de huishouddocumenten naar een externe API te hoeven sturen.
Stap 2: Voer AnythingLLM lokaal uit met permanente opslag en verbind het met Ollama.
AnythingLLM biedt opties voor desktop en zelfhosting. Deze handleiding maakt gebruik van Docker omdat de opslaglimiet expliciet is en er gemakkelijk een back-up van te maken valt. De huidige lokale Docker-documentatie instrueert gebruikers om de image te downloaden en benadrukt dat permanente opslag vereist is, anders kunnen applicatiegegevens verloren gaan wanneer de container opnieuw wordt aangemaakt. Er staat ook vermeld dat de webapplicatie beschikbaar is op [adres] http://localhost:3001. Gebruik de officiële AnythingLLM-handleiding voor lokale Docker in plaats van een oud commando van een forum te kopiëren.
docker pull mintplexlabs/anythingllm:latest
Wanneer je de container uitvoert, zorg er dan voor dat de opslagruimte van AnythingLLM behouden blijft door een hostdirectory te koppelen aan de container /app/server/storage. De documentatie van de leverancier geeft specifiek aan dat deze permanente koppeling noodzakelijk is. Bewaar deze opslagdirectory op een schijf die is opgenomen in je back-upplan.
Configureer vervolgens de LLM-provider als Ollama. Als AnythingLLM direct op de host draait, is het gedocumenteerde standaard Ollama-adres http://127.0.0.1:11434. Als AnythingLLM in Docker draait terwijl Ollama op de host draait, gebruik dan niet localhostvanuit de container. De Docker-netwerkdocumentatie van AnythingLLM geeft aan dat http://host.docker.internal:11434op ondersteunde desktopplatforms gebruikt moet worden; op Linux wordt 172.17.0.1dit hostverbindingspatroon beschreven. Zie de documentatie over netwerken op localhost van AnythingLLM en de Ollama LLM-configuratie .
Kies in de instellingen Ollama als zowel de LLM-provider als, indien gewenst, de embedding-provider. Selecteer het chatmodel voor generatie en het embedding-model voor indexering. Door deze rollen gescheiden te houden, voorkomt u een veelvoorkomende configuratiefout.
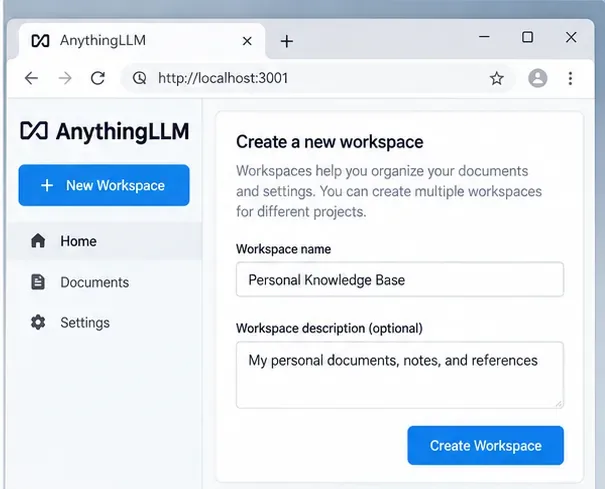
De zelfgehoste versie van AnythingLLM is gedocumenteerd om te draaien op localhost:3001. Een aparte werkruimte geeft één documentverzameling een duidelijk doel en zorgt ervoor dat irrelevant materiaal niet in de zoekresultaten terechtkomt.
Jordan creëert een werkruimte genaamd "Persoonlijke Kennisbank" en vermijdt het koppelen van cloudmodelproviders. Daardoor is de beoogde afbakening later gemakkelijk te controleren: lokale gebruikersinterface, lokaal LLM, lokale embeddings, lokale vectoren.
Stap 3: Documenten toevoegen, kiezen tussen RAG en bijlage met volledige tekst, en de verwerking controleren.
Begin niet met het uploaden van uw hele schijf. Start met een kleine, representatieve set documenten waarvan u de inhoud goed kent. Dit geeft u een gecontroleerde manier om extractie- of ophaalproblemen te detecteren voordat de index groeit.
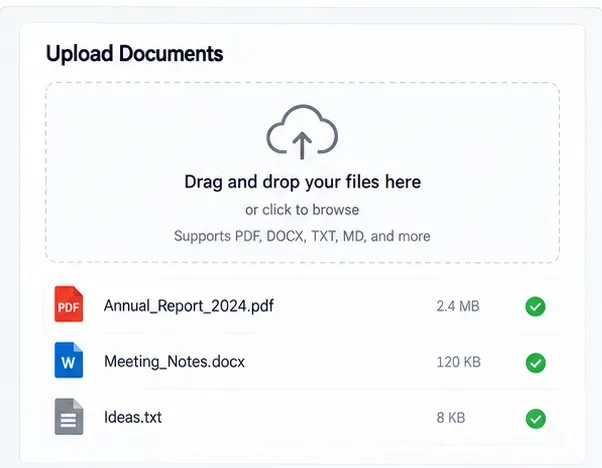
Voor Jordans voorbeeld zou een nuttige eerste batch één doorzoekbaar PDF-bestand, één DOCX-bestand en één notitie in platte tekst of Markdown kunnen bevatten. Als gescande PDF's afbeeldingen in plaats van selecteerbare tekst bevatten, controleer dan of het gekozen documentverwerkingspad daadwerkelijk de benodigde tekst extraheert; een bestand dat er voor u leesbaar uitziet, kan nog steeds een lege of slechte tekstweergave voor RAG opleveren.
AnythingLLM ondersteunt momenteel twee algemene documentgedragingen:
Bijgevoegde documenten: handig wanneer de volledige tekst in het contextvenster van het model past en u wilt dat het model het complete bestand voor die thread ziet.
Ingesloten documenten met RAG: handig voor grotere of herbruikbare collecties. Het systeem verdeelt de inhoud in stukken, sluit deze in en haalt de relevante gedeelten op voor een vraag.
De huidige AnythingLLM-documentatiehandleiding vermeldt dat documenten die in een werkruimte zijn ingesloten, beschikbaar komen voor alle threads in die werkruimte. Dat is handig, maar het betekent ook dat het lidmaatschap van een werkruimte onderdeel uitmaakt van uw privacymodel in omgevingen met meerdere gebruikers. Houd persoonlijke werkruimtes gescheiden van gedeelde werkruimtes.
Voorbeeldweergave van een importproces met verschillende documenttypen. Gebruik eerst een kleine, betrouwbare batch en controleer vervolgens de extractie en indexering voordat u een groot archief toevoegt.
Stel na het inbedden een vraag waarvan het antwoord slechts in één bestand voorkomt. Vraag vervolgens naar een detail dat in geen enkel bestand te vinden is. De eerste vraag test het ophalen van informatie; de tweede test of het model onzekerheid toelaat in plaats van een antwoord te verzinnen.
Wat moet ik afstellen als het ophalen van gegevens zwak is?
AnythingLLM biedt RAG-instellingen op werkruimteniveau, zoals zoekvoorkeuren, het maximale aantal contextfragmenten en de drempelwaarde voor documentgelijkenis. De documentatie adviseert om te beginnen met de werkruimte-instellingen in plaats van aan te nemen dat het basismodel het probleem is. Het vergroten van de opgehaalde context kan helpen wanneer het antwoord meerdere secties omvat, maar het verzenden van te veel fragmenten kan ook irrelevante tekst toevoegen en de capaciteit van het contextvenster in beslag nemen.
Als u na het indexeren de embeddingmodellen wijzigt, moet u de betreffende documenten opnieuw embedden, zodat de opgeslagen vectoren en de zoekvectoren uit dezelfde embeddingruimte afkomstig zijn. Het combineren van embeddings van verschillende modellen is geen zinvolle zoekstrategie.
Stap 4: Test de onderbouwde antwoorden, bescherm de privacy en maak een back-up van de kennisbasis.
Een kennisbank is alleen nuttig als je kunt detecteren wanneer deze onjuist is. Stel een kleine evaluatielijst samen met feiten die je direct kunt verifiëren. Bijvoorbeeld:
Vraag om een datum, bedrag, productmodel of beleidsclausule die letterlijk in één document voorkomt.
Stel een vraag die betrekking heeft op meerdere documenten en waarbij feiten uit twee bestanden nodig zijn.
Stel een opzettelijk onbeantwoordbare vraag en controleer of het antwoord geen verzonnen bron bevat.
Stel dezelfde vraag met een andere formulering om te zien of het ophalen van informatie stabiel blijft.
Open het brondocument en controleer handmatig elke bewering met grote gevolgen.
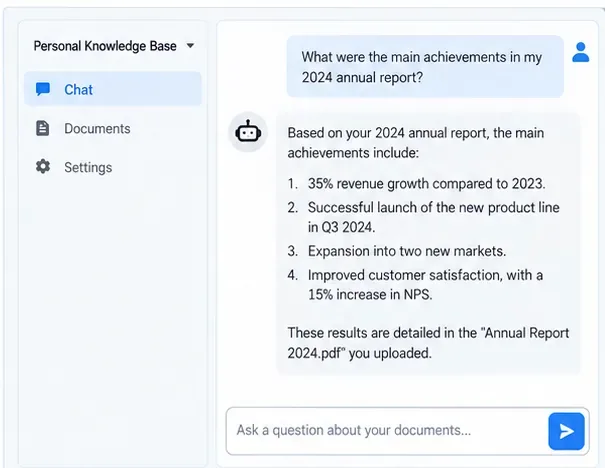
Hypothetisch, op documenten gebaseerd antwoord ter illustratie van de verificatiestap. De getoonde figuren zijn fictieve voorbeelden; in een echte kennisbank moeten belangrijke beweringen worden geverifieerd aan de hand van het originele bestand.
Voor Jordan is een goede acceptatieregel niet "het antwoord klinkt juist", maar "het antwoord komt overeen met de bron, bevat de noodzakelijke context en faalt op een veilige manier wanneer de bron de informatie niet bevat". Die regel is vooral belangrijk bij belastingen, verzekeringen, juridische documenten, medische dossiers of financiële beslissingen.
Houd de configuratie privé nadat het werkt.
Lokale inferentie vermindert de blootstelling van gegevens, maar de privacy blijft afhankelijk van de configuratie. Gebruik deze instellingen als een praktische checklist:
Houd de AnythingLLM-service gebonden aan de lokale machine of een vertrouwd privénetwerk, tenzij toegang op afstand opzettelijk beveiligd is.
Voeg geen cloud-LLM-, cloud-embedding-, webzoek-, browser- of agentintegraties toe aan een werkruimte met gevoelige gegevens, tenzij u begrijpt welke gegevens deze integraties verzenden.
Schakel anonieme telemetrie uit als uw privacybeleid vereist dat er geen producttelemetrie wordt gebruikt.
Gebruik de schijfversleuteling en accountmachtigingen van uw besturingssysteem. Een lokale vectordatabase blijft leesbare data, zelfs als een aanvaller toegang krijgt tot de machine.
Verwijder gevoelige bestanden uit de hele documentbibliotheek, niet alleen uit één werkruimte, als u ze volledig wilt wissen binnen AnythingLLM.
Patch Ollama, AnythingLLM, Docker en het hostbesturingssysteem. "Offline" mag niet betekenen "nooit onderhouden".
Maak een back-up van de onderdelen die moeilijk te reproduceren zijn.
De originele documenten blijven uw bron van waarheid, maar de AnythingLLM-opslagmap bevat de applicatiedatabase, geparseerde documenten, vectorgegevens en configuratie die nodig zijn om te voorkomen dat alles opnieuw moet worden opgebouwd na een schijffout. Maak een back-up van zowel de originele documentmap als de permanente opslag van AnythingLLM. Als u Docker-volumes gebruikt in plaats van een bind-mounted hostmap, volg dan de officiële Docker- documentatie voor het maken van back-ups en het herstellen van volumes .
Test het herstelproces, niet alleen het maken van een back-up. Een back-up is pas bewezen als u deze kunt herstellen naar een andere map of machine, de lokale stack kunt starten, de werkruimte kunt openen en een bekend gegeven correct kunt ophalen.
Wanneer deze opstelling geschikt is – en wanneer niet.
Deze architectuur is zeer geschikt wanneer het bewaren van persoonlijke documenten op hardware die u zelf beheert prioriteit heeft, u geen problemen ondervindt met het lokaal uitvoeren van software en u semantisch zoeken plus antwoorden in natuurlijke taal wilt in een bescheiden documentenbibliotheek. Het is ook handig wanneer de internetverbinding onbetrouwbaar is of wanneer u voorspelbare lokale kosten wilt na het downloaden van de modellen.
Het is minder geschikt als uw computer geen adequaat lokaal model kan uitvoeren, u naadloze toegang nodig hebt vanaf veel apparaten buiten uw thuisnetwerk, of als u identiteitsbeheer, auditing, juridische bewaring, gecentraliseerd sleutelbeheer of gegarandeerde ondersteuning op bedrijfsniveau vereist. In die gevallen is een beheerde privé-implementatie of een RAG-platform voor bedrijven wellicht de juiste oplossing in plaats van een configuratie met één pc.
Een compacte checklist voor de installatie
Installeer Ollama en controleer de lokale modelinferentie.
Installeer een specifiek inbeddingsmodel, zoals een van de modellen die worden vermeld in de huidige documentatie van Ollama over inbeddingen.
Voer AnythingLLM lokaal uit met permanente opslag.
Verbind AnythingLLM met het lokale Ollama-eindpunt met behulp van het juiste hostadres voor uw implementatiemethode.
Gebruik een lokale vectordatabase zoals de standaard LanceDB van AnythingLLM wanneer het doel is om alleen lokaal documenten op te halen.
Creëer een werkruimte met een beperkte reikwijdte.
Begin met een paar bekende documenten en controleer of de extractie lukt.
Gebruik RAG alleen voor grote herbruikbare collecties en voeg volledige tekst toe als bijlage wanneer het document goed in de modelcontext past.
Test de vragen die wel en niet te beantwoorden zijn voordat je het systeem vertrouwt.
Schakel onnodige externe integraties en telemetrie uit, afhankelijk van uw privacyvereisten.
Maak een back-up van zowel de brondocumenten als de permanente applicatieopslag en test vervolgens het herstel.