Home
» Domeinen
»
Hoe je automatisch SEO-metatitels en -beschrijvingen kunt genereren met Local Ollama
Hoe je automatisch SEO-metatitels en -beschrijvingen kunt genereren met Local Ollama
Je hebt 300 product-, documentatie- of blogpagina's klaar om te publiceren, maar de kolom met metadata is nog leeg. Het handmatig schrijven van elke titel en metabeschrijving is tijdrovend; het kopiëren van één patroon over de hele site leidt tot repetitieve resultaten; en het vragen aan een lokaal taalmodel om "een SEO-titel" levert vaak extra commentaar, verzonnen beweringen of inconsistente opmaak op.
Een betere aanpak is om het genereren van metadata te behandelen als een kleine datapipeline: geef het model alleen paginaspecifieke gegevens, vereis gestructureerde uitvoer, valideer deze in de code en controleer vervolgens uitzonderingen voordat de gegevens worden gepubliceerd. Ollama is zeer geschikt voor deze workflow omdat de lokale API na http://localhost:11434/apiinstallatie beschikbaar is en Ollama gestructureerde uitvoer volgens JSON-schema ondersteunt. De hier genoemde documentatie over Ollama en Google Search is gecontroleerd op 13 september 2026.
Waarom automatische SEO-metadata vaak misgaat
De meeste fouten komen voort uit de workflow rondom het model, in plaats van uit een enkele "verkeerde prompt". Veelvoorkomende oorzaken zijn onder andere te weinig pagina-inhoud invoeren, het model in vrije tekst laten antwoorden, dezelfde zoekwoordformule op elke URL toepassen en output publiceren zonder controle op duplicaten op siteniveau.
Er bestaat ook een hardnekkig misverstand over tekenlimieten. Google zegt dat er geen vaste lengtelimiet is voor een <title>element of meta-beschrijving van een pagina; titellinks en fragmenten worden indien nodig ingekort, meestal op basis van de breedte van het apparaat. Google kan ook een andere titellink of fragment genereren op basis van de pagina-inhoud als de systemen een andere weergave nuttiger achten. Zie de officiële richtlijnen van Google voor titellinks , fragmenten en meta-beschrijvingen .
Dat betekent dat een script weliswaar redactionele lengtebeperkingen kan afdwingen voor consistentie, maar dat deze getallen niet als Google-vereisten mogen worden bestempeld. In het onderstaande voorbeeld zijn 65 tekens voor de titel en 165 voor de beschrijving slechts interne richtlijnen. Pas deze aan uw CMS, merkidentiteit, lokalisatiebehoeften en beoordelingsproces aan.
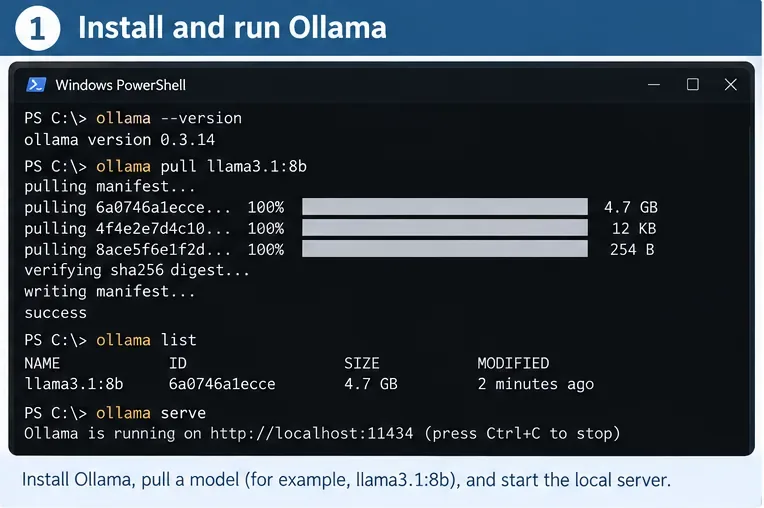
Stap 1: Installeer Ollama en controleer of de lokale API werkt.
De officiële snelstartgids van Ollama vermeldt ondersteuning voor macOS, Windows en Linux. Download na de installatie een lokaal model. De huidige documentatie van Ollama gebruikt vaak gemma3in API-voorbeelden, dus het is een handig neutraal voorbeeld voor deze handleiding:
ollama pull gemma3
Test vervolgens het lokale eindpunt:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
De Ollama API-documentatie vermeldt dat de lokale API beschikbaar is op http://localhost:11434/api. Ollama geeft ook aan dat lokale toegang tot dit adres geen authenticatie vereist. Als uw lokale service niet actief is, ollama serveis het gedocumenteerde CLI-commando om deze te starten. Vermijd het vervangen van een -cloudmodel als uw doel daadwerkelijk lokale inferentie is.
Een workflow voor de terminal tijdens de installatiefase: verifieer Ollama, haal een lokaal model op, controleer of het in de lijst met lokale modellen verschijnt en zorg ervoor dat de service beschikbaar is op localhost. De getoonde waarden voor modelnaam en lengte zijn voorbeelden van workflowwaarden en geen SEO-vereisten.
Kies een model dat bij uw hardware past.
Dit artikel beweert bewust niet dat er één universeel beste model is voor SEO-metadata. De beschikbaarheid van modellen en de compatibiliteit met hardware veranderen in de loop der tijd, en grotere modellen vereisen meer geheugen en reageren over het algemeen trager. Begin met een model dat uw computer probleemloos kan uitvoeren, genereer een kleine set recensies en vergelijk vervolgens de feitelijke nauwkeurigheid, uniciteit, latentie en consistentie voordat u duizenden pagina's verwerkt.
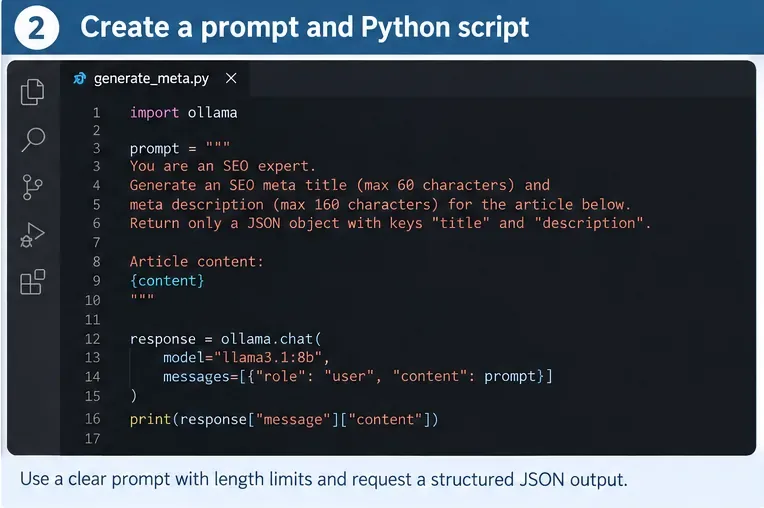
Stap 2: Dwing gestructureerde uitvoer af in plaats van het ontleden van tekst.
Vrije tekst is kwetsbaar voor automatisering. Een antwoord zoals "Hier zijn drie goede opties..." dwingt je programma om te raden waar de eigenlijke titel begint. De documentatie van Ollama over gestructureerde uitvoer ondersteunt het doorgeven van een JSON-schema in het formatveld. De documentatie beveelt ook herbruikbare schema's aan via Pydantic in Python en merkt op dat een lage temperatuur, zoals 0, de determinisme kan verbeteren.
Installeer de twee Python-pakketten die in dit voorbeeld worden gebruikt:
python -m pip install -U ollama pydantic
Maak vervolgens het volgende aan generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
De generator moet expliciet zijn over het bewijsmateriaal op de pagina, de uitvoervelden en de redactionele beperkingen. In een productieomgeving is het beter om de JSON-schema-gestructureerde uitvoer van Ollama en de validatie aan de applicatiezijde te gebruiken in plaats van alleen op de prompttekst te vertrouwen.
Waarom de prompt de huidige titel en H1 bevat
Google zegt dat het systeem voor titel-links rekening kan houden met de belangrijkste visuele titel van de pagina <title>, kopteksten zoals <h1> <h1>, og:title<h2>, prominente tekst, ankertekst en andere signalen. Je lokale generator hoeft het systeem van Google niet exact na te bootsen, maar door de brontitel, H1-tag, URL en representatieve tekst aan te leveren, zorg je ervoor dat de voorgestelde metadata beter aansluit op de pagina die lezers daadwerkelijk te zien krijgen.
Voer geen irrelevante zoekwoordlijsten in en vraag het model niet om ze erin te passen. Google raadt expliciet beschrijvende, beknopte titels aan en waarschuwt tegen keyword stuffing en herhaalde standaardteksten. Wat beschrijvingen betreft, zegt Google dat paginaspecifieke programmatische generatie geschikt is voor grote, databasegestuurde websites, mits de beschrijvingen accuraat, leesbaar en gevarieerd zijn.
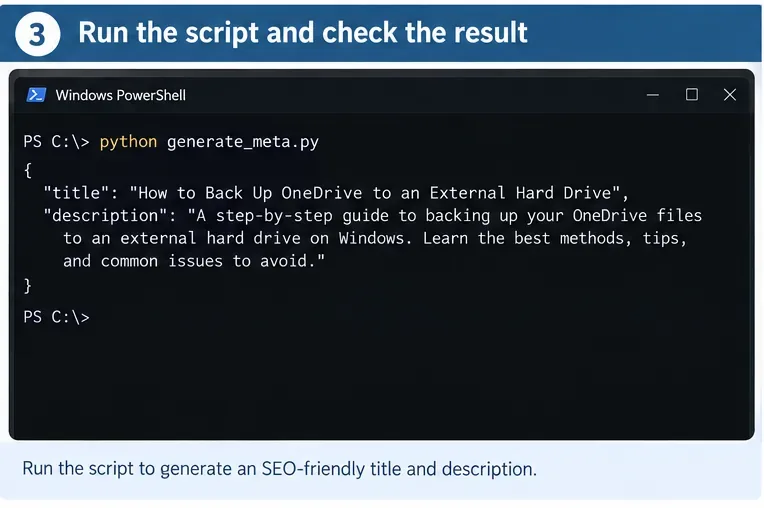
Stap 3: Voer één pagina uit en valideer deze voordat u gaat schalen.
Voer het script uit:
python generate_meta.py
Een succesvol resultaat moet een JSON-object zijn dat Pydantic kan valideren. Belangrijker nog, een menselijke beoordelaar moet het kunnen vergelijken met de bronpagina en snel vier vragen kunnen beantwoorden:
Beschrijft de titel specifiek deze pagina in plaats van de website in het algemeen?
Worden in de beschrijving beweringen, data, prijzen of kenmerken vermeden die niet in de brontekst voorkomen?
Zou deze metadata nog steeds zinvol zijn als deze zonder de pagina-inhoud wordt gelezen?
Is het anders dan de metadata die al op nabijgelegen pagina's wordt gebruikt?
Test eerst één representatieve pagina en controleer het gestructureerde resultaat voordat u een batchtaak start. Een parseerbare JSON-respons is noodzakelijk, maar feitelijke juistheid en relevantie op paginaniveau moeten nog steeds worden gevalideerd.
Voeg herhaalpogingen toe voor fouten in de redactie, niet alleen voor API-fouten.
Een schema kan gegevenstypen en -lengtes beperken, maar het kan niet garanderen dat een zin waarheidsgetrouw of voldoende specifiek is. Bouw herhalingslogica op basis van meetbare controles. Weiger bijvoorbeeld een leeg veld, een dubbele titel, verboden standaardtekst of een beschrijving die de titel bijna woord voor woord herhaalt. Als de pagina gereguleerde of risicovolle beweringen bevat, vereis dan een menselijke beoordeling in plaats van te proberen de betrouwbaarheid te automatiseren.
Houd de prompts voor het opnieuw proberen beperkt. In plaats van alles opnieuw te genereren met "maak het beter", vertel het model wat er mis is gegaan: "De voorgestelde titel is een duplicatie van een andere pagina. Herschrijf de titel met behulp van het unieke onderwerp in de H1, waarbij elke bewering gebaseerd blijft op de aangeleverde inhoud." Dit maakt het controleren van fouten eenvoudiger.
Stap 4: Exporteer pagina's in batches naar CSV voor beoordeling en publicatie.
Zodra de test met één pagina betrouwbaar is, sla je de invoergegevens op in een CSV-bestand met kolommen zoals url, source_title, h1, en content. Het veld 'Content' moet schone paginatekst bevatten, geen navigatiemenu's, cookie-meldingen of duizenden irrelevante links in de voettekst.
Voeg deze batchlogica toe onder de generatorfunctie of plaats deze in een apart script:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Het gegenereerde CSV-bestand kan worden bekeken in Excel, LibreOffice, een tool voor het importeren van databases of in uw CMS-workflow. Overschrijf de live metadata niet automatisch bij de eerste keer uitvoeren. Bewaar de oorspronkelijke titel en beschrijving naast het gegenereerde voorstel, zodat beoordelaars deze kunnen vergelijken en terugdraaien eenvoudig is.
Een wachtrij voor spreadsheetcontrole maakt het controleren van bulkgeneratie eenvoudiger: bewaar de bronpagina-identificatie, de gegenereerde titel, de gegenereerde beschrijving, de lengtes en de QA-vlaggen voordat de wijzigingen worden gepubliceerd.
Maak de batchverwerkingspijplijn veiliger
Rekening
Wat moet ik markeren?
Waarom het belangrijk is
Schemavalidatie
Ontbrekende of ongeldige velden
Voorkomt dat onjuist opgemaakte uitvoer in het CMS terechtkomt.
Controle op dubbele titels
Dezelfde gestandaardiseerde titel op twee URL's.
Helpt pagina's van elkaar te onderscheiden.
Taalcontrole
De taal van de metadata verschilt van de paginataal.
Google raadt aan om de primaire taal en het schrijfsysteem van de pagina te gebruiken.
Bewijscontrole
Cijfers, prijzen, data, merken of garanties ontbreken in de bron.
Vermindert claims die gebaseerd zijn op hallucinaties.
Standaardtekstcontrole
Lange, op de hele site herhaalde zinnen
Google raadt het gebruik van herhaalde standaardtitels af.
Controle van de redactionele lengte
Buiten het door u gekozen huisbereik
Zorgt voor consistente CMS-output; dit is geen tekenlimietregel van Google.
Menselijke beoordeling
Strategische, gevoelige, drukbezochte of onduidelijke pagina's
Automatisering moet uitzonderingen aan het licht brengen, niet verbergen.
Veelvoorkomende problemen, van de makkelijkste tot de moeilijkste oplossing.
De API-verbinding mislukt.
Controleer eerst of Ollama actief is en http://localhost:11434bereikbaar is. De officiële authenticatiedocumentatie vermeldt dat authenticatie niet vereist is voor de lokale API. Als uw script per ongeluk verwijst naar https://ollama.com/api, dan is dat een ander gehost eindpunt waarvoor authenticatie vereist is.
Het antwoord bevat tekst rondom de JSON.
Gebruik het schema format=SeoMeta.model_json_schema()in plaats van alleen in natuurlijke taal om JSON te vragen. Gestructureerde uitvoer is de juiste controlelaag voor een productiepipeline.
Alle titels klinken hetzelfde.
Voer paginaspecifieke H1-tekst en betekenisvolle bodycontent in, verwijder globale navigatie-elementen en vraag expliciet om een paginaspecifieke beschrijving. Voer vervolgens een controle uit op duplicaten en overeenkomsten tussen pagina's. Herhaling is vaak een invoerprobleem voordat het een modelprobleem wordt.
Het model verzint kenmerken of statistieken.
Beperk de invoer tot gezaghebbende paginatekst en versterk de basisregel: geen feitelijke beweringen die verder gaan dan de aangeleverde inhoud. Vergelijk voor belangrijke pagina's de gegenereerde beweringen met gestructureerde bronvelden voordat u ze goedkeurt. Als de bron zelf onduidelijk is, stuur de regel dan door naar een menselijke beoordelaar in plaats van het model herhaaldelijk te laten gissen.
Het model is te traag voor duizenden pagina's.
Meet de prestaties voordat u de architectuur wijzigt. Registreer de generatietijd per pagina, de invoergrootte, de modelnaam en het foutpercentage. Verwijder irrelevante tekst, verwerk stabiele paginadelen en test een kleiner lokaal model als de kwaliteit acceptabel blijft. Het snelste model is niet bruikbaar als de metadata ervan meer revisiewerk oplevert dan het bespaart.
Optioneel: gebruik een bestaande OpenAI-integratie.
Als je al code hebt geschreven voor een OpenAI-compatibele client, documenteert Ollama gedeeltelijke OpenAI API-compatibiliteit op [link http://localhost:11434/v1/]. Dat kan de migratiewerkzaamheden vereenvoudigen. Voor een nieuwe, alleen lokaal te gebruiken metadata-tool is de native Ollama Python-client eenvoudiger en biedt deze voorbeelden van gestructureerde uitvoer direct in de Ollama-documentatie.
Hoe u het voltooide systeem zelf kunt controleren
Voordat u de automatisering als voltooid beschouwt, maakt u een set beoordelingen aan met verschillende inhoudstypen: een kort artikel, een uitgebreide handleiding, een productpagina, een categoriepagina, een pagina met cijfers en een pagina in elke ondersteunde taal. Voer hetzelfde model en dezelfde prompt uit op al deze items en controleer vervolgens de volgende checklist.
Het lokale eindpunt is localhosten het geselecteerde model is een lokaal model, geen model met een cloudtag.
Elke reactie wordt gevalideerd aan de hand van het schema zonder handmatige JSON-opschoning.
Geen enkele gegenereerde titel komt in alle recensies voor.
Alle feitelijke beweringen zijn terug te vinden in de aangeleverde pagina-inhoud.
De metadata gebruikt dezelfde primaire taal en hetzelfde schrijfsysteem als de pagina.
De titel is beschrijvend en bondig, zonder herhaalde trefwoorden.
De beschrijving vat de specifieke pagina samen, niet de website als geheel.
De interne lengtebeperkingen zijn aangeduid als redactionele regels, niet als vereisten van Google.
De oude metadata, het gegenereerde voorstel, de QA-vlaggen, de modelnaam en de promptversie worden bewaard voor controle en terugdraaien.
Een beoordelaar weet welke vlaggen handmatige goedkeuring vereisen vóór publicatie.
Onthoud tot slot wat automatisering wel en niet kan controleren. Een goede <title>meta-beschrijving geeft zoekmachines nuttige signalen op paginaniveau, maar Google kan titellinks en snippets genereren op basis van andere pagina-inhoud. Het doel is daarom niet om een specifieke weergave van zoekresultaten af te dwingen. Het doel is om op grote schaal accurate, onderscheidende en bruikbare metadata te produceren, met voldoende validatie en controle om fouten op te sporen voordat ze in productie worden genomen.