Home
» Domeinen
»
Hoe lipsynchronisatieproblemen in AI-videogeneratoren (HeyGen & ElevenLabs) op te lossen
Hoe lipsynchronisatieproblemen in AI-videogeneratoren (HeyGen & ElevenLabs) op te lossen
Voordat we problemen oplossen, is het belangrijk om eerst even te verduidelijken wat ElevenLabs Dubbing nodig heeft: het voert momenteel geen lipsynchronisatie uit. ElevenLabs geeft aan dat lipsynchronisatie apart beschikbaar is in Image & Video, Flows en Studio via speciale modellen van derden. HeyGen splitst de vertaling momenteel op in Audio Only, Speed lipsynchronisatie en Precision lipsynchronisatie. Dit betekent dat de juiste oplossing afhangt van waar in je workflow de mondanimatie daadwerkelijk wordt gegenereerd.
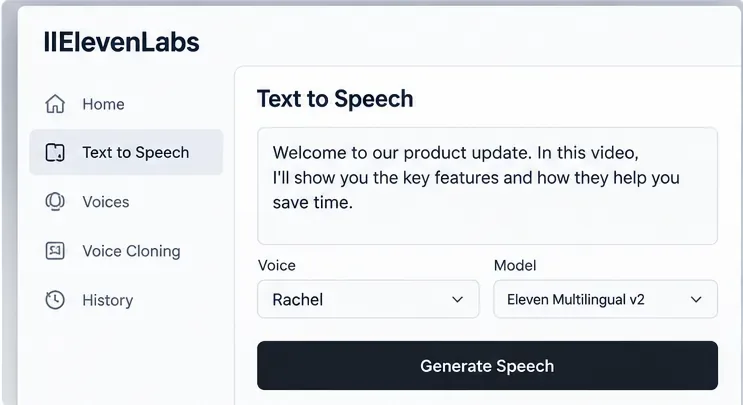
Als je spraak genereert in ElevenLabs en vervolgens een avatar animeert in HeyGen, beschouw het ElevenLabs-bestand dan als de audiobron en HeyGen als de lipsynchronisatiestap. Als je ElevenLabs Dubbing gebruikt voor vertaling, ga er dan niet vanuit dat de Dubbing-stap op zich de mondbewegingen verandert; stuur de voltooide spraak daarna door naar een lipsynchronisatietool. Als je een bestaande video vertaalt in HeyGen, kies dan de lipsynchronisatie-engine op basis van het beeldmateriaal in plaats van ervan uit te gaan dat de duurdere modus altijd nodig is.
Deze handleiding is gecontroleerd aan de hand van de actuele documentatie van HeyGen en ElevenLabs op 13 september 2026. Productcontroles en kredietvoorwaarden kunnen wijzigen, daarom zijn de gelinkte officiële pagina's de meest accurate bron.
Stel eerst vast wat voor soort lipsynchronisatieprobleem er is.
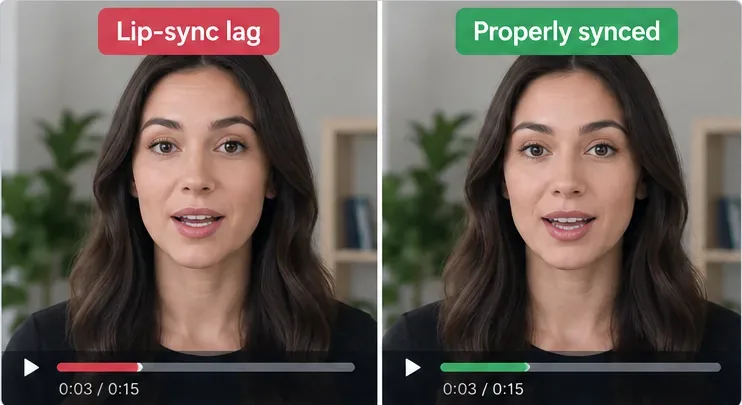
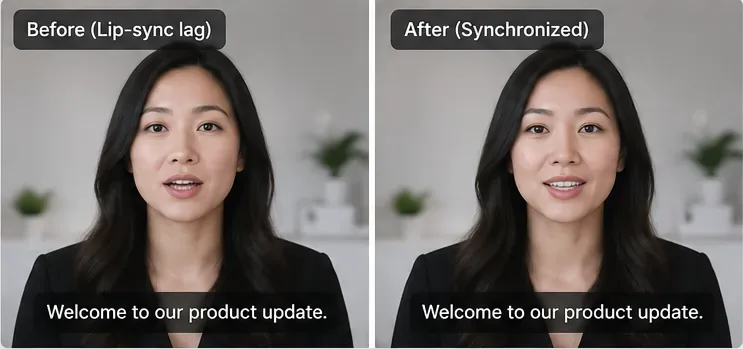
"Lip-sync lag" kan verschillende dingen betekenen. Het corrigeren van de verkeerde laag kost generaties en credits.
Wat je ziet
Waarschijnlijk probleem
De beste eerste zet
De monding is van begin tot eind ongeveer evenveel te laat.
Constante audio-/video-offset of voorafgaande stilte
Knip of verschuif het geluid voordat de volledige video opnieuw wordt gegenereerd.
De eerste zin klopt, maar de afwijking wordt na verloop van tijd erger.
De duur van de spraak en de timing van de video lopen uiteen.
Herstel in een beter tempo, splits de scène op of gebruik duuraanpassing.
Alleen bepaalde woorden zien er verkeerd uit.
Klank/articulatie mismatch
Genereer de betreffende zin opnieuw of gebruik een lipsynchronisatieproces met een hogere resolutie.
Foto's van voren werken wel, maar zijprofielen niet.
Visuele volgmoeilijkheid
Gebruik HeyGen Precision of vereenvoudig de bronopname.
De nasynchronisatie van ElevenLabs klinkt goed getimed, maar de mondbewegingen in het origineel blijven hetzelfde.
De nasynchronisatie werd verward met lipsynchronisatie.
Stuur de nagesynchroniseerde audio naar een speciaal lipsynchronisatiemodel of HeyGen.
Voordat je de instellingen wijzigt, bepaal eerst of je te maken hebt met een constante afwijking, een geleidelijke verschuiving of slechts een paar afwijkende mondvormen; elk probleem vereist een andere oplossing.
1. Kies één betrouwbare audiobron voordat je de video genereert.
Een veelgemaakte fout in de workflow is het genereren van een stem in ElevenLabs en vervolgens de videobewerkingstool het script te laten synthetiseren of herinterpreteren. Dat leidt tot twee timingbeslissingen in plaats van één. Als je de ElevenLabs-stem wilt gebruiken, maak die audio dan eerst af en gebruik die consequent als bron voor de avatarscène.
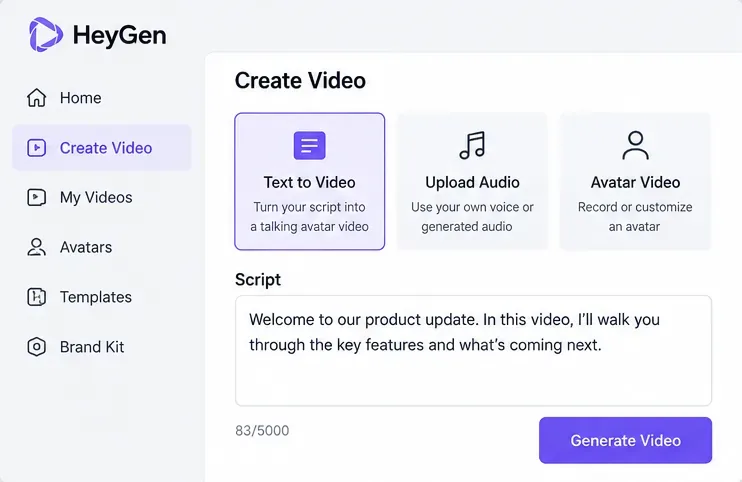
Volgens de huidige documentatie van HeyGen Studio kan aangepaste audio worden toegevoegd door een vooraf opgenomen bestand te uploaden of door direct audio op te nemen. De Studio is scriptgericht en HeyGen merkt op dat volledige previews van geanimeerde avatars niet beschikbaar zijn tijdens het bewerken, omdat de avatar eerst gegenereerd moet worden; je kunt de audio wel beluisteren voordat je het bestand indient.
Aanbeveling: genereer voor complexe of lange scènes eerst een korte testscène. Controleer het gedrag van de audio, gezichten en mondbewegingen voordat u de volledige scène genereert.
Kies één spraakbron voor de scène. Als je de audio van ElevenLabs al hebt goedgekeurd, upload die dan in plaats van de voordracht zelfstandig opnieuw op te nemen.
2. Los eerst het tempo van ElevenLabs op voordat je de lipsynchronisatie-engine de schuld geeft.
Als de spraak zelf gehaast, ongewoon traag of vol ongemakkelijke pauzes is, moet de videogenerator die timing animeren. Schone audio is gemakkelijker te synchroniseren dan audio die je achteraf nog wilt repareren nadat de mondanimatie al is gegenereerd.
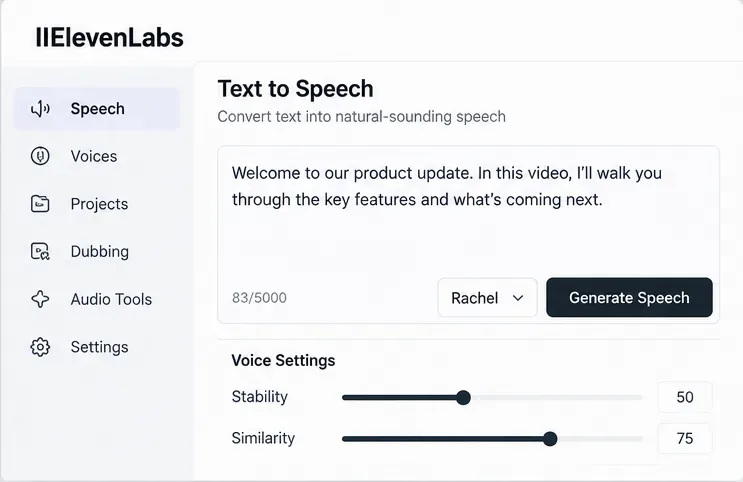
ElevenLabs documenteert momenteel een spraaksnelheidsregeling van 0,7 tot 1,2 in tekst-naar-spraak, waarbij 1,0 de normale snelheid is. Het bedrijf waarschuwt dat extreme waarden de kwaliteit kunnen verminderen. In de documentatie over best practices wordt ook vermeld dat overmatig gebruik van pauzemarkeringen instabiliteit of een onvoorspelbaar tempo kan veroorzaken.
Afweging: het aanpassen van de spreeksnelheid kan helpen om een zin binnen de gewenste lengte te houden, maar het beïnvloedt ook de voordracht. Als de stem gehaast of onnatuurlijk langgerekt klinkt, is het herschrijven van de zin meestal beter dan de spreeksnelheid verder aan te passen.
Genereer en keur de spraak eerst goed. Luister naar eventuele problemen met het tempo, onregelmatige pauzes of gehaaste zinnen voordat je het bestand gebruikt voor lipsynchronisatie.
Een opmerking over de snelheidsregeling van Eleven v3
De officiële documentatie van ElevenLabs is op één punt inconsistent: het Helpcentrum stelt dat de snelheidsinstelling beschikbaar is voor alle stemmen en modellen, terwijl de producthandleiding voor tekst-naar-spraak een modelspecifieke opmerking bevat waarin staat dat de snelheidsinstelling niet beschikbaar is voor Eleven v3. Omdat beide verklaringen officieel zijn, is het raadzaam om de daadwerkelijk weergegeven instellingen voor het geselecteerde model te controleren in plaats van ervan uit te gaan dat er altijd een snelheidsregelaar aanwezig is.
Actie: als het geselecteerde model de snelheid niet weergeeft, regel dan de timing via tekst, interpunctie, modelspecifieke audiotags of een ander ondersteund model in plaats van te vertrouwen op een niet-bestaande bediening.
3. Verwijder onnodige stilte en controleer op een constante offset.
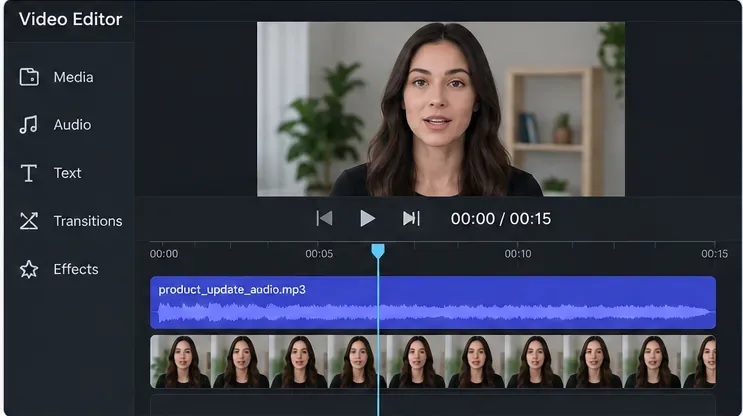
Als de mondbewegingen consequent met dezelfde hoeveelheid te laat of te vroeg zijn, is het aanpassen van het AI-model mogelijk niet nodig. Bekijk het audiobestand in een tijdlijn. Een korte aanloop vóór de eerste gesproken medeklinker, of een audiofragment dat een paar frames verwijderd is van het beoogde begin, kan de indruk wekken van een mislukte lipsynchronisatie.
Een verschuiving van vier frames bij 30 fps is bijvoorbeeld ongeveer 133 milliseconden. Dat is groot genoeg om er bij spraak van dichtbij onnatuurlijk uit te zien, zelfs als de mondanimatie zelf intern consistent is.
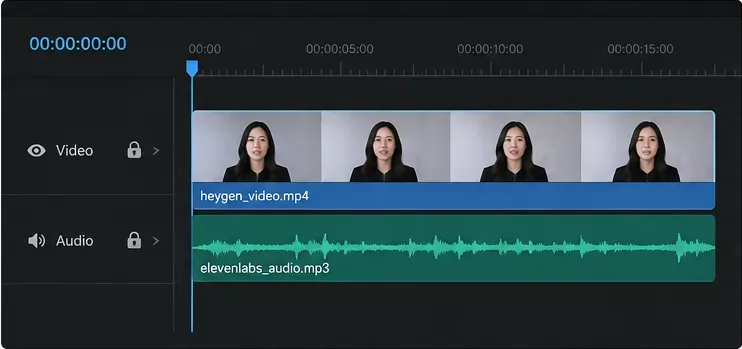
Actie: lijn de eerste duidelijke spraaktransiënt uit met het verwachte begin van het beeld. Als het probleem na generatie een vaste verschuiving blijft vertonen, verschuif dan de audio in een video-editor in plaats van elk element opnieuw te genereren.
Voor een constante offset, inspecteer de golfvorm en de beginpunten van de clip voordat je credits besteedt aan het genereren van een nieuwe avatar.
4. Gebruik kortere segmenten wanneer de drift in de loop van de tijd toeneemt.
Progressieve verschuiving is iets anders dan een vaste verschuiving. Als de eerste paar seconden er correct uitzien en de mond geleidelijk achterloopt, komt de gesproken tijdsduur niet goed overeen met de visuele timing. Lange, aaneengesloten scènes versterken kleine timingverschillen.
Splits een lange gesproken tekst op in kortere, logische zinnen of fragmenten, genereer ze afzonderlijk en voeg ze later samen. Dit geeft je een kleinere eenheid om opnieuw te genereren als slechts één gedeelte fout is. De Voice Mirror-handleiding van HeyGen raadt ook aan om te beginnen met korte segmenten terwijl je het gewenste tempo en verwerkingsgedrag leert kennen.
Afweging: kortere segmenten verbeteren de herstelbaarheid, maar te veel knippen kan de toon en sfeer minder consistent maken. Houd dezelfde steminstellingen aan en vermijd het veranderen van de uitvoeringsstijl tussen opeenvolgende segmenten, tenzij het script dit vereist.
Test eerst een korte zin. Zodra de timing betrouwbaar is, kun je de workflow uitbreiden naar langere scènes in plaats van meteen een volledige video te debuggen.
5. Kies in HeyGen Video Translation voor Snelheid of Precisie, afhankelijk van de opname.
Het huidige videovertalingssysteem van HeyGen biedt drie engine-opties:
Alleen audio: vertalingen en herstemde stemmen zonder lipsynchronisatie.
Snelheid: lipsynchronisatie geoptimaliseerd voor video-opnames met de camera naar voren, beperkte gezichtsbedekking en eenvoudigere gesprekken.
Precisie: hoogwaardigere lipsynchronisatie bedoeld voor zijprofielen, veranderingen in camerahoek, gezichtsverhulling, wisselingen van spreker en complexere gesprekken.
Op 13 september 2026 vermeldt het Helpcentrum van HeyGen een tarief van 6 credits per minuut voor Snelheid en 10 credits per minuut voor Precisie in het huidige creditsysteem. Dit tarief is nuttig om de afweging te begrijpen, maar controleer het product voordat u gaat genereren, aangezien de prijzen kunnen veranderen.
Aanbeveling: gebruik Snelheid voor één spreker die zich binnen een hoek van ongeveer 45 graden van de camera bevindt en wiens gezicht duidelijk zichtbaar is. Upgrade naar Precisie wanneer het lastiger is om de beelden te volgen. Het uitgeven van meer credits lost problemen met slechte bronaudio niet op, dus zorg eerst voor een goede timing.
HeyGen adviseert ook close-ups, minimale camerawisselingen, minder achtergrondgeluid en slechts één spreker tegelijk voor een betere lipsynchronisatie bij de vertaling.
6. Gebruik dynamische duur wanneer de vertaalde spraak meer ruimte nodig heeft.
Verschillende talen hebben zelden precies dezelfde tijd nodig om hetzelfde idee over te brengen. De huidige geavanceerde instellingen van HeyGen bevatten 'Dynamische duur inschakelen' , waarmee de duur van segmenten tot ±20% kan worden verlengd of verkort voor een natuurlijker vertaalde spraak. HeyGen merkt op dat dit de totale videolengte kan beïnvloeden.
Kies Dynamische Duur wanneer: natuurlijke weergave belangrijker is dan het behouden van de exacte oorspronkelijke looptijd.
Vermijd het gebruik ervan wanneer: de video frame-nauwkeurig moet blijven ten opzichte van de muziek, vaste graphics, uitzendtijden of extern getimede signalen. Herschrijf in dat geval eerst de vertaling of pas de spraaktiming van ElevenLabs aan.
Als de looptijd belangrijk is, genereer dan de gesproken zin opnieuw totdat de natuurlijke duur ervan bij de scène past, in plaats van een grote timingcorrectie verderop in het proces af te dwingen.
7. Verwacht niet dat ElevenLabs Dubbing alleen de mond zal animeren.
Dit is het belangrijkste verschil in workflow tussen de twee platforms. In de huidige documentatie van ElevenLabs over nasynchronisatie staat expliciet vermeld dat nasynchronisatie geen lipsynchronisatie omvat. Lipsynchronisatietools zijn afzonderlijk beschikbaar in ElevenLabs Image & Video, Flows en Studio via gespecialiseerde modellen.
ElevenLabs Dubbing v2 wordt momenteel beschreven als een alfaversie. Het behoudt timing, toon en sprekerkenmerken, maar de standaard webworkflow van v2 is automatisch en biedt geen mogelijkheid tot transcriptbewerking binnen de app. Transcriptbewerking en audioregeneratie via de v2 API zijn momenteel alleen beschikbaar voor Enterprise-gebruikers. Dubbing Studio, gebaseerd op v1, blijft beschikbaar, maar bevindt zich in de onderhoudsmodus en ontvangt alleen kritieke bugfixes.
Voor een HeyGen + ElevenLabs-workflow: genereer of dub de uiteindelijke spraak in ElevenLabs en upload vervolgens de goedgekeurde audio naar HeyGen voor de mondanimatie.
Wanneer ElevenLabs de definitieve stemopname levert, gebruik dan dat goedgekeurde bestand als invoer voor de lipsynchronisatiefase in plaats van te verwachten dat de nasynchronisatiestap de mondbewegingen aanpast.
Wat als je helemaal binnen ElevenLabs wilt blijven?
ElevenLabs Image & Video biedt momenteel speciale lipsynchronisatiemodellen voor bronafbeeldingen of -video's in combinatie met spraakaudio. De documentatie vermeldt opties zoals HeyGen Avatar 4, Sync 3, Sync Lipsync 2 Pro, Veed Lipsync en andere. De beschikbaarheid kan per model en regio verschillen; zo staat er bijvoorbeeld in de documentatie dat OmniHuman 1.5 niet beschikbaar is in de Verenigde Staten.
Afweging: in één werkruimte blijven kan het beheer van assets vereenvoudigen, maar dit zijn aparte nabewerkings- of avatarmodellen met hun eigen kosten en beperkingen. Verwar deze niet met de nasynchronisatiefunctie zelf.
8. Als er slechts een resterende constante vertraging overblijft, corrigeer deze dan eenmaal in de eindeditor.
Nadat je het tempo, de audiobron en de lipsynchronisatiemodus hebt ingesteld, kan er nog steeds een kleine, constante afwijking overblijven. Als de mondbewegingen gedurende de hele clip steeds met dezelfde hoeveelheid te vroeg of te laat zijn, is een laatste aanpassing van de tijdlijn vaak goedkoper en voorspelbaarder dan een volledige nieuwe generatie.
Verschuif de audiotrack een paar frames, beluister plosieve medeklinkers zoals p , b en m en controleer minstens drie punten: het begin, het midden en het einde. Als de verschuiving in de loop van de tijd verandert, blijf dan niet de hele track verschuiven; ga terug naar de instellingen voor tempo of segmentduur, omdat je te maken hebt met een verschuiving, niet met een vaste verschuiving.
Een eindbewerkingsprogramma is het meest geschikt voor een kleine, constante afwijking. Progressieve verschuivingen moeten eerder worden gecorrigeerd door de spraakduur aan te passen of het betreffende segment opnieuw te genereren.
Hoe kun je pauzes in ElevenLabs beheren?
De manier waarop pauzes worden afgehandeld, hangt af van het model. ElevenLabs geeft aan dat Eleven v3 audiotags en leestekens gebruikt in plaats van SSML-breaktags. Multilingual v2, Flash v2 en Flash v2.5 ondersteunen SSML-achtige <break time="1.5s" />pauzes tot drie seconden. Het bedrijf waarschuwt dat overmatig gebruik van breaktags snelheidsveranderingen, ruis of andere artefacten kan veroorzaken.
Aanbeveling: gebruik zo min mogelijk pauzemarkeringen om het script op een natuurlijke manier weer te geven. Als een vertaalde zin veel kunstmatige pauzes nodig heeft om de visuele timing te laten kloppen, herschrijf de zin dan of splits de scène op.
Wat als de aangepaste HeyGen-avatar zelf een slechte lipsynchronisatie heeft?
Als elke gegenereerde zin onbetrouwbaar is – zelfs met heldere audio – ligt het probleem mogelijk bij de trainingsvideo van de avatar in plaats van bij het huidige spraakbestand. De richtlijnen van HeyGen voor Digital Twin geven aan dat de trainingsvideo de persoon die daadwerkelijk spreekt moet bevatten, omdat audio en video cruciaal zijn voor de lipsynchronisatie van het systeem. Het bedrijf adviseert minimaal 1080p en 30 fps, heldere, gelijkmatige verlichting en heldere audio zonder sterke echo of omgevingsgeluid.
Actie: als de avatar consequent problemen ondervindt met meerdere schone scripts, overweeg dan om hem opnieuw te trainen met beter bronmateriaal voordat je tijd besteedt aan het micro-aanpassen van elke gegenereerde clip.
Snelle video met een sprekende hoofdpersoon, ingesproken door ElevenLabs.
Genereer eerst de audio van ElevenLabs en upload deze vervolgens naar HeyGen Studio.
Eenvoudige workflow, maar de uiteindelijke avatar vereist nog steeds een generatiestap.
Vertaal een eenvoudige video van een bron die aan de voorkant is opgenomen.
HeyGen videovertaling met snelheid
Lagere kosten per credit dan Precision, maar minder geschikt voor complexe opnames.
Vertaal zijprofielen, occlusies of opnames met meerdere sprekers.
HeyGen videovertaling met precisie
Hoger creditgebruik in ruil voor een betere lipsynchronisatie.
Audio van hoge kwaliteit, zonder mondanimatie.
ElevenLabs Dubbing
Bij nasynchronisatie blijven de timing en stemkenmerken behouden, maar de lippen worden niet gesynchroniseerd.
Houd spraak en lipsynchronisatie binnen ElevenLabs.
ElevenLabs Image & Video met een speciaal lipsynchronisatiemodel
De beschikbaarheid van modellen, de kosten en regionale beperkingen variëren.
Er blijft slechts een kleine vaste verschuiving over.
Verschuif audio in een normale video-editor.
Snel en goedkoop, maar alleen geschikt voor constante offset – niet voor drift.
Definitieve checklist voor probleemoplossing
Controleer of de fout een constante verschuiving, een progressieve drift of een woordniveau-mismatch betreft.
Keur de ElevenLabs-audio goed voordat je de avatarvideo genereert.
Vermijd extreme veranderingen in spreeksnelheid, enkel en alleen om de zin een bepaalde duur te geven.
Gebruik de voor het model geschikte pauzeknoppen en vermijd overmatige pauzemarkering.
Verwijder duidelijke inleidende stiltes en controleer de eerste uitgesproken medeklinker.
Gebruik kortere scènes wanneer de afwijking in de loop van de tijd toeneemt.
Kies HeyGen Speed voor eenvoudige opnamen vanaf de voorkant en Precision voor lastige hoeken of opnamen waarbij het beeld niet bedekt is.
Gebruik dynamische duur alleen wanneer het acceptabel is om de totale looptijd te wijzigen.
Houd er rekening mee dat ElevenLabs Dubbing op zichzelf geen mondanimatie biedt.
Gebruik een laatste tijdlijnverschuiving alleen voor een consistente verschuiving die niet over de hele clip toeneemt.
Kortom
De beste oplossing voor lipsynchronisatieproblemen is niet één enkele instelling, maar een diagnose. Als de hele clip evenveel afwijkt, corrigeer dan de afwijking. Als de afwijking in de loop van de tijd toeneemt, pas dan het tempo of de duur van de segmenten aan. Als alleen lastige camerahoeken problemen geven, gebruik dan een sterkere lipsynchronisatiemodus. Als je ElevenLabs Dubbing gebruikt, voeg dan een aparte lipsynchronisatiestap toe, omdat Dubbing zelf de mond niet animeert.
Voor de meeste HeyGen + ElevenLabs-workflows is de meest efficiënte aanpak om de spraak in ElevenLabs te perfectioneren, een kort fragment in HeyGen te testen, Snelheid of Precisie te kiezen op basis van het bronmateriaal, en externe tijdlijncorrectie te reserveren voor de kleine, constante afwijkingen die na de generatie overblijven.