Home
» Domeinen
»
Hoe los ik de "API Timeout Error" op bij het uitvoeren van workflows met meerdere agents?
Hoe los ik de "API Timeout Error" op bij het uitvoeren van workflows met meerdere agents?
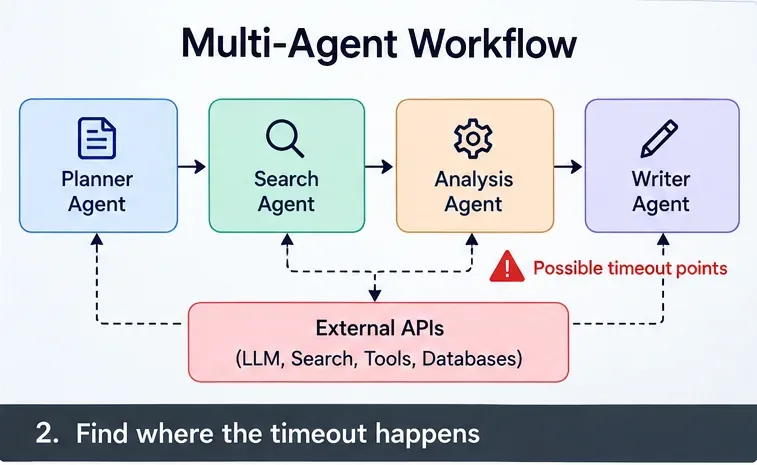
Een "API-time-outfout" in een workflow met meerdere agents wordt zelden opgelost door één getal te wijzigen. Een planner kan drie agents aanroepen, elke agent kan een LLM-, zoekservice-, database- of tool-API aanroepen, en elke laag kan zijn eigen time-out, herhalingsbeleid, verbindingspool en gelijktijdigheidslimiet hebben. De praktische oplossing is om te bepalen welke laag als eerste een time-out geeft, en vervolgens te kiezen tussen langere wachttijden, minder gelijktijdige aanroepen, slimmere herhalingspogingen, een korter kritiek pad of een asynchroon taakontwerp.
De afweging is belangrijk: het verhogen van de time-out is eenvoudig, maar legt langer beslag op resources; agressieve herhaalpogingen kunnen de belasting en kosten verhogen; het verlagen van de gelijktijdigheid verbetert de stabiliteit, maar vermindert de piekdoorvoer; parallelle agents verlagen de werkelijke latentie alleen wanneer de downstream-services de extra belasting aankunnen. Er is geen universeel beste instelling voor elk multi-agentsysteem.
Welke time-out treedt er daadwerkelijk op?
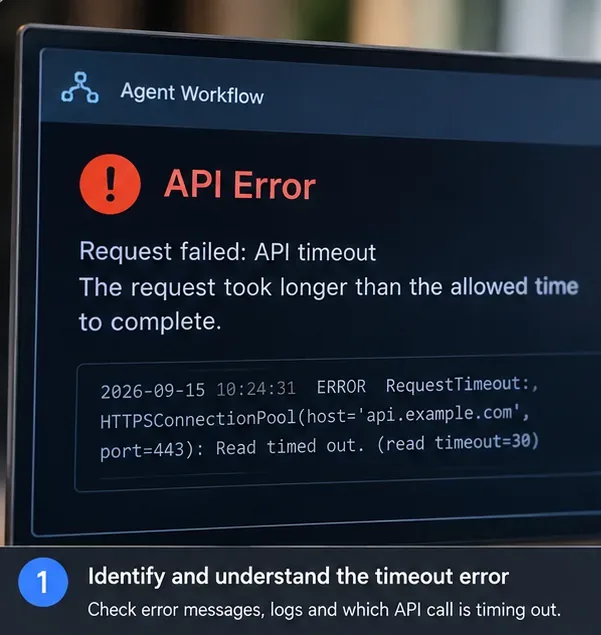
Begin met het classificeren van de fout in plaats van elke time-out als dezelfde gebeurtenis te beschouwen. HTTP-clients kunnen een time-out krijgen tijdens het verbinden, lezen, schrijven of wachten op een verbinding uit een pool. HTTPX documenteert bijvoorbeeld vier afzonderlijke time-outtypen: verbinden, lezen, schrijven en pool. Het standaardgedrag is om een time-out te genereren na vijf seconden netwerkinactiviteit, niet per se na vijf seconden totale aanvraagduur. Zie de officiële HTTPX-time-outdocumentatie .
Als u de OpenAI Python SDK gebruikt, staat in de officiële README vermeld dat verzoeken standaard een clienttime-out van 10 minuten hebben en dat time-outfouten standaard twee keer opnieuw worden geprobeerd. De SDK probeert ook automatisch verbindingsfouten en HTTP 408-, 409-, 429- en 5xx-reacties opnieuw met een korte exponentiële backoff. Dit zijn standaardinstellingen van de SDK en geen garantie dat elke proxy, load balancer, gateway of orchestrator vóór het verzoek 10 minuten zal wachten. Zie de officiële README van de OpenAI Python SDK .
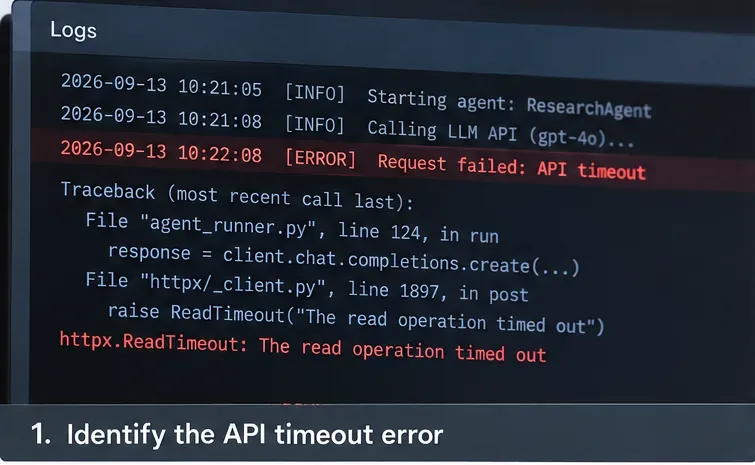
Stap 1: Leg de exacte uitzondering vast, evenals de agent, het eindpunt en de transportlaag die een time-out hebben veroorzaakt, in plaats van alleen een algemene workflowfout te registreren.
Welke oplossing moet je kiezen?
Optie
Beste pasvorm
Belangrijkste voordeel
Belangrijkste afweging
Verhoog de time-out voor het verzoek.
Gezonde, maar aantoonbaar trage model-/toolaanroepen
Minimale code- en architectuurwijzigingen
Werknemers en verbindingen blijven langer bezet; een upstream gateway kan het verzoek nog steeds als eerste afwijzen.
Kan het verkeer, de latentie en de kosten verhogen; onveilig voor niet-idempotente acties, tenzij zorgvuldig ontworpen.
Lagere agent gelijktijdigheid
429-fouten, time-outs van de pool, verzadiging van de downstream-verbinding
Vermindert piekbelastingen en wachtrijcongestie.
Lagere piekdoorvoer en soms een langere doorlooptijd.
Paralleliseer onafhankelijke agenten
Sequentiële workflows met onafhankelijke vertakkingen
Verkort het kritieke pad.
Verhoogt het aantal gelijktijdige verzoeken en kan snelheids- of verbindingslimieten activeren.
Gedeeltelijke uitvoer van de stream
Interactieve UX waarbij de latentie van de eerste byte ertoe doet
Gebruikers zien sneller vooruitgang.
Lost niet automatisch een harde integratietime-out of een overbelaste downstreamservice op.
Verplaats de taak naar een asynchrone taak/wachtrij.
Werkprocessen die tientallen seconden of minuten kunnen duren.
Ontkoppelt de levensduur van HTTP-verzoeken van de levensduur van workflows.
Vereist taakstatus, polling/webhooks, idempotentie, persistentie en operationele monitoring.
Stap 1: Zoek de eerste laag die de deadline overschrijdt.
Registreer een correlatie-ID voor de volledige workflow en een span- of child-ID voor elk agent- en toolgesprek. Noteer de starttijd, eindtijd, eindpunt, pogingsnummer, uitzonderingstype, responsstatus (indien beschikbaar) en of de annulering afkomstig was van de beller of de downstream-service.
De belangrijke vraag is: "Wie stopte er als eerste met wachten?" Als de LLM-aanroep na 42 seconden is voltooid, maar een API-gateway na 30 seconden opgeeft, verandert het verhogen van de LLM-clienttime-out van 60 naar 120 seconden niets. De huidige documentatie van Amazon voor API Gateway HTTP API's vermeldt een maximale integratietime-out van 30 seconden, wat een goed voorbeeld is van waarom de kortste deadline in de keten vaak bepalend is voor het resultaat. Zie Amazon API Gateway HTTP API-quota .
Stap 2: Breng het aanvraagpad in kaart en markeer alle plaatsen waar een oproep kan worden beëindigd of vertraagd: orchestrator, agent, gateway, model-API, zoek-API, database en toolservice.
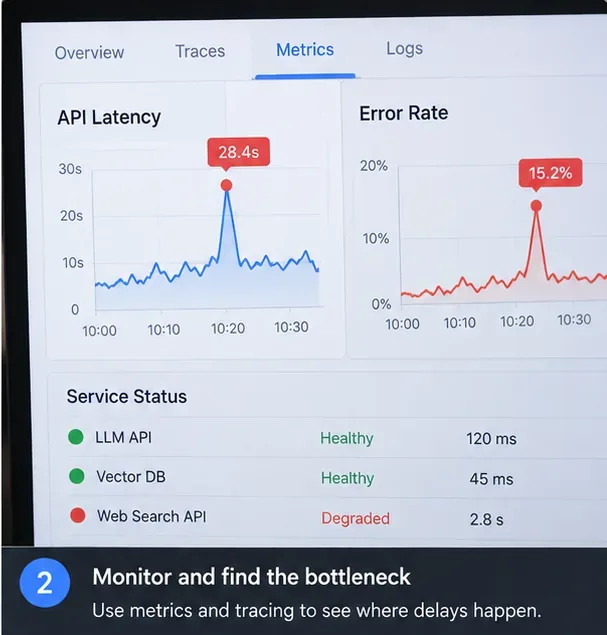
Stap 2: Meet het kritieke pad, niet alleen de gemiddelde latentie.
De gemiddelde latentie kan er gezond uitzien, terwijl een kleine groep trage aanroepen de meeste workflowfouten veroorzaakt. Houd ten minste het succespercentage per afhankelijkheid bij, plus de p50-, p95- en p99-latentie. Registreer in een fan-out-fase ook de wachtrijtijd en de wachttijd in de verbindingspool, omdat een "trage API" in werkelijkheid een overbelaste client kan zijn die wacht op een vrije verbinding.
Gebruik traceringen om drie praktische vragen te beantwoorden: welke afhankelijkheid domineert het kritieke pad, of meerdere trage agents sequentieel draaien terwijl ze gelijktijdig zouden kunnen draaien, en of pieken in gelijktijdigheid samenvallen met 429-, pool-timeout- of 5xx-fouten.
Stap 3: vergelijk latentie, fouten en de status van afhankelijkheden met elkaar; een piek in time-outs die samenvalt met een verslechterde afhankelijkheid suggereert een andere oplossing dan een piek in gelijktijdigheid op systeemniveau.
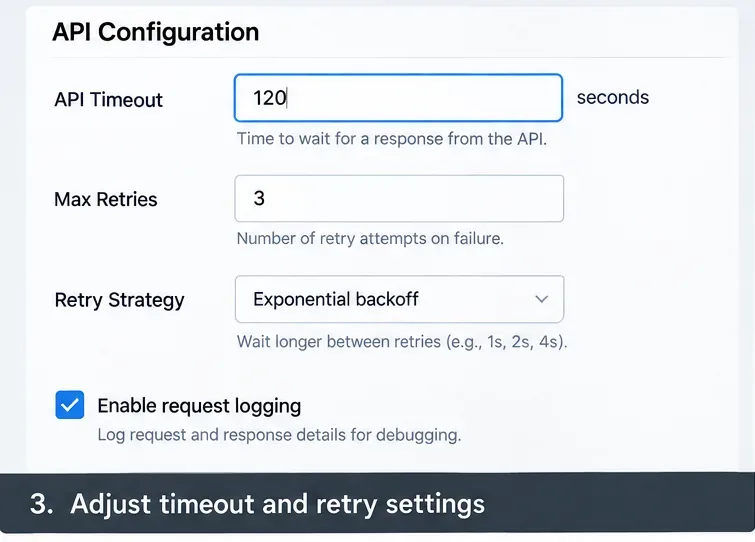
Stap 3: Stel een time-outbudget op vanuit een extern perspectief.
Stel eerst een deadline in voor de gehele workflow en maak de tussentijdse deadlines vervolgens korter, zodat lagere lagen vroeg genoeg falen om de orchestrator de tijd te geven zich te herstellen. Een deadline van 120 seconden voor de gebruiker kan bijvoorbeeld 10 seconden reserveren voor orchestratie en responsverwerking, waardoor er 110 seconden overblijven voor nuttig werk. Een individuele toolaanroep kan 15 seconden krijgen, terwijl een modelaanroep 45 of 60 seconden kan krijgen, afhankelijk van de waargenomen staartlatentie.
Kopieer deze waarden niet blindelings; het zijn slechts voorbeelden van budgetteringsmethoden, geen universele standaardwaarden. Kies waarden uit uw gemeten latentieverdeling en de SLO van uw product. De buitenste deadline moet lang genoeg zijn om de binnenste aanroep, het aantal toegestane herhaalpogingen, de backoff-vertragingen en de opschoontijd te omvatten.
Vanaf Python 3.11 is het mogelijk asyncio.timeout()om een deadline in te stellen voor asynchroon werk. Wanneer de deadline verstrijkt, wordt de taak geannuleerd en geeft de contextmanager een foutmelding weer TimeoutError. Raadpleeg de officiële Python asyncio timeout-documentatie .
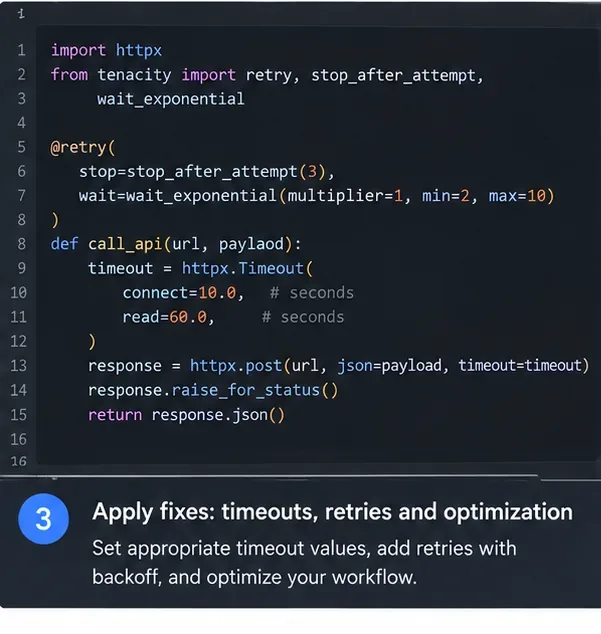
Stap 4: Configureer de time-out- en herhaalpogingswaarden als een gecoördineerd budget in plaats van elke waarde afzonderlijk te verhogen.
Stap 4: Beperk het aantal gelijktijdige processen voordat u het aantal herhaalpogingen verhoogt.
Multi-agentsystemen falen vaak omdat de fan-out sneller groeit dan verwacht. Als 20 gebruikersverzoeken elk vijf agents starten en elke agent twee tools opstart, kan het systeem tot wel 200 downstream-aanroepen genereren voordat er herhaalpogingen plaatsvinden. Het toevoegen van herhaalpogingen aan het begin van het proces kan congestie veranderen in een ware herhalingsstorm.
Een gelijktijdigheidsbeperking is vaak de beste eerste stap wanneer je 429-reacties, time-outs van de pool, een oplopende wachtrijtijd of een afhankelijkheid die verzadigd raakt tegenkomt. Python asyncio.Semaphorebiedt een eenvoudige, op tellers gebaseerde manier om te beperken hoeveel coroutines tegelijkertijd een beveiligde sectie betreden. Zie de officiële Python-documentatie over semaforen .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
De afweging is weloverwogen: een lagere limiet beschermt downstream-services, maar kan de wachtrijvorming binnen uw applicatie vergroten. Stem de limiet af op de doorvoer, p95-latentie, snelheidslimieten en de capaciteit van de verbindingspool, in plaats van het grootste getal te kiezen dat uw machine kan verwerken.
Stap 5: combineer beperkte gelijktijdigheid met expliciete transportinstellingen, zodat een volle verbindingspool zich niet voordoet als een traag model of hulpmiddel.
Stap 5: Herhaal alleen mislukte pogingen waarvan de kans groot is dat ze later wel lukken.
Herhaalde pogingen zijn waardevol bij tijdelijke verbindingsproblemen, snelheidslimieten, specifieke serverfouten en time-outs van verzoeken, wanneer het herhalen van de bewerking veilig is. Ze zijn echter geen goede standaardoplossing bij validatiefouten, authenticatiefouten, deterministische bugs in tools of acties met neveneffecten zonder idempotentiebescherming.
Let op de vermenigvuldiging van het aantal herhaalpogingen. Als een SDK twee herhaalpogingen doet, betekent dit maximaal drie pogingen voor één logische aanroep. Als uw agentlaag de hele aanroep ook twee keer herhaalt, wordt het theoretische maximum negen pogingen voor die ene logische bewerking: drie externe pogingen vermenigvuldigd met drie SDK-pogingen. Als de orchestrator vervolgens een volledige stage van vijf agents herhaalt, kan het aantal aanvragen snel toenemen.
Centraliseer het beheer van herhaalpogingen waar mogelijk. Houd er bij LLM-aanroepen met de OpenAI Python SDK rekening mee dat de huidige SDK bepaalde soorten fouten standaard al twee keer herhaalt. Voeg alleen een extra herhaalpoging toe als u daar een specifieke reden voor hebt en het totale aantal pogingen kunt beperken.
Stap 6: Classificeer de fout voordat u het opnieuw probeert; een time-out bij het lezen kan een beperkte herhaalpoging rechtvaardigen, terwijl een permanente configuratiefout dat meestal niet doet.
Stap 6: Verkort het kritieke pad zonder een fan-outprobleem te creëren.
Als de processen voor planning, onderzoek, evaluatie en schrijven strikt na elkaar worden uitgevoerd, is de totale latentie ongeveer gelijk aan de som van hun duur. Onafhankelijke processen kunnen soms gelijktijdig worden uitgevoerd, waardoor de totale doorlooptijd eerder wordt verkort door het langzaamste proces dan door de som van alle processen.
De `TaskGroup` van Python asyncio.TaskGroupbiedt een gestructureerde manier om gerelateerde taken gelijktijdig uit te voeren. De huidige Python-documentatie vermeldt dat `TaskGroup` wacht op taken in de groep en de resterende taken annuleert wanneer er een taak mislukt met een uitzondering die geen annulering toelaat. Dit biedt een veiligere werking dan het ongestructureerd starten van taken. Zie de officiële Python `TaskGroup`-documentatie .
Parallelisatie is niet gratis. Als dezelfde provider een strikte limiet hanteert voor het aantal verzoeken per minuut of het aantal gelijktijdige verzoeken, kan het gelijktijdig uitvoeren van vier agents een trage maar succesvolle workflow veranderen in een snelle piek van 429 reacties. Paralleliseer alleen echt onafhankelijke taken en behoud de algemene limiet voor gelijktijdige verwerking.
Stap 7: Wanneer moet je stoppen met het gebruik van een synchrone HTTP-aanvraag?
Als normale workflows routinematig de kortste time-out voor verzoeken in uw netwerkpad overschrijden, is overstappen op een asynchroon taakmodel meestal een schonere oplossing dan elke time-out steeds opnieuw te verlengen. Het initiële HTTP-verzoek kan de invoer valideren, een duurzame taak aanmaken en direct een taak-ID retourneren. Vervolgens voeren de workers de multi-agentgrafiek uit buiten de levenscyclus van het verzoek, terwijl de client de voortgang ontvangt via polling, server-sent events, WebSockets of een webhook.
Streaming is nuttig wanneer de server al vroeg zinvolle output kan versturen. De OpenAI Python SDK ondersteunt bijvoorbeeld server-sent-event streaming voor Responses API-aanroepen. Streaming verbetert de waargenomen responsiviteit en kan een actieve verbinding data laten produceren, maar het lost niet automatisch het probleem van de maximale aanvraaglevensduur van elke proxy op. Zie de officiële OpenAI-referentie voor streaminggebeurtenissen .
Kies voor een asynchrone taak wanneer duurzaamheid belangrijker is dan onmiddellijke eenvoud: langdurige onderzoekstaken, agentworkflows met menselijke goedkeuring, veel toolaanroepen, kostbare bewerkingen die u niet wilt herhalen, of workloads die moeten blijven functioneren na een verbroken verbinding met de client. De kosten hiervan zijn extra statusbeheer: taakstatus, controlepunten, idempotentiesleutels, annulering, opslag van resultaten en eigendom van herhaalpogingen.
Stap 7: Bij lange workflows kunt u de voltooiing van de agent bijhouden als een permanente workflowstatus in plaats van te vertrouwen op één clientverbinding die open blijft totdat elke agent klaar is.
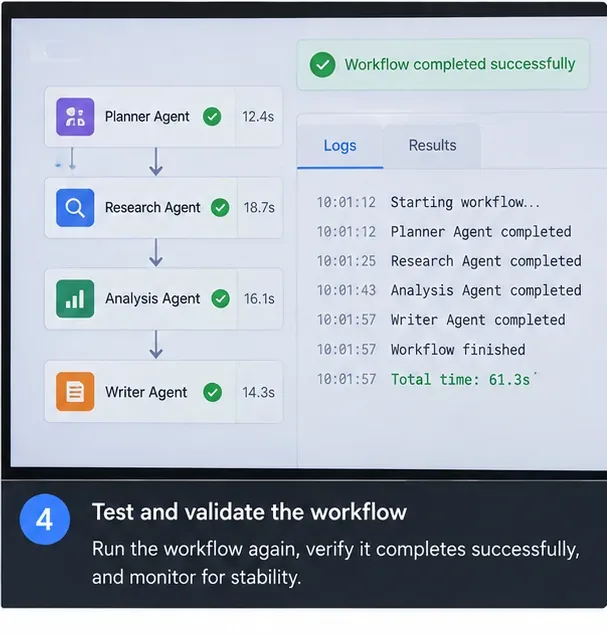
Stap 8: Valideer de oplossing onder realistische belasting
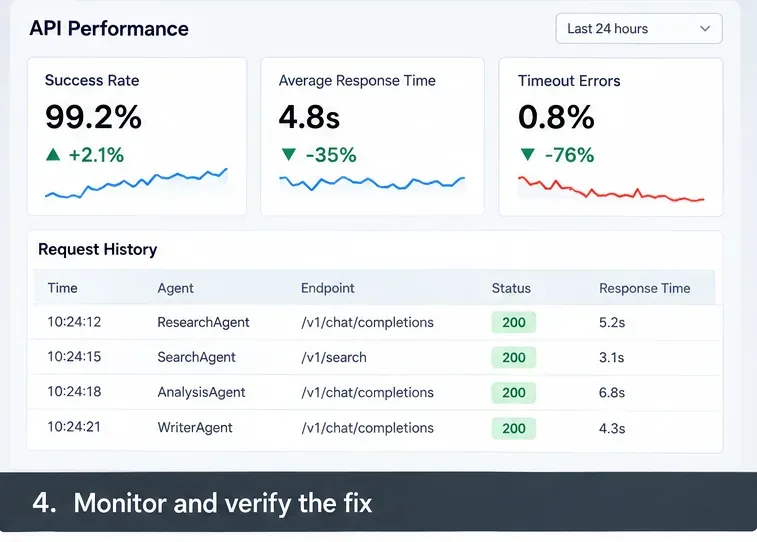
Een oplossing is niet bewezen omdat één verzoek slaagt. Test met de gelijktijdigheid die u in productie verwacht en meet het succespercentage, het time-outpercentage, het aantal herhaalpogingen per logische taak, de p95- en p99-latentie, de wachtrijvertraging, de wachttijd in de verbindingspool, de downstream 429/5xx-snelheden en de kosten per voltooide workflow.
Als je agents in Kubernetes gebruikt, gebruik je readiness en liveness voor verschillende doeleinden. Kubernetes beschrijft readiness probes als het mechanisme dat bepaalt of een Pod verkeer mag ontvangen, terwijl liveness probes bepalen wanneer een container opnieuw moet worden opgestart. De documentatie waarschuwt expliciet dat slecht geïmplementeerde liveness checks onder belasting tot een kettingreactie van fouten kunnen leiden. Zie de officiële Kubernetes-documentatie over probes .
Bij tijdelijke overbelasting is het vaak veiliger om "niet beschikbaar" te zijn dan herhaaldelijk gezonde, maar overbelaste werknemers uit te schakelen. Reserveer live-uitval voor situaties waarin het herstarten van het proces daadwerkelijk de juiste herstelactie is.
Stap 8: verifieer de wijziging met behulp van productieverkeer en tail-latency-statistieken, en niet alleen met één succesvolle testrun.
Hoe bepaal je welke oplossing geschikt is voor jouw specifieke foutpatroon?
Waargenomen patroon
De meest nuttige eerste verandering
Wat je vooral niet moet doen
Gesprekken worden net na de deadline van de klant beëindigd; de vervolgstroom is gezond.
Verhoog de specifieke interne time-out en herbereken de externe deadline.
Verhoog het aantal herhaalpogingen
Het aantal 429-fouten en pooltime-outs neemt toe bij gelijktijdige toegang.
Verlaag de gelijktijdigheid en voeg wachtrijen/tegendruk toe.
Start meerdere agents parallel.
Incidentele 408/5xx-fouten of netwerkstoringen.
Gebruik begrensde exponentiële-terugval-herhalingspogingen voor idempotente bewerkingen.
Probeer elke uitzondering oneindig opnieuw.
De workflow duurt doorgaans langer dan de toegangslimieten.
Gebruik een asynchrone taakarchitectuur of een ondersteund streamingontwerp.
Verhoog alleen de SDK-time-out.
Eén trage afhankelijkheid domineert de p99-latentie.
Optimaliseer, cache, vervang of isoleer die afhankelijkheid; overweeg een terugvaloptie.
Stel de time-outs van niet-gerelateerde agenten in.
Fouten treden pas op na het toevoegen van parallelle agenten.
Behoud nuttige parallelisatie, maar voeg een globale semaphore en per-provider limieten toe.
Ga ervan uit dat parallelle verwerking altijd sneller is.
Een praktische basislijn voor de productie
Voor een typische multi-agent API is een robuuste basisstructuur als volgt: elke workflow krijgt een correlatie-ID, elke aanroep van een agent en tool wordt getraceerd, er wordt één einddeadline gedefinieerd, daarbinnen worden kortere deadlines per aanroep ingesteld, er wordt een globale gelijktijdigheidslimiet per downstream provider afgedwongen, het aantal herhaalpogingen wordt beperkt en de implementatie is idempotent, en er wordt voldoende statusinformatie bewaard om de workflow te kunnen hervatten of een gedeeltelijke voltooiing te kunnen rapporteren.
Stem vervolgens af op basis van metingen. Als het systeem stabiel is maar te traag, paralleliseer dan selectief onafhankelijke taken. Als het snel is bij lage belasting maar faalt bij piekbelasting, verlaag dan de fan-out en verhoog de backpressure. Als succesvolle workflows van nature langer duren dan het synchrone aanvraagpad toelaat, schakel dan over naar een andere architectuur in plaats van te proberen elke proxy langer te laten wachten.