Home
» Domeinen
»
Hoe maak je aangepaste GPT's die hun kennisbestanden niet vergeten?
Hoe maak je aangepaste GPT's die hun kennisbestanden niet vergeten?
Huidige status, gecontroleerd op 13 september 2026: OpenAI meldt dat persoonlijke ChatGPT-accounts, inclusief Free, Go, Plus en Pro, geen nieuwe GPT's kunnen aanmaken of publiceren. Bestaande GPT's kunnen nog steeds worden gebruikt en, indien mogelijk, bewerkt. In Business-, Enterprise- en Edu-werkruimtes is het aanmaken afhankelijk van de werkruimte-instellingen en -machtigingen. OpenAI meldt ook dat aangepaste GPT-workflows worden overgezet naar plug-ins, met een migratieproces gepland voor 17 september 2026 en de uitfasering van de betreffende Enterprise GPT's gepland voor 11 december 2026. Als u dit later leest, controleer dan de meest recente status in de OpenAI- documentatie over het aanmaken en bewerken van GPT's voordat u een nieuwe workflow bouwt.
Een aangepaste GPT die een kennisbestand lijkt te "vergeten", is het bestand meestal niet kwijt. De FAQ over bestandsuploads van OpenAI stelt dat bestanden die als GPT-kennis worden geüpload, worden bewaard totdat de aangepaste GPT wordt verwijderd. Het meest voorkomende probleem is het ophalen van informatie: het model leest niet per se elk geüpload bestand volledig voor elke vraag. Het haalt materiaal op dat relevant lijkt voor de vraag, dus de kwaliteit van de bron, de bestandsstructuur, de instructies en de testresultaten zijn allemaal van invloed op de vraag of de juiste passage wordt gevonden.
Maak ook onderscheid tussen 'kennis' en 'geheugen'. De documentatie van OpenAI over GPT's in ChatGPT stelt dat GPT's geen gebruik maken van opgeslagen geheugen, persoonlijke aangepaste instructies of eerdere gesprekken; elk gesprek begint opnieuw. Geüploade kennis is daarom een geconfigureerde referentiebron, geen gespreksgeheugen dat zich opbouwt uit eerdere chats.
Hoe een betrouwbaar resultaat eruit zou moeten zien.
Het doel is niet om een GPT te dwingen bij elke beurt een bestand te noemen. Het doel is om bronafhankelijke antwoorden consistent te baseren op het juiste materiaal, terwijl vragen zonder onderbouwing veilig afwijzen in plaats van een zelfverzekerde gok te produceren.
Kwaliteitssignaal
Wat "goed" inhoudt
Wanneer moet je de instellingen wijzigen?
Juistheid
Het antwoord komt overeen met het gezaghebbende bestand voor de geteste vraag.
Als het antwoord ondanks de aanwezigheid van de informatie onjuist is, vereenvoudig dan de bron of beperk de vraagstelling.
Aarding
De GPT kan, indien gevraagd, de naam van het ondersteunende bestand of de sectie opgeven.
Als het antwoord gebaseerd is op algemene kennis, verscherp dan de instructies voor bronprioriteit en test opnieuw.
Onthouding
Als de bestanden het antwoord niet bevatten, geeft GPT dat duidelijk aan.
Als er een nieuw beleid, een nieuwe prijs, datum of procedure wordt bedacht, voeg dan een expliciete regel toe die gokken uitsluit.
Als kleine wijzigingen in de formulering tot grote afwijkingen leiden, verminder dan de onduidelijkheid in zowel de bestanden als de instructies.
Integriteit bijwerken
Na een herziening van de brontekst weerspiegelen dezelfde evaluatievragen de nieuwe inhoud.
Als de oude antwoorden blijven verschijnen, controleer dan of het bijgewerkte bestand is bijgevoegd, sla het GPT-bestand op en voer de tests opnieuw uit.
Acht stappen om het gebruik van kennisbestanden betrouwbaarder te maken
1. Controleer of uw account of werkruimte nog steeds GPT-kaarten kan aanmaken of bewerken.
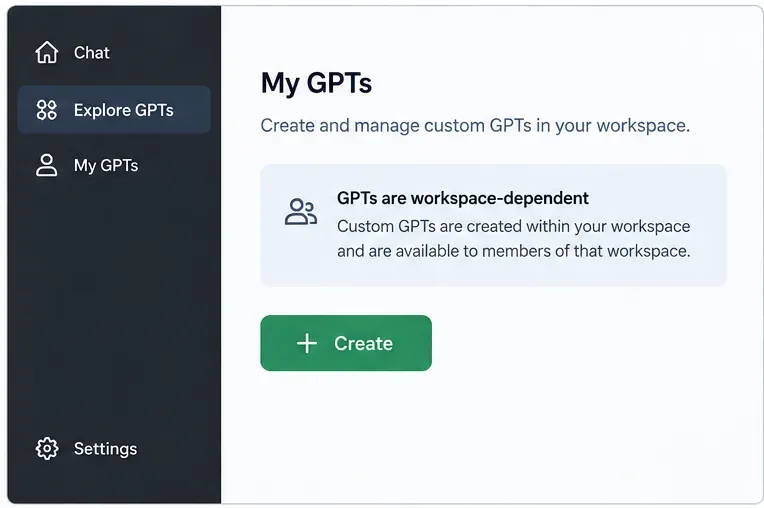
Begin met de geschiktheid, want een ontbrekende knop 'Aanmaken' kan nu eerder normaal gedrag zijn dan een browserprobleem. De huidige richtlijnen van OpenAI voor GPT's in ChatGPT geven aan dat het aanmaken van nieuwe GPT's niet beschikbaar is voor persoonlijke accounts. Beheerde werkruimtes kunnen het aanmaken van GPT's nog steeds mogelijk maken op basis van beheerdersbeleid en rolmachtigingen. Als u al een bestaande GPT bezit, controleer dan of bewerken nog steeds mogelijk is voor uw account.
In geschikte beheerde werkruimten kunt u beginnen in het GPT-gebied; de beschikbaarheid is afhankelijk van de machtigingen van de werkruimte.
Verspil geen tijd aan het oplossen van problemen met het ophalen van kennis totdat u zeker weet dat u in een ondersteunde editor werkt. Als uw organisatie al overstapt op plug-ins, beschouw de resterende aangepaste GPT dan als een migratiekandidaat in plaats van een nieuwe afhankelijkheid voor de lange termijn.
2. Scheid gedragsinstructies van kennis.
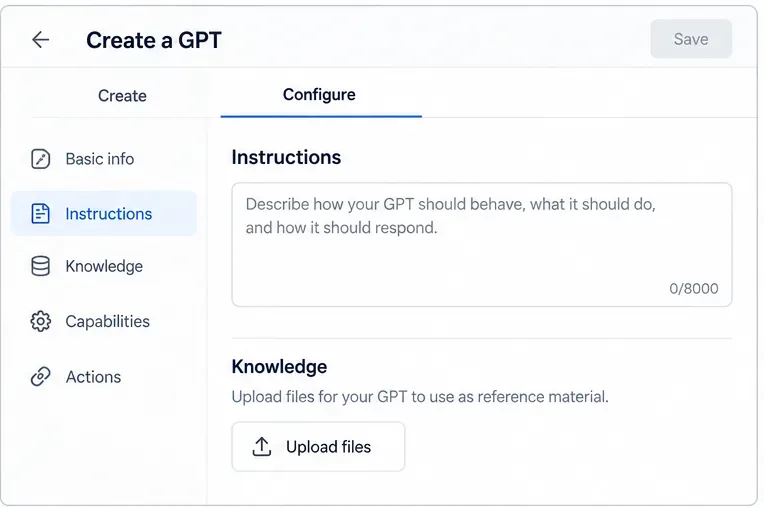
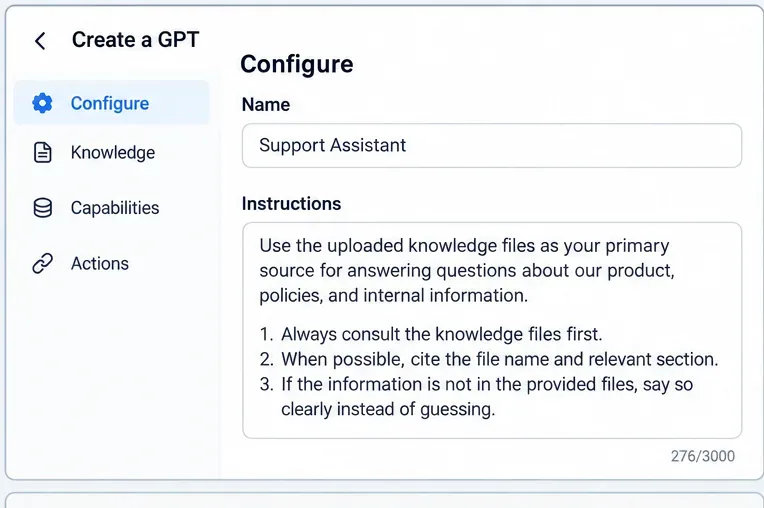
Gebruik het veld Instructies voor regels zoals toon, beslissingsvolgorde, citatieformaat, escalatiegedrag en wat de GPT moet doen als een bron niets zegt. Gebruik Kennis voor referentiemateriaal: handleidingen, productdocumentatie, beleid, veelgestelde vragen, specificaties of interne richtlijnen. OpenAI raadt deze scheiding expliciet aan, omdat kennis het beste werkt als bronmateriaal, terwijl instructies het gedrag definiëren.
Bewaar gedragsregels in de instructies en naslagmateriaal in de kennissectie.
Dit onderscheid is belangrijk voor de betrouwbaarheid. Een zin als "Vermeld nooit een verlopen prijs" hoort in de instructies. De eigenlijke prijstabel hoort in de kennis. Het mengen van regels in een grote referentie-pdf maakt het gedrag moeilijker te controleren en te testen.
3. Bereid bestanden voor op ophalen, niet alleen op lezen door mensen.
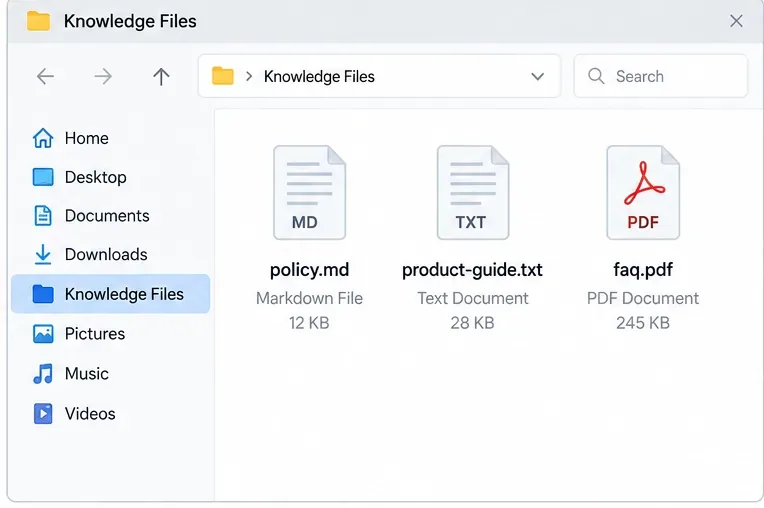
Geef de voorkeur aan duidelijke, tekstgerichte bestanden met beschrijvende koppen, korte secties, consistente terminologie en ondubbelzinnige versiedatums. Een prachtig vormgegeven brochure kan minder informatie opleveren dan een eenvoudig Markdown- of tekstbestand als de cruciale feiten verspreid zijn over kolommen, tekstballonnen, schermafbeeldingen of decoratieve lay-outs.
Tekstbestanden met duidelijke namen en een eenvoudige structuur zijn betrouwbaarder terug te vinden.
Dit is vooral belangrijk voor PDF's. In de FAQ van OpenAI over visuele zoekopdrachten met PDF's staat dat PDF's die als GPT Knowledge zijn geüpload, worden verwerkt met alleen tekstuele zoekopdrachten. Met andere woorden, een grafiek, diagram of schermafbeelding in de PDF mag niet de enige plek zijn waar een cruciale regel voorkomt. Voeg een tekstuele uitleg of een begeleidend tekstbestand toe.
Verwijder ook verouderde duplicaten. Als in het ene bestand staat dat de retourtermijn 14 dagen is en in een ander 30 dagen, kan het opvragen van gegevens beide passages aan het licht brengen. Bestandsnamen zoals returns-policy-2026-09.md en een zichtbare "ingangsdatum" maken versiebeheer eenvoudiger te controleren.
4. Upload een kleine, samenhangende kennisset en verifieer deze.
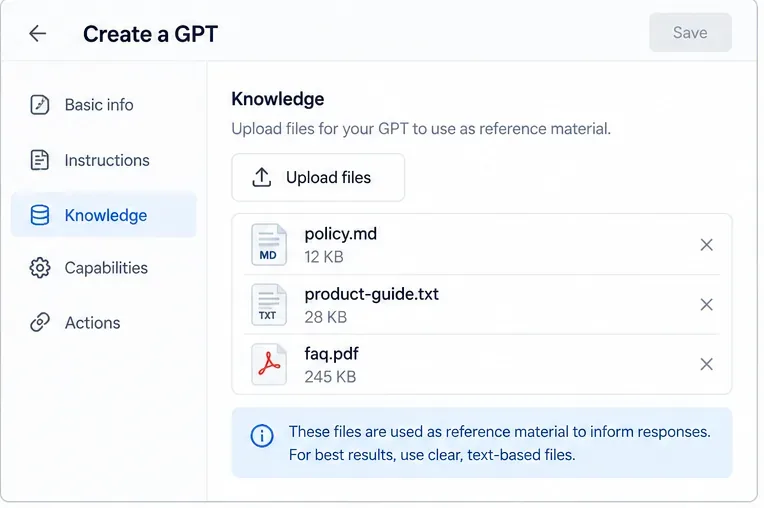
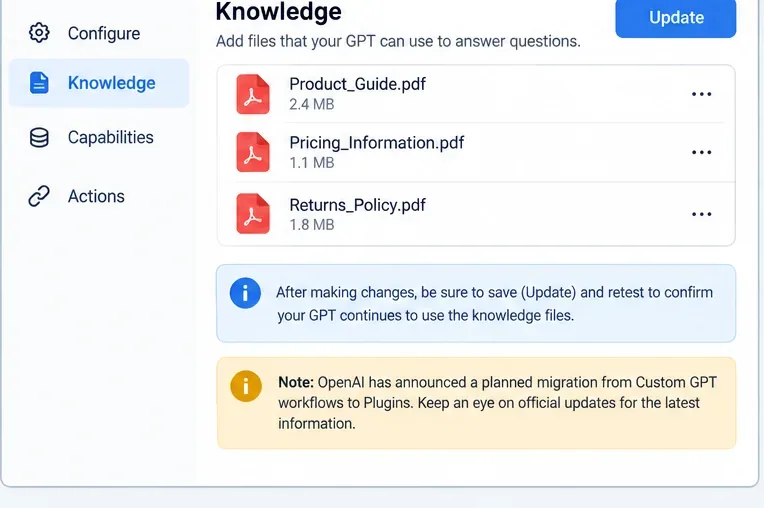
Upload alleen de bestanden die de GPT daadwerkelijk nodig heeft. De richtlijnen van OpenAI voor bedrijfsbestanden geven aan dat minder, maar meer gerichte documenten over het algemeen de nauwkeurigheid van bestandsgebaseerde zoekopdrachten verbeteren. Controleer na het uploaden of elk verwacht bestand in de kennislijst voorkomt voordat u verdergaat.
Upload de referentieset en controleer vervolgens of alle verwachte bestanden aanwezig zijn voordat u gaat testen.
Er is momenteel een inconsistentie in de documentatie met betrekking tot het aantal bestanden. De handleiding van de GPT-editor geeft aan dat u maximaal 20 bestanden aan een GPT kunt koppelen, terwijl de FAQ over bestandsuploads spreekt over maximaal 10 bestanden per GPT gedurende de gehele levensduur van die GPT. Beide documenten vermelden een harde limiet van 512 MB per bestand, en de FAQ over bestandsuploads vermeldt een limiet van 2 miljoen tokens voor tekst- en documentbestanden. Omdat de officiële pagina's het niet eens zijn over het aantal bestanden, is het raadzaam geen kritieke workflow te ontwerpen op basis van het hogere aantal zonder eerst de actuele editor en documentatie voor uw account te raadplegen.
5. Voeg op retrieval gerichte instructies toe
Vertrouw niet op een vage instructie zoals "Gebruik de geüploade bestanden". Geef aan wat er moet gebeuren wanneer een vraag betrekking heeft op een kennisdomein. Een praktische aanpak is: raadpleeg eerst de geüploade kennis; geef de voorkeur aan de geüploade kennis boven algemene modelkennis voor bedrijfsspecifieke feiten; identificeer het ondersteunende bestand of de ondersteunende sectie indien mogelijk; en geef aan dat de informatie niet beschikbaar is wanneer de bestanden geen antwoord ondersteunen.
Op zoekgerichte instructies moeten de prioriteit van bronnen, het citatiegedrag en een niet-gisbaar alternatief definiëren.
De probleemoplossingsrichtlijnen van OpenAI bevelen specifiekere prompts aan die directer verwijzen naar bijgevoegde documenten wanneer kennis niet goed wordt gebruikt. Ook wordt aanbevolen om regels en workflowgedrag in instructies op te nemen in plaats van ze te verbergen in geüploade bestanden. Zie Probleemoplossing GPT's .
Vermijd tegenstrijdige instructies. "Beantwoord de gebruiker altijd" is in tegenspraak met "Beantwoord nooit tenzij het bestand dit ondersteunt." Vervang dit conflict door een expliciete terugvaloptie, zoals: "Als de kennisbestanden het vereiste feit niet bevatten, geef dan aan dat de aangeleverde bronnen het antwoord niet onderbouwen en stel de goedgekeurde volgende stap voor."
6. Voer positieve aardingstests uit in de voorbeeldweergave.
Test vragen waarvan de juiste antwoorden zeker in de bestanden te vinden zijn. Test niet alleen de eenvoudigste zin van de eerste pagina. Voeg vragen toe die vereisen dat men verschillende secties raadpleegt, alternatieve formuleringen herkent en vergelijkbare beleidsregels van elkaar onderscheidt.
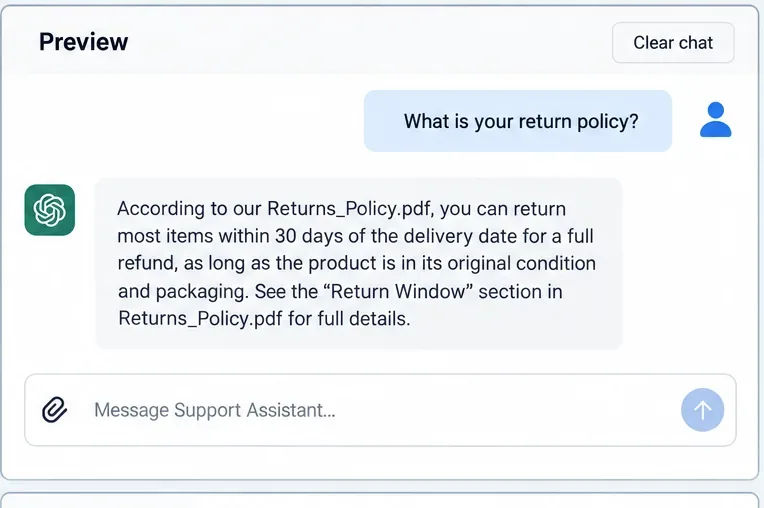
Een positieve uitslag van de test geeft het juiste antwoord en identificeert het ondersteunende bestand of de bijbehorende sectie.
Noteer voor elke test het verwachte antwoord, het verwachte bronbestand en of de GPT de bron heeft vermeld of geïdentificeerd toen hierom werd gevraagd. De aangepaste GPT-richtlijnen van OpenAI Academy raden aan een evaluatieset samen te stellen van ongeveer 10 tot 15 representatieve vragen met correcte antwoorden. Dit is voldoende om terugkerende foutpatronen aan het licht te brengen zonder van elke bewerking een groot testproject te maken.
Beoordeel het antwoord op basis van de onderbouwing, niet alleen op de vloeiende klank. Een gepolijst antwoord met een onjuiste beleidsverwijzing is een mislukking. Een korter antwoord dat correct verwijst naar het relevante document levert doorgaans een beter resultaat op.
7. Voer negatieve tests en herformuleer tests uit.
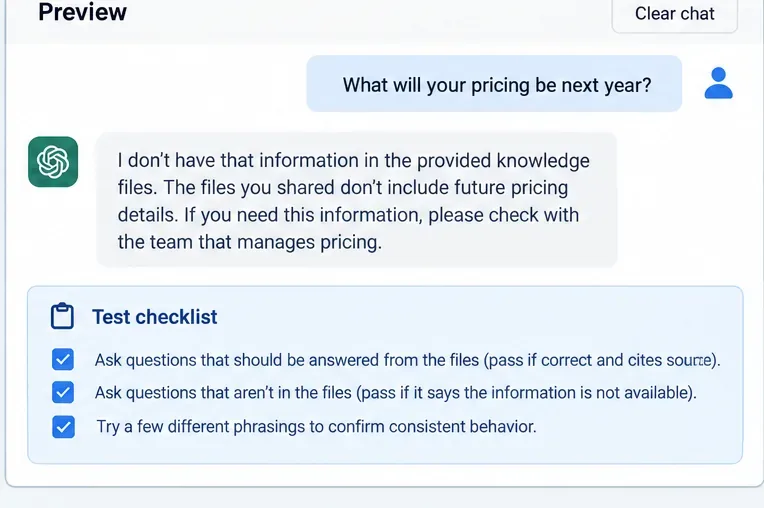
Een betrouwbare kennisassistent moet weten wat hij niet weet. Stel vragen die opzettelijk niet in de bestanden voorkomen: een toekomstige prijs, een nog niet uitgebrachte functie, een beleid voor een land dat niet in het handboek wordt behandeld, of een datum die buiten het toepassingsgebied van het document valt. Het gewenste resultaat is een duidelijke beperking, geen plausibele verzinsel.
Negatieve tests zijn belangrijk: de GPT moet toegeven wanneer een antwoord niet in de bestanden staat en consistent blijven bij verschillende herformuleringen.
Herformuleer vervolgens een paar positieve en negatieve vragen op verschillende manieren. Als "Wat is de retourtermijn?" wel werkt, maar "Hoe lang heb ik de tijd om het terug te sturen?" niet, ligt het probleem mogelijk bij de retrieval-dekking in plaats van een gebrek aan kennis. Verbeter de titels, terminologie of instructies voordat u meer bestanden toevoegt.
8. Versie-updates, hertesten en weten wanneer statische kennis niet het juiste instrument is.
Wanneer u een bron wijzigt, verwijdert u de verouderde versie, voegt u de huidige versie toe, slaat u de GPT op of werkt u deze bij en voert u dezelfde evaluatieset opnieuw uit. Het bijhouden van een klein wijzigingslogboek buiten de GPT kan u helpen vast te stellen of een regressie is veroorzaakt door nieuwe instructies, een vervangen bron of een platformwijziging.
Nadat u bronbestanden of instructies hebt gewijzigd, slaat u de update op en voert u dezelfde evaluatiereeks opnieuw uit.
Statische kennis kent beperkingen. Als de bron constant verandert, de toegang moet gebaseerd zijn op gebruikersrechten, of de assistent heeft live operationele gegevens nodig, dan is het herhaaldelijk uploaden van bestanden een risicovolle oplossing. De apps van OpenAI met synchronisatiedocumentatie beschrijven geïndexeerde, verbonden bronnen die up-to-date blijven met respect voor de bronrechten. OpenAI stuurt aangepaste GPT-workflows ook richting plug-ins, waardoor een kennisbank die regelmatig verandert een sterke kandidaat is voor een verbonden of gemigreerde architectuur in plaats van een groeiende stapel statische bestanden.
Hoe diagnosticeer je een GPT-bestand dat nog steeds "vergeet"?
Als een bekend feit over het hoofd wordt gezien, controleer dan eerst of het feit daadwerkelijk aanwezig is in een bijgevoegd, actueel bestand. Stel vervolgens een specifiekere vraag die het document of onderwerp benoemt. Als de specifieke vraag werkt, verbeter dan de zoekaanwijzingen door koppen te vereenvoudigen, een te breed document op te splitsen of concurrerende versies te verwijderen. Als de specifieke vraag nog steeds niet werkt, zet dan de cruciale informatie om in een overzichtelijkere tekst en test het opnieuw.
Los niet meteen elke fout op door meer instructies toe te voegen. Overmatige of tegenstrijdige regels kunnen het gedrag minder voorspelbaar maken. Voeg evenmin meer bestanden toe voordat u zeker weet dat de bestaande set in orde is. Het kwaliteitssignaal waarnaar u op zoek bent, is herhaalbaarheid: dezelfde kleine evaluatiesuite moet na elke wijziging slagen, vooral bij risicovolle beleids-, juridische, prijs- of operationele vraagstukken.
De praktische beperking: je kunt de zoekresultaten verbeteren, maar niet garanderen.
Geen enkele prompt kan een generatief model ertoe dwingen om bij elk antwoord met absolute zekerheid elk kennisbestand te raadplegen. Een betrouwbare aangepaste GPT is daarom een ontworpen workflow, geen eenmalige upload: gerichte bronbestanden, expliciete instructies voor bronprioriteit, een gedefinieerd onthoudingsgedrag en herhaalbare evaluatie. Als deze controles nog steeds niet voldoen aan de nauwkeurigheid of actualiteit die u nodig hebt, wijzig dan de architectuur in plaats van dezelfde statische configuratie te blijven optimaliseren.
Voor geschikte GPT's kan dat proces het probleem "mijn bestand is vergeten" aanzienlijk verminderen. Voor nieuw werk dat eind 2026 van start gaat, moet bij de beslissing op de lange termijn echter ook rekening worden gehouden met de aangekondigde overgang van OpenAI van aangepaste GPT-workflows naar plug-ins en de beschikbaarheid van gekoppelde kennisbronnen.