Home
» Domeinen
»
Hoe meet je de kwaliteit van LLM-reacties met behulp van evaluatiekaders?
Hoe meet je de kwaliteit van LLM-reacties met behulp van evaluatiekaders?
De meest betrouwbare manier om de kwaliteit van LLM-responsen te meten, is door evaluatie te beschouwen als een herhaalbaar testsysteem, niet als een enkele score. Definieer wat "goed" betekent voor uw toepassing, stel een representatieve evaluatiedataset samen, combineer deterministische controles met modelgebaseerde en menselijke beoordelingen, vergelijk elke kandidaatwijziging met een basislijn en inspecteer fouten per categorie voordat u de implementatie uitvoert.
Dit is belangrijk omdat een LLM een antwoord kan produceren dat er gepolijst uitziet, maar toch onjuist, niet onderbouwd, onvolledig, onveilig of inconsistent met uw instructies kan zijn. Een bruikbaar evaluatiekader zet deze vage zorgen om in expliciete criteria die opnieuw kunnen worden uitgevoerd na een promptwijziging, modelupgrade, wijziging in de ophaalmethode, toolupdate of herziening van het veiligheidsbeleid.
Opmerking bij de documentatie: de hieronder beschreven frameworkfunctionaliteiten zijn gecontroleerd aan de hand van de officiële documentatie die beschikbaar was op 13 september 2026. Deze tools ontwikkelen zich snel, dus controleer de actuele API's voordat u frameworkspecifieke code in productie neemt.
Wat moet je als eerste meten?
Begin met de fout die voor uw gebruikers het belangrijkst is. Voor een feitelijke ondersteuningsbot zijn correctheid en naleving van het beleid wellicht doorslaggevend. Voor retrieval-augmented generation (RAG) zijn de gegrondheid en de kwaliteit van de retrieval belangrijk, omdat een vloeiend antwoord nog steeds feiten kan verzinnen die niet worden ondersteund door de opgehaalde context. Voor een agent is de kwaliteit van het uiteindelijke antwoord niet voldoende; u moet mogelijk ook de toolselectie, toolargumenten, taakvoltooiing en onnodige stappen beoordelen.
Kwaliteitsdimensie
Wat het vraagt
Goed type beoordelaar
Juistheid
Is het antwoord feitelijk of logisch juist?
Referentievergelijking, codecontrole, LLM-beoordeling of menselijke beoordeling
Instructies volgen
Voldeed het model aan de vereiste beperkingen?
Coderegels plus beoordelingscriteria
Gegrondheid
Worden de beweringen ondersteund door de gegeven context?
RAG-specifieke controles op rechter- of claimniveau
Relevantie
Beantwoordt het antwoord de eigenlijke vraag zonder af te dwalen?
LLM-jury of menselijke beoordeling
Formaatconformiteit
Is de uitvoer geldige JSON, voldoet deze aan het schema of is deze op een andere manier door machines te gebruiken?
Deterministische code
Veiligheid en beleid
Is het antwoord in strijd met de regels van uw applicatie?
Beleidscontroles, LLM-jury en gerichte menselijke beoordeling
Efficiëntie
Welke latentie, tokengebruik en kosten waren er verbonden aan het antwoord?
Telemetrie en tracering
Middel deze niet te snel tot één getal. Een kandidaatmodel dat twee punten scoort op stijl, maar zelfs een klein aantal ernstige beleidsfouten bevat, kan een slechtere release zijn. Houd kritieke dimensies zichtbaar als afzonderlijke poorten.
Een evaluatieworkflow in vier fasen die werkt binnen verschillende frameworks.
1. Stel een representatieve evaluatiedataset samen.
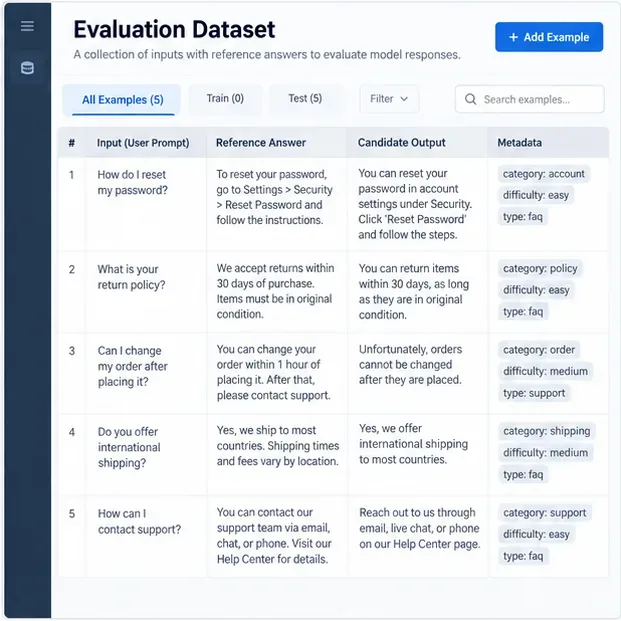
Uw dataset moet realistische invoergegevens en, waar mogelijk, verwacht gedrag bevatten. Sommige rijen kunnen exacte referentieantwoorden bevatten; voor andere is wellicht een beoordelingsschema nodig in plaats van één enkele "gouden" zin. Voeg metadata toe zoals taaktype, klantsegment, taal, moeilijkheidsgraad, ophaalconditie of veiligheidscategorie, zodat u de resultaten later kunt filteren.
Neem bijvoorbeeld een klantenservicemedewerker. Een nuttige evaluatieset zou niet alleen eenvoudige FAQ-vragen bevatten. Deze zou ook ambigue verzoeken, uitzonderingen op het beleid, gevallen met ontbrekende context, tegenstrijdige prompts, vervolgvragen die meerdere beurten vereisen en voorbeelden waarbij het juiste gedrag is om te zeggen dat het antwoord niet kan worden vastgesteld, moeten omvatten.
De huidige evaluatierichtlijnen van LangSmith bevelen aan om te beginnen met handmatig samengestelde voorbeelden die laten zien hoe goed gedrag eruitziet, en vervolgens de dataset uit te breiden met historische traceringen en fouten die in de productieomgeving zijn ontdekt. Het evaluatiesysteem ondersteunt datasets met invoer, optionele referentie-uitvoer en metadata. Zie de documentatie over evaluatieconcepten van LangSmith .
Een evaluatiedataset moet realistische prompts koppelen aan referenties of verwacht gedrag en metadata bewaren voor latere foutenanalyse.
Wanneer is deze aanpak geschikt? Bijna altijd. Zelfs als je live productie-evaluatie gebruikt, heb je nog steeds een stabiele offline dataset nodig voor regressietesten. Als je geen referentieantwoord hebt voor open vragen, sla dan in plaats daarvan een beoordelingsschema, vereiste feiten, verboden gedragingen of voorkeuren per paar op.
2. Koppel elke kwaliteitsdimensie aan de juiste beoordelaar.
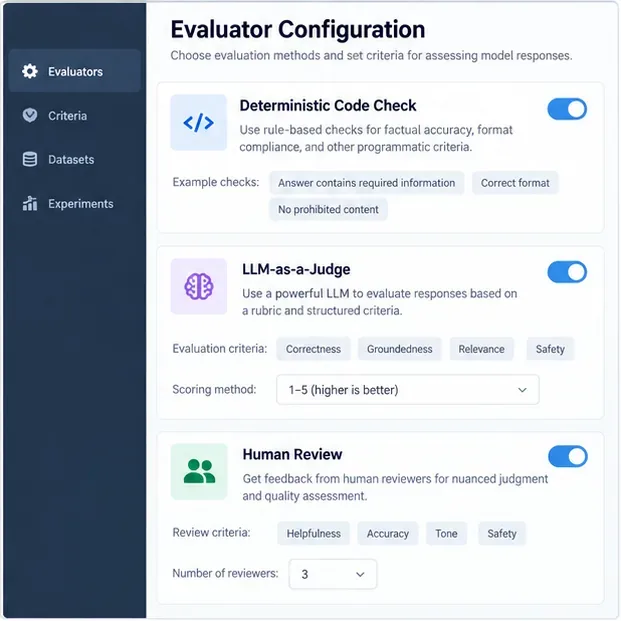
De beste evaluatiesuites combineren verschillende soorten beoordelaars, omdat geen enkele beoordelaar ideaal is voor elke vraag.
Deterministische controles zijn het meest geschikt wanneer de vereiste ondubbelzinnig is: geldige JSON, exacte labels, vereiste sleutels, numerieke tolerantie, reguliere expressieregels of de vraag of een toolaanroep goedgekeurde argumenten heeft gebruikt.
Referentiegebaseerde meetmethoden kunnen nuttig zijn wanneer er een bekend antwoord bestaat, maar tekenreeksgelijkenis alleen is vaak te beperkt voor geldige parafrases en te tolerant voor semantisch onjuiste tekst die dezelfde woordenschat gebruikt.
LLM-as-a-judge is nuttig voor criteria zoals volledigheid, relevantie, toon, getrouwheid aan het origineel, of de vraag of een open antwoord voldoet aan een beoordelingsschema.
Paarwise evaluatie is nuttig wanneer het gemakkelijker is om te bepalen of kandidaat A of basislijn B beter is dan om een zinvolle absolute score toe te kennen.
Menselijke beoordeling blijft belangrijk voor het kalibreren van geautomatiseerde beoordelingssystemen, het oplossen van subjectieve of zeer belangrijke gevallen en het controleren of de meetmethode zelf de waarde voor de gebruiker weerspiegelt.
De huidige Evals API van OpenAI definieert een evaluatie als testcriteria plus een schema voor de gegevensbron en ondersteunt herbruikbare beoordelaars. De beoordelaars-API omvat deterministische tekenreekscontroles, beoordelaars op basis van tekstgelijkenis en modelgebaseerde beoordelaars; zie de OpenAI Evals API-referentie en de OpenAI beoordelaarsreferentie . De Vertex AI Gen AI-evaluatieservice van Google Cloud ondersteunt puntsgewijze en paarsgewijze modelgebaseerde metrieken, evenals op berekeningen gebaseerde metrieken; de resultaten kunnen scores per instantie, uitleg, geaggregeerde gemiddelden, standaarddeviaties en paarsgewijze winstpercentages bevatten. Zie de documentatie over de evaluatieresultaten van Vertex AI .
Gebruik waar mogelijk deterministische regels, voeg op rubrieken gebaseerde LLM-beoordelaars toe voor semantische kwaliteit en houd menselijke beoordeling beschikbaar voor kalibratie en genuanceerde gevallen.
Wanneer deze aanpak geschikt is: gebruik deterministische controles voor machinaal verifieerbare vereisten, LLM-rechters voor semantische kwaliteiten en mensen wanneer meningsverschillen belangrijke zakelijke of veiligheidsgevolgen hebben. Voor een RAG-systeem biedt Ragas statistieken zoals contextprecisie, contextrecall, responsrelevantie en betrouwbaarheid, plus statistieken over agent-/toolgebruik, waaronder nauwkeurigheid van toolaanroepen en nauwkeurigheid van agentdoelen. Zie de documentatie over Ragas-statistieken . DeepEval biedt eveneens taakspecifieke statistieken en aangepaste LLM-rechterevaluatie, inclusief G-Eval-achtige scores; zie de documentatie over DeepEval-statistieken .
3. Voer dezelfde dataset uit op een basislijn en een kandidaat.
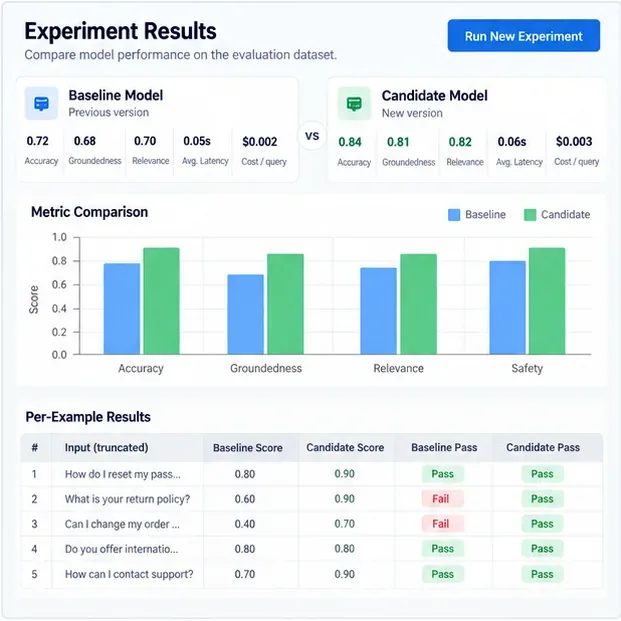
Absolute scores zijn nuttig, maar beslissingen over releases zijn meestal duidelijker wanneer de nieuwe configuratie wordt getest tegen de versie die je al vertrouwt. Houd de dataset, de definities van de evaluator, de modelparameters en de steekproefinstellingen zo stabiel mogelijk. Vergelijk vervolgens dezelfde voorbeelden naast elkaar.
Houd ten minste drie niveaus van resultaten bij:
Scores per voorbeeld: Welke specifieke prompts zijn verbeterd of verslechterd?
Resultaten per segment: Veranderde de prestatie bij vragen met een lange context, een bepaalde taal, moeilijke gevallen, een productcategorie of tegenstrijdige invoer?
Geaggregeerde resultaten: Wat is er gebeurd met het slagingspercentage, de gemiddelde score, de latentie, het tokengebruik, de kosten en het aantal ernstige fouten?
Voor niet-deterministische systemen is het belangrijk om belangrijke tests voldoende vaak te herhalen om de variabiliteit te begrijpen, in plaats van aan te nemen dat één enkele test de volledige weergave van het model vertegenwoordigt. Als de beslissing over de vrijgave van essentieel belang is, gebruik dan gepaarde vergelijkingen op dezelfde voorbeelden en rapporteer de onzekerheid in plaats van alleen te vertrouwen op een kleine verandering in het gemiddelde.
LangSmith ondersteunt offline experimenten voor het vergelijken van versies en paarsgewijze evaluaties, terwijl de huidige GenAI-evaluatiestack van MLflow evaluatiedatasets, ingebouwde en aangepaste scorers, LLM-beoordelaars, menselijke feedback, tracering en productiemonitoring ondersteunt. Zie LangSmith-evaluatie en MLflow LLM- en agentevaluatie .
Vergelijk een kandidaat met de huidige basislijn aan de hand van dezelfde voorbeelden en analyseer vervolgens zowel de geaggregeerde statistieken als de resultaten per voorbeeld (geslaagd of niet geslaagd).
Wanneer is deze aanpak geschikt? Telkens wanneer u een model, systeemprompt, ophaalpipeline, toolimplementatie of decoderingsinstellingen wijzigt. Een kandidaat mag niet zomaar worden gepromoveerd omdat één algemene meetwaarde stijgt; deze moet voldoen aan de releasedrempels op kritieke dimensies en onaanvaardbare regressies op segmentniveau vermijden.
4. Inspecteer fouten, kalibreer de beoordelaar en zet regressies om in nieuwe tests.
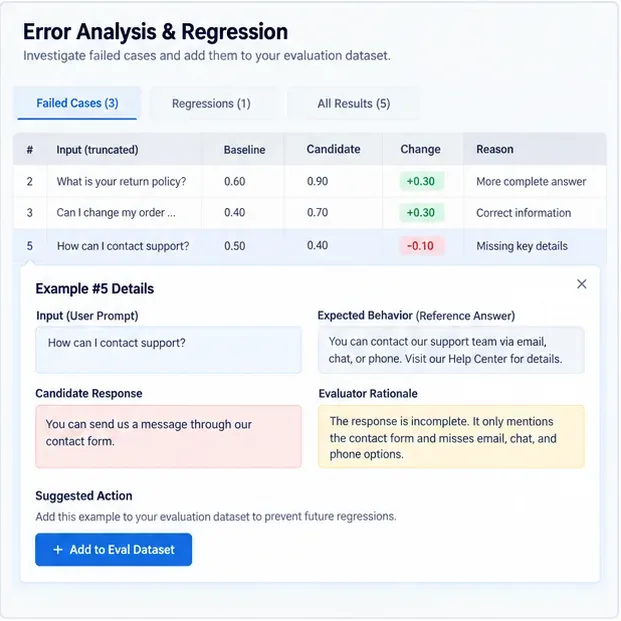
Een evaluatierun is alleen waardevol als deze je vervolgstappen beïnvloedt. Sorteer fouten op ernst en onderliggende oorzaak. Een lage score voor de mate van onderbouwing kan het gevolg zijn van zwakke informatie-uitwisseling, een prompt die aanzet tot gissen, een beoordelingsschema dat te vaag is of een onjuist referentieantwoord. Lees de onderliggende voorbeelden voordat je het model aanpast.
Vervolgens worden belangrijke fouten gepromoveerd tot permanente regressiegevallen. Dit creëert een vicieuze cirkel: de productieomgeving ontdekt een fout, een mens bevestigt deze, het geval wordt toegevoegd aan de offline dataset, de oplossing wordt getest met de volledige testsuite en toekomstige releases worden geblokkeerd om hetzelfde probleem niet opnieuw te introduceren.
Ook juryleden voor LLM-examens moeten worden geëvalueerd. De documentatie van Google beschrijft expliciet hoe modelgebaseerde meetresultaten worden vergeleken met menselijke beoordelingen om te bepalen of het jurylid geschikt is voor een specifieke toepassing. Het GDPval-project van OpenAI gebruikt eveneens paarsgewijze beoordeling door experts als primaire standaard en beschrijft geautomatiseerde beoordeling als een benadering in plaats van een vervanging voor deskundig oordeel. Zie de richtlijnen van Vertex AI voor het evalueren van een jurymodel en de GDPval-methodologie van OpenAI .
Bekijk de daadwerkelijk mislukte voorbeelden, bevestig dat de beoordelaar correct oordeelt en voeg belangrijke regressies toe aan de permanente testset.
Wanneer deze aanpak geschikt is: altijd bij fouten met grote impact en wanneer een LLM-beoordelaar invloed heeft op een vrijgavecriterium. Als menselijke beoordelaars het herhaaldelijk oneens zijn met de beoordelaar, pas dan de beoordelingscriteria aan, geef duidelijkere referenties, verander het beoordelingsmodel of verplaats het betreffende criterium terug naar menselijke beoordeling.
Hoe betrouwbaar is LLM als rechter?
LLM-beoordelaars zijn machtig omdat ze open-ended output kunnen evalueren op een schaal die door louter menselijke beoordeling niet geëvenaard kan worden. Het oorspronkelijke G-Eval-onderzoek rapporteerde een aanzienlijk betere correlatie met menselijke beoordeling dan traditionele automatische meetmethoden in de samenvattingscontext die het onderzocht. Dezelfde publicatie waarschuwde echter dat LLM-beoordelaars de voorkeur kunnen geven aan door LLM gegenereerde tekst. Zie de oorspronkelijke G-Eval-publicatie .
Afzonderlijk onderzoek op MT-Bench en Chatbot Arena toonde aan dat sterke LLM-beoordelaars goed aansluiten bij menselijke voorkeuren, terwijl ze tegelijkertijd positie-, woordgebruik-, zelfverheerlijkings- en redeneringsgerelateerde vooroordelen documenteren. Zie het oorspronkelijke onderzoek naar LLM als beoordelaar .
De praktische conclusie is niet "gebruik nooit LLM-beoordelaars". Maar wel: kalibreer ze. Stel een steekproef samen met menselijke beoordelaars, meet de overeenstemming, analyseer de categorieën van meningsverschillen, randomiseer of verwissel de volgorde van antwoorden in paarsgewijze tests wanneer positie-effecten aannemelijk zijn, en voorkom dat dezelfde vage beoordelaarsvraag stilzwijgend elke vrijgavebeslissing bepaalt.
Welk evaluatiekader moet je kiezen?
Kader
Beste pasvorm
Opmerkelijke kracht
OpenAI-evaluatoren en -graders
Teams die al gebruikmaken van OpenAI API's en API-native evaluatieruns willen uitvoeren
Herbruikbare evaluatiedefinities met deterministische en modelgebaseerde beoordelaars
LangSmith
LLM-toepassingen die tracering, datasets, offline regressietests en online evaluatie vereisen.
Sterke vergelijking van experimenten en feedbackloop in de productie
Ragas
RAG-pipelines en evaluatie van agent-/toolgebruik
Speciaal ontwikkelde zoek-, betrouwbaarheids-, relevantie- en toolstatistieken
DeepEval
Python-georiënteerde teams die testachtige evaluaties en aanpasbare LLM-beoordelaars willen.
Uitgebreide meetcatalogus, component-/end-to-end-evaluatie en agenttrajectmetrieken
MLflow GenAI-evaluatie
Teams die MLflow al gebruiken of evaluaties willen koppelen aan tracering en levenscyclusbeheer.
Datasets, scorers, menselijke feedback, experimenttracking en productiemonitoring
Vertex AI Gen AI-evaluatie
Google Cloud-implementaties
Evaluatieworkflows op basis van puntsgewijze, paarsgewijze, modelgebaseerde en computationele methoden.
De keuze van het framework is minder belangrijk dan het ontwerp van de evaluatie. Je kunt een zwakke evaluatiesuite bouwen in een geavanceerd platform of een sterke met een paar scripts. Geef de voorkeur aan de tool die ervoor zorgt dat je tests reproduceerbaar, versiebeheerbaar, gemakkelijk te inspecteren en eenvoudig uit te voeren zijn vóór elke belangrijke wijziging.
Een praktische scorekaart voor releases
Voor een productiemedewerker kan een nuttige releasebeslissing worden uitgedrukt als een reeks criteria in plaats van één gecombineerde score. Bijvoorbeeld: eis nul kritieke veiligheidsfouten in de samengestelde veiligheidsset, geen statistisch significante achteruitgang in taakcorrectheid, een minimaal slagingspercentage voor RAG-vragen, geldige gestructureerde output voor elk schemageval en latentie of kosten binnen het operationele budget. De exacte drempelwaarden moeten worden afgeleid van uw risicotolerantie en gebruikersvereisten; er is geen universeel percentage dat een LLM "goed genoeg" maakt.
Bewaar ook de ruwe voorbeelden achter de score. Als een release bijvoorbeeld van 0,84 naar 0,86 gaat, moet je nog steeds weten welke twee gevallen zijn veranderd en of die veranderingen relevant zijn. In de praktijk leren teams meer van een klein aantal duidelijk gecategoriseerde fouten dan van een indrukwekkend gemiddelde op het dashboard zonder traceerbaarheid.
Veelvoorkomende beoordelingsfouten
Test alleen de succesvolle scenario's: voeg ambiguïteit, randgevallen, prompt-injectiepogingen, ontbrekende context en bekende historische fouten toe.
Gebruik exacte overeenkomst voor open antwoorden: reserveer exacte overeenkomst voor resultaten waarbij nauwkeurigheid echt vereist is.
Vertrouwen op een LLM-jurylid zonder kalibratie: vergelijk de beoordeling met menselijke beoordelingen en analyseer eventuele meningsverschillen.
Het gemiddelde optimaliseren en tegelijkertijd ernstige fouten verbergen: veiligheid, beleid en andere kritieke dimensies expliciet als toegangspoorten hanteren.
Het wijzigen van de dataset tijdens een modelvergelijking: bevries de vergelijkingsset of versieer deze zodat de resultaten interpreteerbaar blijven.
Productieafwijkingen negeren: offline evaluaties beschermen releases; online evaluatie en steekproefsgewijze menselijke beoordeling onthullen nieuw gebruikersgedrag en nieuwe faalmodi.
Kortom
Het meten van de responskwaliteit van LLM-systemen is een technische discipline, geen oppervlakkige test. Begin met een representatieve dataset, definieer taakspecifieke kwaliteitsdimensies, kies voor deterministische controles waar de vereiste kan worden berekend, gebruik LLM-beoordelaars waar semantisch oordeel nodig is, kalibreer die beoordelaars met mensen en vergelijk kandidaatwijzigingen met een stabiele basislijn. Maak vervolgens van elke belangrijke mislukking in de praktijk een toekomstige regressietest.
Als je die cyclus volgt, wordt het evaluatiekader meer dan een rapportagedashboard: het wordt het kwaliteitscontrolesysteem dat je vertelt of een prompt, model, retrieval-wijziging of agentupdate het product daadwerkelijk heeft verbeterd.