Home
» Domeinen
»
How to Create an Automated Invoice Processing Agent Using Open-Source AI
How to Create an Automated Invoice Processing Agent Using Open-Source AI
An automated invoice processing agent does not need to begin as a large autonomous AI system. For a first useful version, think of an agent as a controlled software workflow that receives an invoice, calls the right document and AI tools, validates the result, decides whether a human must review it, and only then saves or exports approved data.
That distinction matters in finance. A language model can help turn messy invoice layouts into structured fields, but it should not be the only thing deciding whether an invoice is valid or safe to post. The beginner-friendly design in this guide keeps extraction probabilistic and the important accounting checks deterministic.
By the end, you will have a local prototype that accepts PDF or image invoices, extracts fields such as vendor, invoice number, dates, currency, totals, and line items, validates those fields against rules, routes questionable documents to review, stores an audit trail, and exposes the process through an API.
What do you need to understand before you start?
There are four terms worth knowing:
OCR (optical character recognition) turns text visible in an image or scan into machine-readable text.
Document parsing preserves more structure than plain OCR, such as reading order, tables, headings, and layout regions.
LLM (large language model) can map variable invoice text into a consistent JSON structure.
Human-in-the-loop means the system stops and asks a person to review cases that fail checks instead of pretending every result is correct.
As of September 2026, several actively maintained open-source projects cover these layers. Docling supports PDF, image, office-document, and other document formats; PaddleOCR provides OCR and document-understanding pipelines and is released under Apache 2.0; and the Tesseract project documents its current 5.x line as an open-source OCR engine in the official Tesseract manual.
For local model inference, llama.cpp's server documentation describes OpenAI-compatible endpoints and schema-constrained JSON output. That makes it useful for an extraction service because you can ask a locally hosted model to return a defined object rather than unconstrained prose.
One licensing warning is important: an open-source inference engine does not automatically make every model weight open source. Check the license for the exact model checkpoint you deploy, especially for commercial use.
Which stack should a beginner use?
Layer
Practical choice
Why it is here
Document conversion
Docling
Converts PDFs and images into a structured document representation and exportable text.
OCR fallback
PaddleOCR or Tesseract
Useful when the invoice is a scan or photo and text extraction needs OCR.
Local AI extraction
llama.cpp + a suitable instruction model
Maps variable invoice text to a stable JSON schema while keeping inference local.
Schema validation
Pydantic
Validates Python data against declared field types and constraints.
API
FastAPI
Accepts invoice uploads and returns processing results.
Storage
SQLite for a prototype; PostgreSQL for a shared service
Stores normalized data, review status, source-file identity, and audit events.
Orchestration
Plain Python first; LangGraph optional later
A deterministic function is easier to debug. Add a stateful agent framework when branching and human review become more complex.
Pydantic's official documentation explains that models inherit from BaseModel, validate incoming data, and can emit JSON Schema through model_json_schema(). See Pydantic model validation. If you later need durable, stateful branching, LangGraph's reference describes support for long-running stateful agents, persistence, and human-in-the-loop workflows.
Step 1: Set up the project and define a narrow first goal
Do not start with “automate accounts payable.” Start with one document class and one output contract. A good MVP is: English-language supplier invoices, PDF or image input, one legal entity, one currency set, and no automatic payment execution.
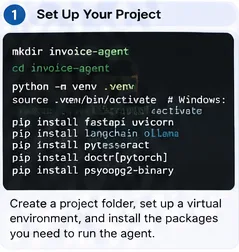
Install your OCR engine separately if you need one. Docling's current installation guide uses pip install docling; PaddleOCR's current installation documentation distinguishes its base OCR package from optional document parsing and information-extraction dependency groups. Use the Docling installation guide or the PaddleOCR 3.x installation guide rather than copying an old dependency list.
Step 1: Create a small isolated Python project first. Keep the first invoice type and output schema narrow enough to test thoroughly.
Step 2: Convert invoices into text and layout data
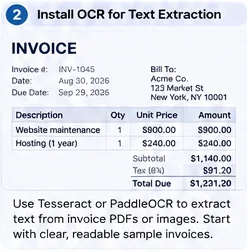
Born-digital PDFs may already contain usable text. Scanned PDFs and photos require OCR. Your parser should hide that difference from the rest of the pipeline: later stages should receive normalized document text plus any useful layout or table information.
A minimal Docling conversion looks like this:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Docling's official quickstart uses the same convert-then-export pattern. For OCR-heavy collections, test PaddleOCR or Tesseract on your own scans. PaddleOCR's project documentation recommends its newer PP-StructureV3 family for document analysis, while Tesseract can be called from the command line or API for printed-text OCR.
Step 2: Begin with readable sample invoices that contain the fields you plan to extract, then add harder scans only after the basic pipeline works.
Stap 3: Bepaal precies welke gegevens de agent mag produceren.
Het extractieschema is het contract tussen AI en boekhoudlogica. Vermijd een enorm schema met "alles wat op een factuur zou kunnen voorkomen". Begin met velden die je kunt valideren.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"Dit is in deze context nuttig omdat onverwachte LLM-velden niet stilletjes onderdeel mogen worden van uw boekhouding. Houd er ook rekening mee dat de Pydantic-validatie de structuur en gegevenstypen bevestigt; het bewijst niet dat de geëxtraheerde leverancier of het bedrag overeenkomt met de factuurafbeelding.
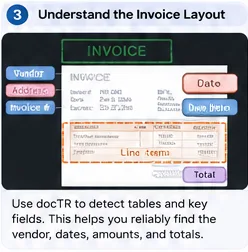
Stap 3: Definieer de doelvelden op basis van de bedrijfsbehoeften en gebruik vervolgens lay-out- en tabelinformatie om te behouden waar die waarden vandaan komen.
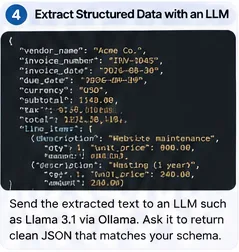
Stap 4: Gebruik een lokaal model om de documenttekst om te zetten in gestructureerde JSON.
Gebruik een geschikt instructiemodel achter de HTTP-server van llama.cpp. De exacte modelgrootte hangt af van uw hardware en de complexiteit van de factuur. Ga er niet van uit dat een groter model automatisch beter is; test de nauwkeurigheid van de velden, de latentie en het geheugenverbruik op uw eigen factuurset.
llama.cpp ondersteunt momenteel schema-beperkte JSON-reacties. U kunt dat schema afleiden van Pydantic en het meesturen met het extractieverzoek:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
Schema-gebaseerde generatie helpt bij het verkrijgen van een geldige structuur, maar garandeert geen semantische juistheid. Een perfect geldig JSON-object kan nog steeds een onjuist totaal bevatten. Daarom is de volgende stap noodzakelijk.
Stap 4: Vraag het lokale model om een strikt gestructureerd object, geen vrije tekst, zodat de daaropvolgende validatie voorspelbare velden ontvangt.
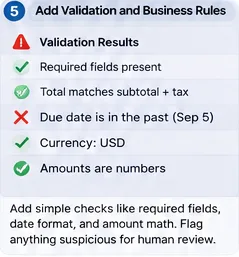
Stap 5: Voeg deterministische boekhoudkundige controles en beoordelingsregels toe.
Vraag de LLM niet: "Heb je er vertrouwen in?" en vertrouw niet blindelings op het antwoord. Zelfgerapporteerd vertrouwen in het model is geen gekalibreerde controle. Bouw controles in die opnieuw berekend kunnen worden op basis van de geëxtraheerde gegevens en je eigen systemen.
Enkele nuttige basisregels zijn:
De verplichte velden zijn aanwezig;
Het factuurnummer is nog niet geregistreerd voor dezelfde leverancier;
De valuta die voor die leverancier of entiteit is toegestaan, is toegestaan;
De bedragen per regel zijn bij benadering gelijk aan het subtotaal;
Het subtotaal plus belasting is ongeveer gelijk aan het totaalbedrag;
De factuurdatum en de vervaldatum zijn aannemelijk;
De leverancier is opgenomen in uw leveranciersdatabase of is aangemeld voor onboarding;
De inkooporderreferenties komen overeen wanneer afstemming van inkooporders vereist is.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Stuur elke mislukte controle door naar een beoordelingswachtrij. Bij een eerste implementatie is het verstandig om alle facturen ter beoordeling aan te bieden terwijl u de kwaliteit van de gegevensextractie meet. De drempelwaarden voor automatisering moeten gebaseerd zijn op bewijsmateriaal dat is verzameld op uw eigen gelabelde facturen, en niet op een algemeen percentage dat is overgenomen uit een ander systeem.
Stap 5: Beschouw rekenkundige bewerkingen, duplicatiedetectie, leveranciersafstemming en datumregels als deterministische controles; leid uitzonderingen door naar een persoon.
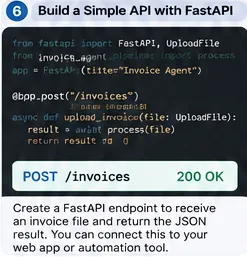
Stap 6: Verpak de processor in een kleine API
Een API maakt het mogelijk dat een uploadformulier, e-mailworker, gedeelde mapmonitor of boekhoudintegratie dezelfde verwerkingsfunctie aanroept. De officiële handleiding voor het uploaden van bestanden van FastAPI beveelt aan UploadFileom voor geüploade bestanden een spoolbestand te gebruiken, wat beter geschikt is dan het volledig in het geheugen laden van grote bestanden.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Raadpleeg de actuele FastAPI-documentatie over request-files voor de ondersteunde uploadpatronen. Handhaaf in een productieomgeving ook limieten voor de bestandsgrootte, voer waar nodig malware-scans uit, verifieer de bellers, gebruik request-ID's en zorg voor een veilige verwijdering van tijdelijke bestanden.
Stap 6: Stel één verwerkingseindpunt beschikbaar nadat de lokale pipeline is voltooid, zodat meerdere invoerkanalen hetzelfde validatiepad kunnen hergebruiken.
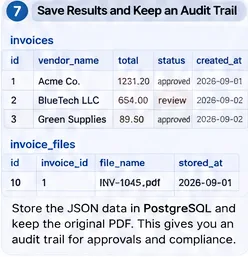
Stap 7: Bewaar het oorspronkelijke bewijsmateriaal, het genormaliseerde resultaat en de auditgebeurtenissen.
Bewaar nooit alleen de uiteindelijke JSON. Bewaar voldoende bewijsmateriaal om te kunnen reconstrueren wat er is gebeurd: de oorspronkelijke bestandsidentificatie, hash, parserversie, model-ID, promptversie, de geëxtraheerde JSON, validatieresultaten, beoordelingsbeslissing, tijdstempels en de gebruiker of service die een wijziging heeft goedgekeurd.
Een eenvoudig prototype kan SQLite gebruiken. Een service voor meerdere gebruikers kan PostgreSQL gebruiken met unieke en externe sleutelbeperkingen. De huidige documentatie van PostgreSQL behandelt tabelbeperkingen , die nuttig zijn voor het beschermen van sleutels en relaties onafhankelijk van de AI-pipeline.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
De bronhash biedt een tweede manier om onbedoelde herverzendingen te detecteren. Houd de toegangsrechten voor bestandsopslag strenger dan voor algemene applicatielogboeken, omdat facturen vaak adressen, bankgegevens, btw-nummers en andere bedrijfsgevoelige gegevens bevatten.
Stap 7: Bewaar zowel de genormaliseerde factuurgegevens als de metadata van het bronbestand, zodat goedkeuringen, duplicaten en latere correcties traceerbaar blijven.
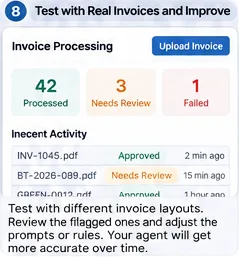
Stap 8: Test met echte factuurvariaties voordat u de daaropvolgende acties automatiseert.
Een prototype dat werkt met vijf schone PDF's is nog niet klaar voor productie. Stel een evaluatieset samen met labels die de daadwerkelijk ontvangen invoer vertegenwoordigt: verschillende leveranciers, scans, gedraaide pagina's, kleine lettertypen, facturen van meerdere pagina's, kortingen, negatieve posten, belastingen, verzendkosten, meerdere valuta, ontbrekende inkooporders en dubbele inzendingen.
Houd veldspecifieke statistieken afzonderlijk bij. "Factuurnauwkeurigheid" kan verbergen dat de naam van de leverancier gemakkelijk te achterhalen is, terwijl de hoeveelheid per artikel onbetrouwbaar is. Meet minimaal het volgende:
Exacte overeenkomst voor factuurnummer, valuta en datums;
Numerieke tolerantienauwkeurigheid voor subtotaal, belasting en totaal;
precisie en recall van regelitems als regelitems verderop in het proces van belang zijn;
percentage dat naar een menselijke beoordeling wordt doorgestuurd;
onjuiste automatische goedkeuringsratio;
verwerkingslatentie en foutpercentage;
Nauwkeurigheid van de duplicaatdetectie.
Bewaar fouten als testgevallen. Voer elke keer dat u een parserregel, prompt, schema of model corrigeert, de volledige evaluatieset opnieuw uit. Dit voorkomt dat een verbetering van de ene leverancier ongemerkt de lay-out van een andere leverancier verstoort.
Stap 8: Meet de beoordelingswachtrij en het aantal foutgevallen bij representatieve facturen voordat u de agent toestaat de daaropvolgende boekhoudkundige acties te automatiseren.
Hoe moet de agent beslissen wat er vervolgens gebeurt?
Houd de toestandsmachine expliciet. De "agent" kan in eerste instantie een gewone Python-functie zijn:
Dit is al agent-achtig omdat het tools coördineert en een vertakking kiest. Je hebt geen LLM nodig om elke volgende stap te bepalen. Voeg LangGraph of een ander orchestratie-framework toe wanneer je persistente meerstapsbeoordelingen, herhaalpogingen, asynchrone callbacks of verschillende gespecialiseerde tools nodig hebt waarvan de uitvoeringsvolgorde per geval verschilt.
Welke fouten moeten beginners vermijden?
De LLM als boekhoudkundige controle laten fungeren
Het model moet gegevens extraheren en normaliseren; code en betrouwbare systeemgegevens moeten de gegevens verifiëren. Rekenkundige bewerkingen, controle op duplicaten, leveranciersstatus, afstemming van inkooporders en goedkeuringslimieten horen thuis in de deterministische logica.
Het brondocument na extractie weggooien.
Bewaar de originele factuur of een gecontroleerde verwijzing ernaar. Beoordelaars hebben bewijs nodig en u moet een manier hebben om fouten na model- of parser-upgrades te reproduceren.
Het gebruik van één prompt zonder versie
Sla bij elke verwerkte factuur een promptversie en model-ID op. Anders kunt u niet verklaren waarom twee facturen die met een tussenpoos van enkele maanden zijn verwerkt, zich verschillend gedroegen.
Automatisch elk schema-valid resultaat plaatsen
De geldigheid van JSON is niet hetzelfde als de geldigheid van een factuur. Begin met een handmatige controle en automatiseer pas de processen voor gevallen met een laag risico nadat uit de evaluatie is gebleken dat de prestaties acceptabel zijn.
Model- en datalicenties worden buiten beschouwing gelaten.
Bibliotheken en modelgewichten kunnen verschillende licenties hebben. PaddleOCR en Tesseract publiceren open-source licenties, terwijl de licentie van het model dat je via llama.cpp uitvoert, afhankelijk is van dat specifieke checkpoint. Controleer dit vóór de implementatie.
De gebruikersinterface bouwen voordat de extractiekwaliteit is bewezen.
Een geavanceerd dashboard kan onjuiste hoeveelheden niet compenseren. Test eerst de documentparsing, schema-extractie en validatie; voeg pas een beoordelingsinterface toe nadat je weet wat beoordelaars daadwerkelijk moeten zien.
Wanneer moet je OCR-only, lay-outmodellen of een LLM gebruiken?
Benadering
Beste pasvorm
Belangrijkste beperking
OCR + regels
Klein aantal zeer stabiele leverancierssjablonen
Regels worden minder strikt naarmate de lay-outs variëren.
Document lay-out model
Tabellen, formulieren en velden waar de positie ertoe doet.
Mogelijk is taakspecifieke training of nabewerking nodig.
OCR/documentparser + lokale LLM
Veel factuurformaten met een gemeenschappelijk doelschema.
Moet worden beperkt en gevalideerd; inferentie vereist meer rekenkracht.
Visie-taalmodel
Complexe documenten waarin tekst en visuele vormgeving nauw met elkaar verweven zijn.
Hogere hardwarevereisten en een complexere evaluatie.
De huidige LayoutLMv3-documentatie van Hugging Face beschrijft een document-AI-model dat tekst- en visuele lay-outinformatie combineert. De PP-StructureV3-documentatie van PaddleOCR richt zich eveneens op lay-out, tabellen en gestructureerde documentanalyse. Dit zijn opties wanneer platte tekst plus een LLM niet volstaat.
Wat is een verstandige route van prototype naar productie?
Ga stapsgewijs te werk. Voer eerst een lokale test uit op een map met gelabelde facturen. Voeg vervolgens de API en permanente opslag toe. Introduceer daarna een wachtrij voor handmatige controle. Integreer vervolgens alleen-lezen zoekfuncties, zoals leveranciersstamgegevens of inkooporders. Maak ten slotte gecontroleerde export naar een tijdelijke boekhoudomgeving mogelijk. Pas nadat monitoring de effectiviteit van de controles heeft aangetoond, kunt u automatische boekingen overwegen voor strikt gedefinieerde gevallen met een laag risico.
Bewaar in elke fase drie dingen: bewijsmateriaal (het originele document en de geëxtraheerde bron), determinisme (bedrijfsregels die opnieuw kunnen worden uitgevoerd) en traceerbaarheid (welke parser, model, prompt en reviewer het uiteindelijke resultaat hebben geproduceerd).
Definitieve checklist
De factuurparser werkt zowel met digitaal aangemaakte pdf's als met de scans die u daadwerkelijk ontvangt.
De extractie-output is beperkt tot een versiebeheerd Pydantic-schema.
Het model mag geen ontbrekende waarden verzinnen.
Totalen, datums, duplicaten, leveranciersidentificatie en inkooporderregels worden buiten het LLM gevalideerd.
Regels die niet worden nageleefd, leiden tot een handmatige controle door een mens in plaats van een stille correctie.
Het originele document, de bron-hash, het model, de promptversie en het validatieresultaat worden vastgelegd.
De API stelt beperkingen aan het bestandstype en de bestandsgrootte en vereist authenticatie voordat deze in een productieomgeving kan worden gebruikt.
Uw testset bevat echte lay-outvariaties en uitzonderlijke gevallen.
De licenties voor het model en de bibliotheek zijn gecontroleerd voor de door u beoogde implementatie.
Vervolgboekingen worden geleidelijk ingevoerd en blijven controleerbaar.
Als die controles aanwezig zijn, heb je meer dan een OCR-demo: je hebt de basis voor een betrouwbare factuurverwerkingsagent. De open-source componenten kunnen in de loop der tijd veranderen, maar de architectuur blijft robuust: bewijsmateriaal analyseren, extraheren in een schema, valideren met code, onduidelijkheden doorsturen naar mensen en elke beslissing vastleggen.