Início
» Domínios
»
Como corrigir o erro “Janela de contexto excedida” na análise de documentos longos sem perder evidências importantes
Como corrigir o erro “Janela de contexto excedida” na análise de documentos longos sem perder evidências importantes
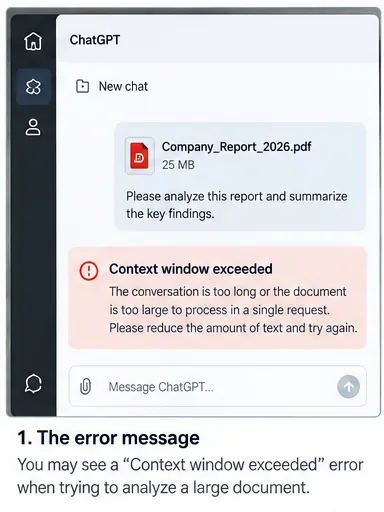
Você envia um relatório extenso, solicita uma análise detalhada e, em vez de uma resposta, recebe uma mensagem como "Janela de contexto excedida", "Comprimento máximo do contexto excedido" ou outro aviso de que a solicitação é muito grande. O mais frustrante é que o arquivo pode ter sido enviado com sucesso e o mesmo documento poderia até mesmo funcionar para uma pergunta mais específica.
O motivo é simples, mas fácil de passar despercebido: um limite de upload e a janela de contexto de um modelo não são a mesma coisa. Um modelo precisa adequar o material que está analisando ativamente a um orçamento finito de tokens. Esse orçamento pode incluir suas instruções, histórico de conversas, texto extraído de arquivos, definições de ferramentas, trechos recuperados, tokens de raciocínio e espaço para a resposta. Portanto, um documento pode ser legalmente carregado, mas ainda assim ser grande demais para ser analisado em uma única passagem.
A melhor solução geralmente não é ficar tentando a mesma solicitação complexa repetidamente. Comece com as mudanças menos disruptivas e, somente se a abordagem mais simples ainda falhar, passe para o agrupamento, a recuperação ou um fluxo de trabalho com um contexto mais amplo.
Primeiro, confirme se o erro é realmente um problema de janela de contexto.
Antes de alterar o documento, diferencie um erro de contexto de um limite de upload ou armazenamento. As diretrizes atuais da OpenAI para upload de arquivos indicam que arquivos enviados para o ChatGPT ou um GPT têm um limite rígido de 512 MB por arquivo, enquanto arquivos de texto e documentos são limitados a 2 milhões de tokens por arquivo. Esses são limites de upload, não uma garantia de que todo o texto será inserido no contexto ativo de um modelo de uma só vez.
A seção de perguntas frequentes sobre uploads de arquivos da OpenAI é a fonte oficial para verificar os limites de upload atuais. Os limites exatos variam de acordo com o produto, plano, modelo e provedor, portanto, não presuma que um número copiado de um artigo antigo ainda se aplique.
O que você vê
Provável gargalo
Melhor primeiro passo
O arquivo foi rejeitado antes do início da análise.
Tamanho do arquivo, tipo de arquivo, armazenamento ou cota de upload
Verifique as regras de upload atuais.
O arquivo é carregado, mas uma longa solicitação falha com um erro de contexto.
A solicitação ativa excede o orçamento de contexto do modelo.
Resumir a solicitação e reduzir o contexto ativo
A resposta abrange as primeiras páginas, mas omite as seções posteriores.
Nem todo o material foi colocado diretamente em contexto, ou a recuperação deixou de fora trechos relevantes.
Faça perguntas mais específicas ou divida por seção.
Uma conversa que funcionava antes, mas que falha após várias tentativas.
O histórico de bate-papo acumulado está consumindo o contexto.
Inicie uma nova análise com um resumo conciso da transição de informações.
Um erro de janela de contexto pode ocorrer após o upload bem-sucedido de um documento, porque a solicitação ativa ainda precisa se adequar ao orçamento de tokens do modelo.
Passo 1: Meça o documento antes de alterá-lo.
A quantidade de páginas e megabytes são pistas úteis, mas o que realmente importa para o contexto do texto são os tokens. A tokenização depende do idioma, da formatação, da pontuação e da codificação do modelo; portanto, um manual técnico de 100 páginas pode consumir um número de tokens muito diferente de uma apresentação de slides de 100 páginas.
As diretrizes da OpenAI para contagem de tokens recomendam verificar a janela de contexto do modelo alvo e deixar espaço para a saída e, no caso de modelos de raciocínio, para os tokens de raciocínio. Também observam que a estrutura da mensagem, ferramentas, arquivos, imagens e esquemas podem adicionar tokens além do texto simples que você conta.
Para uma triagem rápida, registre a quantidade de páginas do arquivo, a contagem aproximada de palavras, o número de seções principais e se ele contém apêndices, linguagem jurídica repetitiva, registros brutos, transcrições, tabelas ou referências que você não precisa para a tarefa.
Verifique a escala do documento antes de solucionar problemas. O tamanho do arquivo e o número de páginas são apenas indicadores; o uso de tokens é o limite mais relevante para a análise de texto.
Passo 2: Reduza a conversa ativa antes de mexer no arquivo.
Se o documento não for extraordinariamente grande, a solução mais econômica pode ser remover o contexto acumulado em vez de dividir o arquivo. Inicie um novo chat ou solicitação e transmita apenas as instruções relevantes. Substitua uma longa conversa de vai e vem por uma breve transferência de informações, como: “Analise o relatório em anexo para identificar os fatores de receita, os riscos relevantes e as orientações da gerência. Apresente cinco conclusões com as respectivas referências de página ou seção.”
Remova também material de fundo repetido, exemplos desnecessários, texto colado duplicado e rascunhos anteriores. Se estiver usando um fluxo de trabalho de API, considere a solicitação completa, e não apenas o documento. Uma solicitação que mal cabe deixa pouco espaço para a resposta e pode falhar de forma imprevisível à medida que as instruções ou os esquemas da ferramenta aumentam.
Sinal de sucesso: o mesmo arquivo funciona em uma nova thread com um prompt focado. Nesse caso, o problema era, pelo menos em parte, o contexto acumulado, e não o documento em si.
Etapa 3: Refine a pergunta e o resultado desejado.
A instrução “Analise tudo neste documento de 400 páginas e redija um relatório abrangente” força o sistema a considerar muitos tópicos simultaneamente. Em vez disso, faça uma pergunta de cada vez. Por exemplo, primeiro solicite os principais riscos do documento, depois suas premissas financeiras e, por fim, as contradições entre as afirmações da administração e os dados que as sustentam.
Mantenha o formato da resposta conciso. Uma solicitação de um documento de 20 páginas consome muito mais recursos de produção do que uma solicitação de uma tabela de evidências com 10 linhas. Você sempre pode expandir a resposta final após a coleta das evidências.
Uma sugestão útil e objetiva é: “Usando apenas este documento, identifique até oito afirmações relevantes para a rotatividade de clientes. Para cada afirmação, indique a seção ou página de referência, uma explicação de uma frase e quaisquer limitações mencionadas. Se o documento não contiver evidências suficientes, indique isso.”
Quando prosseguir: se uma pergunta específica ainda produzir o mesmo erro, ou se você precisar de uma cobertura confiável de todo o documento em vez de um único tópico, divida a fonte.
Passo 4: Divida o documento por significado, não apenas por número igual de páginas.
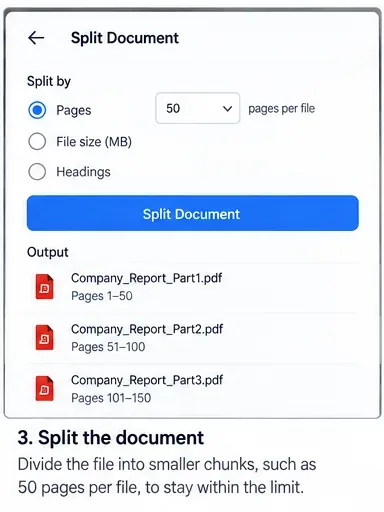
A divisão em blocos é a solução mais confiável e de uso geral para documentos muito longos. Divida o arquivo em limites naturais, como capítulos, seções de relatórios, contratos, apêndices, intervalos de datas ou turnos de fala. Blocos lógicos preservam o contexto melhor do que cortes arbitrários a cada 50 páginas.
Se uma seção depender muito da anterior, inclua uma pequena sobreposição ou uma breve nota de transição descrevendo a seção precedente. Nomeie as partes claramente, por exemplo 01_Executive_Summary.pdf, 02_Financial_Results.pdf, , e 03_Risk_Factors.pdf. Mantenha a numeração original das páginas sempre que possível para que a síntese final possa ser auditada.
Divida uma fonte muito longa em seções lógicas e claramente nomeadas. Preserve as referências originais de página ou seção para que a síntese posterior possa ser verificada em relação à fonte.
Etapa 5: Analise cada fragmento com o mesmo esquema de evidências.
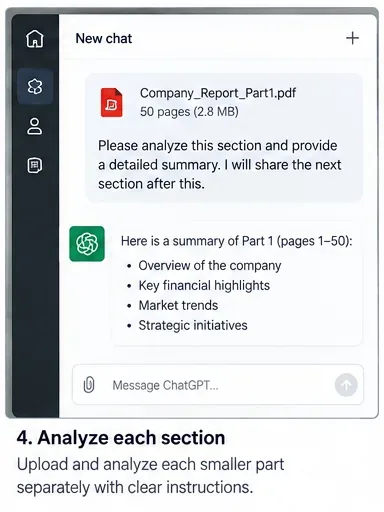
Não solicite simplesmente um resumo livre de cada parte. Utilize a mesma estrutura para cada seção, de modo que os resultados possam ser mesclados sem perder diferenças importantes. Um esquema prático pode conter o nome da seção, as principais conclusões, as evidências de apoio, a referência da página ou do título, as incertezas e as questões em aberto.
Por exemplo: “Analise apenas a Parte 3. Apresente: (1) cinco ou menos conclusões relevantes, (2) as evidências para cada conclusão, (3) a página ou seção original, (4) qualquer ressalva feita pelo autor e (5) questões que devem ser verificadas em outra seção. Não infira fatos que não estejam nesta parte.”
Essa abordagem também facilita a avaliação da qualidade. Se um resumo de um trecho contiver afirmações sem indicação da origem, corrija esse trecho antes de prosseguir, em vez de esperar que a síntese final o corrija.
Analise uma seção de cada vez com um formato de saída fixo, para que cada resultado parcial possa ser posteriormente combinado e rastreado até a origem.
Etapa 6: Crie um resumo dos resumos em vez de recarregar cada bloco completo.
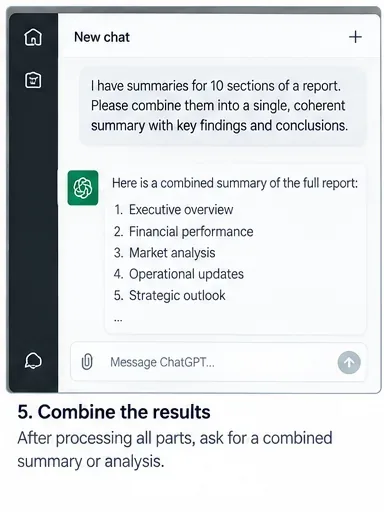
Após a análise das partes, crie um pacote de evidências compacto a partir das saídas dos fragmentos e sintetize-o. Não envie automaticamente todos os fragmentos originais, juntamente com todos os resumos, em uma única solicitação final; isso pode recriar o mesmo problema de contexto.
A instrução de síntese deve orientar o modelo a preservar divergências e lacunas. Por exemplo: “Combine estas análises de seção em um único relatório. Una as descobertas duplicadas, mantenha as evidências conflitantes como pontos separados, preserve todas as referências das fontes e sinalize qualquer questão que não possa ser resolvida a partir dos resumos.”
Este método hierárquico é particularmente útil para livros, documentos regulatórios, conjuntos de provas, longas coleções de entrevistas e pesquisas com múltiplos documentos. Sua principal limitação é a compressão da informação: detalhes omitidos durante um resumo em bloco não podem reaparecer magicamente mais tarde. É por isso que o esquema de evidências e as referências das fontes são importantes.
Combine as análises das seções compactas em vez de recarregar todo o texto original. Preserve as citações, as divergências e as questões não resolvidas durante a síntese.
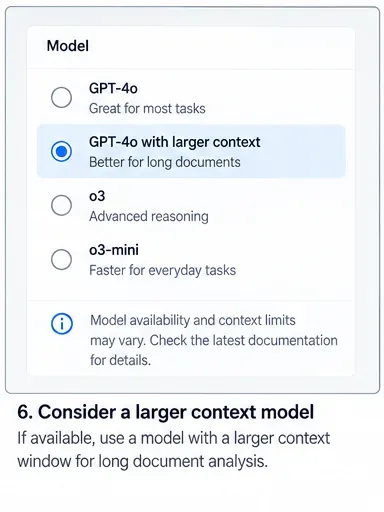
Etapa 7: Considere um modelo de contexto mais amplo, mas não o trate como uma solução completa.
Um modelo com uma janela de contexto maior pode reduzir a necessidade de fragmentação agressiva. A documentação atual dos modelos da OpenAI lista os limites de janela de contexto e de saída máxima para os modelos da API, e esses valores podem mudar conforme os modelos são atualizados.
No entanto, o tamanho do contexto do título de um modelo não corresponde necessariamente à quantidade de um arquivo carregado que um produto insere diretamente no prompt. As diretrizes de arquivos específicas para empresas da OpenAI descrevem atualmente um processo separado de "inclusão de contexto" para documentos de texto carregados: até 110.000 tokens de documentos carregados podem ser inseridos diretamente no contexto, com material adicional disponível por meio de um índice de pesquisa privado. A OpenAI afirma explicitamente que esse comportamento está em desenvolvimento ativo e sujeito a alterações. Consulte Otimizando o envio de arquivos no ChatGPT Enterprise .
A lição prática é escolher um modelo de contexto mais amplo quando ele simplificar materialmente o fluxo de trabalho, mas ainda assim verificar se as seções relevantes estão sendo de fato consideradas. Um contexto mais amplo não elimina a necessidade de um bom escopo, referências de fontes ou verificação.
Um modelo de contexto mais amplo pode ajudar, mas verifique os limites para o modelo exato e a superfície do produto que você está usando, em vez de confiar em um número genérico.
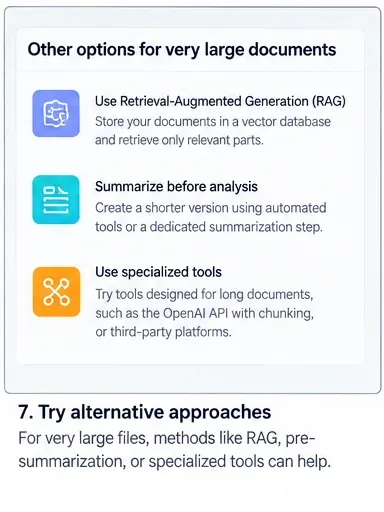
Etapa 8: Para corpora muito grandes, mude de "encher tudo" para recuperação.
Se a tarefa envolver centenas ou milhares de páginas, a recuperação geralmente é uma arquitetura melhor do que tentar encaixar todo o corpus em uma única solicitação. Os sistemas de recuperação indexam a fonte, buscam trechos relevantes para a pergunta atual e colocam apenas esses trechos em contexto ativo.
A documentação da ferramenta de Busca de Arquivos da OpenAI descreve uma ferramenta hospedada para pesquisar arquivos carregados em repositórios vetoriais. A recuperação funciona especialmente bem para perguntas específicas, como "Quais seções definem a rescisão por conveniência?" ou "Onde o relatório discute a concentração da cadeia de suprimentos?".
A recuperação de dados é menos confiável quando a tarefa realmente exige o conhecimento simultâneo de cada passagem, como provar que um tópico nunca aparece, comparar cada célula de uma tabela em uma coleção enorme ou produzir uma transformação exaustiva linha por linha. Nesses casos, utilize processamento em lote sistemático ou pré-processamento baseado em código, além da recuperação de dados.
Para corpora que permanecem muito grandes após o agrupamento, a recuperação pode trazer apenas as passagens mais relevantes para o contexto ativo de cada pergunta.
Correção avançada da API: truncamento de controle intencional.
Os desenvolvedores que usam a API de Respostas da OpenAI têm uma opção adicional. A documentação da API descreve uma truncationconfiguração: com disabled`true`, que é o padrão documentado, uma solicitação que excederia a janela de contexto do modelo falhará; com ` autofalse`, os itens de conversa anteriores podem ser descartados para que a solicitação caiba no espaço disponível. Consulte a documentação da API de Respostas .
O truncamento automático pode evitar uma falha grave, mas altera as informações disponíveis para o modelo. Para análise de documentos, descartar silenciosamente o contexto inicial pode ser pior do que receber um erro. Use-o somente quando seu aplicativo for projetado de forma que os itens de conversa mais antigos sejam dispensáveis ou já estejam resumidos em outro lugar.
Como verificar se a correção realmente funcionou
Uma solicitação bem-sucedida não basta. O objetivo é uma análise defensável que abranja o material correto sem perder evidências de forma implícita. Teste o resultado antes de considerar o problema resolvido.
Verificação de abrangência: confirme se todos os capítulos, intervalos de datas ou arquivos de origem necessários constam no plano de análise ou na tabela final de evidências.
Verificação de rastreabilidade: analise amostras de afirmações importantes e verifique suas referências de página, seção ou arquivo em relação à fonte original.
Verificação de limites: inspecione as descobertas próximas aos limites dos blocos para garantir que um conceito não tenha sido dividido ou contradito entre as partes.
Verificação de controle negativo: faça uma pergunta cuja resposta se sabe estar ausente. Um bom fluxo de trabalho deve afirmar que a evidência não está presente, em vez de inventá-la.
Verificação de repetibilidade: repita algumas perguntas representativas. Grandes mudanças nas evidências citadas podem indicar uma recuperação deficiente ou um enunciado muito amplo.
Verificação de orçamento: se você usa uma API, inspecione o uso real de tokens de entrada e saída em vez de confiar apenas em estimativas aproximadas de contagem de palavras.
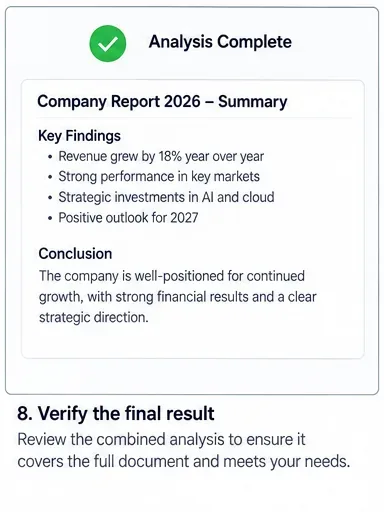
A etapa final é a verificação: verificar a cobertura, as referências de origem, os limites dos blocos e as afirmações não comprovadas antes de confiar na análise combinada.
O que não fazer
Não continue reenviando a mesma solicitação excessivamente grande esperando um limite de tokens diferente. Não exclua referências de origem durante o processo de fragmentação. Não presuma que a aceitação de um arquivo signifique que todas as páginas estão ativas no contexto. E não resolva o erro encurtando a resposta de forma tão drástica que a análise não consiga mais atender aos requisitos da tarefa.
Evite também tratar o truncamento automático como mágica invisível. Se o sistema descartar itens mais antigos, a solicitação poderá ser bem-sucedida, mas com a perda de instruções ou evidências importantes. Para análises de alto risco, o agrupamento e a recuperação explícitos geralmente são mais fáceis de auditar.
Uma regra prática de decisão
Se uma nova thread e uma pergunta mais específica funcionarem, mantenha o fluxo de trabalho simples. Se a tarefa exigir uma ampla cobertura de um documento longo, divida-o em seções lógicas e sintetize análises estruturadas de blocos. Se você consultar repetidamente uma coleção de documentos muito grande, use a recuperação de dados. Se você controla a API e ainda se aproxima do limite, meça os tokens, reserve espaço na saída, selecione um modelo apropriado e torne o comportamento de truncamento uma decisão de projeto explícita.
O resultado mais eficaz não é aquele que inclui a maior quantidade de texto em uma única solicitação. É aquele que abrange as evidências necessárias, preserva a rastreabilidade e deixa claro quando as informações não estavam disponíveis.