Início
» Domínios
»
Como gerar automaticamente títulos e descrições meta para SEO usando o Local Ollama
Como gerar automaticamente títulos e descrições meta para SEO usando o Local Ollama
Você tem 300 páginas de produtos, documentação ou blog prontas para publicação, mas a coluna de metadados ainda está em branco. Escrever cada título e meta descrição manualmente é demorado; copiar um padrão em todo o site produz resultados repetitivos; e pedir a um modelo de idioma local por um "título SEO" geralmente retorna comentários extras, afirmações inventadas ou formatação inconsistente.
Uma abordagem melhor é tratar a geração de metadados como um pequeno pipeline de dados: fornecer ao modelo apenas evidências específicas da página, exigir uma saída estruturada, validá-la no código e, em seguida, revisar as exceções antes da publicação. O Ollama é adequado para esse fluxo de trabalho porque sua API local está disponível após http://localhost:11434/apia instalação e o Ollama oferece suporte a saídas estruturadas em JSON Schema. A documentação do Ollama e do Google Search aqui referenciada foi verificada em 13 de setembro de 2026.
Por que os metadados de SEO automáticos falham?
A maioria das falhas decorre do fluxo de trabalho em torno do modelo, e não de uma única "instrução incorreta". Causas comuns incluem fornecer pouco conteúdo à página, permitir que o modelo responda em prosa livre, aplicar a mesma fórmula de palavras-chave a todos os URLs e publicar a saída sem verificações de duplicatas no nível do site.
Existe também uma ideia errada persistente sobre os limites de caracteres. O Google afirma que não há um limite de comprimento fixo para o <title>elemento `<title>` ou a meta descrição de uma página; os links de título e os trechos de código são truncados conforme necessário, geralmente de acordo com a largura do dispositivo. O Google também pode gerar um link de título ou um trecho de código diferente a partir do conteúdo da página quando seus sistemas consideram outra representação mais útil. Consulte as orientações oficiais do Google sobre links de título , trechos de código e meta descrições .
Isso significa que um script pode impor limites de tamanho editorial para manter a consistência, mas não deve rotular esses números como requisitos do Google. No exemplo abaixo, 65 caracteres para o título e 165 para a descrição são apenas diretrizes internas. Altere-os para que correspondam ao seu CMS, à sua marca, às suas necessidades de localização e ao seu processo de revisão.
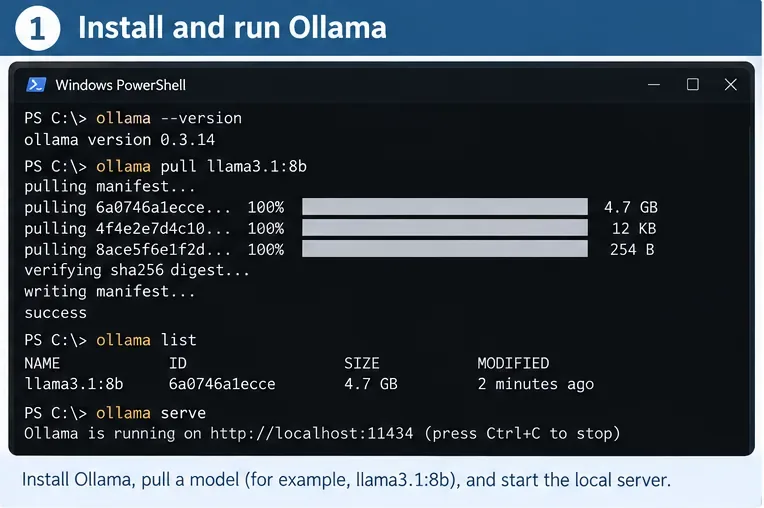
Passo 1: Instale o Ollama e confirme se a API local está funcionando.
O guia de início rápido oficial do Ollama lista suporte para macOS, Windows e Linux. Após a instalação, baixe um modelo local. A documentação atual do Ollama usa frequentemente o modelo gemma3em exemplos da API, sendo, portanto, um exemplo neutro conveniente para este tutorial.
ollama pull gemma3
Em seguida, teste o endpoint local:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
A documentação da API do Ollama afirma que a API local é servida em http://localhost:11434/api. O Ollama também afirma que o acesso local a este endereço não requer autenticação. Se o seu serviço local não estiver em execução, ollama serveo comando CLI documentado para iniciá-lo é . Evite substituir um -cloudmodelo se o seu objetivo for realmente a inferência local.
Fluxo de trabalho no terminal para a fase de configuração: verificar o Ollama, obter um modelo local, confirmar se ele aparece na lista de modelos locais e garantir que o serviço esteja disponível no localhost. Os valores de nome e comprimento do modelo mostrados são exemplos de fluxo de trabalho e não requisitos de SEO.
Escolha um modelo de acordo com o seu hardware.
Este artigo não afirma, intencionalmente, que um modelo seja universalmente o melhor para metadados de SEO. A disponibilidade de modelos e a adequação ao hardware mudam com o tempo, e modelos maiores exigem mais memória e geralmente respondem mais lentamente. Comece com um modelo que sua máquina consiga executar sem problemas, gere um pequeno conjunto de testes e compare a precisão factual, a singularidade, a latência e a consistência antes de processar milhares de páginas.
Etapa 2: Forçar a saída estruturada em vez de analisar prosa.
Textos livres são frágeis para automação. Uma resposta como "Aqui estão três ótimas opções..." força seu programa a adivinhar onde o título real começa. A documentação de saídas estruturadas do Ollama permite passar um esquema JSON no formatcampo. A documentação também recomenda esquemas reutilizáveis por meio do Pydantic em Python e observa que uma temperatura baixa, como 0, pode melhorar o determinismo.
Instale os dois pacotes Python usados neste exemplo:
python -m pip install -U ollama pydantic
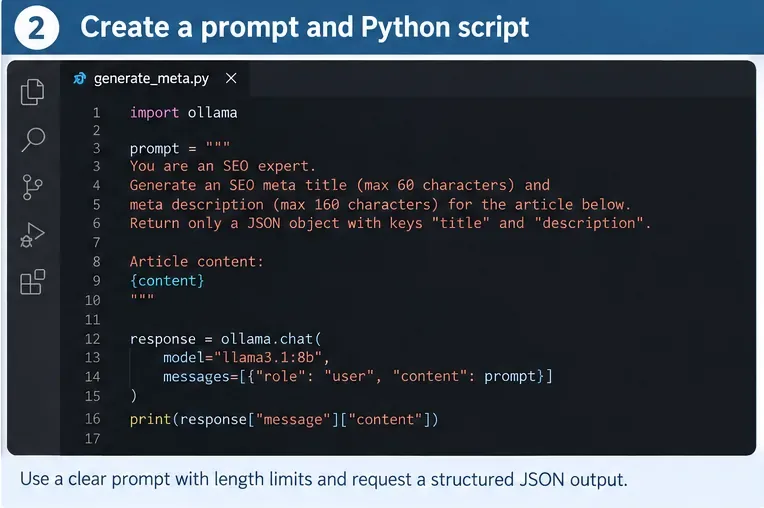
Em seguida, crie generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
O gerador deve ser explícito quanto às evidências da página, aos campos de saída e às restrições editoriais. Em produção, prefira a saída estruturada em JSON-schema do Ollama e a validação no lado da aplicação em vez de depender apenas da redação do prompt.
Por que o prompt inclui o título atual e o H1?
O Google afirma que seu sistema de título e link pode considerar o título visual principal da página <title>, cabeçalhos como "H1" <h1>, og:title"H2", texto em destaque, texto âncora e outros sinais. Seu gerador local não precisa reproduzir o sistema do Google, mas fornecer o título original, o H1, a URL e um texto representativo do corpo do conteúdo ajuda a manter os metadados propostos alinhados com a página que os leitores realmente verão.
Não alimente o modelo com listas de palavras-chave irrelevantes e peça para ele "encaixá-las". O Google recomenda explicitamente títulos descritivos e concisos e alerta contra o excesso de palavras-chave e a repetição de conteúdo genérico. Para descrições, o Google afirma que a geração programática específica para cada página é apropriada para sites grandes baseados em banco de dados, desde que as descrições sejam precisas, legíveis para humanos e diversificadas.
Etapa 3: Execute uma página e valide os resultados antes de expandir.
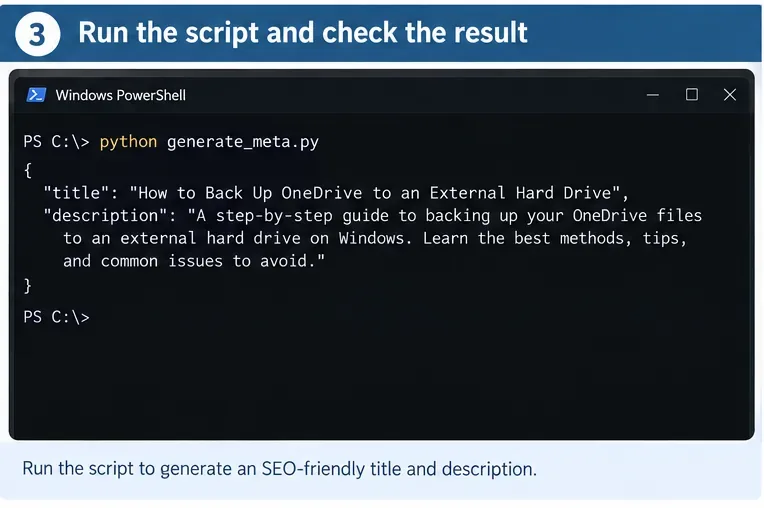
Execute o script:
python generate_meta.py
Um resultado bem-sucedido deve ser um objeto JSON que o Pydantic possa validar. Mais importante ainda, um revisor humano deve ser capaz de compará-lo com a página de origem e responder rapidamente a quatro perguntas:
O título descreve esta página específica em vez do site em geral?
A descrição evita afirmações, datas, preços ou características que estejam ausentes do conteúdo original?
Esses metadados ainda fariam sentido se fossem lidos sem o corpo da página?
É diferente dos metadados já utilizados em páginas próximas?
Antes de iniciar um processamento em lote, teste primeiro uma página representativa e inspecione o resultado estruturado. Uma resposta JSON analisável é necessária, mas a precisão factual e a relevância em nível de página ainda exigem validação.
Adicione novas tentativas para falhas editoriais, não apenas para erros de API.
Um esquema pode restringir tipos e comprimentos de dados, mas não pode garantir que uma frase seja verdadeira ou suficientemente específica. Crie uma lógica de repetição baseada em verificações que você possa mensurar. Por exemplo, rejeite um campo vazio, um título duplicado, texto padrão proibido ou uma descrição que repita o título quase palavra por palavra. Se a página contiver afirmações regulamentadas ou de alto risco, exija revisão humana em vez de tentar automatizar a perda de confiança.
Mantenha as instruções para novas tentativas concisas. Em vez de regenerar tudo com "melhore", diga ao modelo o que falhou: "O título proposto duplica outra página. Reescreva-o usando o tópico exclusivo no H1, mantendo todas as afirmações fundamentadas no conteúdo fornecido." Isso facilita a auditoria das falhas.
Etapa 4: Converter as páginas em lote para CSV para revisão e publicação.
Assim que o teste de página única estiver confiável, armazene suas entradas em um arquivo CSV com colunas como url, source_title, h1, e content. O campo de conteúdo deve conter o texto limpo da página, não menus de navegação, avisos de cookies ou milhares de links de rodapé irrelevantes.
Adicione essa lógica de lote abaixo da função geradora ou coloque-a em um script separado:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
O arquivo CSV gerado pode ser visualizado no Excel, LibreOffice, em uma ferramenta de importação de banco de dados ou no seu fluxo de trabalho de CMS. Não sobrescreva automaticamente os metadados ativos na primeira execução. Mantenha o título e a descrição originais junto com a proposta gerada para que os revisores possam compará-los e para que o processo de reversão seja simples.
Uma fila de revisão em planilha facilita a auditoria da geração em massa: retém o identificador da página de origem, o título gerado, a descrição gerada, os comprimentos e os indicadores de controle de qualidade antes de publicar as alterações.
Tornar o processo de lote mais seguro
Verificar
O que sinalizar
Por que isso importa
Validação de esquema
Campos ausentes ou inválidos
Impede que dados malformados entrem no CMS.
Verificação de título duplicado
Mesmo título normalizado em duas URLs
Ajuda a manter as páginas distinguíveis.
Verificação de idioma
A linguagem dos metadados difere da linguagem da página.
O Google recomenda que a cor e o sistema de escrita sejam os mesmos do idioma principal da página.
Verificação de evidências
Números, preços, datas, marcas ou garantias ausentes da fonte.
Reduz as alegações alucinatórias.
Verificação de texto padrão
Frases longas e repetidas em todo o site
O Google desaconselha o uso de títulos padronizados repetidos.
Verificação do tamanho editorial
Fora do alcance da sua casa escolhida
Mantém a consistência da saída do CMS; esta não é uma regra de limite de caracteres do Google.
Revisão humana
Páginas estratégicas, sensíveis, com alto tráfego ou ambíguas
A automação deve revelar as exceções, não ocultá-las.
Problemas comuns, da solução mais fácil à mais difícil.
A conexão com a API falhou.
Primeiro, confirme se o Ollama está em execução e http://localhost:11434acessível. A documentação oficial de autenticação afirma que a autenticação não é necessária para a API local. Se o seu script estiver apontando acidentalmente para `http:// https://ollama.com/apilocalhost:8080`, trata-se de um endpoint hospedado diferente e que requer autenticação.
A resposta contém um texto explicativo sobre o JSON.
Utilize o esquema format=SeoMeta.model_json_schema()em vez de solicitar apenas JSON em linguagem natural. A saída estruturada é a camada de controle adequada para um pipeline de produção.
Todos os títulos soam iguais.
Insira um texto H1 específico para cada página e conteúdo relevante no corpo do texto, remova ruídos da navegação global e solicite explicitamente uma descrição específica para cada página. Em seguida, execute uma verificação de duplicidades e similaridades entre páginas. A repetição geralmente é um problema de entrada antes de ser um problema de modelagem.
O modelo inventa características ou estatísticas.
Reduza a entrada ao texto oficial da página e reforce a regra básica: nenhuma afirmação factual além do conteúdo fornecido. Para páginas importantes, compare as afirmações geradas com os campos estruturados da fonte antes da aprovação. Se a própria fonte for ambígua, envie a linha para revisão humana em vez de solicitar repetidamente que o modelo tente adivinhar.
O modelo é muito lento para milhares de páginas.
Meça antes de alterar a arquitetura. Registre o tempo de geração por página, o tamanho da entrada, o nome do modelo e a taxa de falhas. Trunque o texto irrelevante, processe as seções estáveis da página e teste um modelo local menor se a qualidade permanecer aceitável. O modelo mais rápido não é útil se seus metadados criarem mais trabalho de revisão do que economizam.
Opcional: utilize uma integração existente no estilo OpenAI.
Se você já possui código escrito para um cliente compatível com OpenAI, a documentação da Ollama sobre compatibilidade parcial com a API OpenAI pode ser encontrada aqui http://localhost:11434/v1/. Isso pode reduzir o trabalho de migração. Para uma nova ferramenta de metadados somente local, o cliente nativo da Ollama em Python é mais simples e expõe exemplos de saída estruturada diretamente na documentação da Ollama.
Como verificar o sistema finalizado por conta própria
Antes de considerar a automação concluída, crie um conjunto de revisões contendo diferentes tipos de conteúdo: um artigo curto, um guia extenso, uma página de produto, uma página de categoria, uma página com números e uma página em cada idioma compatível. Execute o mesmo modelo e prompt em todos os conjuntos de revisões e, em seguida, verifique a seguinte lista de verificação.
O endpoint local é localhoste o modelo selecionado é um modelo local, não um modelo com tags de nuvem.
Cada resposta é validada em relação ao esquema sem necessidade de limpeza manual do JSON.
Nenhum título gerado é duplicado em todo o conjunto de avaliações.
Todas as afirmações factuais constam do conteúdo da página fornecida.
Os metadados utilizam o mesmo idioma principal e sistema de escrita da página.
O título é descritivo e conciso, sem palavras-chave repetidas.
A descrição resume a página específica, e não o site como um todo.
As suas diretrizes internas de comprimento são rotuladas como regras editoriais, não como requisitos do Google.
Os metadados antigos, a proposta gerada, os indicadores de controle de qualidade, o nome do modelo e a versão do prompt são salvos para auditoria e reversão.
Um revisor sabe quais sinalizações exigem aprovação manual antes da publicação.
Por fim, lembre-se do que a automação pode e não pode controlar. Uma boa <title>descrição e meta descrição fornecem aos mecanismos de busca sinais úteis em nível de página, mas o Google pode gerar links de título e trechos a partir de outros conteúdos da página. O objetivo, portanto, não é forçar uma renderização específica nos resultados de busca. O objetivo é produzir metadados precisos, distintos e úteis em escala, preservando validação e revisão suficientes para detectar erros antes que cheguem à produção.