Início
» Domínios
»
Como reduzir o tempo de renderização no ComfyUI para um fluxo de trabalho SDXL
Como reduzir o tempo de renderização no ComfyUI para um fluxo de trabalho SDXL
A maneira mais rápida de reduzir o tempo de renderização em um fluxo de trabalho ComfyUI SDXL geralmente é reduzir a quantidade de processamento de difusão antes de alterar as flags de inicialização de baixo nível: teste em uma resolução SDXL adequada, mantenha o tamanho do lote em 1 durante os ajustes, use menos etapas de amostragem quando a qualidade ainda for mantida e ignore temporariamente recursos extras dispendiosos, como refinadores, ramificações do ControlNet, passes de upscale ou pré-processadores. Somente depois disso você deve ajustar o uso de VRAM, a atenção, a pré-visualização e o comportamento do cache.
Essa ordem é importante porque os parâmetros de inicialização não conseguem compensar um fluxo de trabalho que simplesmente exige da GPU duas ou três vezes mais trabalho do que o necessário. A documentação atual do ComfyUI também recomenda reduzir a resolução ou o tamanho do lote primeiro quando a geração estiver lenta e, em seguida, usar otimizações de memória e atenção conforme necessário. As orientações abaixo foram verificadas com base na documentação atual do ComfyUI e do PyTorch em 13 de setembro de 2026.
Por que os fluxos de trabalho SDXL ficam lentos no ComfyUI?
Uma renderização SDXL pode consumir tempo em diversas etapas: carregamento ou movimentação de pesos de modelos, codificação de texto CLIP, remoção de ruído repetida dentro do KSampler, ControlNet ou outros processos de condicionamento, decodificação VAE, aumento de escala e qualquer etapa de segunda passagem ou refinamento. Se a VRAM estiver limitada, transferências adicionais da CPU para a GPU podem aumentar ainda mais a latência.
Isso significa que dois usuários com a mesma GPU podem ter tempos de renderização muito diferentes. Um grafo básico de texto para imagem com 1024 classes não é comparável a um fluxo de trabalho que adiciona um refinador, duas ControlNets, uma segunda passagem de alta resolução e um lote grande. O objetivo é identificar qual parte do seu grafo é custosa e, em seguida, remover ou otimizar essa parte sem sacrificar a qualidade de saída que você realmente considera importante.
1. Meça uma linha de base limpa antes de fazer qualquer alteração.
Use um prompt fixo, uma semente fixa, tamanho de lote 1 e a mesma resolução de saída. Execute o fluxo de trabalho pelo menos duas vezes. A primeira execução pode incluir carregamento de checkpoint, compilação, E/S de disco ou transferências de modelo; uma execução posterior é uma medida melhor da velocidade de geração em estado estacionário.
Verifique também se a GPU está realmente executando o trabalho. Em sistemas NVIDIA, nvidia-smié possível visualizar o uso de VRAM e a utilização da GPU. Se a utilização da GPU permanecer baixa enquanto o sistema estiver constantemente movimentando dados ou carregando modelos, o gargalo pode ser a pressão na memória ou a E/S, e não o próprio sampler.
Verifique o comportamento da GPU e da VRAM antes de ajustar o ComfyUI. Considere os valores mostrados aqui como um exemplo de layout, não como um valor alvo de teste.
2. Comece pelo menor gráfico SDXL que produza o resultado desejado.
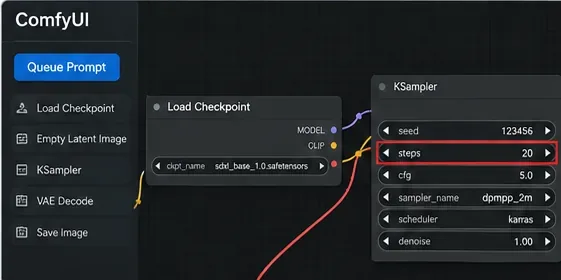
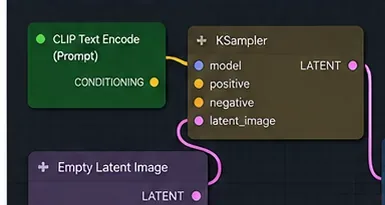
Antes de otimizar um fluxo de trabalho complexo, compare-o com um caminho mínimo: carregamento de checkpoint, condicionamento de prompt, uma Imagem Latente Vazia, KSampler, decodificação VAE e salvamento da imagem. Os exemplos oficiais do ComfyUI mostram que o checkpoint base SDXL pode ser usado como um checkpoint comum. Se esse grafo básico for rápido, mas o seu grafo de produção for lento, os ramos extras são o problema.
Para a fase de rascunho, desative temporariamente os componentes que não são essenciais para a decisão atual. Exemplos incluem um refinador, uma segunda passagem de ampliação, pré-processadores de imagem, múltiplos ControlNets ou ramificações de estilo opcionais. Reative-os um de cada vez após a imagem base ser considerada aceitável.
Um gráfico SDXL pequeno é a melhor base de comparação. Adicione ramificações dispendiosas somente depois de saber quanto tempo cada uma delas leva.
3. Reduza os passos do KSampler antes de tentar configurações de velocidade extremas.
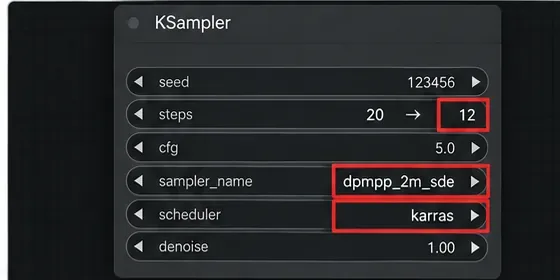
As etapas de amostragem são um dos fatores mais claros a serem considerados, pois cada etapa adicional de redução de ruído aumenta o trabalho. Se você reduzir as etapas de um valor mais alto para um mais baixo, a parte da renderização dedicada à amostragem deverá ficar mais curta, embora o tempo total de processamento não diminua exatamente na mesma proporção, pois o carregamento do modelo, a codificação de prompts, a decodificação VAE e outros nós ainda consomem tempo.
Não copie uma contagem de passos "ideal" universal de outra pessoa. O número correto depende do ponto de verificação, do sampler, do agendador, do prompt, do CFG e da meta de qualidade. Um método prático é manter a semente fixa e testar uma pequena escala — por exemplo, sua configuração atual, depois uma redução moderada e, em seguida, outra redução. Pare quando as texturas, a anatomia, a tipografia ou a fidelidade do prompt se degradarem mais do que você está disposto a aceitar.
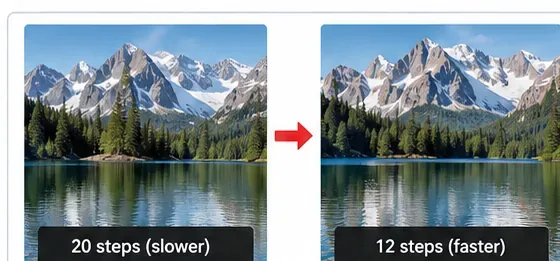
Diminuir o número de passos do KSampler pode reduzir o tempo de redução de ruído. Os valores mostrados são ilustrativos; verifique a qualidade com seu próprio ponto de verificação e semente fixa.
4. Mantenha a resolução do teste e o tamanho do lote sob controle.
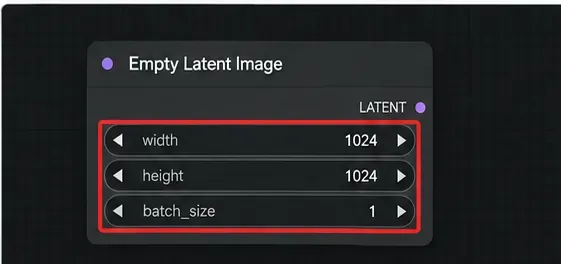
Para SDXL, os exemplos oficiais do ComfyUI recomendam 1024×1024 ou outras proporções com contagem de pixels semelhante, como 896×1152 ou 1536×640, para um comportamento ideal do modelo base. Ultrapassar substancialmente esse limite de pixels aumenta o tamanho latente e, consequentemente, o uso de computação e memória.
Durante o ajuste de prompts e fluxos de trabalho, mantenha o valor batch_sizeem 1, a menos que você precise especificamente de testes de throughput. Um lote de quatro instrui o pipeline a produzir quatro imagens em uma única execução; isso pode melhorar o throughput em algumas configurações, mas não é a maneira de minimizar o tempo até a primeira imagem e aumenta os requisitos de memória.
Se o seu produto final precisar ter uma resolução maior do que a resolução base normal do SDXL, considere separar o "teste de composição" da versão final em alta resolução. Primeiro, acerte o prompt, a seed, o condicionamento e a composição, e só depois invista no upscale ou na segunda versão, que são mais caros, para os candidatos selecionados.
Uma latência de 1024 classes com tamanho de lote 1 é uma linha de base sensata para ajuste do SDXL antes de execuções com resolução mais alta ou com múltiplas imagens.
5. Compare os desempenhos de amostradores e agendadores em vez de presumir que um deles é sempre o mais rápido.
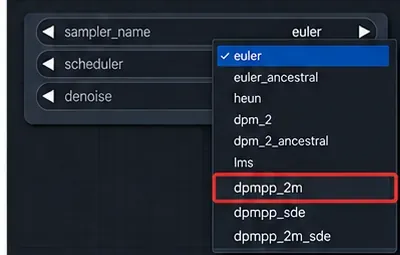
O ComfyUI expõe várias opções de amostradores e agendadores no KSampler. Diferentes combinações podem atingir uma qualidade aceitável em diferentes números de etapas, portanto, "mais rápido" deve significar o mais rápido com a qualidade necessária , e não apenas a execução única mais curta.
Use o mesmo ponto de verificação, prompt, seed, resolução e CFG ao comparar. Altere apenas o sampler ou o scheduler e compare o tempo de renderização e a qualidade visível. Se uma combinação exigir significativamente menos etapas para o seu ponto de verificação, mantendo o resultado desejado, você terá um ganho real de velocidade. Se forem necessárias etapas extras para recuperar detalhes, a aparente vantagem pode desaparecer.
Altere uma variável de amostragem por vez e compare com uma semente fixa. Não assuma que uma amostragem é mais rápida para todos os pontos de verificação ou metas de qualidade do SDXL.
6. Elimine o trabalho redundante em grafos e use o modelo de execução do ComfyUI a seu favor.
O ComfyUI foi projetado para executar apenas as partes do grafo que precisam ser executadas. A documentação do projeto afirma que as partes inalteradas podem ser reutilizadas entre execuções, e o backend atual inclui um cache configurável de resultados de nós. Isso é útil quando você está alterando apenas um valor subsequente em vez de reconstruir todo o fluxo de trabalho.
Mantenha os nós de carregamento e o processamento upstream dispendioso estáveis sempre que possível. Se você alternar constantemente os pontos de verificação, redimensionar imagens grandes repetidamente ou invalidar nós upstream, perderá o benefício do trabalho em cache.
O ComfyUI também possui um recurso documentado de Execução Parcial que permite executar apenas a parte de um fluxo de trabalho necessária para um nó de saída selecionado. Use-o quando estiver testando uma ramificação subsequente e não precisar que todas as saídas em um grafo grande sejam regeneradas.
Um grafo enxuto facilita a identificação de gargalos. Utilize cache e execução parcial para evitar a repetição desnecessária de tarefas inalteradas em etapas anteriores.
7. Ajuste as pré-visualizações, o cache, o modo VRAM e a atenção somente depois que o gráfico estiver eficiente.
As opções de linha de comando atuais do ComfyUI expõem vários controles de desempenho. Seus efeitos dependem do hardware e da memória disponível, portanto, considere-os como possíveis parâmetros de teste, e não como opções obrigatórias.
Contexto
Quando isso pode ajudar
Principal compensação
--preview-method none
Se as pré-visualizações do sampler estiverem ativadas e você só se importar com o resultado final,
Você perde as pré-visualizações latentes em tempo real. A CLI atual já não usa pré-visualizações por padrão.
--highvram
Se você tiver VRAM suficiente e o descarregamento/recarregamento repetido do modelo estiver consumindo tempo,
Mantém os modelos na memória da GPU e pode causar erros de falta de memória em placas com menos recursos.
--lowvram
Se o fluxo de trabalho não couber na VRAM, por outros motivos,
Este é principalmente um modo de economia de memória, não um modo de velocidade; o uso da CPU ou as transferências podem aumentar a latência.
--use-pytorch-cross-attention
Vale a pena fazer testes de desempenho em combinações modernas de PyTorch/GPU.
Não combine sinalizadores de modo de atenção mutuamente exclusivos indiscriminadamente.
--use-flash-attention
Vale a pena testar quando sua pilha de hardware/software suportar o caminho otimizado.
A disponibilidade e os benefícios dependem das entradas e kernels suportados.
--cache-classicou--cache-lru N
Fluxos de trabalho repetidos onde memória cache extra é aceitável.
Pode utilizar mais RAM/VRAM.
--cache-none
Somente quando reduzir a memória cache for mais importante do que a velocidade.
A própria CLI do ComfyUI indica que cada nó será executado a cada execução, o que geralmente piora o tempo de renderização.
A CLI atual também expõe o descarregamento assíncrono de pesos, e seu texto de ajuda indica que ele está habilitado por padrão em placas NVIDIA. Isso significa que adicionar mais opções não resulta automaticamente em otimização; primeiro verifique seu comando de inicialização atual e os registros de log.
A atenção de produto escalar escalonada do PyTorch pode selecionar automaticamente implementações CUDA otimizadas, como FlashAttention ou atenção com uso eficiente de memória, quando as entradas e o hardware permitirem. Essa é a razão pela qual os caminhos de atenção modernos podem ser relevantes, mas o ganho exato depende do hardware. Evite citar uma porcentagem genérica como se ela se aplicasse ao seu fluxo de trabalho SDXL.
8. Mantenha o comportamento da fila e do lote alinhado com seu objetivo.
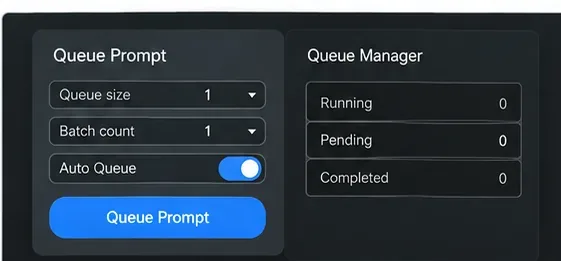
Se sua prioridade é o ciclo de feedback mais rápido, enfileire uma imagem por vez durante o ajuste. Grandes quantidades de imagens na fila e em lotes são úteis quando você já conhece as configurações e deseja alta taxa de transferência, mas não fazem com que a primeira imagem chegue mais rápido.
Após a finalização do fluxo de trabalho, você pode avaliar o desempenho separadamente. Nesse ponto, um lote maior pode ser interessante, caso a VRAM permita e se o número total de imagens por minuto for mais importante do que a latência por imagem.
Use uma imagem enfileirada e um tamanho de lote de 1 para ajuste interativo; teste lotes maiores posteriormente, quando o objetivo for a taxa de transferência.
Como saber se a otimização realmente funcionou?
Uma execução mais rápida só é útil se a imagem ainda atender ao seu objetivo. Compare o antes e o depois com a mesma semente e o mesmo prompt. Verifique primeiro as áreas que falham quando as configurações são muito agressivas: texto pequeno, mãos e rostos, padrões repetidos, materiais delicados, detalhes de borda e aderência aos atributos específicos do prompt.
Registre pelo menos estes quatro itens para cada teste: tempo total de execução, etapas de amostragem, resolução e se o carregamento do modelo ocorreu. Se a primeira execução levar 30 segundos e a segunda levar 12 segundos, não credite automaticamente uma mudança de amostrador — a primeira execução pode simplesmente ter pago o custo do carregamento do ponto de verificação.
Use comparações lado a lado com sementes fixas para decidir se um número menor de passos é aceitável. Os rótulos na imagem ilustram o método e não representam resultados de benchmark.
Uma ordem de otimização prática
Faça um teste comparativo em uma execução aquecida. Mantenha a semente, o prompt, a resolução e o lote fixos.
Remova ramificações desnecessárias. Teste o caminho base do SDXL sem refinador, ControlNet, upscale ou pré-processadores opcionais.
Reduza as etapas. Encontre a menor quantidade possível que ainda atenda aos seus padrões de qualidade.
Mantenha a resolução em níveis aceitáveis. Ajuste o orçamento de pixels da classe 1024 do SDXL antes de finalizar em alta resolução.
Mantenha o lote em 1 durante a iteração. Otimize a taxa de transferência somente após o fluxo de trabalho estar estável.
Compare as opções de amostrador/programador. Avalie a velocidade com qualidade aceitável equivalente.
Utilize cache e execução parcial. Evite executar novamente trabalhos anteriores que não foram alterados.
Em seguida, teste os parâmetros de inicialização do benchmark. Teste as alterações de visualização, VRAM, cache e atenção, uma de cada vez.
Quando você deve mudar de estratégia em vez de otimizar mais?
Se um fluxo de trabalho SDXL ainda demorar muito após essas alterações, verifique o que o trabalho está realmente fazendo. Um grafo de produção com múltiplos ControlNets, refinador e upscale, pode simplesmente ser computacionalmente intensivo por natureza. Nesse ponto, você tem três opções viáveis: aceitar a renderização mais demorada para as imagens finais, usar um fluxo de trabalho de rascunho mais simples para iteração ou mover a carga de trabalho para um hardware mais rápido.
Da mesma forma, se você está constantemente ficando sem VRAM, forçar um modo residente na GPU "mais rápido" não é a solução ideal. Uma execução estável com o gerenciamento dinâmico de memória padrão ou com uma configuração de VRAM reduzida é melhor do que falhas repetidas por falta de memória. Configurações de economia de memória podem aumentar o tempo de renderização, mas uma renderização bem-sucedida, mesmo que mais lenta, ainda é mais útil do que uma falha repentina.