Início
» Domínios
»
How to Set Up a Private Local AI Knowledge Base for Personal Documents
How to Set Up a Private Local AI Knowledge Base for Personal Documents
The simplest practical answer: run the language model, embedding model, document index, and chat interface on your own computer. A straightforward stack is Ollama for local model serving plus self-hosted AnythingLLM for document ingestion, retrieval-augmented generation (RAG), and chat. Keep the vector database local, use persistent storage, avoid cloud model providers, and test that answers are actually grounded in your files.
Illustrative example: throughout this guide, imagine Jordan is organizing a private collection that includes household manuals, insurance PDFs, meeting notes, a personal finance reference, and a few project reports. Jordan is fictional. The files, questions, answers, and outcomes described below are examples for explaining the workflow, not test results or a testimonial.
This guide uses a four-step setup so the privacy boundary stays understandable. It is appropriate for one person or a small trusted household that wants local document search and question answering. If you need enterprise identity controls, multi-node availability, centralized auditing, or regulatory guarantees, you should treat this as a starting architecture rather than a complete compliance solution.
What “private local AI knowledge base” actually means
A local knowledge base is not the same thing as training a model on your documents. In a typical RAG workflow, the system extracts text from your files, splits the text into chunks, converts those chunks into numeric embeddings, stores them in a vector database, retrieves relevant chunks for each question, and sends only those chunks to the language model as context.
AnythingLLM’s current documentation describes both attached-document and embedded-document workflows. Attached documents can place full text into a chat when the context window permits, while RAG retrieves smaller relevant pieces from embedded documents. Its current local LanceDB documentation also states that the default on-instance LanceDB keeps document text and embeddings inside the AnythingLLM application. See the AnythingLLM document workflow documentation and AnythingLLM LanceDB documentation.
Component
Role in the local stack
Privacy-sensitive choice
Ollama
Runs the chat model and, optionally, an embedding model on your machine
Use a local model, not a cloud-hosted model endpoint
AnythingLLM
Provides the UI, document management, chunking, RAG, and workspace organization
Run it locally and keep its storage directory persistent
Embedding model
Turns document chunks and queries into vectors for semantic retrieval
Use a local embedder if documents must not be sent to an external service
LanceDB
Stores vectors used to find relevant passages
Keep the default local instance unless you intentionally need a remote database
Original files and backups
Remain the authoritative source
Protect them with normal OS access controls, encryption, and backups
Before you begin: decide the privacy boundary
The key question is not “Is the app local?” It is “Which components can send document text or prompts off the machine?” A local UI can still be configured to call a cloud LLM, a cloud embedding API, web search, or remote tools. For a private setup, keep the LLM, embedder, and vector database local unless you have deliberately accepted the data-sharing implications of an external provider.
AnythingLLM documents anonymous telemetry and provides a way to disable it. Its privacy documentation also distinguishes removing a document from one workspace from deleting it from the document library entirely. For full erasure within AnythingLLM, the current documentation says to delete the document from My Documents, which removes the parsed source and cached embeddings as well as workspace references. Review the AnythingLLM privacy and data handling documentation before adding sensitive material.
You also need enough memory for your chosen local model. There is no single correct model size because usable speed depends on CPU, GPU, RAM or VRAM, quantization, context length, and the number of documents retrieved. Start with a model that fits comfortably rather than choosing the largest model your machine can barely load.
Step 1: Install Ollama and prepare local chat and embedding models
Install Ollama using the current instructions for your operating system. Ollama is available for macOS, Windows, and Linux, and its local API is served on port 11434 by default. The official Ollama quickstart is the best source for current installation and command syntax.
After installation, pull a chat model that suits your hardware. The exact model is deliberately not fixed here because the model catalog changes and hardware requirements vary. A typical command has this form:
ollama pull <chat-model-name>
For RAG, you also need an embedding model. Ollama’s current embeddings documentation, checked in September 2026, lists models such as embeddinggemma, qwen3-embedding, and all-minilm as recommended embedding choices. You can review the current list in the Ollama embeddings documentation. For example:
ollama pull embeddinggemma
Do not use a normal chat model as an embedding model just because it appears in a model dropdown. AnythingLLM’s current Ollama embedder documentation explicitly warns that Ollama can expose both chat models and embedding models in the same list. Use an actual embedding model for document indexing. See the AnythingLLM Ollama embedder setup.
Illustrative terminal flow for pulling a local model with Ollama. The version number visible in this example is not a current-version recommendation; verify the installed version with the official Ollama documentation.
For Jordan’s fictional setup, the goal at this stage is simple: both generation and embedding should be possible without sending the household documents to a remote API.
Step 2: Run AnythingLLM locally with persistent storage and connect it to Ollama
AnythingLLM offers desktop and self-hosted options. This guide uses the Docker route because the storage boundary is explicit and easy to back up. Its current local Docker documentation instructs users to pull the image and emphasizes that persistent storage is required or application data can be lost when the container is recreated. It also states that the web application is available at http://localhost:3001. Use the official AnythingLLM local Docker guide rather than copying an old command from a forum.
docker pull mintplexlabs/anythingllm:latest
When you run the container, preserve AnythingLLM’s storage by mounting a host directory to /app/server/storage. The vendor documentation specifically calls out the persistent mount as necessary. Keep that storage directory on a disk that is included in your backup plan.
Then configure the LLM provider as Ollama. If AnythingLLM is running directly on the host, the documented default Ollama address is http://127.0.0.1:11434. If AnythingLLM is running inside Docker while Ollama runs on the host, do not use localhost from inside the container. AnythingLLM’s Docker networking documentation says to use http://host.docker.internal:11434 on supported desktop platforms; on Linux it documents 172.17.0.1 for this host connection pattern. See AnythingLLM’s localhost networking note and Ollama LLM configuration.
In settings, choose Ollama as both the LLM provider and, if desired, the embedding provider. Select the chat model for generation and the embedding model for indexing. Keeping those roles separate prevents a common configuration mistake.
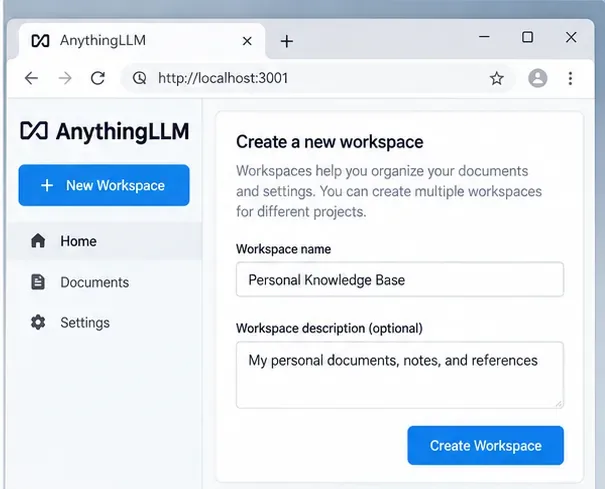
Self-hosted AnythingLLM is documented to run at localhost:3001. A dedicated workspace gives one document collection a clear purpose and keeps unrelated material out of the retrieval pool.
Jordan creates a workspace called “Personal Knowledge Base” and avoids connecting cloud model providers. That makes the intended boundary easy to audit later: local UI, local LLM, local embeddings, local vectors.
Step 3: Add documents, choose RAG versus full-text attachment, and verify ingestion
Do not begin by uploading your entire drive. Start with a small, representative set of documents whose contents you know well. This gives you a controlled way to detect extraction or retrieval problems before the index grows.
No exemplo de Jordan, um primeiro lote útil poderia incluir um PDF pesquisável, um arquivo DOCX e uma nota em texto simples ou Markdown. Se os PDFs digitalizados contiverem imagens em vez de texto selecionável, confirme se o caminho de processamento de documentos escolhido extrai realmente o texto necessário; um arquivo que parece legível para você ainda pode produzir uma representação de texto vazia ou de baixa qualidade para o RAG.
Atualmente, o AnythingLLM oferece suporte a dois comportamentos gerais de documentos:
Documentos anexados: úteis quando o texto completo cabe na janela de contexto do modelo e você deseja que o modelo veja o arquivo completo daquela thread.
Documentos incorporados com RAG: úteis para coleções maiores ou reutilizáveis. O sistema divide o conteúdo em partes, incorpora-o e recupera as porções relevantes para uma pergunta.
O guia de documentação atual do AnythingLLM observa que os documentos incorporados em um espaço de trabalho ficam disponíveis em todas as threads desse espaço de trabalho. Isso é conveniente, mas também significa que a associação ao espaço de trabalho faz parte do seu modelo de privacidade em implantações com vários usuários. Mantenha os espaços de trabalho pessoais separados de qualquer espaço de trabalho compartilhado.
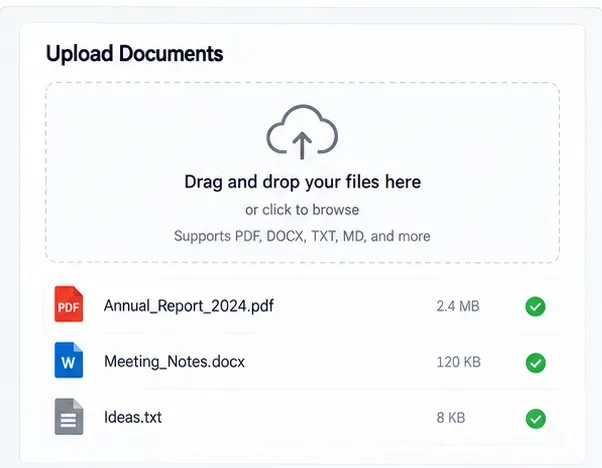
Exemplo de visualização de ingestão com vários tipos de documentos. Use primeiro um pequeno lote com resultados satisfatórios e, em seguida, verifique a extração e a indexação antes de adicionar um arquivo grande.
Após a incorporação, faça uma pergunta cuja resposta apareça em apenas um arquivo. Em seguida, peça um detalhe que não apareça em nenhum arquivo. A primeira pergunta testa a capacidade de recuperação de dados; a segunda testa se o modelo admite incerteza em vez de inventar uma resposta.
O que ajustar se a recuperação estiver fraca?
O AnythingLLM expõe controles RAG em nível de espaço de trabalho, como preferências de pesquisa, número máximo de trechos de contexto e limite de similaridade de documentos. Sua documentação recomenda começar pelas configurações do espaço de trabalho, em vez de presumir que o problema esteja no modelo base. Aumentar o contexto recuperado pode ajudar quando a resposta abrange várias seções, mas enviar muitos trechos também pode adicionar texto irrelevante e consumir a capacidade da janela de contexto.
Se você alterar os modelos de incorporação após a indexação, reincorpore os documentos afetados para que os vetores armazenados e os vetores de consulta provenham do mesmo espaço de incorporação. Misturar incorporações de modelos diferentes não é uma estratégia de recuperação adequada.
Etapa 4: Teste respostas fundamentadas, proteja a privacidade e faça backup da base de conhecimento.
Uma base de conhecimento só é útil se você conseguir detectar quando ela está errada. Crie uma pequena lista de avaliação a partir de fatos que você possa verificar diretamente. Por exemplo:
Solicite uma data, valor, modelo de produto ou cláusula da apólice que conste textualmente em um documento.
Faça uma pergunta que envolva vários documentos e que exija informações de dois arquivos diferentes.
Faça uma pergunta deliberadamente sem resposta e verifique se a resposta não inventa uma fonte.
Faça a mesma pergunta com palavras diferentes para verificar se a recuperação da informação é estável.
Abra o documento original e confirme manualmente cada afirmação de alto risco.
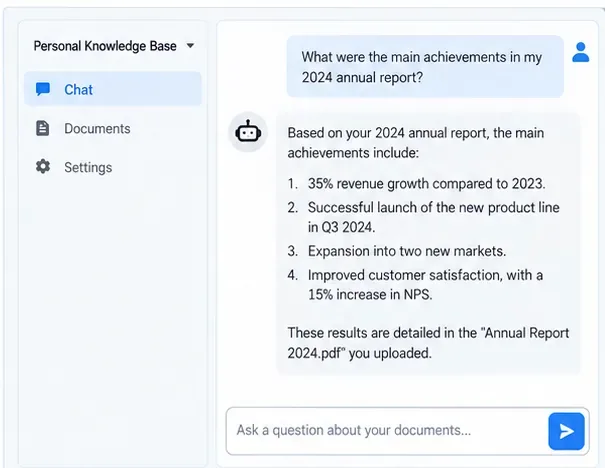
Resposta hipotética baseada em documento, usada para ilustrar a etapa de verificação. As figuras apresentadas são exemplos fictícios de conteúdo; em uma base de conhecimento real, as afirmações importantes devem ser verificadas em relação ao arquivo original.
Para Jordan, uma boa regra de aceitação não é "a resposta parece certa". É "a resposta corresponde à fonte, inclui o contexto necessário e falha de forma segura quando a fonte não contém a informação". Essa regra é especialmente importante para impostos, seguros, documentos legais, registros médicos ou decisões financeiras.
Mantenha a configuração privada depois que ela funcionar.
A inferência local reduz a exposição de dados, mas a privacidade ainda depende da configuração. Use esses controles como um guia prático:
Mantenha o serviço AnythingLLM vinculado à máquina local ou a uma rede privada confiável, a menos que o acesso remoto seja intencionalmente protegido.
Não adicione integrações de LLM na nuvem, incorporação na nuvem, pesquisa na web, navegador ou agente a um espaço de trabalho que contenha material confidencial, a menos que você entenda o que essas integrações transmitem.
Desative a telemetria anônima se sua política de privacidade exigir zero telemetria de produto.
Utilize a criptografia de disco e as permissões de conta do seu sistema operacional. Um banco de dados de vetores local ainda será legível caso um invasor obtenha acesso à máquina.
Exclua arquivos confidenciais da biblioteca de documentos, e não apenas de um espaço de trabalho específico, quando sua intenção for apagá-los completamente dentro do AnythingLLM.
Aplique patches no Ollama, AnythingLLM, Docker e no sistema operacional do host. "Offline" não deve significar "nunca recebeu manutenção".
Faça backup das partes que são difíceis de recriar.
Os documentos originais continuam sendo sua fonte de verdade, mas o diretório de armazenamento do AnythingLLM contém o banco de dados do aplicativo, os documentos analisados, os dados vetoriais e a configuração necessária para evitar a reconstrução de tudo após uma falha de disco. Faça backup tanto da pasta de documentos original quanto do armazenamento persistente do AnythingLLM. Se você usar volumes do Docker em vez de um diretório do host montado por bind, siga a documentação oficial do Docker sobre backup e restauração de volumes .
Teste a restauração, não apenas a criação de backups. Um backup só é considerado eficaz quando você consegue restaurá-lo para outro diretório ou máquina, iniciar o sistema local, abrir o espaço de trabalho e recuperar corretamente um fato conhecido.
Quando essa configuração é adequada — e quando não é.
Essa arquitetura é ideal quando sua prioridade é manter documentos pessoais em hardware que você controla, você se sente confortável executando software local e deseja busca semântica com respostas em linguagem natural em uma biblioteca de documentos de tamanho moderado. Também é útil quando o acesso à internet é instável ou quando você deseja custos locais previsíveis após o download dos modelos.
Essa solução é menos adequada se o seu computador não for capaz de executar um modelo local apropriado, se você precisar de acesso contínuo a partir de vários dispositivos fora da sua rede doméstica ou se exigir recursos de nível empresarial, como identidade, auditoria, retenção legal, gerenciamento centralizado de chaves ou suporte garantido. Nesses casos, a solução ideal pode ser uma implementação privada gerenciada ou uma plataforma RAG empresarial, em vez de uma configuração em um único computador.
Uma lista de verificação de configuração compacta
Instale o Ollama e verifique a inferência do modelo local.
Instale um modelo de incorporação dedicado, como um dos listados na documentação atual de incorporações do Ollama.
Execute o AnythingLLM localmente com armazenamento persistente.
Conecte o AnythingLLM ao endpoint local do Ollama usando o endereço de host correto para o seu método de implantação.
Utilize um banco de dados vetorial local, como o LanceDB padrão do AnythingLLM, quando o objetivo for a recuperação de documentos apenas em nível local.
Crie um espaço de trabalho com escopo bem definido.
Comece com alguns documentos conhecidos e verifique a extração.
Use o RAG para grandes coleções reutilizáveis e anexos de texto completo somente quando o documento se encaixar confortavelmente no contexto do modelo.
Faça testes com perguntas que podem ser respondidas e perguntas que não podem ser respondidas antes de confiar no sistema.
Desative integrações externas e telemetria desnecessárias de acordo com suas necessidades de privacidade.
Faça backup dos documentos de origem e do armazenamento persistente do aplicativo e, em seguida, teste a restauração.