Início
» Domínios
»
Como medir a qualidade das respostas do LLM usando as estruturas de avaliação
Como medir a qualidade das respostas do LLM usando as estruturas de avaliação
A maneira mais confiável de medir a qualidade da resposta do LLM é tratar a avaliação como um sistema de teste repetível, e não como uma pontuação única. Defina o que "bom" significa para sua aplicação, construa um conjunto de dados de avaliação representativo, combine verificações determinísticas com julgamento humano e baseado em modelos, compare cada alteração candidata com uma linha de base e inspecione as falhas por categoria antes do lançamento.
Isso é importante porque um LLM pode produzir uma resposta que soa bem elaborada, mas ainda assim está errada, sem embasamento, incompleta, insegura ou inconsistente com suas instruções. Uma estrutura de avaliação útil transforma essas preocupações vagas em critérios explícitos que podem ser reavaliados após uma alteração de prompt, atualização do modelo, mudança de recuperação de dados, atualização da ferramenta ou revisão da política de segurança.
Nota sobre a documentação: as funcionalidades do framework descritas abaixo foram verificadas com base na documentação oficial disponível em 13 de setembro de 2026. Essas ferramentas evoluem rapidamente, portanto, verifique as APIs atuais antes de copiar o código específico do framework para produção.
O que você deve medir primeiro?
Comece com a falha que mais importaria para seus usuários. Para um bot de suporte factual, a correção e a conformidade com as políticas podem ser os fatores mais importantes. Para geração aumentada por recuperação (RAG), a fundamentação e a qualidade da recuperação são importantes porque uma resposta fluente ainda pode inventar fatos que não são sustentados pelo contexto recuperado. Para um agente, a qualidade da resposta final não é suficiente; você também pode precisar avaliar a seleção de ferramentas, os argumentos da ferramenta, a conclusão da tarefa e etapas desnecessárias.
Dimensão da qualidade
O que pede?
Bom tipo de avaliador
Correção
A resposta está correta do ponto de vista factual ou lógico?
Comparação de referências, verificação de código, avaliador do LLM ou revisão humana.
Instruções a seguir
O modelo obedeceu às restrições exigidas?
Regras do código mais avaliação baseada em critérios.
Firmeza
As afirmações são sustentadas pelo contexto apresentado?
verificações específicas do juiz ou do processo RAG
Relevância
A resposta responde à pergunta em si, sem se desviar do assunto?
Juiz de mestrado em Direito ou revisão humana
Conformidade de formato
O resultado é um JSON válido, compatível com o esquema ou, de alguma forma, utilizável por máquina?
Código determinístico
Segurança e política
A resposta viola as regras do aplicativo?
Verificações de políticas, juiz de LLM e revisão humana direcionada.
Eficiência
Qual foi a latência, o uso de tokens e o custo exigidos pela resposta?
Telemetria e rastreamento
Não faça a média desses valores em um único número muito cedo. Um modelo candidato que ganha dois pontos em estilo, mas introduz mesmo um pequeno número de falhas graves nas políticas, pode resultar em uma versão pior. Mantenha as dimensões críticas visíveis como etapas separadas.
Um fluxo de trabalho de avaliação em quatro etapas que funciona em diversas estruturas.
1. Construa um conjunto de dados de avaliação representativo.
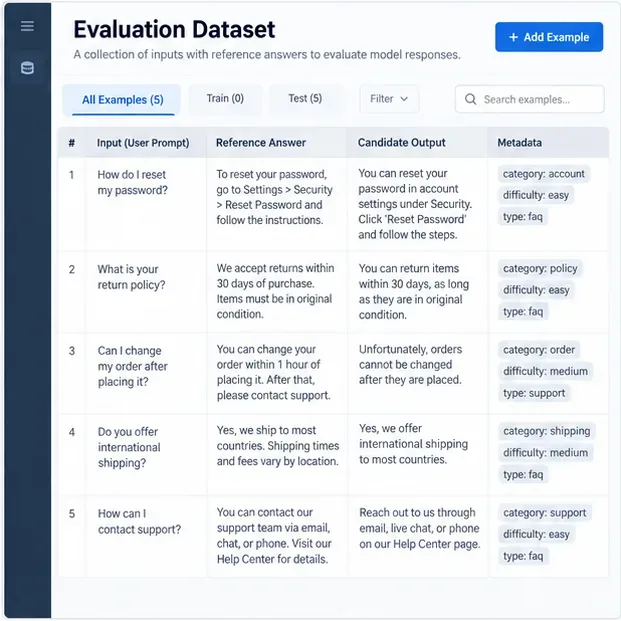
Seu conjunto de dados deve conter entradas realistas e, quando possível, o comportamento esperado. Algumas linhas podem ter respostas de referência exatas; outras podem precisar de uma rubrica em vez de uma única frase "ideal". Adicione metadados como tipo de tarefa, segmento de clientes, idioma, dificuldade, condição de recuperação ou categoria de segurança para que você possa segmentar os resultados posteriormente.
Por exemplo, imagine um assistente de suporte ao cliente. Um conjunto de avaliação útil não conteria apenas perguntas fáceis de perguntas frequentes. Ele também deveria incluir solicitações ambíguas, exceções de política, casos de falta de contexto, perguntas adversárias, acompanhamentos com várias interações e exemplos em que o comportamento correto seria dizer que a resposta não pode ser determinada.
As diretrizes de avaliação atuais do LangSmith recomendam começar com exemplos selecionados manualmente que mostrem o que é um bom comportamento e, em seguida, expandir o conjunto de dados com registros históricos e falhas descobertas em produção. Seu sistema de avaliação suporta conjuntos de dados com entradas, saídas de referência opcionais e metadados. Consulte a documentação de conceitos de avaliação do LangSmith .
Um conjunto de dados de avaliação deve combinar instruções realistas com referências ou comportamento esperado e preservar os metadados para posterior análise de falhas.
Quando essa abordagem se aplica: quase sempre. Mesmo se você usar avaliação em produção real, ainda precisará de um conjunto de dados offline estável para testes de regressão. Se você não tiver uma resposta de referência para tarefas abertas, armazene uma rubrica, fatos obrigatórios, comportamentos proibidos ou preferências entre pares.
2. Associe cada dimensão de qualidade ao avaliador correto.
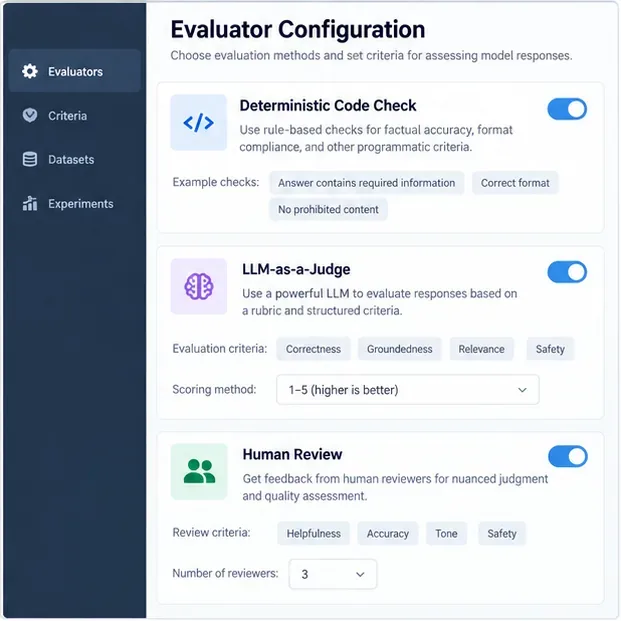
Os melhores sistemas de avaliação combinam diferentes tipos de avaliadores, pois nenhum avaliador individual é ideal para todas as questões.
As verificações determinísticas são mais adequadas quando o requisito é inequívoco: JSON válido, rótulos exatos, chaves obrigatórias, tolerância numérica, regras de expressão regular ou se uma chamada de ferramenta usou argumentos aprovados.
As métricas baseadas em referência podem ajudar quando existe uma resposta conhecida, mas a similaridade de strings por si só costuma ser muito frágil para paráfrases válidas e muito tolerante com textos semanticamente incorretos que compartilham vocabulário.
O modelo LLM-as-a-judge é útil para critérios como completude, relevância, tom, fidelidade ou se uma resposta aberta satisfaz uma rubrica.
A avaliação aos pares é útil quando é mais fácil decidir se o candidato A ou a linha de base B é melhor do que atribuir uma pontuação absoluta significativa.
A revisão humana continua sendo importante para calibrar avaliadores automatizados, resolver casos subjetivos ou de alto risco e verificar se a própria métrica reflete o valor para o usuário.
A API Evals da OpenAI define uma avaliação como critérios de teste mais um esquema de fonte de dados e oferece suporte a avaliadores reutilizáveis. Sua API de avaliadores inclui verificações determinísticas de strings, avaliadores de similaridade de texto e avaliadores baseados em modelos; consulte a referência da API Evals da OpenAI e a referência dos avaliadores da OpenAI . O serviço de avaliação Gen AI do Google Cloud, Vertex AI, oferece suporte a métricas pontuais e em pares baseadas em modelos, bem como métricas baseadas em computação; seus resultados podem incluir pontuações por instância, explicações, médias agregadas, desvios padrão e taxas de acerto em pares. Consulte a documentação de resultados de avaliação do Vertex AI .
Utilize regras determinísticas sempre que possível, adicione juízes LLM baseados em rubricas para avaliar a qualidade semântica e mantenha a revisão humana disponível para calibração e casos mais complexos.
Quando essa abordagem se aplica: utilize verificações determinísticas para requisitos verificáveis por máquina, juízes LLM para qualidades semânticas e humanos quando a discordância tiver consequências significativas para os negócios ou para a segurança. Para um sistema RAG, o Ragas expõe métricas como precisão de contexto, recall de contexto, relevância da resposta e fidelidade, além de métricas de uso de agentes/ferramentas, incluindo precisão de chamadas de ferramentas e precisão de objetivos do agente. Consulte a documentação de métricas do Ragas . O DeepEval também fornece métricas específicas para tarefas e avaliação personalizada de juízes LLM, incluindo pontuação no estilo G-Eval; consulte a documentação de métricas do DeepEval .
3. Execute o mesmo conjunto de dados em relação a uma linha de base e a um candidato.
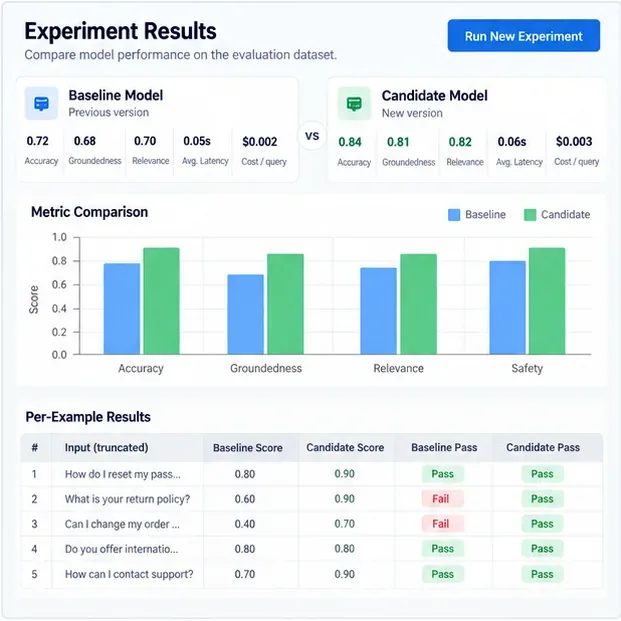
As pontuações absolutas são úteis, mas as decisões de lançamento geralmente são mais claras quando a nova configuração é testada em comparação com a versão em que você já confia. Mantenha o conjunto de dados, as definições do avaliador, os parâmetros do modelo e as configurações de amostragem o mais estáveis possível. Em seguida, compare os mesmos exemplos lado a lado.
Acompanhe pelo menos três níveis de resultados:
Pontuações por exemplo: Quais instruções específicas melhoraram ou pioraram?
Resultados por fatia: O desempenho mudou para perguntas de contexto longo, um idioma específico, casos difíceis, uma categoria de produto ou entradas adversárias?
Resultados agregados: O que aconteceu com a taxa de aprovação, a pontuação média, a latência, o uso de tokens, o custo e a contagem de falhas graves?
Para sistemas não determinísticos, repita os testes importantes vezes suficientes para entender a variabilidade, em vez de assumir que uma única execução representa o modelo. Se a decisão de lançamento for relevante, use comparações pareadas nos mesmos exemplos e relate a incerteza em vez de se basear apenas em uma pequena mudança na média.
O LangSmith oferece suporte a experimentos offline para comparação de versões e avaliadores aos pares, enquanto a atual pilha de avaliação GenAI do MLflow oferece suporte a conjuntos de dados de avaliação, avaliadores integrados e personalizados, juízes LLM, feedback humano, rastreamento e monitoramento de produção. Consulte Avaliação do LangSmith e Avaliação de Agentes e LLM do MLflow .
Compare um candidato com a linha de base atual nos mesmos exemplos e, em seguida, inspecione as métricas agregadas e os resultados de aprovação ou reprovação por exemplo.
Quando essa abordagem se aplica: sempre que você alterar um modelo, um prompt do sistema, um pipeline de recuperação, a implementação de uma ferramenta ou as configurações de decodificação. Um candidato não deve ser promovido simplesmente porque uma métrica agregada aumenta; ele deve atender aos limites de lançamento em dimensões críticas e evitar regressões inaceitáveis em nível de fatia.
4. Inspecione as falhas, calibre o juiz e transforme as regressões em novos testes.
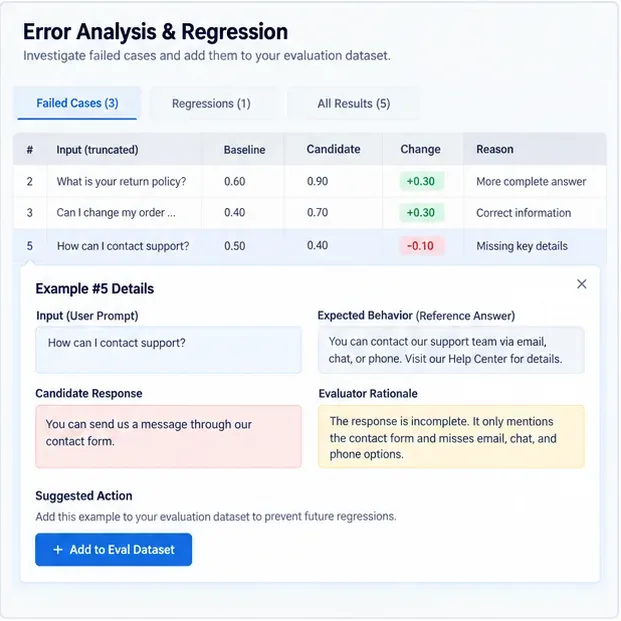
Uma avaliação só é valiosa se alterar suas próximas ações. Classifique as falhas por gravidade e causa raiz. Uma baixa pontuação de fundamentação pode ser resultado de uma recuperação de informações deficiente, um enunciado que incentiva o palpite, uma rubrica de avaliação muito vaga ou uma resposta de referência incorreta. Leia os exemplos subjacentes antes de alterar o modelo.
Em seguida, promova falhas importantes a casos de regressão permanentes. Isso cria um ciclo virtuoso: a produção revela uma falha, um humano a confirma, o caso é adicionado ao conjunto de dados offline, a correção é testada em todo o conjunto de testes e as versões futuras são impedidas de reintroduzir o mesmo problema.
Os juízes do LLM também precisam de avaliação. A documentação do Google descreve explicitamente a comparação das métricas geradas pelo modelo com avaliações humanas para determinar se o juiz é adequado para um caso de uso específico. O trabalho GDPval da OpenAI também utiliza a avaliação por pares de especialistas como padrão principal e descreve a avaliação automatizada como uma aproximação, e não como uma substituição, do julgamento de especialistas. Consulte as orientações da Vertex AI sobre como avaliar um modelo de juiz e a metodologia GDPval da OpenAI .
Analise os exemplos reais que falharam, confirme se o avaliador está julgando corretamente e adicione regressões importantes ao conjunto de testes permanente.
Quando essa abordagem se aplica: sempre que houver erros de alto impacto e quando um avaliador do LLM influenciar uma etapa de liberação. Se os revisores humanos discordarem repetidamente do avaliador, corrija a rubrica, forneça referências mais claras, altere o modelo de avaliação ou devolva esse critério à revisão humana.
Quão confiável é o LLM como juiz?
Os avaliadores do LLM são poderosos porque conseguem avaliar resultados abertos em uma escala que a revisão exclusivamente humana não consegue alcançar. A pesquisa original do G-Eval relatou uma correlação substancialmente melhor com o julgamento humano do que as métricas automáticas tradicionais no cenário de sumarização estudado. No entanto, o mesmo artigo alertou que os avaliadores do LLM podem favorecer o texto gerado pelo próprio LLM. Veja o artigo original do G-Eval .
Pesquisas independentes realizadas no MT-Bench e no Chatbot Arena constataram que juízes de LLM (Literatura Lidística Mista) de alto nível conseguem se alinhar bem às preferências humanas, ao mesmo tempo que documentam vieses relacionados à posição, verbosidade, autoengrandecimento e raciocínio. Veja o estudo original sobre LLM como juiz .
A conclusão prática não é "nunca use juízes LLM". É: calibre-os. Construa uma amostra rotulada por humanos, meça a concordância, inspecione as categorias de discordância, randomize ou troque a ordem das respostas em testes de comparação aos pares quando os efeitos de posição forem plausíveis e evite deixar que a mesma instrução vaga do juiz determine silenciosamente todas as decisões de liberação.
Qual framework de avaliação você deve escolher?
Estrutura
Melhor ajuste
Força notável
Avaliações e classificadores da OpenAI
Equipes que já utilizam APIs da OpenAI e desejam execuções de avaliação nativas da API
Definições de avaliação reutilizáveis com avaliadores determinísticos e baseados em modelos.
LangSmith
Aplicações de LLM que necessitam de rastreamento, conjuntos de dados, testes de regressão offline e avaliação online.
Forte comparação de experimentos e ciclo de feedback de produção
Ragas
Pipelines RAG e avaliação do uso de agentes/ferramentas
Métricas de recuperação, fidelidade, relevância e ferramentas desenvolvidas especificamente para esse fim.
Avaliação profunda
Equipes focadas em Python que desejam avaliações no estilo de testes e juízes LLM personalizáveis.
Catálogo abrangente de métricas, avaliação de componentes/ponta a ponta e métricas de trajetória de agentes.
Avaliação do MLflow GenAI
Equipes que já utilizam o MLflow ou que desejam vincular avaliações ao rastreamento e gerenciamento do ciclo de vida.
Conjuntos de dados, avaliadores, feedback humano, acompanhamento de experimentos e monitoramento de produção.
Avaliação de IA Gen da Vertex
Implantações do Google Cloud
Fluxos de trabalho de avaliação pontual, em pares, baseados em modelos e baseados em computação.
A escolha da estrutura importa menos do que o design da avaliação. Você pode construir um conjunto de avaliação fraco em uma plataforma sofisticada ou um robusto com alguns scripts. Dê preferência à ferramenta que torna seus testes reproduzíveis, versionados, fáceis de inspecionar e fáceis de executar antes de qualquer alteração significativa.
Um guia prático de lançamento
Para um assistente de produção, uma decisão de lançamento útil pode ser expressa como um conjunto de critérios em vez de uma pontuação combinada. Por exemplo, exigir zero falhas críticas de segurança no conjunto de segurança selecionado, nenhuma regressão estatisticamente significativa na correção da tarefa, uma taxa mínima de aprovação em questões RAG (Radio Attitudes, Generalidades e Possibilidades), saída estruturada válida em todos os casos de esquema e latência ou custo dentro do orçamento operacional. Os limites exatos devem ser definidos com base na tolerância ao risco e nos requisitos do usuário; não existe uma porcentagem universal que torne um LLM (Limite de Aprendizagem Baseado em Risco) "bom o suficiente".
Preserve também os exemplos brutos por trás da pontuação. Se uma versão passar de 0,84 para 0,86, você ainda precisa saber quais dois casos mudaram e se essas mudanças são relevantes. Na prática, as equipes aprendem mais com um pequeno número de falhas claramente categorizadas do que com uma média impressionante em um painel de controle, mas sem rastreabilidade.
Erros comuns de avaliação
Testar apenas os cenários ideais: adicionar ambiguidade, casos extremos, tentativas de injeção de código, contexto ausente e falhas históricas conhecidas.
Utilizando a correspondência exata para respostas abertas: reserve a correspondência exata para resultados onde a exatidão é realmente necessária.
Confiar na avaliação de um juiz com mestrado em Direito (LLM) sem calibração: compare com avaliações feitas por humanos e revise as divergências.
Otimizar a média enquanto se ocultam falhas graves: manter a segurança, as políticas e outras dimensões críticas como critérios explícitos.
Alterar o conjunto de dados durante uma comparação de modelos: congele o conjunto de comparação ou crie versões para que os resultados permaneçam interpretáveis.
Ignorando a deriva de produção: avaliações offline protegem as versões; avaliações online e revisões humanas amostradas revelam novos comportamentos do usuário e novos modos de falha.
Resumindo
Medir a qualidade da resposta do LLM é uma disciplina de engenharia, não uma simples verificação de impressões. Comece com um conjunto de dados representativo, defina dimensões de qualidade específicas para a tarefa, escolha verificações determinísticas sempre que o requisito puder ser computado, use avaliadores do LLM quando o julgamento semântico for necessário, calibre esses avaliadores com humanos e compare as mudanças candidatas com uma linha de base estável. Em seguida, transforme cada falha importante no mundo real em um futuro teste de regressão.
Seguindo esse ciclo, a estrutura de avaliação se torna mais do que um painel de relatórios: ela se transforma no sistema de controle de qualidade que informa se uma solicitação, modelo, alteração de recuperação ou atualização de agente realmente melhorou o produto.