Acasă
» domenii
»
Cum să configurezi o bază de cunoștințe AI locală privată pentru documente personale
Cum să configurezi o bază de cunoștințe AI locală privată pentru documente personale
Cel mai simplu răspuns practic: rulați modelul de limbaj, modelul de încorporare, indexul documentelor și interfața de chat pe propriul computer. O stivă simplă este Ollama pentru servirea locală a modelelor, plus AnythingLLM auto-găzduit pentru ingerarea documentelor, generarea augmentată de recuperare (RAG) și chat. Păstrați baza de date vectorială locală, utilizați stocare persistentă, evitați furnizorii de modele în cloud și testați dacă răspunsurile sunt într-adevăr bazate pe fișierele dvs.
Exemplu ilustrativ: în acest ghid, imaginați-vă că Jordan organizează o colecție privată ce include manuale de uz casnic, PDF-uri cu asigurări, note de ședință, o referință financiară personală și câteva rapoarte de proiect. Jordan este fictiv. Fișierele, întrebările, răspunsurile și rezultatele descrise mai jos sunt exemple pentru explicarea fluxului de lucru, nu rezultate ale testelor sau o mărturie.
Acest ghid folosește o configurație în patru pași, astfel încât limita de confidențialitate să rămână ușor de înțeles. Este potrivit pentru o singură persoană sau o gospodărie mică și de încredere care dorește căutare locală de documente și răspunsuri la întrebări. Dacă aveți nevoie de controale de identitate la nivel de întreprindere, disponibilitate pe mai multe noduri, audit centralizat sau garanții de reglementare, ar trebui să tratați aceasta ca pe o arhitectură de pornire, mai degrabă decât ca pe o soluție completă de conformitate.
Ce înseamnă de fapt „bază de cunoștințe AI locală privată”
O bază de cunoștințe locală nu este același lucru cu antrenarea unui model pe baza documentelor. Într-un flux de lucru RAG tipic, sistemul extrage text din fișiere, împarte textul în blocuri, convertește acele blocuri în încorporări numerice, le stochează într-o bază de date vectorială, preia blocurile relevante pentru fiecare întrebare și trimite doar acele blocuri către modelul lingvistic ca și context.
Documentația actuală a AnythingLLM descrie atât fluxurile de lucru pentru documente atașate, cât și pentru documente încorporate. Documentele atașate pot plasa text integral într-un chat atunci când fereastra contextuală permite, în timp ce RAG preia fragmente relevante mai mici din documentele încorporate. Documentația sa locală actuală LanceDB precizează, de asemenea, că LanceDB implicit pe instanță păstrează textul documentelor și încorporările în cadrul aplicației AnythingLLM. Consultați documentația fluxului de lucru pentru documente AnythingLLM și documentația AnythingLLM LanceDB .
Componentă
Rol în stiva locală
Opțiune sensibilă la confidențialitate
Ollama
Rulează modelul de chat și, opțional, un model de încorporare pe mașina dvs.
Folosește un model local, nu un endpoint de model găzduit în cloud
OriceLLM
Oferă interfața utilizator, gestionarea documentelor, segmentarea, RAG și organizarea spațiului de lucru
Rulați-l local și păstrați directorul său de stocare persistent
Model de încorporare
Transformă fragmentele de documente și interogările în vectori pentru regăsirea semantică
Folosește un embeder local dacă documentele nu trebuie trimise către un serviciu extern
LanceDB
Stochează vectorii utilizați pentru a găsi pasaje relevante
Păstrați instanța locală implicită, cu excepția cazului în care aveți nevoie intenționat de o bază de date la distanță
Fișiere originale și copii de rezervă
Rămâneți sursa autorizată
Protejați-le cu controale de acces normale ale sistemului de operare, criptare și copii de rezervă
Înainte de a începe: decideți limita de confidențialitate
Întrebarea cheie nu este „Este aplicația locală?”, ci „Ce componente pot trimite text de documente sau solicitări de pe mașină?”. O interfață cu utilizatorul locală poate fi configurată în continuare pentru a apela un LLM în cloud, o API de încorporare în cloud, căutare web sau instrumente la distanță. Pentru o configurare privată, păstrați LLM-ul, embedder-ul și baza de date vectorială locală, cu excepția cazului în care ați acceptat în mod deliberat implicațiile de partajare a datelor ale unui furnizor extern.
AnythingLLM documentează telemetria anonimă și oferă o modalitate de dezactivare a acesteia. Documentația sa privind confidențialitatea face, de asemenea, distincție între eliminarea unui document dintr-un spațiu de lucru și ștergerea acestuia din biblioteca de documente. Pentru ștergerea completă în cadrul AnythingLLM, documentația actuală prevede ștergerea documentului din Documentele mele , ceea ce elimină sursa analizată și încorporările din cache, precum și referințele la spațiul de lucru. Consultați documentația AnythingLLM privind confidențialitatea și gestionarea datelor înainte de a adăuga materiale sensibile.
De asemenea, aveți nevoie de suficientă memorie pentru modelul local ales. Nu există o singură dimensiune corectă a modelului, deoarece viteza utilizabilă depinde de CPU, GPU, RAM sau VRAM, cuantizare, lungimea contextului și numărul de documente recuperate. Începeți cu un model care se potrivește confortabil, în loc să alegeți cel mai mare model pe care mașina dvs. abia îl poate încărca.
Pasul 1: Instalați Ollama și pregătiți chat-ul local și modelele de încorporare
Instalați Ollama folosind instrucțiunile actuale pentru sistemul dvs. de operare. Ollama este disponibil pentru macOS, Windows și Linux, iar API-ul său local este servit pe portul 11434 în mod implicit. Ghidul oficial de pornire rapidă Ollama este cea mai bună sursă pentru instalarea actuală și sintaxa comenzilor.
După instalare, extrageți un model de chat care se potrivește hardware-ului dvs. Modelul exact nu este fixat în mod deliberat aici, deoarece catalogul de modele se modifică și cerințele hardware variază. O comandă tipică are această formă:
ollama pull <chat-model-name>
Pentru RAG, aveți nevoie și de un model de embedding. Documentația actuală de embeddings a Ollama, verificată în septembrie 2026, listează modele precum embeddinggemma, qwen3-embedding, și all-minilmca opțiuni de embedding recomandate. Puteți consulta lista actuală în documentația de embeddings Ollama . De exemplu:
ollama pull embeddinggemma
Nu utilizați un model de chat normal ca model de încorporare doar pentru că apare într-o listă derulantă de modele. Documentația actuală a instrumentului de încorporare Ollama de la AnythingLLM avertizează explicit că Ollama poate expune atât modele de chat, cât și modele de încorporare în aceeași listă. Utilizați un model de încorporare real pentru indexarea documentelor. Consultați configurarea instrumentului de încorporare AnythingLLM Ollama .
Flux de lucru ilustrativ în terminal pentru extragerea unui model local cu Ollama. Numărul versiunii vizibil în acest exemplu nu este o recomandare pentru versiunea curentă; verificați versiunea instalată cu documentația oficială Ollama.
Pentru configurația fictivă a lui Jordan, obiectivul în această etapă este simplu: atât generarea, cât și integrarea ar trebui să fie posibile fără a trimite documentele gospodăriei către o API la distanță.
Pasul 2: Rulați AnythingLLM local cu spațiu de stocare persistent și conectați-l la Ollama
AnythingLLM oferă opțiuni desktop și auto-găzduite. Acest ghid folosește ruta Docker deoarece limita de stocare este explicită și ușor de copiat de rezervă. Documentația sa locală actuală pentru Docker instruiește utilizatorii să extragă imaginea și subliniază faptul că este necesară stocarea persistentă, altfel datele aplicației se pot pierde atunci când containerul este recreat. De asemenea, se precizează că aplicația web este disponibilă la http://localhost:3001. Folosiți ghidul oficial local Docker de la AnythingLLM, în loc să copiați o comandă veche de pe un forum.
docker pull mintplexlabs/anythingllm:latest
Când rulați containerul, păstrați spațiul de stocare al AnythingLLM prin montarea unui director gazdă pe /app/server/storage. Documentația furnizorului solicită în mod specific montarea persistentă, după cum este necesar. Păstrați directorul de stocare respectiv pe un disc inclus în planul de backup.
Apoi configurați furnizorul LLM ca Ollama. Dacă AnythingLLM rulează direct pe gazdă, adresa Ollama implicită documentată este http://127.0.0.1:11434. Dacă AnythingLLM rulează în Docker în timp ce Ollama rulează pe gazdă, nu utilizați localhostdin interiorul containerului. Documentația de rețea Docker a AnythingLLM spune să se utilizeze http://host.docker.internal:11434pe platformele desktop acceptate; pe Linux, documentează 172.17.0.1acest model de conexiune gazdă. Consultați nota de rețea localhost a AnythingLLM și configurația Ollama LLM .
În setări, alegeți Ollama atât ca furnizor LLM, cât și, dacă doriți, ca furnizor de încorporare. Selectați modelul de chat pentru generare și modelul de încorporare pentru indexare. Păstrarea separată a acestor roluri previne o greșeală comună de configurare.
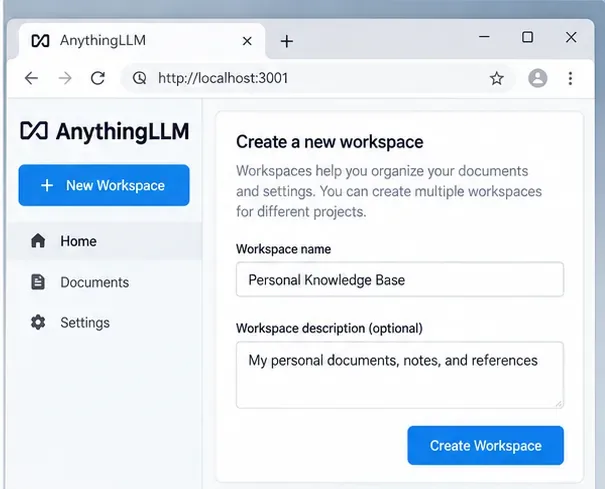
Este documentat că AnythingLLM, găzduit automat, rulează la localhost:3001. Un spațiu de lucru dedicat oferă unei colecții de documente un scop clar și împiedică materialele fără legătură să intre în pool-ul de recuperare.
Jordan creează un spațiu de lucru numit „Bază de cunoștințe personală” și evită conectarea furnizorilor de modele cloud. Acest lucru face ca granița dorită să fie ușor de auditat ulterior: interfață utilizator locală, LLM local, încorporări locale, vectori locali.
Pasul 3: Adăugați documente, alegeți atașament RAG versus atașament full-text și verificați ingerarea
Nu începeți prin a încărca întregul disc. Începeți cu un set mic și reprezentativ de documente al căror conținut îl cunoașteți bine. Acest lucru vă oferă o modalitate controlată de a detecta problemele de extragere sau recuperare înainte ca indexul să crească.
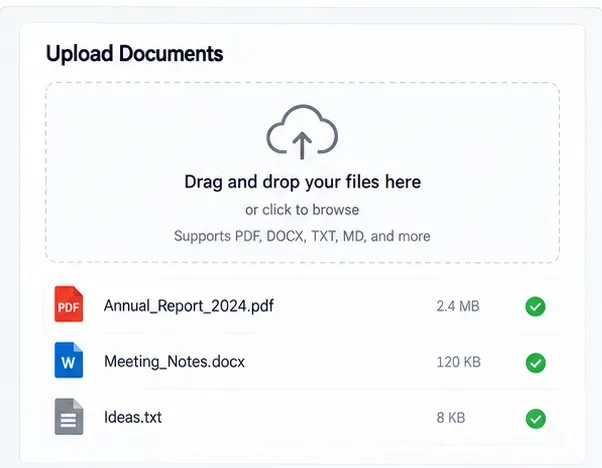
În exemplul lui Jordan, un prim lot util ar putea include un PDF cu funcție de căutare, un fișier DOCX și o notă text simplu sau Markdown. Dacă PDF-urile scanate conțin imagini în loc de text selectabil, confirmați că traseul ales pentru procesarea documentelor extrage într-adevăr textul necesar; un fișier care pare lizibil pentru dvs. poate produce în continuare o reprezentare text goală sau slabă pentru RAG.
AnythingLLM acceptă în prezent două comportamente generale pentru documente:
Documente atașate: utile atunci când textul integral se încadrează în fereastra contextuală a modelului și doriți ca modelul să vadă fișierul complet pentru firul de discuție respectiv.
Documente încorporate cu RAG: utile pentru colecții mai mari sau reutilizabile. Sistemul împarte conținutul în bucăți, îl încorporează și preia porțiunile relevante pentru o întrebare.
Ghidul actual pentru documente AnythingLLM menționează că documentele încorporate într-un spațiu de lucru devin disponibile în mai multe thread-uri din spațiul de lucru respectiv. Acest lucru este convenabil, dar înseamnă și că apartenența la spațiul de lucru face parte din modelul dvs. de confidențialitate în implementările cu mai mulți utilizatori. Păstrați spațiile de lucru personale separate de orice spațiu de lucru partajat.
Exemplu de vizualizare a ingerării cu mai multe tipuri de documente. Folosiți mai întâi un lot mic, cunoscut ca fiind valid, apoi verificați extragerea și indexarea înainte de a adăuga o arhivă mare.
După încorporare, adresați o întrebare al cărei răspuns apare într-un singur fișier. Apoi, solicitați un detaliu care nu apare în niciun fișier. Prima întrebare testează recuperarea datelor; a doua testează dacă modelul admite incertitudine în loc să inventeze un răspuns.
Ce să ajustezi dacă recuperarea este slabă
AnythingLLM expune controale RAG la nivel de spațiu de lucru, cum ar fi preferințele de căutare, numărul maxim de fragmente de context și pragul de similaritate al documentului. Documentația sa recomandă începerea cu setările spațiului de lucru, mai degrabă decât să se presupună că modelul de bază este problema. Creșterea contextului recuperat poate fi utilă atunci când răspunsul se întinde pe mai multe secțiuni, dar trimiterea unui număr prea mare de fragmente poate adăuga text irelevant și poate consuma capacitatea ferestrei de context.
Dacă modificați modelele de încorporare după indexare, reîncorporați documentele afectate astfel încât vectorii stocați și vectorii de interogare să provină din același spațiu de încorporare. Amestecarea încorporărilor din modele diferite nu este o strategie de recuperare semnificativă.
Pasul 4: Testați răspunsuri fundamentate, protejați confidențialitatea și faceți o copie de rezervă a bazei de cunoștințe
O bază de cunoștințe este utilă doar dacă poți detecta când este greșită. Construiește o mică listă de evaluare din fapte pe care le poți verifica direct. De exemplu:
Solicitați o dată, o sumă, un model de produs sau o clauză de politică care să apară ad litteram într-un singur document.
Pune o întrebare care să abordeze mai multe documente și care necesită informații din două fișiere.
Puneți o întrebare în mod deliberat fără răspuns și verificați dacă răspunsul nu fabrică o sursă.
Puneți aceeași întrebare cu o formulă diferită pentru a vedea dacă recuperarea este stabilă.
Deschideți documentul sursă și confirmați manual fiecare afirmație cu miză mare.
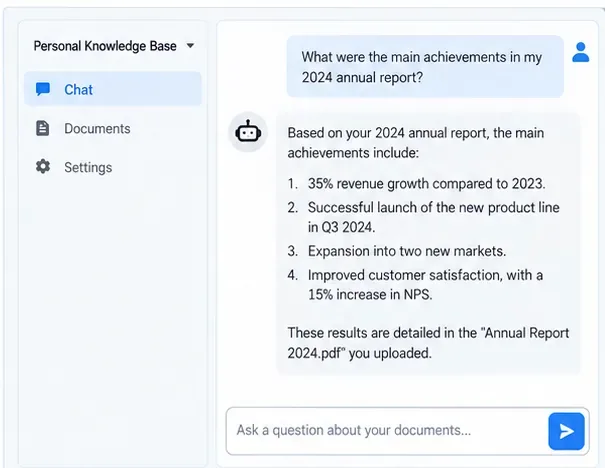
Răspuns ipotetic bazat pe documente, folosit pentru a ilustra etapa de verificare. Figurile afișate reprezintă exemple fictive de conținut; într-o bază de cunoștințe reală, verificați afirmațiile importante în raport cu fișierul original.
Pentru Jordan, o regulă bună de acceptare nu este „răspunsul sună corect”. Ci „răspunsul se potrivește cu sursa, include contextul necesar și eșuează în siguranță atunci când sursa nu conține informațiile”. Această regulă este importantă în special pentru impozite, asigurări, documente juridice, dosare medicale sau decizii financiare.
Păstrați configurarea privată după ce funcționează
Inferența locală reduce expunerea datelor, dar confidențialitatea depinde în continuare de configurație. Folosiți aceste controale ca o listă de verificare practică:
Păstrați serviciul AnythingLLM legat de mașina locală sau de o rețea privată de încredere, cu excepția cazului în care accesul la distanță este securizat intenționat.
Nu adăugați integrări Cloud LLM, încorporare în Cloud, căutare web, browser sau agenți într-un spațiu de lucru care conține materiale sensibile, decât dacă înțelegeți ce transmit aceste integrări.
Dezactivați telemetria anonimă dacă politica dvs. de confidențialitate nu impune nicio telemetrie a produsului.
Folosește criptarea discului și permisiunile contului tău de operare. O bază de date vectorială locală este în continuare o informație lizibilă dacă un atacator obține acces la mașină.
Ștergeți fișierele sensibile din biblioteca de documente, nu doar dintr-un singur spațiu de lucru, atunci când intenționați ștergerea completă în cadrul AnythingLLM.
Aplicați patch-uri pentru Ollama, AnythingLLM, Docker și sistemul de operare gazdă. „Offline” nu ar trebui să însemne „niciodată întreținut”.
Faceți o copie de rezervă a părților care sunt greu de recreat
Documentele originale rămân sursa ta de adevăr, dar directorul de stocare AnythingLLM conține baza de date a aplicației, documentele analizate, datele vectoriale și configurația necesară pentru a evita reconstruirea completă după o defecțiune a discului. Faceți o copie de rezervă atât a folderului documentelor originale, cât și a spațiului de stocare persistent al AnythingLLM. Dacă utilizați volume Docker în loc de un director gazdă montat prin bind, urmați documentația oficială Docker pentru backup și restaurarea volumelor .
Testează restaurarea, nu doar crearea unei copii de rezervă. O copie de rezervă este dovedită doar atunci când o poți restaura într-un alt director sau pe o altă mașină, poți porni stiva locală, poți deschide spațiul de lucru și poți recupera corect un fapt cunoscut.
Când această configurație este potrivită - și când nu este
Această arhitectură este potrivită atunci când prioritatea ta este păstrarea documentelor personale pe hardware-ul pe care îl controlezi, te simți confortabil să rulezi software local și dorești căutare semantică plus răspunsuri în limbaj natural într-o bibliotecă de documente modestă. De asemenea, este utilă atunci când accesul la internet este nesigur sau când dorești costuri locale previzibile după descărcarea modelelor.
Este mai puțin potrivit dacă computerul dvs. nu poate rula un model local adecvat, aveți nevoie de acces fără probleme de la mai multe dispozitive din afara rețelei de domiciliu sau aveți nevoie de identitate la nivel de întreprindere, audit, rețineri legale, gestionare centralizată a cheilor sau asistență garantată. În aceste cazuri, răspunsul corect poate fi o implementare privată gestionată sau o platformă RAG pentru întreprinderi, mai degrabă decât o configurație cu un singur PC.
O listă de verificare compactă pentru configurare
Instalați Ollama și verificați inferența modelului local.
Instalați un model de embedding dedicat, cum ar fi cel listat în documentația actuală de embedding a Ollamei.
Rulați AnythingLLM local cu spațiu de stocare persistent.
Conectați AnythingLLM la endpoint-ul local Ollama folosind adresa gazdă corectă pentru metoda dvs. de implementare.
Folosește o bază de date vectorială locală, cum ar fi LanceDB implicită a AnythingLLM, atunci când obiectivul este recuperarea documentelor doar local.
Creați un spațiu de lucru cu scop restrâns.
Începeți cu câteva documente cunoscute și verificați extragerea.
Folosiți RAG pentru colecții reutilizabile mari și atașamente full-text numai atunci când documentul se potrivește confortabil contextului modelului.
Testați întrebările la care se poate răspunde și cele fără răspuns înainte de a avea încredere în sistem.
Dezactivați integrările externe și telemetria inutile în funcție de cerințele dvs. de confidențialitate.
Faceți copii de rezervă atât pentru documentele sursă, cât și pentru spațiul de stocare persistent al aplicației, apoi testați o restaurare.