Acasă
» domenii
»
Cum să generezi automat titluri și descrieri meta SEO folosind Local Ollama
Cum să generezi automat titluri și descrieri meta SEO folosind Local Ollama
Ai 300 de pagini de produs, documentație sau blog gata de publicare, dar coloana de metadate este încă goală. Scrierea manuală a fiecărui titlu și metadescriere este lentă; copierea unui model pe site produce rezultate repetitive; iar solicitarea unui model lingvistic local pentru „un titlu SEO” returnează adesea comentarii suplimentare, afirmații inventate sau formatare inconsistentă.
O abordare mai bună este tratarea generării de metadate ca pe o mică rețea de date: oferiți modelului doar dovezi specifice paginii, solicitați ieșirea structurată, validați-o în cod, apoi revizuiți excepțiile înainte de publicare. Ollama este potrivit pentru acest flux de lucru deoarece API-ul său local este disponibil după http://localhost:11434/apiinstalare, iar Ollama acceptă ieșiri structurate în schemă JSON. Documentația Ollama și Google Search la care se face referire aici a fost verificată pe 13 septembrie 2026.
De ce metadatele SEO automate sunt greșite
Majoritatea eșecurilor provin din fluxul de lucru din jurul modelului, mai degrabă decât dintr-o singură „solicitare greșită”. Printre cauzele frecvente se numără alimentarea cu conținut prea mic pe pagină, permiterea modelului să răspundă în proză liberă, aplicarea aceleiași formule de cuvinte cheie pentru fiecare adresă URL și publicarea rezultatelor fără verificări ale duplicatelor la nivel de site.
Există, de asemenea, o concepție greșită persistentă despre limitele de caractere. Google afirmă că nu există o limită fixă de lungime pentru <title>elementul sau metadescrierea unei pagini; linkurile și fragmentele de titlu sunt trunchiate după cum este necesar, de obicei în funcție de lățimea dispozitivului. De asemenea, Google poate genera un link sau un fragment de titlu diferit din conținutul paginii atunci când sistemele sale consideră o altă reprezentare mai utilă. Consultați îndrumările oficiale Google pentru linkurile și fragmentele de titlu și metadescriere .
Asta înseamnă că un script poate impune limite de lungime editorială pentru consecvență, dar nu ar trebui să eticheteze aceste numere ca fiind cerințe Google. În exemplul de mai jos, 65 de caractere pentru titlu și 165 pentru descriere sunt doar bariere interne. Modificați-le pentru a se potrivi cu CMS-ul, brandul, nevoile de localizare și procesul de revizuire.
Pasul 1: Instalați Ollama și confirmați că API-ul local funcționează
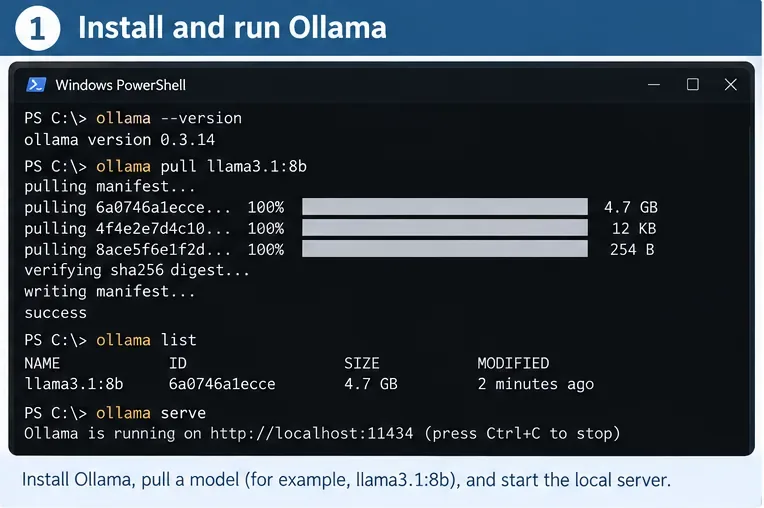
Ghidul oficial de pornire rapidă al Ollama listează suportul pentru macOS, Windows și Linux. După instalare, descărcați un model local. Documentația actuală a Ollama folosește frecvent gemma3exemple API, așa că este un exemplu neutru convenabil pentru acest tutorial:
ollama pull gemma3
Apoi testați endpoint-ul local:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
Documentația API-ului Ollama precizează că API-ul local este servit la http://localhost:11434/api. Ollama precizează, de asemenea, că accesul local la această adresă nu necesită autentificare. Dacă serviciul local nu rulează, ollama serveeste comanda CLI documentată pentru pornirea acestuia. Evitați înlocuirea unui -cloudmodel dacă obiectivul dvs. este cu adevărat inferența locală.
Un flux de lucru în terminal pentru etapa de configurare: verificarea Ollama, extragerea unui model local, confirmarea faptului că apare în lista de modele locale și asigurarea că serviciul este disponibil pe localhost. Numele modelului și cifrele de lungime afișate sunt exemple de valori ale fluxului de lucru, nu cerințe SEO.
Alegeți un model în funcție de hardware-ul dvs.
Acest articol nu susține în mod intenționat că un model este universal cel mai bun pentru metadatele SEO. Disponibilitatea modelului și compatibilitatea hardware-ului se schimbă în timp, iar modelele mai mari necesită mai multă memorie și, în general, răspund mai lent. Începeți cu un model pe care computerul dvs. îl poate rula confortabil, generați un set mic de recenzii, apoi comparați acuratețea factuală, unicitatea, latența și consistența înainte de a procesa mii de pagini.
Pasul 2: Forțați ieșirea structurată în loc să analizați proza
Textul în formă liberă este fragil pentru automatizare. Un răspuns precum „Iată trei opțiuni excelente…” obligă programul să ghicească unde începe titlul real. Documentația de ieșiri structurate a lui Ollama acceptă transmiterea unei scheme JSON în formatcâmp. Documentația recomandă, de asemenea, scheme reutilizabile prin Pydantic în Python și notează că o temperatură scăzută, cum ar fi 0, poate îmbunătăți determinismul.
Instalați cele două pachete Python folosite în acest exemplu:
python -m pip install -U ollama pydantic
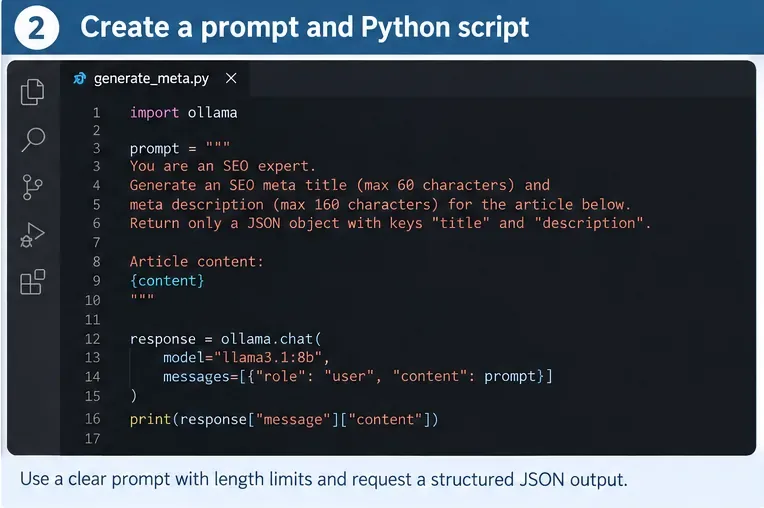
Apoi creați generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Generatorul ar trebui să fie explicit în ceea ce privește dovezile paginii, câmpurile de ieșire și constrângerile editoriale. În producție, este de preferat ieșirea structurată în schema JSON a lui Ollama și validarea din partea aplicației, în locul bazării exclusive pe formularea prompturilor.
De ce include promptul titlul curent și H1
Google spune că sistemul său titlu-link poate lua în considerare titlul vizual principal al paginii <title>, titlul vizual principal, titluri precum <h1>[ og:titletextul/subtitlul], textul proeminent, textul ancoră și alte semnale. Generatorul local nu trebuie să reproducă sistemul Google, dar furnizarea titlului sursă, a H1-ului, a adresei URL și a textului reprezentativ al corpului ajută la menținerea metadatelor propuse aliniate cu pagina pe care cititorii o vor vedea efectiv.
Nu alimentați liste de cuvinte cheie fără legătură și nu cereți modelului să le „încadreze”. Google recomandă în mod explicit titluri descriptive și concise și avertizează împotriva umplerii cu cuvinte cheie și a repetării descrierilor standard. Pentru descrieri, Google spune că generarea programatică specifică paginii este potrivită pentru site-urile mari, bazate pe baze de date, atunci când descrierile sunt precise, ușor de citit de către oameni și diverse.
Pasul 3: Rulați o pagină, apoi validați înainte de scalare
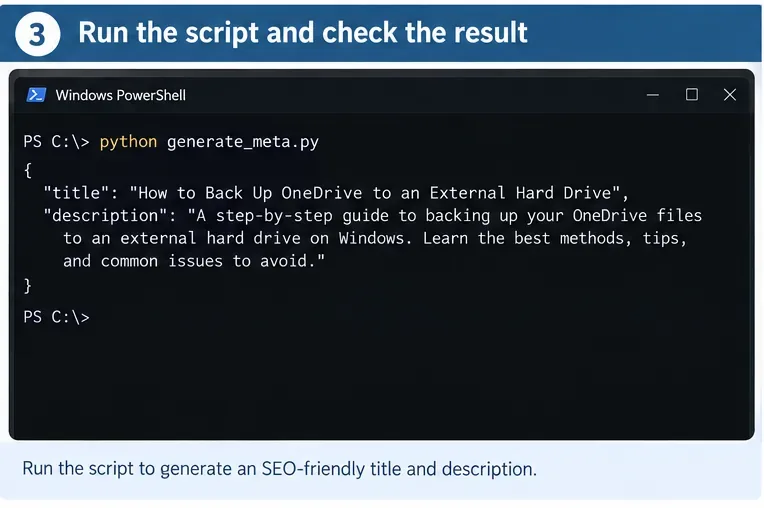
Rulați scriptul:
python generate_meta.py
Un rezultat pozitiv ar trebui să fie un obiect JSON pe care Pydantic îl poate valida. Mai important, un recenzent uman ar trebui să îl poată compara cu pagina sursă și să răspundă rapid la patru întrebări:
Titlul descrie exact această pagină și nu site-ul web în general?
Evită descrierea afirmațiile, datele, prețurile sau caracteristicile care lipsesc din conținutul sursă?
Ar mai avea sens aceste metadate dacă ar fi citite fără corpul paginii?
Este diferită de metadatele deja utilizate pe paginile din apropiere?
Testați mai întâi o pagină reprezentativă și inspectați rezultatul structurat înainte de a începe o lucrare în lot. Este necesar un răspuns JSON analizabil, dar acuratețea factuală și relevanța la nivel de pagină necesită în continuare validare.
Adăugați reîncercări pentru erori editoriale, nu doar pentru erori API
O schemă poate restricționa tipurile și lungimile de date, dar nu poate garanta că o propoziție este veridică sau suficient de specifică. Construiți o logică de reîncercare în jurul unor verificări pe care le puteți măsura. De exemplu, respingeți un câmp gol, un titlu duplicat, un formular standard interzis sau o descriere care repetă titlul aproape cuvânt cu cuvânt. Dacă pagina conține afirmații reglementate sau cu miză mare, solicitați o verificare umană, în loc să încercați să automatizați eliminarea încrederii.
Mențineți solicitările de reîncercare restrânse. În loc să regenerați totul cu „îmbunătățiți-l”, spuneți modelului ce a eșuat: „Titlul propus duplică o altă pagină. Rescrieți-l folosind subiectul unic din H1, păstrând în același timp fiecare afirmație bazată pe conținutul furnizat.” Acest lucru face ca eșecurile să fie mai ușor de auditat.
Pasul 4: Pagini în lot în format CSV pentru revizuire și publicare
După ce testul de o pagină este fiabil, stocați datele de intrare într-un fișier CSV cu coloane precum url, source_title, h1și content. Câmpul de conținut ar trebui să conțină text de pagină curățat, nu meniuri de navigare, notificări privind modulele cookie sau mii de linkuri de subsol fără legătură.
Adăugați această logică batch sub funcția generatorului sau plasați-o într-un script separat:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Fișierul CSV de ieșire poate fi revizuit în Excel, LibreOffice, un instrument de import al bazelor de date sau în fluxul de lucru CMS. Nu suprascrieți automat metadatele live la prima rulare. Păstrați titlul și descrierea originale alături de propunerea generată, astfel încât recenzorii să le poată compara și astfel revenirea la versiunea inițială să fie simplă.
O coadă de revizuire a foilor de calcul facilitează auditarea generării în bloc: păstrați identificatorul paginii sursă, titlul generat, descrierea generată, lungimile și semnalizatoarele de control al calității înainte de publicarea modificărilor.
Faceți canalul de batch mai sigur
Verifica
Ce să semnalezi
De ce contează
Validarea schemei
Câmpuri lipsă sau nevalide
Previne intrarea în CMS a ieșirilor incorecte.
Verificare titlu duplicat
Același titlu normalizat pe două adrese URL
Ajută la menținerea vizibilității paginilor.
Verificare lingvistică
Limba metadatelor diferă de limba paginii
Google recomandă potrivirea limbii principale și a sistemului de scriere al paginii.
Verificarea dovezilor
Numere, prețuri, date, mărci sau garanții absente din sursă
Reduce afirmațiile halucinate.
Verificare standard
Expresii lungi, repetate pe întregul site
Google recomandă evitarea repetului titlurilor șablonizate.
Verificarea lungimii editoriale
În afara intervalului de case ales de dvs.
Menține consecvența rezultatului CMS; aceasta nu este o regulă Google privind limita de caractere.
Recenzie umană
Pagini strategice, sensibile, cu trafic intens sau ambigue
Automatizarea ar trebui să scoată la iveală excepțiile, nu să le ascundă.
Probleme comune, de la cea mai ușoară la cea mai dificilă soluție
Conexiunea API eșuează
Mai întâi confirmați că Ollama rulează și că http://localhost:11434este accesibil. Documentația oficială de autentificare precizează că autentificarea nu este necesară pentru API-ul local. Dacă scriptul dvs. indică accidental către https://ollama.com/api, acesta este un alt endpoint găzduit și necesită autentificare.
Răspunsul conține proză în jurul codului JSON
Folosește schema direct format=SeoMeta.model_json_schema()în loc să ceri JSON doar în limbaj natural. Ieșirea structurată este stratul de control potrivit pentru o conductă de producție.
Toate titlurile sună la fel
Introduceți text H1 specific paginii și conținut semnificativ, eliminați zgomotul de navigare globală și solicitați explicit o descriere specifică paginii. Apoi, rulați o verificare a duplicatelor și similarității pe mai multe pagini. Repetiția este adesea o problemă de introducere a datelor înainte de a fi o problemă de model.
Modelul inventează caracteristici sau statistici
Reduceți introducerea la text autorizat al paginii și consolidați regula fundamentală: nicio afirmație factuală dincolo de conținutul furnizat. Pentru paginile importante, comparați afirmațiile generate cu câmpurile structurate ale sursei înainte de aprobare. Dacă sursa în sine este ambiguă, trimiteți rândul pentru revizuire umană în loc să solicitați în mod repetat modelului să ghicească.
Modelul este prea lent pentru mii de pagini
Măsurați înainte de a schimba arhitectura. Înregistrați timpul de generare per pagină, dimensiunea datelor de intrare, numele modelului și rata de eșec. Trunchiați textul irelevant, procesați secțiunile stabile ale paginii și testați un model local mai mic dacă calitatea rămâne acceptabilă. Cel mai rapid model nu este util dacă metadatele sale generează mai multă muncă de revizuire decât economisește.
Opțional: utilizați o integrare existentă în stil OpenAI
Dacă aveți deja cod scris pentru un client compatibil cu OpenAI, Ollama documentează compatibilitatea parțială cu API-ul OpenAI la http://localhost:11434/v1/. Acest lucru poate reduce munca de migrare. Pentru un nou instrument de metadate doar local, clientul nativ Ollama Python este mai simplu și expune exemple cu ieșire structurată direct în documentația Ollama.
Cum să autoverificați sistemul finalizat
Înainte de a finaliza automatizarea, creați un set de recenzii care să conțină diferite tipuri de conținut: un articol scurt, un ghid lung, o pagină de produs, o pagină de categorie, o pagină cu numere și o pagină în fiecare limbă acceptată. Rulați același model și aceeași solicitare în toate, apoi verificați următoarea listă de verificare.
Punctul final local este localhostși modelul selectat este un model local, nu un model etichetat în cloud.
Fiecare răspuns este validat în funcție de schemă fără curățare manuală JSON.
Niciun titlu generat nu este duplicat în setul de recenzii.
Fiecare afirmație factuală apare în conținutul paginii furnizate.
Metadatele folosesc aceeași limbă principală și același sistem de scriere ca și pagina.
Titlul este descriptiv și concis, fără cuvinte cheie repetitive.
Descrierea rezumă pagina specifică, nu site-ul în ansamblu.
Limitele de lungime internă sunt etichetate drept reguli editoriale, nu cerințe Google.
Metadatele vechi, propunerea generată, semnalizatoarele QA, numele modelului și versiunea solicitării sunt salvate pentru audit și revenire la versiunea anterioară.
Un recenzent știe ce semnalizări necesită aprobare manuală înainte de publicare.
În cele din urmă, rețineți ce poate și ce nu poate controla automatizarea. O <title>metadescriere bună oferă motoarelor de căutare semnale utile la nivel de pagină, dar Google poate genera link-uri de titlu și fragmente din alt conținut al paginii. Prin urmare, scopul nu este de a forța o anumită randare a rezultatelor căutării. Scopul este de a produce metadate precise, distincte și utile la scară largă, păstrând în același timp suficiente validări și revizuiri pentru a detecta greșelile înainte ca acestea să ajungă în producție.