Acasă
» domenii
»
Cum să reduci timpul de randare în ComfyUI pentru un flux de lucru SDXL
Cum să reduci timpul de randare în ComfyUI pentru un flux de lucru SDXL
Cea mai rapidă metodă de a reduce timpul de randare într-un flux de lucru ComfyUI SDXL este de obicei reducerea volumului de lucru pentru difuzie înainte de a modifica semnalizatoarele de lansare de nivel scăzut: testarea la o rezoluție SDXL rezonabilă, menținerea dimensiunii lotului la 1 în timpul ajustării, utilizarea mai puținilor pași de eșantionare atunci când calitatea se menține și ocolirea temporară a elementelor suplimentare costisitoare, cum ar fi rafinăriile, ramificațiile ControlNet, pasele de upscaling sau preprocesoarele. Abia după aceea ar trebui să ajustați VRAM, atenția, previzualizarea și comportamentul memoriei cache.
Această ordine este importantă deoarece semnalizările de pornire nu pot compensa un flux de lucru care pur și simplu solicită GPU-ului să facă de două sau trei ori mai multă muncă decât este necesar. Documentația actuală ComfyUI recomandă, de asemenea, reducerea rezoluției sau a dimensiunii lotului mai întâi atunci când generarea este lentă, apoi utilizarea optimizărilor de memorie și atenție, după cum este necesar. Îndrumările de mai jos au fost verificate în raport cu documentația actuală ComfyUI și PyTorch la 13 septembrie 2026.
De ce fluxurile de lucru SDXL devin lente în ComfyUI
O randare SDXL poate petrece timp în mai multe locuri diferite: încărcarea sau mutarea ponderilor modelului, codificarea textului CLIP, eliminarea repetată a zgomotului în KSampler, ControlNet sau alte condiționări, decodificarea VAE, upscaling și orice etapă de rafinare sau de a doua trecere. Dacă VRAM-ul este limitat, transferurile suplimentare de la CPU la GPU pot adăuga și mai multă latență.
Asta înseamnă că doi utilizatori cu același GPU pot vedea timpi de randare foarte diferiți. Un grafic text-imagine de bază, de clasă 1024, nu este comparabil cu un flux de lucru care adaugă un rafinator, două ControlNet-uri, o a doua trecere de înaltă rezoluție și un lot mare. Scopul este de a identifica ce parte a graficului este costisitoare, apoi de a elimina sau optimiza acea parte fără a sacrifica calitatea rezultatului care vă interesează cu adevărat.
1. Măsurați o linie de bază curată înainte de a schimba orice
Folosește un prompt fix, o valoare inițială fixă, dimensiunea lotului 1 și aceeași rezoluție de ieșire. Rulează fluxul de lucru de cel puțin două ori. Prima rulare poate include încărcarea punctelor de control, compilare, I/O pe disc sau transferuri de model; o rulare ulterioară este o măsură mai bună a vitezei de generare în stare stabilă.
De asemenea, verificați dacă GPU-ul chiar își face treaba. Pe sistemele NVIDIA, nvidia-smipoate afișa utilizarea VRAM și utilizarea GPU-ului. Dacă utilizarea GPU-ului rămâne scăzută în timp ce sistemul mută constant date sau încarcă modele, blocajul poate fi presiunea memoriei sau I/O, mai degrabă decât eșantionatorul în sine.
Verificați comportamentul GPU și VRAM înainte de a regla ComfyUI. Tratați valorile afișate aici ca un exemplu de aspect, nu ca un obiectiv de referință.
2. Începeți de la cel mai mic grafic SDXL care produce rezultatul de care aveți nevoie
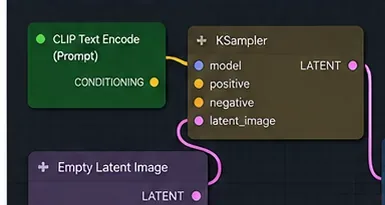
Înainte de a optimiza un flux de lucru complex, comparați-l cu o cale minimală: încărcarea punctului de control, condiționarea prompturilor, o imagine latentă goală, KSampler, decodare VAE și salvarea imaginii. Exemplele oficiale ComfyUI arată că punctul de control de bază SDXL poate fi utilizat ca un punct de control obișnuit. Dacă acest grafic de bază este rapid, dar graficul de producție este lent, ramificațiile suplimentare sunt problema.
Pentru schițare, ocoliți temporar componentele care nu sunt esențiale pentru decizia curentă. Exemplele includ un rafinator, o a doua trecere de upscaling, preprocesoare de imagine, mai multe ControlNet-uri sau ramificații de stil opționale. Reactivați-le pe rând după ce imaginea de bază este acceptabilă.
Un grafic SDXL mic este cea mai bună bază. Adăugați ramuri costisitoare numai după ce știți cât timp costă fiecare.
3. Reduceți pașii din KSampler înainte de a căuta setări de viteză exotice
Pașii de eșantionare sunt una dintre cele mai clare pârghii, deoarece fiecare pas suplimentar de eliminare a zgomotului adaugă efort. Dacă reduceți pașii de la o valoare mai mare la una mai mică, porțiunea de eșantionare a randării ar trebui să devină mai scurtă, deși timpul total de eșantionare nu va scădea exact cu același procent, deoarece încărcarea modelului, codificarea prompturilor, decodificarea VAE și alte noduri necesită în continuare timp.
Nu copiați un număr universal de pași „cel mai bun” de la altcineva. Numărul corect depinde de punctul de control, eșantionator, planificator, prompt, CFG și ținta de calitate. O metodă practică este să păstrați semințele fixe și să testați o scară mică - de exemplu, setarea curentă, apoi o reducere modestă, apoi o altă reducere. Opriți-vă când texturile, anatomia, tipografia sau fidelitatea promptului se degradează mai mult decât sunteți dispus să acceptați.
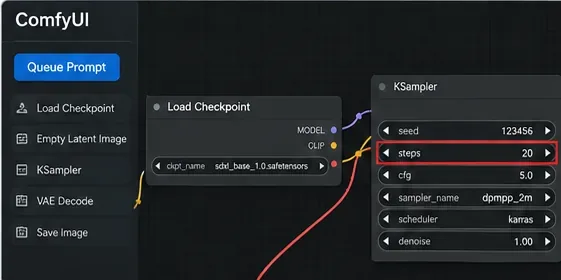
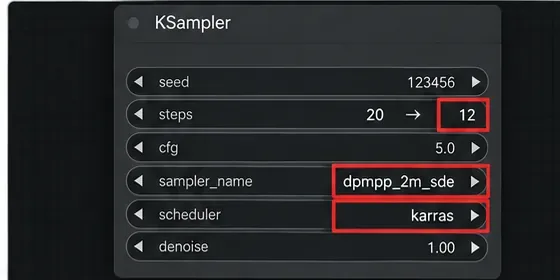
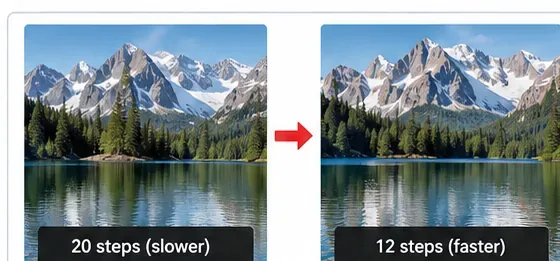
Reducerea pașilor KSampler poate reduce timpul de eliminare a zgomotului. Valorile afișate sunt ilustrative; verificați calitatea cu propriul punct de control și valoarea inițială fixă.
4. Mențineți rezoluția testului și dimensiunea lotului sub control
Pentru SDXL, exemplele oficiale SDXL ale ComfyUI recomandă 1024×1024 sau alte raporturi de aspect cu aproximativ același număr de pixeli, cum ar fi 896×1152 sau 1536×640, pentru un comportament optim al modelului de bază. Depășirea substanțială a acestui buget de pixeli crește dimensiunea latentă și, prin urmare, utilizarea de calcul și memorie.
În timpul ajustării prompturilor și a fluxului de lucru, mențineți valoarea batch_sizela 1, cu excepția cazului în care aveți nevoie în mod specific de testare a randamentului. Un lot de patru solicită canalului să producă patru imagini într-o singură execuție; acest lucru poate îmbunătăți randamentul în unele configurații, dar nu este modalitatea de a minimiza timpul până la prima imagine și crește cerințele de memorie.
Dacă rezultatul final trebuie să fie mai mare decât rezoluția de bază normală a SDXL, luați în considerare separarea „testării compoziției” de trecerea finală de înaltă rezoluție. Obțineți mai întâi promptul, semințele, condiționarea și compoziția corecte, apoi plătiți pentru upgrade-ul costisitor sau a doua trecere doar pentru candidații selectați.
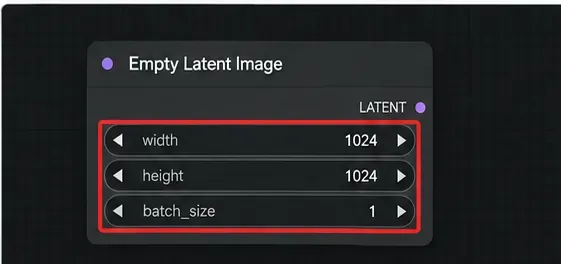
O imagine latentă de clasă 1024 cu dimensiunea lotului 1 este o bază de reglare SDXL sensibilă înainte de rulările cu rezoluție mai mare sau cu imagini multiple.
5. Evaluează eșantionatoarele și programatoarele în loc să presupui că unul este întotdeauna cel mai rapid
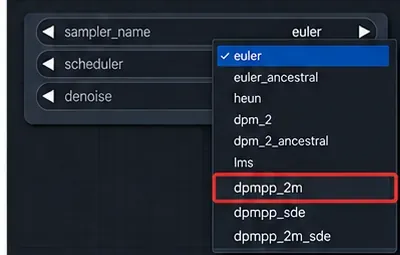
ComfyUI oferă multiple opțiuni de eșantionare și planificare în KSampler. Diferite combinații pot atinge o calitate acceptabilă în diferite etape, așadar „cel mai rapid” ar trebui să însemne cel mai rapid la calitatea de care aveți nevoie , nu doar cea mai scurtă rulare individuală.
Folosește același punct de control, prompt, valoare inițială, rezoluție și CFG atunci când compari. Schimbă doar samplerul sau planificatorul, apoi compară atât timpul de randare, cât și calitatea vizibilă. Dacă o combinație necesită mult mai puțini pași pentru punctul de control, păstrând în același timp rezultatul dorit, este un câștig real de viteză. Dacă necesită pași suplimentari pentru a recupera detaliile, avantajul aparent poate dispărea.
Schimbați câte o variabilă de eșantionare pe rând și comparați la o valoare inițială fixă. Nu presupuneți că un eșantionator este mai rapid pentru fiecare punct de control SDXL sau țintă de calitate.
6. Eliminați munca redundantă pe grafuri și folosiți modelul de execuție ComfyUI în avantajul dumneavoastră
ComfyUI este conceput să execute doar părțile graficului care trebuie rulate. Documentația proiectului său precizează că porțiunile nemodificate pot fi reutilizate între execuții, iar backend-ul curent include o memorie cache configurabilă pentru rezultatele nodurilor. Acest lucru este util atunci când modificați doar o valoare din aval, în loc să reconstruiți întregul flux de lucru.
Mențineți nodurile de încărcare și procesarea costisitoare din amonte stabile, atunci când este posibil. Dacă schimbați constant punctele de control, redimensionați imagini mari în mod repetat sau invalidați nodurile din amonte, pierdeți beneficiul muncii memorate în cache.
ComfyUI are și o funcție documentată de execuție parțială care poate rula doar partea unui flux de lucru necesară pentru un nod de ieșire selectat. Folosește-o atunci când testezi o ramură din aval și nu ai nevoie ca fiecare ieșire dintr-un grafic mare să fie regenerată.
Un grafic simplificat face ca blocajele să fie mai ușor de observat. Folosește memoria cache și execuția parțială, astfel încât munca nemodificată din amonte să nu fie repetată inutil.
7. Reglați previzualizările, memoria cache, modul VRAM și atenția numai după ce graficul este eficient
Opțiunile actuale din linia de comandă ComfyUI expun mai multe controale de performanță. Efectele lor depind de hardware și de memoria disponibilă, așadar tratați-le ca pe niște candidați de referință, mai degrabă decât ca pe niște comutatoare obligatorii.
Setare
Când poate ajuta
Compromisul principal
--preview-method none
Dacă previzualizările eșantionatorului au fost activate și vă interesează doar rezultatul final
Pierzi previzualizările latente live. Interfața CLI actuală nu folosește deja previzualizări în mod implicit.
--highvram
Dacă aveți suficientă memorie VRAM și descărcarea/reîncărcarea repetată a modelului costă timp
Păstrează modelele în memoria GPU și poate cauza erori de memorie insuficientă pe plăcile mai compacte.
--lowvram
Dacă fluxul de lucru nu se încadrează în VRAM
Acesta este în principal un mod de economisire a memoriei, nu un mod de viteză; utilizarea procesorului sau transferurile pot crește latența.
--use-pytorch-cross-attention
Merită testat comparativ combinațiile moderne PyTorch/GPU
Nu combinați orbește semnalizatoare de mod de atenție care se exclud reciproc.
--use-flash-attention
Merită testat atunci când stiva hardware/software acceptă calea optimizată
Disponibilitatea și beneficiile depind de intrările și kernelurile acceptate.
--cache-classicsau--cache-lru N
Fluxuri de lucru repetate în care memoria cache suplimentară este acceptabilă
Se poate folosi mai multă memorie RAM/VRAM.
--cache-none
Numai atunci când reducerea memoriei cache este mai importantă decât viteza
Interfața CLI proprie a ComfyUI spune că fiecare nod se va executa pentru fiecare rulare, deci de obicei este mai rău pentru timpul de randare.
Interfața CLI actuală expune și descărcarea asincronă a greutății, iar textul său de ajutor precizează că este activată în mod implicit pe NVIDIA. Aceasta înseamnă că adăugarea mai multor semnalizatoare nu este automat o optimizare; verificați mai întâi comanda de lansare curentă și jurnalele.
Atenția scalată prin produs scalar din PyTorch poate selecta automat implementări CUDA optimizate, cum ar fi FlashAttention sau atenția eficientă din punct de vedere al memoriei, atunci când intrările și hardware-ul permit acest lucru. Acesta este motivul pentru care căile moderne de atenție pot conta, dar câștigul exact depinde de hardware. Evitați să citați un procent generic ca și cum s-ar aplica fluxului de lucru SDXL.
8. Mențineți comportamentul cozii și al lotului aliniat cu obiectivul dvs.
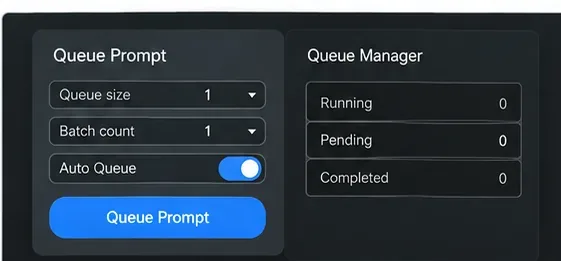
Dacă prioritatea ta este cea mai rapidă buclă de feedback, pune în coadă câte o imagine pe rând în timpul optimizării. Numărul mare de imagini în coadă și loturile sunt utile atunci când știi deja setările și dorești randament, dar acestea nu fac ca prima imagine să ajungă mai repede.
Odată ce fluxul de lucru este finalizat, puteți evalua separat randamentul. În acel moment, un lot mai mare ar putea avea sens dacă VRAM o permite și dacă numărul total de imagini pe minut contează mai mult decât latența per imagine.
Folosește o imagine în coadă și dimensiunea lotului 1 pentru reglarea interactivă; testează loturi mai mari ulterior, când obiectivul este debitul.
Cum să știi dacă optimizarea a funcționat cu adevărat
O rulare mai rapidă este utilă doar dacă imaginea corespunde în continuare obiectivului dorit. Comparați înainte și după cu aceeași valoare inițială și aceeași solicitare. Verificați zonele care eșuează primele atunci când setările sunt prea agresive: text mic, mâini și fețe, modele repetitive, materiale fine, detalii ale marginilor și respectarea atributelor specifice solicitării.
Înregistrați cel puțin aceste patru elemente pentru fiecare test: timpul total de execuție, pașii de eșantionare, rezoluția și dacă a avut loc încărcarea modelului. Dacă prima rulare durează 30 de secunde, iar a doua durează 12 secunde, nu creditați automat o modificare a eșantionatorului - prima rulare ar fi putut pur și simplu să acopere costul încărcării punctului de control.
Folosiți comparații alăturate cu semințe fixe pentru a decide dacă este acceptabil un număr mai mic de pași. Etichetele din imagine ilustrează metoda și nu reprezintă rezultate de referință.
O comandă practică de optimizare
Evaluează o rulare încălzită. Păstrează valorile inițiale, prompt, rezoluție și lot fixe.
Eliminați ramificațiile inutile. Testați calea SDXL de bază fără rafinare, ControlNet, upscaling sau preprocesoare opționale.
Reduceți numărul de pași. Găsiți cel mai mic număr de pași care încă îndeplinește standardul de calitate.
Mențineți rezoluția la un nivel rezonabil. Reglați în jurul bugetului de pixeli de clasa 1024 al SDXL înainte de finisarea la rezoluție înaltă.
Păstrează lotul la 1 în timpul iterării. Optimizează randamentul numai după ce fluxul de lucru este stabil.
Comparați opțiunile de eșantionare/planificare. Evaluați viteza la o calitate acceptabilă echivalentă.
Folosește memoria cache și execuția parțială. Evită reluarea lucrărilor din amonte nemodificate.
Apoi, semnalizatoarele de lansare a testelor de testare. Previzualizarea testului, VRAM, memoria cache și atenționarea se modifică pe rând.
Când ar trebui să schimbi strategia în loc să optimizezi mai intens
Dacă un flux de lucru SDXL durează prea mult după aceste modificări, verificați ce face de fapt lucrarea. Un grafic de producție multi-ControlNet, rafinare plus upscale, poate fi pur și simplu proiectat să necesite multă putere de calcul. În acel moment, aveți trei opțiuni corecte: acceptați randarea mai lungă pentru imaginile finale, utilizați un flux de lucru de tip draft mai simplu pentru iterație sau mutați volumul de lucru pe hardware mai rapid.
În mod similar, dacă rămâneți constant fără memorie VRAM, forțarea unui mod rezident GPU „mai rapid” este soluția greșită. Execuția stabilă în gestionarea dinamică a memoriei implicită sau într-o configurație cu memorie VRAM mai mică este mai bună decât erorile repetate de memorie insuficientă. Setările de economisire a memoriei pot crește timpul de randare, dar o randare mai lentă și reușită este totuși mai utilă decât o blocare rapidă.