Acasă
» domenii
»
Cum să remediați eroarea „Fereastra contextuală depășită” în analiza documentelor lungi fără a pierde dovezi cheie
Cum să remediați eroarea „Fereastra contextuală depășită” în analiza documentelor lungi fără a pierde dovezi cheie
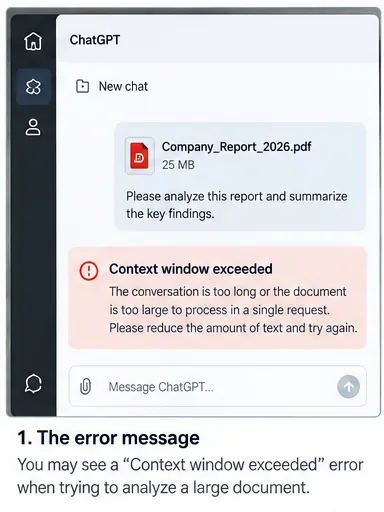
Încarci un raport lung, soliciți o analiză amănunțită și, în loc de răspuns, primești un mesaj precum „Fereastra de context a fost depășită”, „lungimea maximă a contextului a fost depășită” sau un alt avertisment că solicitarea este prea mare. Partea frustrantă este că fișierul s-ar fi putut încărca cu succes și că același document ar fi putut funcționa chiar și pentru o întrebare mai restrânsă.
Motivul este simplu, dar ușor de trecut cu vederea: o limită de încărcare și fereastra contextuală a unui model nu sunt același lucru. Un model trebuie să încadreze materialul pe care îl analizează în mod activ într-un buget finit de jetoane. Acest buget poate include instrucțiunile dvs., istoricul conversațiilor, textul extras din fișiere, definițiile instrumentelor, pasajele recuperate, jetoanele de raționament și spațiul pentru răspuns. Prin urmare, un document poate fi legal pentru încărcare, dar totuși prea mare pentru a fi analizat dintr-o singură trecere.
Cea mai bună soluție este, de obicei, să nu reîncerci aceeași solicitare gigantică. Începe cu cele mai puțin perturbatoare modificări, apoi treci la fragmentare, recuperare sau la un flux de lucru cu context mai larg doar dacă abordarea mai simplă tot eșuează.
Mai întâi, confirmați că eroarea este într-adevăr o problemă a ferestrei contextuale
Înainte de a modifica documentul, distingeți o eroare de context de o limită de încărcare sau stocare. Ghidul actual OpenAI privind încărcarea fișierelor precizează că fișierele încărcate în ChatGPT sau într-un GPT au o limită fixă de 512 MB per fișier, în timp ce fișierele text și documente sunt limitate la 2 milioane de token-uri per fișier. Acestea sunt limite de încărcare, nu o promisiune că tot textul respectiv va fi plasat simultan în contextul activ al unui model.
Întrebările frecvente despre încărcarea fișierelor de la OpenAI sunt locul autorizat pentru a verifica limitele actuale de încărcare. Limitele exacte variază în funcție de produs, plan, model și furnizor, așa că nu presupuneți că un număr copiat dintr-un articol vechi este încă valabil.
Ceea ce vezi
Probabil blocaj
Cea mai bună primă mișcare
Fișierul este respins înainte de începerea analizei
Dimensiunea fișierului, tipul fișierului, spațiul de stocare sau cota de încărcare
Verificați regulile actuale de încărcare
Fișierul se încarcă, dar o solicitare lungă eșuează și afișează o eroare de context.
Cererea activă depășește bugetul contextual al modelului
Scurtați solicitarea și reduceți contextul activ
Răspunsul acoperă primele pagini, dar omite secțiunile ulterioare.
Nu tot materialul a fost plasat direct în context sau nu s-au recuperat pasaje relevante.
Puneți întrebări mai specifice sau împărțiți-le pe secțiuni
O conversație a funcționat anterior, dar eșuează după mai multe runde.
Istoricul acumulat al chatului consumă context
Începeți un nou fir de analiză cu un rezumat compact al predării
O eroare de tip fereastră contextuală poate apărea după ce un document este încărcat cu succes, deoarece solicitarea activă trebuie să se încadreze în bugetul de tokenuri al modelului.
Pasul 1: Măsurați documentul înainte de a-l modifica
Numărul de pagini și megaocteții sunt indicii utile, dar tokenurile sunt măsura care contează pentru contextul textului. Tokenizarea depinde de limbă, formatare, punctuație și codificarea modelului, astfel încât un manual tehnic de 100 de pagini poate consuma un număr foarte diferit de tokenuri față de un pachet de diapozitive de 100 de pagini.
Ghidul OpenAI privind numărarea token-urilor recomandă verificarea ferestrei contextuale a modelului țintă și lăsarea de spațiu pentru ieșire și, pentru modelele de raționament, pentru token-uri de raționament. De asemenea, se menționează că structura mesajelor, instrumentele, fișierele, imaginile și schemele pot adăuga token-uri dincolo de textul simplu pe care îl numărați.
Pentru o triere rapidă, înregistrați numărul de pagini al fișierului, numărul aproximativ de cuvinte, numărul de secțiuni principale și dacă acesta conține anexe, limbaj juridic repetitiv, jurnale brute, transcrieri, tabele sau referințe de care nu aveți nevoie pentru această sarcină.
Verificați dimensiunea documentului înainte de a depana problema. Dimensiunea fișierului și numărul de pagini sunt doar indicatori indirecti; utilizarea token-urilor este limita mai relevantă pentru analiza textului.
Pasul 2: Reduceți conversația activă înainte de a atinge fișierul
Dacă documentul nu este extraordinar de mare, cea mai ieftină soluție ar putea fi eliminarea contextului acumulat, în loc să divizați fișierul. Începeți o nouă conversație sau o nouă solicitare și transmiteți doar instrucțiunile care contează. Înlocuiți o conversație lungă și schimbătoare de informații cu o scurtă transmitere, cum ar fi: „Analizați raportul atașat pentru factorii determinanți ai veniturilor, riscurile semnificative și îndrumările manageriale. Returnați cinci constatări cu referințe la pagină sau secțiune.”
De asemenea, eliminați materialele de fundal repetate, exemplele care nu mai sunt necesare, textul lipit duplicat și rezultatele anterioare în versiune preliminară. Dacă utilizați un flux de lucru API, luați în considerare solicitarea completă, nu doar documentul. O solicitare care abia se încadrează lasă puțin loc pentru răspuns și poate eșua în mod imprevizibil pe măsură ce instrucțiunile sau schemele instrumentelor cresc.
Semn de succes: același fișier funcționează într-un fir de execuție nou cu un prompt focalizat. Dacă da, problema a fost cel puțin parțial contextul acumulat, nu documentul în sine.
Pasul 3: Restrângeți întrebarea și rezultatul solicitat
„Analizează totul în acest document de 400 de pagini și scrie un raport cuprinzător” obligă sistemul să ia în considerare mai multe subiecte simultan. Pune, în schimb, câte o întrebare pe rând. De exemplu, solicită mai întâi principalele riscuri ale documentului, apoi ipotezele sale financiare, apoi contradicțiile dintre afirmațiile conducerii și datele justificative.
Păstrați formatul răspunsului limitat. O solicitare pentru un rezultat de 20 de pagini consumă un buget de rezultat mult mai mare decât o solicitare pentru un tabel de dovezi cu 10 rânduri. Puteți oricând extinde răspunsul final după ce dovezile au fost colectate.
O sugestie utilă și specifică este: „Folosind doar acest document, identificați până la opt afirmații relevante pentru ratarea clienților. Pentru fiecare afirmație, furnizați referința secțiunii sau a paginii, o explicație de o propoziție și orice limitare menționată. Dacă documentul nu conține suficiente dovezi, precizați acest lucru.”
Când să treci mai departe: dacă o întrebare specifică produce în continuare aceeași eroare sau dacă ai nevoie de o acoperire fiabilă a întregului document, mai degrabă decât a unui singur subiect, separă sursa.
Pasul 4: Împărțiți documentul după semnificație, nu doar după numărul egal de pagini
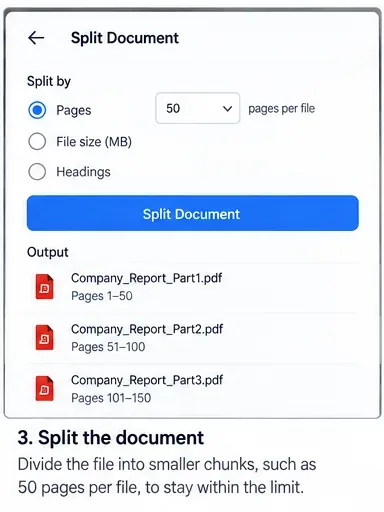
Împărțirea în bucăți este cea mai fiabilă soluție generală pentru documentele foarte lungi. Împărțiți fișierul la limite naturale, cum ar fi capitole, secțiuni de raport, contracte, anexe, intervale de date sau rânduri de vorbitori. Bucățile logice păstrează contextul mai bine decât tăieturile arbitrare la fiecare 50 de pagini.
Dacă o secțiune depinde foarte mult de cea anterioară, includeți o mică suprapunere sau o scurtă notă de legătură care să descrie secțiunea precedentă. Denumiți părțile clar, de exemplu 01_Executive_Summary.pdf, 02_Financial_Results.pdf, și 03_Risk_Factors.pdf. Păstrați numerele de pagină originale atunci când este posibil, astfel încât sinteza finală să poată fi auditată.
Împărțiți o sursă foarte lungă în secțiuni logice, denumite clar. Păstrați referințele originale la pagina sau secțiune, astfel încât sinteza ulterioară să poată fi verificată în raport cu sursa.
Pasul 5: Analizați fiecare fragment cu aceeași schemă de dovezi
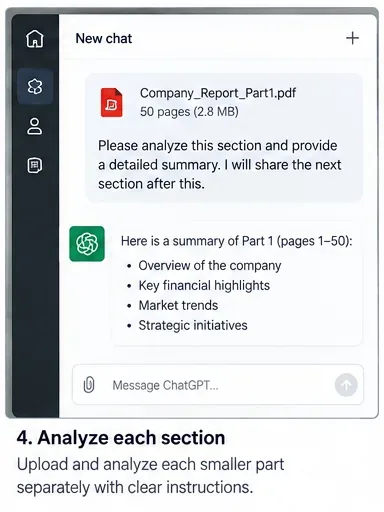
Nu solicitați doar un rezumat liber al fiecărei părți. Folosiți aceeași structură pentru fiecare segment, astfel încât rezultatele să poată fi îmbinate fără a pierde diferențele importante. O schemă practică ar putea conține numele secțiunii, concluziile cheie, dovezile justificative, referința la pagină sau titlu, incertitudinile și întrebările deschise.
De exemplu: „Analizați doar Partea 3. Returnați: (1) cinci sau mai puține constatări semnificative, (2) dovezile pentru fiecare constatare, (3) pagina sau referința secțiunii originale, (4) orice avertizare enunțată de autor și (5) întrebări care trebuie verificate într-o altă secțiune. Nu deduceți fapte care nu se află în această parte.”
Această abordare facilitează, de asemenea, evaluarea calității. Dacă un rezumat al unui fragment conține afirmații fără locații sursă, corectați fragmentul respectiv înainte de a continua, în loc să sperați că sinteza finală îl va repara.
Analizați câte o secțiune pe rând, cu un format de ieșire fix, astfel încât fiecare rezultat parțial să poată fi ulterior combinat și urmărit până la sursă.
Pasul 6: Creați un rezumat al rezumatelor în loc să reîncărcați fiecare fragment complet
După ce părțile sunt analizate, creați un pachet compact de dovezi din rezultatele fragmentelor și sintetizați-le. Nu trimiteți automat fiecare fragment original plus fiecare rezumat înapoi într-o singură cerere finală; aceasta poate recrea aceeași problemă de context.
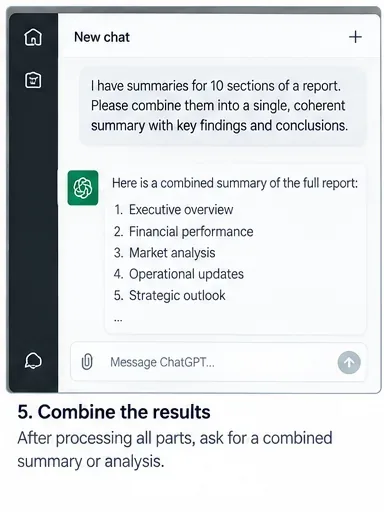
Promptul de sinteză ar trebui să îi spună modelului să păstreze dezacordurile și lacunele. De exemplu: „Combinați aceste analize de secțiune într-un singur raport. Fuzionați constatările duplicate, păstrați dovezile contradictorii ca puncte separate, păstrați toate referințele sursă și semnalați orice întrebare care nu poate fi rezolvată din rezumate.”
Această metodă ierarhică este utilă în special pentru cărți, documente depuse la autoritățile de reglementare, seturi de descoperiri, colecții lungi de interviuri și cercetarea mai multor documente. Principala sa limitare este compresia informațiilor: detaliile omise în timpul unui rezumat fragmentar nu pot reapărea în mod magic ulterior. De aceea, schema dovezilor și referințele surselor sunt importante.
Combinați analize compacte ale secțiunilor în loc să reîncărcați întregul text sursă. Păstrați citările, dezacordurile și întrebările nerezolvate în timpul sintezei.
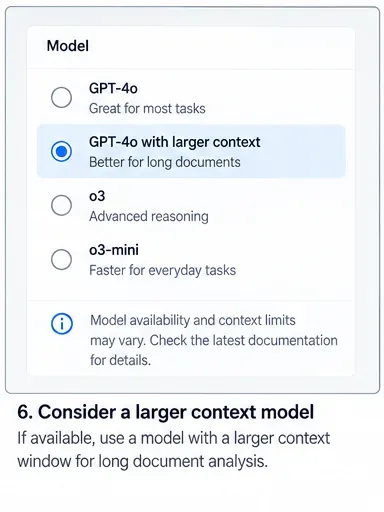
Pasul 7: Luați în considerare un model cu context mai larg, dar nu îl tratați ca o soluție completă
Un model cu o fereastră de context mai mare poate reduce agresivitatea procesului de segmentare. Documentația actuală a modelului OpenAI listează limitele ferestrei de context și ale randamentului maxim pentru modelele API, iar aceste cifre se pot modifica pe măsură ce modelele sunt actualizate.
Totuși, dimensiunea contextului titlului unui model nu este neapărat cantitatea de fișier încărcat pe care un produs o plasează direct în prompt. Ghidul OpenAI specific pentru întreprinderi descrie în prezent un proces separat de „umplere cu context” pentru documentele text încărcate: până la 110.000 de jetoane din documentele încărcate pot fi plasate direct în context, cu materiale suplimentare disponibile prin intermediul unui index de căutare privat. OpenAI precizează în mod explicit că acest comportament este în curs de dezvoltare activă și poate fi modificat. Consultați Optimizarea încărcărilor de fișiere în ChatGPT Enterprise .
Lecția practică este să alegem un model cu context mai larg atunci când simplifică semnificativ fluxul de lucru, dar să testăm totuși dacă secțiunile relevante sunt într-adevăr luate în considerare. Contextul mai larg nu elimină necesitatea unei bune definiții a domeniului de aplicare, a referințelor la surse sau a verificării.
Un model cu context mai larg poate fi de ajutor, dar verificați limitele pentru modelul exact și suprafața produsului pe care le utilizați, în loc să vă bazați pe un număr generic.
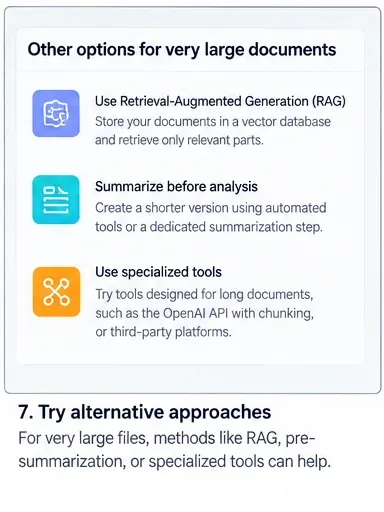
Pasul 8: Pentru corpusuri foarte mari, treceți de la „a completa totul” la recuperare
Dacă sarcina implică sute sau mii de pagini, regăsirea informațiilor este de obicei o arhitectură mai bună decât încercarea de a încadra întregul corpus într-o singură solicitare. Sistemele de regăsire indexează sursa, caută pasaje relevante pentru întrebarea curentă și plasează doar acele pasaje în context activ.
Documentația OpenAI File Search descrie un instrument găzduit pentru căutarea fișierelor încărcate prin intermediul depozitelor vectoriale. Recuperarea funcționează deosebit de bine pentru întrebări specifice, cum ar fi „Ce secțiuni definesc terminarea pentru comoditate?” sau „Unde se discută raportul concentrarea lanțului de aprovizionare?”
Recuperarea este mai puțin fiabilă atunci când sarcina necesită într-adevăr conștientizarea simultană a fiecărui pasaj, cum ar fi demonstrarea faptului că un subiect nu apare niciodată, compararea fiecărei celule dintr-un tabel dintr-o colecție masivă sau producerea unei transformări exhaustive linie cu linie. În aceste cazuri, utilizați procesarea sistematică în loturi sau preprocesarea bazată pe cod, pe lângă recuperare.
Pentru corpusurile care rămân prea mari după segmentare, recuperarea poate aduce doar pasajele cele mai relevante în contextul activ pentru fiecare întrebare.
Corecție API avansată: controlează trunchierea în mod deliberat
Dezvoltatorii care utilizează API-ul OpenAI Responses au o opțiune suplimentară. Referința API documentează o truncationsetare: cu disabled, care este valoarea implicită documentată, o solicitare care ar depăși fereastra de context a modelului eșuează; cu auto, elementele conversației anterioare pot fi eliminate pentru a face solicitarea potrivită. Consultați referința API-ului Responses .
Trunchierea automată poate preveni o eroare majoră, dar modifică informațiile disponibile modelului. Pentru analiza documentelor, eliminarea silențioasă a contextului timpuriu poate fi mai rea decât primirea unei erori. Folosiți-o numai atunci când aplicația dvs. este proiectată astfel încât elementele de conversație mai vechi să poată fi eliminate sau să fie deja rezumate în altă parte.
Cum să verifici dacă remedierea a funcționat efectiv
O solicitare reușită nu este suficientă. Scopul este o analiză justificabilă care acoperă materialul corect fără a pierde în mod silențios dovezi. Testați rezultatul înainte de a considera problema rezolvată.
Verificarea acoperirii: confirmați că fiecare capitol, interval de date sau fișier sursă necesar apare în planul de analiză sau în tabelul final de dovezi.
Verificarea trasabilității: eșantionați revendicările importante și verificați referințele paginii, secțiunii sau fișierului acestora în raport cu sursa originală.
Verificarea limitelor: inspectarea constatărilor din apropierea limitelor segmentelor pentru a vă asigura că un concept nu a fost divizat sau contrazis între părți.
Verificare cu control negativ: puneți o întrebare al cărei răspuns este cunoscut ca fiind absent. Un flux de lucru bun ar trebui să precizeze că dovezile nu sunt prezente, în loc să le inventeze.
Verificarea repetabilității: repetarea câtorva întrebări reprezentative. Modificările mari ale dovezilor citate pot indica o recuperare slabă sau o solicitare prea generală.
Verificarea bugetului: dacă utilizați o API, inspectați utilizarea efectivă a tokenurilor de intrare și ieșire, în loc să vă bazați doar pe estimări aproximative ale numărului de cuvinte.
Pasul final este verificarea: verificați acoperirea, referințele sursă, limitele fragmentelor și afirmațiile neacceptate înainte de a avea încredere în analiza combinată.
Ce să nu faci
Nu retrimiteți în mod repetat aceeași solicitare supradimensionată și nu vă așteptați la o limită diferită de tokenuri. Nu ștergeți referințele sursă în timpul segmentării. Nu presupuneți că acceptarea unui fișier înseamnă că fiecare pagină este activă în context. Și nu rezolvați eroarea scurtând răspunsul atât de agresiv încât analiza să nu mai poată satisface sarcina.
De asemenea, evitați tratarea trunchierii automate ca pe o magie invizibilă. Dacă sistemul elimină elemente mai vechi, solicitarea poate reuși, pierzând în același timp instrucțiuni sau dovezi importante. Pentru analize cu miză mare, segmentarea explicită și recuperarea sunt de obicei mai ușor de auditat.
O regulă practică de decizie
Dacă un fir de discuție nou și o întrebare mai restrânsă funcționează, mențineți fluxul de lucru simplu. Dacă sarcina necesită o acoperire largă a unui document lung, împărțiți-l în secțiuni logice și sintetizați analize structurate pe blocuri. Dacă interogați în mod repetat o colecție foarte mare de documente, utilizați recuperarea datelor. Dacă controlați API-ul și totuși vă apropiați de limită, măsurați token-urile, rezervați spațiu de ieșire, selectați un model adecvat și faceți din comportamentul de trunchiere o decizie explicită de proiectare.
Cel mai puternic rezultat nu este cel care înghesuie cel mai mult text într-o singură cerere. Este cel care acoperă dovezile necesare, păstrează trasabilitatea și face evident când informațiile nu erau disponibile.