Acasă
» domenii
»
Cum să creezi GPT-uri personalizate care nu își uită fișierele de cunoștințe
Cum să creezi GPT-uri personalizate care nu își uită fișierele de cunoștințe
Stare actuală, verificată pe 13 septembrie 2026: OpenAI spune că nu se pot crea sau publica noi GPT-uri pentru conturile ChatGPT personale, inclusiv Free, Go, Plus și Pro. GPT-urile existente pot fi în continuare utilizate și, acolo unde sunt eligibile, editate. În spațiile de lucru Business, Enterprise și Edu, crearea depinde de setările și permisiunile spațiului de lucru. OpenAI spune, de asemenea, că fluxurile de lucru GPT personalizate sunt mutate către Plugin-uri, cu un flux de migrare planificat pentru 17 septembrie 2026 și retragerea planificată pentru GPT-urile Enterprise afectate pe 11 decembrie 2026. Dacă veți citi acest text mai târziu, verificați cea mai recentă stare din documentația OpenAI privind crearea și editarea GPT-urilor înainte de a construi un nou flux de lucru.
Un GPT personalizat care pare să „uite” un fișier de cunoștințe, de obicei, nu l-a pierdut. Întrebările frecvente despre încărcarea fișierelor de la OpenAI precizează că fișierele încărcate ca cunoștințe GPT sunt păstrate până când GPT-ul personalizat este șters. Problema mai frecventă este recuperarea: modelul nu citește neapărat fiecare fișier încărcat în întregime pentru fiecare întrebare. Acesta recuperează materialul care pare relevant pentru solicitare, astfel încât calitatea sursei, structura fișierului, instrucțiunile și testarea afectează dacă este identificat pasajul corect.
De asemenea, separați „cunoștințele” de „memorie”. GPT-urile OpenAI din documentația ChatGPT precizează că GPT-urile nu utilizează memoria salvată, instrucțiunile personalizate sau conversațiile anterioare; fiecare conversație începe de la zero. Prin urmare, cunoștințele încărcate sunt o sursă de referință configurată, nu memorie conversațională care se acumulează din chat-urile anterioare.
Cum ar trebui să arate un rezultat fiabil
Scopul nu este de a forța un GPT să menționeze un fișier de fiecare dată. Scopul este de a face ca răspunsurile dependente de sursă să fie în mod constant bazate pe materialul corect, făcând în același timp ca întrebările nejustificate să eșueze în siguranță, în loc să producă o presupunere sigură.
Semnal de calitate
Cum arată „binele”
Când să modificați configurația
Corectitudine
Răspunsul corespunde fișierului autorizat pentru întrebarea testată.
Dacă răspunsul este greșit, în ciuda faptului că este prezent, simplificați sursa sau restrângeți întrebarea.
Împământare
GPT poate denumi fișierul sau secțiunea justificativă atunci când i se solicită.
Dacă răspunsul se bazează în schimb pe cunoștințe generale, consolidați instrucțiunile de prioritate a sursei și retestați.
Abţinere
Când fișierele nu conțin răspunsul, GPT-ul specifică acest lucru clar.
Dacă inventează o politică, un preț, o dată sau o procedură, adăugați o regulă explicită care interzice ghicirea.
Consistență
Formulările echivalente produc răspunsuri în mod material consecvente.
Dacă modificările minore de formulare cauzează abateri majore, reduceți ambiguitatea atât în fișiere, cât și în instrucțiuni.
Integritatea actualizării
După o revizuire a sursei, aceleași întrebări de evaluare reflectă noul conținut.
Dacă răspunsurile vechi persistă, verificați dacă fișierul actualizat este atașat, salvați GPT-ul și rulați din nou testele.
Opt pași pentru a face utilizarea fișierelor de cunoștințe mai fiabilă
1. Confirmați că în contul sau spațiul dvs. de lucru puteți crea sau edita în continuare GPT-ul
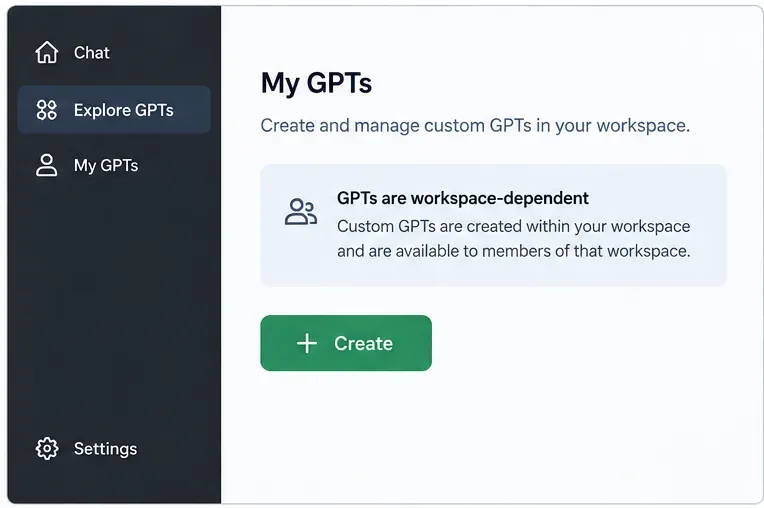
Începeți cu eligibilitatea, deoarece lipsa butonului „Creare” ar putea fi acum un comportament așteptat, mai degrabă decât o problemă a browserului. Ghidul actual OpenAI pentru GPT-uri în ChatGPT precizează că crearea de noi GPT-uri nu este disponibilă pentru conturile personale. Spațiile de lucru gestionate pot expune în continuare crearea de GPT-uri pe baza politicii de administrator și a permisiunilor de rol. Dacă dețineți deja un GPT existent, verificați dacă editarea este încă disponibilă pentru contul dvs.
În spațiile de lucru gestionate eligibile, începeți din zona GPT; disponibilitatea depinde de permisiunile spațiului de lucru.
Nu pierdeți timp depanând problemele de recuperare a cunoștințelor până când nu știți că lucrați într-un editor compatibil. Dacă organizația dvs. trece deja la pluginuri, tratați GPT-ul personalizat rămas ca pe un candidat pentru migrare, mai degrabă decât ca pe o nouă dependență pe termen lung.
2. Separați instrucțiunile de comportament de cunoștințe
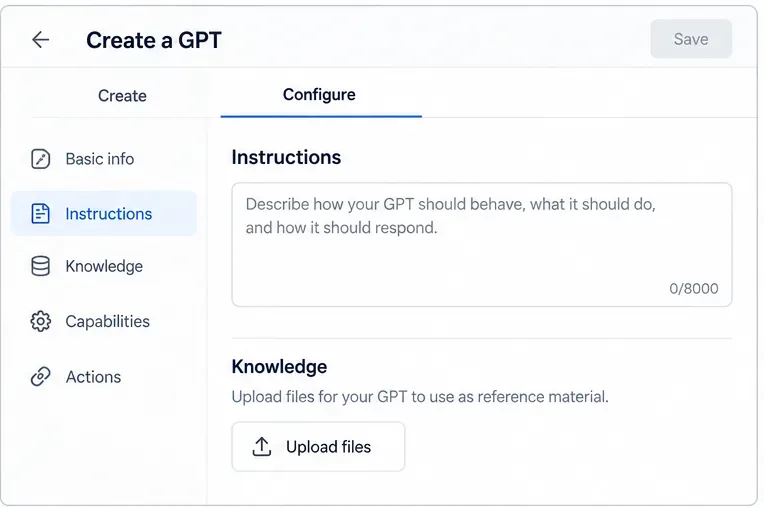
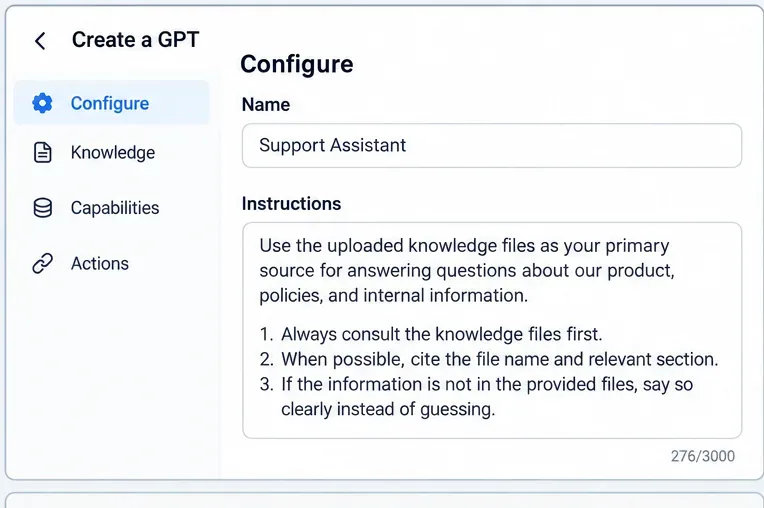
Folosește câmpul Instrucțiuni pentru reguli precum tonul, ordinea deciziilor, formatul citărilor, comportamentul de escalare și ce ar trebui să facă GPT-ul atunci când o sursă este silențioasă. Folosește câmpul Cunoștințe pentru materiale de referință: manuale, documentație de produs, politici, întrebări frecvente, specificații sau ghiduri interne. OpenAI recomandă în mod explicit această separare, deoarece cunoștințele funcționează cel mai bine ca material sursă, în timp ce instrucțiunile definesc comportamentul.
Păstrați regulile de comportament în Instrucțiuni și consultați materialele din Cunoștințe.
Această distincție este importantă pentru fiabilitate. O propoziție precum „Nu citați niciodată un preț expirat” își are locul în Instrucțiuni. Tabelul de prețuri propriu-zis își are locul în Cunoștințe. Combinarea regulilor într-un PDF de referință mare face ca comportamentul să fie mai greu de controlat și mai greu de testat.
3. Pregătiți fișierele pentru recuperare, nu doar pentru citire de către oameni
Preferați fișiere clare, cu text înainte, cu titluri descriptive, secțiuni scurte, terminologie stabilă și date de versiune clare. O broșură frumos concepută poate fi mai slabă decât un simplu fișier Markdown sau text dacă informațiile esențiale sunt răspândite pe coloane, explicații, capturi de ecran sau machete decorative.
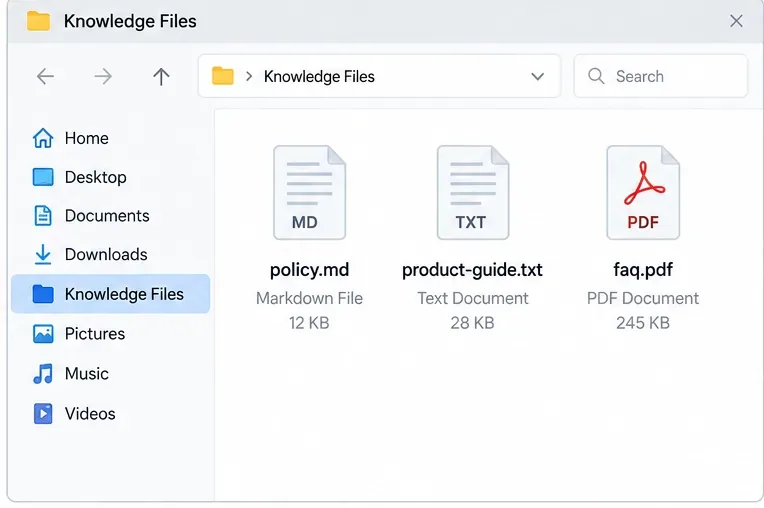
Fișierele text-forward cu nume clare și structură simplă sunt mai ușor de recuperat în mod fiabil.
Acest lucru este deosebit de important pentru fișierele PDF. Întrebările frecvente despre recuperarea vizuală cu fișiere PDF de la OpenAI precizează că fișierele PDF încărcate ca GPT Knowledge sunt procesate cu recuperare doar text. Cu alte cuvinte, o diagramă, o diagramă sau o captură de ecran din interiorul fișierului PDF nu ar trebui să fie singurul loc în care există o regulă critică. Adăugați o explicație text sau un fișier însoțitor bazat pe text.
De asemenea, eliminați duplicatele învechite. Dacă un fișier indică o fereastră de returnare de 14 zile, iar altul indică 30 de zile, recuperarea poate scoate la iveală oricare dintre pasaje. Numele de fișiere, cum ar fi returns-policy-2026-09.md și textul vizibil „data intrării în vigoare”, facilitează auditarea versiunilor.
4. Încărcați un set de cunoștințe mic și coerent și verificați-l
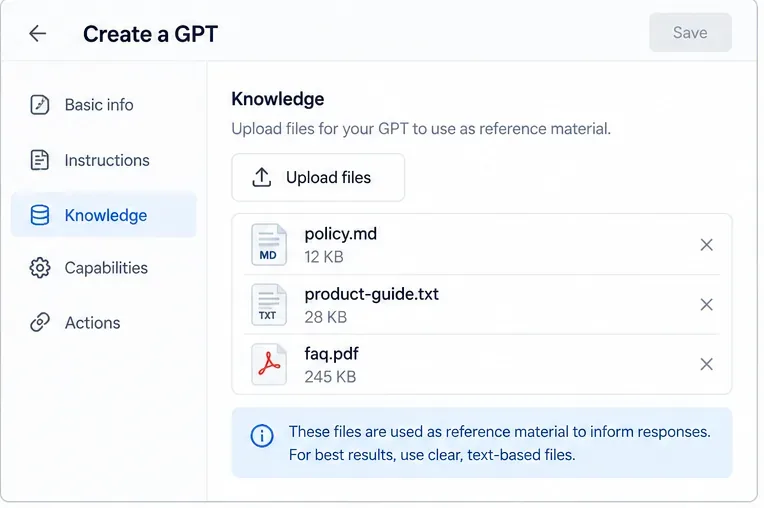
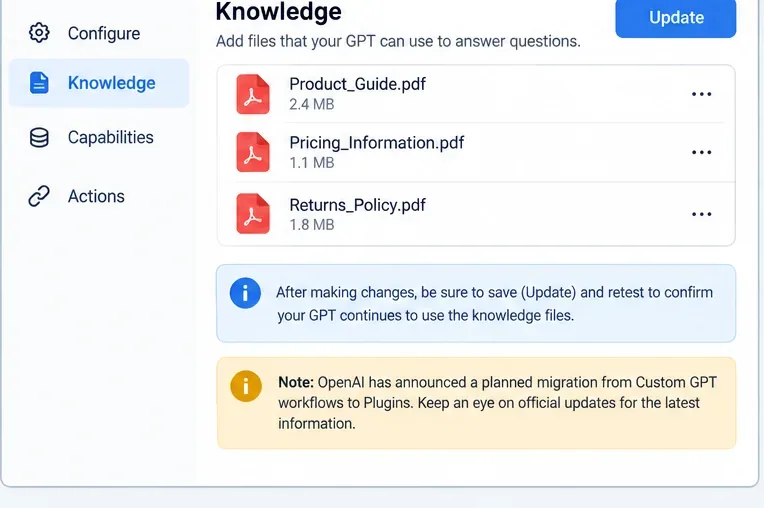
Încărcați doar fișierele de care GPT are nevoie efectiv. Ghidul OpenAI pentru fișiere la nivel de întreprindere menționează că, în general, mai puține documente și mai specifice îmbunătățesc precizia regăsirii bazate pe fișiere. După încărcare, confirmați că fiecare fișier așteptat apare în lista de cunoștințe înainte de a continua.
Încărcați setul de referințe, apoi verificați dacă apare fiecare fișier așteptat înainte de testare.
În prezent, există o inconsecvență în documentație privind numărul de fișiere. Ghidul editorului GPT precizează că puteți atașa până la 20 de fișiere la un GPT, în timp ce Întrebările frecvente despre încărcarea fișierelor menționează până la 10 fișiere per GPT pe durata de viață a GPT-ului respectiv. Ambele documente menționează o limită fixă de 512 MB per fișier, iar Întrebările frecvente despre încărcarea fișierelor menționează o limită de 2 milioane de token-uri pentru fișierele text și documente. Deoarece paginile oficiale nu sunt de acord cu numărul de fișiere, nu proiectați un flux de lucru critic în jurul numărului mai mare fără a verifica editorul actual și documentația pentru contul dvs.
5. Adăugați instrucțiuni orientate spre recuperare
Nu vă bazați pe instrucțiuni vagi, cum ar fi „Folosiți fișierele încărcate”. Indicați ce ar trebui să se întâmple atunci când o întrebare aparține unui domeniu bazat pe cunoștințe. Un model practic este: consultați mai întâi cunoștințele încărcate; preferați-le în locul cunoștințelor generale despre model pentru informații specifice companiei; identificați fișierul sau secțiunea justificativă atunci când este practic; și spuneți că informațiile nu sunt disponibile atunci când fișierele nu susțin un răspuns.
Instrucțiunile orientate spre regăsire ar trebui să definească prioritatea sursei, comportamentul citării și o opțiune de rezervă fără ghicire.
Ghidul de depanare OpenAI recomandă solicitări mai restrânse care se referă mai direct la documentele atașate atunci când cunoștințele nu sunt utilizate corect. De asemenea, recomandă păstrarea regulilor și a comportamentului fluxului de lucru în Instrucțiuni, în loc să fie ascunderea lor în fișierele încărcate. Consultați Depanarea GPT-urilor .
Evitați instrucțiunile contradictorii. „Răspundeți întotdeauna utilizatorului” intră în conflict cu „Nu răspundeți niciodată decât dacă fișierul îl acceptă”. Înlocuiți acest conflict cu o soluție explicită, cum ar fi: „Dacă fișierele cu cunoștințe nu conțin faptele solicitate, precizați că sursele furnizate nu stabilesc răspunsul și sugerați pasul următor aprobat.”
6. Rulați teste de împământare pozitive în Previzualizare
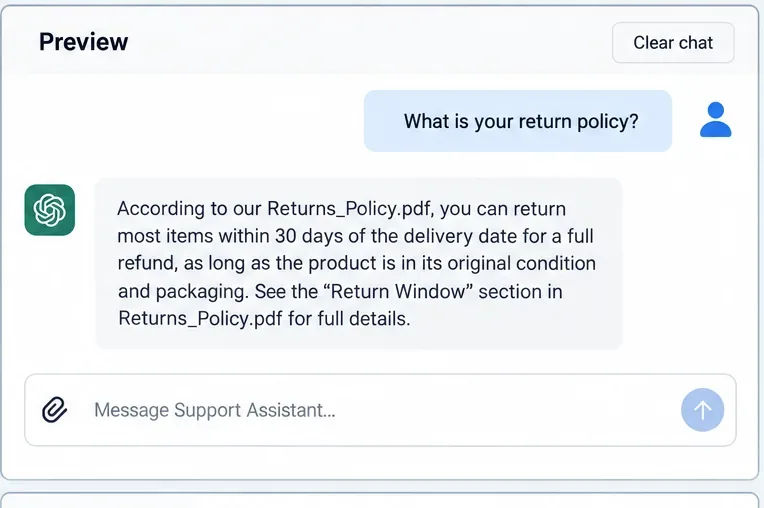
Întrebări de testare ale căror răspunsuri corecte sunt cu siguranță prezente în fișiere. Nu testați doar cea mai ușoară propoziție de pe prima pagină. Includeți întrebări care necesită regăsirea diferitelor secțiuni, recunoașterea formulărilor alternative și distingerea politicilor similare.
Un test pozitiv oferă răspunsul corect și identifică fișierul sau secțiunea justificativă.
Pentru fiecare test, înregistrați răspunsul așteptat, fișierul sursă așteptat și dacă GPT a citat sau a identificat sursa respectivă atunci când a fost solicitat. Ghidul GPT personalizat al OpenAI Academy recomandă construirea unui set de evaluare de aproximativ 10 până la 15 întrebări reprezentative cu răspunsuri corecte. Acesta este suficient de mare pentru a expune tipare recurente de eșec fără a transforma fiecare editare într-un proiect de testare major.
Evaluează rezultatul în funcție de dacă este sau nu acceptat, nu doar de faptul că sună fluent. Un răspuns rafinat cu o politică greșită este un eșec. Un răspuns mai scurt care citează cu acuratețe documentul de control este de obicei un rezultat mai bun.
7. Efectuați teste negative și reformulați testele
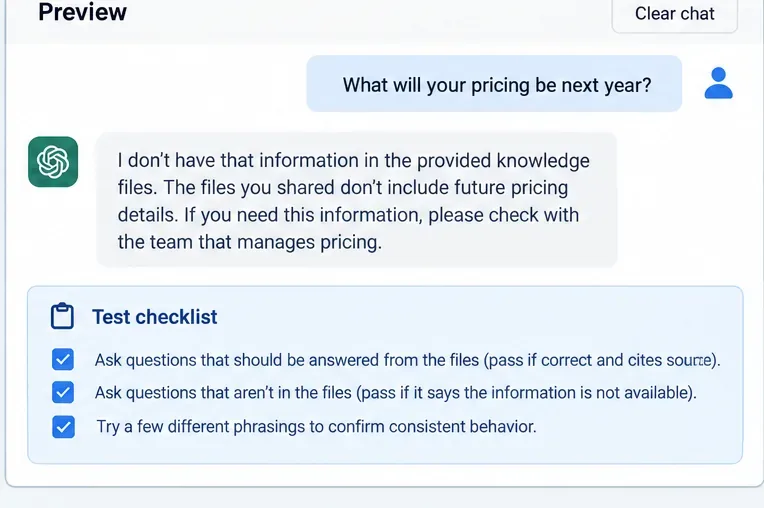
Un asistent de cunoștințe de încredere trebuie să știe ceea ce nu știe. Puneți întrebări care lipsesc intenționat din fișiere: un preț viitor, o funcție nelansată, o politică pentru o țară care nu este acoperită de manual sau o dată care depășește domeniul de aplicare al documentului. Rezultatul dorit este o limitare clară, nu o invenție plauzibilă.
Testele negative contează: GPT ar trebui să admită când un răspuns nu se află în fișiere și să rămână consecvent în toate reformulările.
Apoi, reformulează câteva întrebări pozitive și negative în mai multe moduri. Dacă răspunsul „Care este perioada de rambursare?” funcționează, dar răspunsul „În cât timp am la dispoziție să-l trimit înapoi?” nu funcționează, problema ar putea fi legată de acoperirea datelor recuperate, mai degrabă decât de lipsa de cunoștințe. Îmbunătățește titlurile, terminologia sau instrucțiunile înainte de a adăuga mai multe fișiere.
8. Actualizări de versiune, retestare și verificarea momentului în care cunoștințele statice sunt instrumentul nepotrivit
Ori de câte ori modificați o sursă, eliminați versiunea învechită, atașați-o pe cea curentă, salvați sau actualizați GPT-ul și rulați din nou același set de evaluare. Păstrarea unui mic jurnal de modificări în afara GPT-ului vă poate ajuta să identificați dacă o regresie a provenit din instrucțiuni noi, o sursă înlocuită sau o modificare a platformei.
După modificarea fișierelor sursă sau a instrucțiunilor, salvați actualizarea și rulați din nou același set de evaluare.
Cunoștințele statice au limite. Dacă sursa se schimbă constant, accesul trebuie să reflecte permisiunile per utilizator sau asistentul are nevoie de date operaționale în timp real, încărcarea repetată a fișierelor este fragilă. Aplicațiile OpenAI cu documentație de sincronizare descriu surse indexate conectate care rămân actualizate respectând permisiunile sursei. OpenAI orientează, de asemenea, fluxurile de lucru GPT personalizate către pluginuri, astfel încât o bază de cunoștințe care se schimbă frecvent este un candidat puternic pentru o arhitectură conectată sau migrată, mai degrabă decât o grămadă tot mai mare de fișiere statice.
Cum să diagnostichezi un GPT care totuși „uită” un fișier
Dacă un fapt cunoscut este omis, demonstrați mai întâi că faptul este de fapt prezent într-un fișier atașat, curent. Apoi, adresați o întrebare mai restrânsă care denumește documentul sau subiectul. Dacă întrebarea restrânsă funcționează, îmbunătățiți indiciile de recuperare prin simplificarea titlurilor, divizarea unui document prea amplu sau eliminarea versiunilor concurente. Dacă întrebarea restrânsă tot eșuează, convertiți materialul critic într-un text mai curat și testați din nou.
Nu rezolvați imediat fiecare eroare adăugând mai multe instrucțiuni. Regulile excesive sau conflictuale pot face comportamentul mai puțin previzibil. De asemenea, nu adăugați mai multe fișiere până nu știți că setul existent este curat. Semnalul de calitate dorit este repetabilitatea: aceeași suită mică de evaluare ar trebui să fie aprobată după fiecare modificare, în special pentru întrebări legate de politici, aspecte juridice, prețuri sau operaționale cu risc ridicat.
Limita practică: poți îmbunătăți recuperarea, nu o poți garanta
Nicio solicitare nu poate face ca un model generativ să consulte fiecare fișier de cunoștințe pentru fiecare răspuns cu certitudine absolută. Prin urmare, un GPT personalizat fiabil este un flux de lucru proiectat, nu o încărcare unică: fișiere sursă concentrate, instrucțiuni explicite privind prioritatea sursei, un comportament de abținere definit și o evaluare repetabilă. Dacă aceste controale tot nu îndeplinesc acuratețea sau actualitatea de care aveți nevoie, modificați arhitectura în loc să continuați să reglați aceeași configurație statică.
Pentru GPT-urile eligibile, acest proces poate reduce substanțial problema de tipul „fișierul meu a fost uitat”. Cu toate acestea, pentru lucrările noi începute la sfârșitul anului 2026, decizia pe termen lung ar trebui să țină cont și de tranziția anunțată de OpenAI de la fluxurile de lucru GPT personalizate la plugin-uri și de disponibilitatea surselor de cunoștințe conectate.