Acasă
» domenii
»
Cum să creezi un agent de procesare automată a facturilor folosind inteligența artificială open-source
Cum să creezi un agent de procesare automată a facturilor folosind inteligența artificială open-source
Un agent de procesare automată a facturilor nu trebuie să înceapă ca un sistem autonom de inteligență artificială de mari dimensiuni. Pentru o primă versiune utilă, gândiți-vă la un agent ca la un flux de lucru software controlat care primește o factură, apelează documentul și instrumentele de inteligență artificială corecte, validează rezultatul, decide dacă o ființă umană trebuie să o revizuiască și abia apoi salvează sau exportă datele aprobate.
Această distincție este importantă în domeniul financiar. Un model lingvistic poate ajuta la transformarea machetelor de facturi dezordonate în câmpuri structurate, dar nu ar trebui să fie singurul factor care decide dacă o factură este validă sau sigură pentru înregistrare. Designul ușor de utilizat pentru începători din acest ghid menține extragerea probabilistă, iar verificările contabile importante deterministe.
Până la final, veți avea un prototip local care acceptă facturi PDF sau imagine, extrage câmpuri precum furnizorul, numărul facturii, datele, moneda, totalurile și articolele, validează aceste câmpuri în funcție de reguli, direcționează documentele discutabile pentru revizuire, stochează o pistă de audit și expune procesul printr-o API.
Ce trebuie să înțelegi înainte să începi?
Există patru termeni care merită cunoscuți:
OCR (recunoașterea optică a caracterelor) transformă textul vizibil dintr-o imagine sau dintr-o scanare în text lizibil de mașină.
Analiza documentelor păstrează mai multă structură decât OCR-ul simplu, cum ar fi ordinea de citire, tabelele, titlurile și regiunile de aspect.
LLM (model de limbaj mare) poate mapa textul variabil al facturii într-o structură JSON consistentă.
Funcția „human-in-the-loop” înseamnă că sistemul se oprește și cere unei persoane să revizuiască cazurile care nu trec de verificări, în loc să pretindă că toate rezultatele sunt corecte.
Începând cu septembrie 2026, mai multe proiecte open-source întreținute activ acoperă aceste straturi. Docling acceptă PDF, imagini, documente Office și alte formate de documente; PaddleOCR oferă servicii OCR și de înțelegere a documentelor și este lansat sub Apache 2.0; iar proiectul Tesseract își documentează linia actuală 5.x ca motor OCR open-source în manualul oficial Tesseract .
Pentru inferența modelului local, documentația serverului llama.cpp descrie endpoint-uri compatibile cu OpenAI și ieșiri JSON cu schemă constrânsă. Acest lucru îl face util pentru un serviciu de extracție, deoarece puteți solicita unui model găzduit local să returneze un obiect definit în loc de text neconstrâns.
Un avertisment privind licențierea este important: un motor de inferență open-source nu face automat ca fiecare model să fie open-source să fie considerat open-source. Verificați licența pentru punctul de control exact al modelului pe care îl implementați, în special pentru uz comercial.
Ce stivă ar trebui să folosească un începător?
Strat
Alegere practică
De ce este aici
Conversia documentelor
Docling
Convertește fișiere PDF și imagini într-o reprezentare structurată a documentului și text exportabil.
Soluție de rezervă OCR
PaddleOCR sau Tesseract
Util atunci când factura este scanată sau fotografiată, iar extragerea textului necesită OCR.
Extracție locală de inteligență artificială
llama.cpp + un model de instrucțiuni adecvat
Mapează textul variabil al facturii la o schemă JSON stabilă, păstrând în același timp inferența locală.
Validarea schemei
Pidantic
Validează datele Python în funcție de tipurile de câmp declarate și de constrângeri.
API-ul
API rapidă
Acceptă încărcări de facturi și returnează rezultatele procesării.
Depozitare
SQLite pentru un prototip; PostgreSQL pentru un serviciu partajat
Stochează date normalizate, starea revizuirii, identitatea fișierului sursă și evenimentele de audit.
Orchestrație
Mai întâi Python simplu; LangGraph opțional mai târziu
O funcție deterministă este mai ușor de depanat. Adăugați un framework de agent cu stări atunci când ramificarea și revizuirea umană devin mai complexe.
Documentația oficială Pydantic explică faptul că modelele moștenesc de la BaseModel, validează datele primite și pot emite scheme JSON prin model_json_schema(). Consultați validarea modelului Pydantic . Dacă ulterior aveți nevoie de ramificare durabilă, cu stare, referința LangGraph descrie suportul pentru agenți cu stare de lungă durată, persistență și fluxuri de lucru human-in-the-loop.
Pasul 1: Configurați proiectul și definiți un prim obiectiv precis
Nu începeți cu „automatizarea datoriilor de plată”. Începeți cu o singură clasă de documente și un singur contract de ieșire. Un MVP bun este: facturi de la furnizor în limba engleză, introducere PDF sau imagine, o singură entitate juridică, un singur set de valute și nicio executare automată a plăților.
Instalați motorul OCR separat dacă aveți nevoie de unul. Ghidul de instalare actual al Docling folosește pip install docling; Documentația de instalare actuală a PaddleOCR distinge pachetul OCR de bază de grupurile opționale de dependențe pentru analizarea documentelor și extragerea informațiilor. Utilizați ghidul de instalare Docling sau ghidul de instalare PaddleOCR 3.x în loc să copiați o listă veche de dependențe.
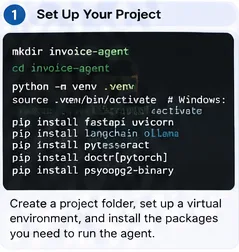
Pasul 1: Creați mai întâi un proiect Python mic și izolat. Păstrați primul tip de factură și schema de ieșire suficient de restrânse pentru a le testa temeinic.
Pasul 2: Conversia facturilor în text și date de layout
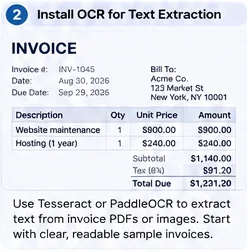
PDF-urile digitale incipiente pot conține deja text utilizabil. PDF-urile scanate și fotografiile necesită OCR. Parserul dvs. ar trebui să ascundă această diferență de restul procesului: etapele ulterioare ar trebui să primească textul normalizat al documentului, plus orice informații utile despre aspect sau tabel.
O conversie Docling minimă arată astfel:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Ghidul oficial de pornire rapidă al Docling folosește același model de tip „convert-the-export”. Pentru colecțiile care utilizează mult OCR, testați PaddleOCR sau Tesseract pe propriile scanări. Documentația proiectului PaddleOCR recomandă noua familie PP-StructureV3 pentru analiza documentelor, în timp ce Tesseract poate fi apelat din linia de comandă sau din API pentru OCR de text tipărit.
Pasul 2: Începeți cu facturi eșantion lizibile care conțin câmpurile pe care intenționați să le extrageți, apoi adăugați scanări mai complexe numai după ce funcționează canalul de bază.
Pasul 3: Decideți exact ce date are permisiunea agentului să producă
Schema de extracție este contractul dintre inteligența artificială și logica contabilă. Evitați o schemă gigantică de tipul „orice ar putea apărea pe o factură”. Începeți cu câmpuri pe care le puteți valida.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"este util în acest context, deoarece câmpurile LLM neașteptate nu ar trebui să devină în mod silențios parte a înregistrării contabile. De asemenea, rețineți că validarea Pydantic confirmă structura și tipurile; nu dovedește că furnizorul sau suma extrase corespunde cu imaginea facturii.
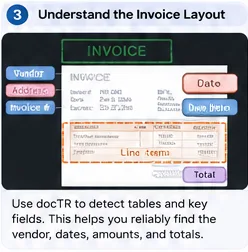
Pasul 3: Definiți câmpurile țintă în funcție de nevoile afacerii, apoi utilizați informațiile din aspect și tabel pentru a păstra proveniența acestor valori.
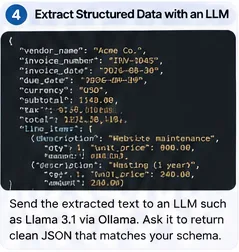
Pasul 4: Folosește un model local pentru a mapa textul documentului în JSON structurat
Rulați un model de instrucțiuni adecvat în spatele serverului HTTP al llama.cpp. Dimensiunea exactă a modelului depinde de hardware-ul dvs. și de complexitatea facturilor. Nu presupuneți că un model mai mare este automat mai bun; comparați acuratețea câmpurilor, latența și memoria pe propriul set de facturi.
llama.cpp acceptă în prezent răspunsuri JSON cu schemă constrânsă. Puteți deriva acea schemă din Pydantic și o puteți trimite împreună cu solicitarea de extragere:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
Generarea cu constrângeri de schemă ajută la crearea unei structuri valide, dar nu garantează veridicitatea semantică. Un obiect JSON perfect valid poate conține totuși un total greșit. De aceea, următorul pas este obligatoriu.
Pasul 4: Solicitați modelului local un obiect structurat strict, nu proză liberă, astfel încât validarea din aval să primească câmpuri previzibile.
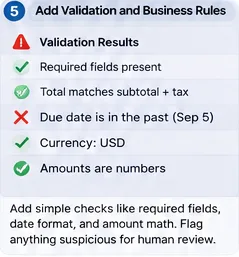
Pasul 5: Adăugați verificări contabile deterministe și revizuiți regulile
Nu întreba masteratul în drept „Ești încrezător?” și ai încredere în răspuns. Încrederea modelului auto-raportată nu este un control calibrat. Construiește verificări care pot fi recalculate din datele extrase și din sistemele tale.
Primele reguli utile includ:
câmpurile obligatorii sunt prezente;
numărul facturii nu este deja înregistrat pentru același furnizor;
moneda este permisă pentru furnizorul sau entitatea respectivă;
sumele pe articole reprezintă aproximativ subtotalul;
subtotalul plus taxa este aproximativ egal cu totalul;
data facturii și data scadenței sunt plauzibile;
furnizorul există în lista principală de furnizori sau este direcționat pentru integrare;
Referințele comenzilor de achiziție se potrivesc atunci când este necesară potrivirea comenzilor de achiziție.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Direcționați fiecare verificare eșuată către o coadă de revizuire. Pentru o primă implementare, este rezonabil să direcționați toate facturile către revizuire în timp ce măsurați calitatea extragerii. Pragurile de automatizare ar trebui să provină din dovezile colectate pe propriile facturi etichetate, nu dintr-un procent generic copiat dintr-un alt sistem.
Pasul 5: Tratați aritmetica, detectarea duplicatelor, potrivirea furnizorilor și regulile de dată ca controale deterministe; direcționați excepțiile către o persoană.
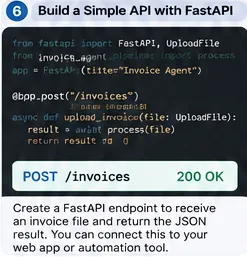
Pasul 6: Încadrați procesorul într-o mică API
O API permite unui formular de încărcare, unui funcționar de e-mail, unui observator de foldere partajate sau unei integrări contabile să apeleze aceeași funcție de procesare. Ghidul oficial de încărcare a fișierelor FastAPI recomandă UploadFilepentru fișierele încărcate și menționează că utilizează un fișier spool, care este mai potrivit decât încărcarea integrală a fișierelor mari în memorie.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Consultați documentația curentă FastAPI privind fișierele de solicitare pentru modelele de încărcare acceptate. În producție, impuneți și limite de dimensiune a fișierelor, scanarea programelor malware acolo unde este cazul, apelanții autentificați, ID-urile de solicitare și curățarea securizată a fișierelor temporare.
Pasul 6: Expuneți un punct final de procesare după ce canalul local funcționează, astfel încât mai multe canale de intrare să poată reutiliza aceeași cale de validare.
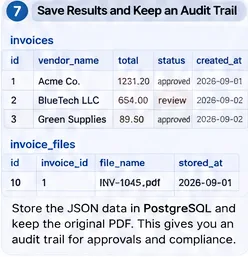
Pasul 7: Stocarea dovezilor originale, a rezultatului normalizat și a evenimentelor de audit
Nu stocați niciodată doar fișierul JSON final. Păstrați suficiente dovezi pentru a reconstitui ce s-a întâmplat: identitatea fișierului original, hash-ul, versiunea parserului, identificatorul modelului, versiunea promptului, JSON-ul extras, rezultatele validării, decizia de revizuire, marcajele temporale și utilizatorul sau serviciul care a aprobat o modificare.
Un prototip simplu poate utiliza SQLite. Un serviciu multi-utilizator poate utiliza PostgreSQL cu constrângeri de unicitate și cheie externă. Documentația actuală a PostgreSQL acoperă constrângerile de tabel , care sunt utile pentru protejarea cheilor și relațiilor independent de conducta de inteligență artificială.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
Hash-ul sursei vă oferă o a doua modalitate de a detecta retrimiterea accidentală. Păstrați permisiunile de stocare a fișierelor mai stricte decât jurnalele generale ale aplicațiilor, deoarece facturile conțin adesea adrese, detalii bancare, coduri de identificare fiscală și alte date sensibile pentru afaceri.
Pasul 7: Păstrați atât datele normalizate ale facturilor, cât și metadatele fișierului sursă, astfel încât aprobările, duplicatele și corecțiile ulterioare să rămână auditabile.
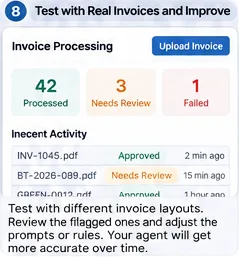
Pasul 8: Testați cu variații reale ale facturii înainte de a automatiza acțiunile ulterioare
Un prototip care funcționează pe cinci PDF-uri curate nu este pregătit pentru producție. Construiți un set de evaluare etichetat care să reprezinte datele de intrare pe care le primiți efectiv: furnizori diferiți, scanări, pagini rotite, fonturi mici, facturi cu mai multe pagini, reduceri, linii negative, taxe, costuri de livrare, valute multiple, comenzi de achiziție lipsă și documente trimise duplicat.
Urmăriți separat indicatorii la nivel de câmp. „Acuratețea facturilor” poate ascunde faptul că numele furnizorului este ușor de identificat, în timp ce cantitatea pe articol nu este fiabilă. Măsurați cel puțin:
precizie de corespondență exactă pentru numărul facturii, moneda și datele;
precizie numerică a toleranței pentru subtotal, taxă și total;
precizia și reamintirea elementelor de linie dacă acestea sunt importante în aval;
procent direcționat către revizuire umană;
rată de auto-aprobări false;
latența procesării și rata de eșec;
precizia detectării duplicatelor.
Stocați eșecurile ca cazuri de testare. De fiecare dată când remediați o regulă de analizor, o solicitare, o schemă sau un model, rulați din nou întregul set de evaluare. Acest lucru împiedică îmbunătățirea unui furnizor să perturbe discret aspectul altui furnizor.
Pasul 8: Măsurați coada de revizuire și cazurile de eșec de pe facturile reprezentative înainte de a permite agentului să automatizeze acțiunile contabile ulterioare.
Cum ar trebui agentul să decidă ce se întâmplă în continuare?
Păstrați mașina de stare explicită. „Agentul” poate fi inițial o funcție Python simplă:
Acest lucru este deja similar unui agent, deoarece coordonează instrumentele și alege o ramură. Nu aveți nevoie de un LLM pentru a alege fiecare pas următor. Adăugați LangGraph sau un alt framework de orchestrare atunci când aveți nevoie de revizuiri persistente în mai multe etape, reîncercări, apeluri inverse asincrone sau mai multe instrumente specializate a căror ordine de execuție se modifică în funcție de caz.
Ce greșeli ar trebui să evite începătorii?
Permiterea LLM-ului să fie controlul contabil
Modelul ar trebui să extragă și să normalizeze; codul și datele sistemului de încredere ar trebui să verifice. Aritmetica, verificările duplicatelor, starea furnizorului, potrivirea comenzilor de achiziție și limitele de aprobare aparțin logicii deterministe.
Eliminarea documentului sursă după extragere
Păstrați factura originală sau o referință controlată la aceasta. Recenzorii au nevoie de dovezi, iar dumneavoastră aveți nevoie de o modalitate de a reproduce erorile după actualizările modelului sau ale parserului.
Utilizarea unui prompt fără o versiune
Stocați o versiune a promptului și un identificator de model cu fiecare factură procesată. Altfel, nu puteți explica de ce două facturi procesate la interval de luni s-au comportat diferit.
Postarea automată a fiecărui rezultat valid pentru schemă
Validitatea JSON nu este valabilitatea facturilor. Începeți cu o verificare umană, apoi automatizați doar cazurile cu risc scăzut după ce evaluarea demonstrează o performanță acceptabilă.
Ignorarea licențelor de model și de date
Bibliotecile și ponderile modelelor pot avea licențe diferite. PaddleOCR și Tesseract publică licențe open-source, în timp ce licența modelului pe care îl rulați prin llama.cpp depinde de punctul de control specific. Confirmați-l înainte de implementare.
Construirea interfeței utilizator înainte de a demonstra calitatea extracției
Un tablou de bord rafinat nu poate compensa sumele incorecte. Testați mai întâi analiza documentelor, extragerea schemelor și validarea; adăugați o interfață de revizuire după ce știți ce trebuie de fapt să vadă recenzorii.
Când ar trebui să utilizați doar OCR, modele de machetare sau un LLM?
Abordare
Cea mai bună potrivire
Principala limitare
Reguli OCR +
Număr mic de șabloane de furnizori extrem de stabile
Regulile devin fragile pe măsură ce machetele variază.
Model de aspect al documentului
Tabele, formulare și câmpuri în care poziția contează
Ar putea necesita instruire specifică sarcinii sau postprocesare.
Analizator OCR/documente + LLM local
Multe formate de factură cu o schemă țintă comună
Trebuie constrâns și validat; inferența costă mai mult efort de calcul.
Modelul viziunii-limbajului
Documente complexe în care textul și aspectul vizual sunt strâns legate
Cerințe hardware mai mari și complexitate suplimentară a evaluării.
Documentația actuală LayoutLMv3 a Hugging Face descrie un model de inteligență artificială pentru documente care combină informații textuale și vizuale despre aspect. Documentația PP-StructureV3 a PaddleOCR se concentrează, de asemenea, pe aspect, tabele și analiza structurată a documentelor. Acestea sunt opțiuni atunci când textul simplu plus un LLM nu sunt suficiente.
Care este o cale rezonabilă de la prototip la producție?
Mutați în etape. Mai întâi, rulați local pe un folder de facturi etichetate. În al doilea rând, adăugați API-ul și stocarea persistentă. În al treilea rând, introduceți o coadă de revizuire umană. În al patrulea rând, integrați căutări doar pentru citire, cum ar fi datele principale ale furnizorilor sau comenzile de achiziție. În al cincilea rând, permiteți exportul controlat către o zonă de pregătire contabilă. Numai după ce monitorizarea dovedește controalele ar trebui să luați în considerare înregistrarea automată pentru cazuri cu risc scăzut strict definite.
În fiecare etapă, păstrați trei lucruri: dovezile (documentul original și sursa extrasă), determinismul (regulile de business care pot fi rulate din nou) și trasabilitatea (ce parser, model, prompt și recenzent au produs înregistrarea finală).
Listă de verificare finală
Analizatorul de facturi funcționează atât pe PDF-uri digitale, cât și pe scanările pe care le primiți efectiv.
Rezultatul extragerii este limitat la o schemă Pydantic versionată.
Modelul nu are voie să inventeze valori lipsă.
Totalurile, datele, duplicatele, identitatea furnizorului și regulile comenzilor de comandă sunt validate în afara LLM.
Regulile eșuate produc o stare de revizuire umană în loc de corecție silențioasă.
Documentul original, hash-ul sursei, modelul, versiunea promptului și rezultatul validării sunt înregistrate în jurnal.
API-ul restricționează tipul și dimensiunea fișierelor și este autentificat înainte de utilizarea în producție.
Setul tău de testare conține variații reale de aspect și cazuri limită.
Licențele de model și bibliotecă au fost verificate pentru implementarea dorită.
Scrierile contabile în aval sunt introduse treptat și rămân auditabile.
Dacă aceste controale sunt implementate, aveți mai mult decât o demonstrație OCR: aveți baza unui agent de procesare a facturilor fiabil. Componentele open-source se pot schimba în timp, dar arhitectura rămâne durabilă - analizați dovezile, extrageți-le într-o schemă, validați cu cod, direcționați incertitudinea către persoane și înregistrați fiecare decizie.