Acasă
» domenii
»
Cum se măsoară calitatea răspunsurilor LLM folosind cadre Evals
Cum se măsoară calitatea răspunsurilor LLM folosind cadre Evals
Cea mai fiabilă metodă de a măsura calitatea răspunsului LLM este de a trata evaluarea ca pe un sistem de testare repetabil, nu ca pe un singur scor. Definiți ce înseamnă „bun” pentru aplicația dvs., construiți un set de date de evaluare reprezentativ, combinați verificările deterministe cu judecata umană și bazată pe modele, comparați fiecare modificare a candidatului cu o valoare de referință și inspectați eșecurile pe categorii înainte de a le expedia.
Acest lucru este important deoarece un LLM poate produce un răspuns care pare rafinat, dar care este în același timp greșit, nejustificat, incomplet, nesigur sau inconsistent cu instrucțiunile dumneavoastră. Un cadru de evaluare util transformă acele preocupări vagi în criterii explicite care pot fi reluate după o modificare promptă, o actualizare a modelului, o modificare a recuperării, o actualizare a instrumentului sau o revizuire a politicii de siguranță.
Notă privind documentația: capacitățile framework-ului descrise mai jos au fost verificate în raport cu documentația oficială disponibilă la 13 septembrie 2026. Aceste instrumente evoluează rapid, așadar verificați API-urile actuale înainte de a copia codul specific framework-ului în producție.
Ce ar trebui să măsori mai întâi?
Începeți cu eșecul care ar conta cel mai mult pentru utilizatorii dvs. Pentru un bot de suport factual, corectitudinea și conformitatea cu politicile pot fi dominante. Pentru generarea augmentată de recuperare (RAG), fundamentarea și calitatea recuperării contează, deoarece un răspuns fluent poate inventa în continuare fapte care nu sunt susținute de contextul recuperat. Pentru un agent, calitatea răspunsului final nu este suficientă; este posibil să fie nevoie să evaluați și selecția instrumentului, argumentele instrumentului, finalizarea sarcinii și pașii inutili.
Dimensiunea calității
Ceea ce întreabă
Tipul de evaluator bun
Corectitudine
Este răspunsul corect din punct de vedere factual sau logic?
Comparare de referințe, verificare a codului, evaluare LLM sau evaluare umană
Instrucțiuni care urmează
A respectat modelul constrângerile impuse?
Reguli de cod plus judecător bazat pe rubrică
Împământare
Sunt afirmațiile susținute de contextul furnizat?
Verificări specifice judecătorului RAG sau la nivel de revendicare
Relevanţă
Răspunde răspunsul la întrebarea reală fără a devia?
Judecător LLM sau evaluare umană
Conformitatea formatului
Rezultatul este un JSON valid, compatibil cu schema sau utilizabil de mașină în alt mod?
Cod determinist
Siguranță și politică
Încalcă răspunsul regulile aplicației tale?
Verificări ale politicilor, judecător LLM și evaluare umană direcționată
Eficienţă
Ce latență, utilizare a token-urilor și cost a necesitat răspunsul?
Telemetrie și urmărire
Nu calculați media acestora într-un singur număr prea devreme. Un model candidat care câștigă două puncte în stil, dar introduce chiar și un număr mic de eșecuri severe ale politicilor, ar putea fi o versiune mai slabă. Mențineți dimensiunile critice vizibile ca porți separate.
Un flux de lucru de evaluare în patru etape care funcționează în mai multe cadre de lucru
1. Construiți un set de date de evaluare reprezentativ
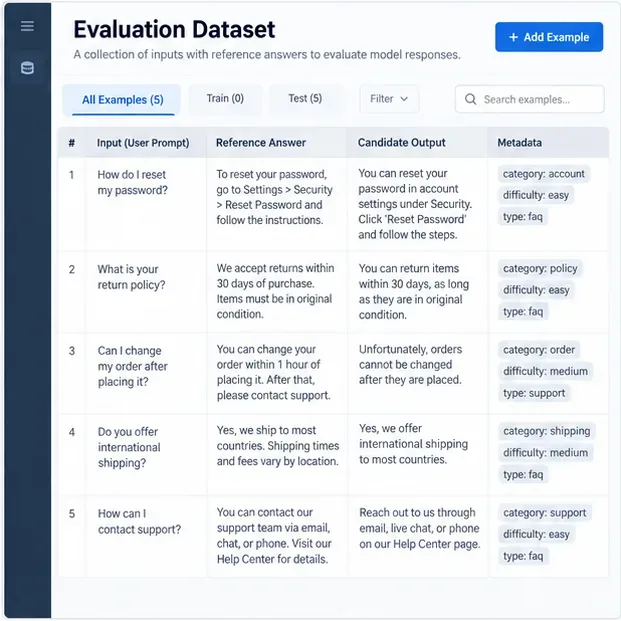
Setul de date ar trebui să conțină intrări realiste și, acolo unde este posibil, comportamentul așteptat. Unele rânduri pot avea răspunsuri de referință exacte; altele pot necesita o rubrică în loc de o singură propoziție „de aur”. Adăugați metadate precum tipul de sarcină, segmentul de clienți, limba, dificultatea, condiția de recuperare sau categoria de siguranță, astfel încât să puteți analiza ulterior rezultatele în secvențe.
De exemplu, imaginați-vă un asistent de asistență clienți. Un set de evaluare util nu ar conține doar întrebări frecvente (FAQ) simple. Ar trebui să includă și solicitări ambigue, excepții de la politici, cazuri de context lipsă, solicitări contradictorii, răspunsuri ulterioare cu mai multe rânduri de răspunsuri și exemple în care comportamentul corect este să se spună că răspunsul nu poate fi determinat.
Ghidul actual de evaluare al LangSmith recomandă începerea cu exemple selectate manual care arată cum arată un comportament bun, apoi extinderea setului de date cu urme istorice și erori descoperite în producție. Sistemul său de evaluare acceptă seturi de date cu intrări, ieșiri de referință opționale și metadate. Consultați documentația conceptelor de evaluare LangSmith .
Un set de date de evaluare ar trebui să asocieze solicitări realiste cu referințe sau comportamente așteptate și să păstreze metadatele pentru analiza ulterioară a defecțiunilor.
Când se potrivește această abordare: aproape întotdeauna. Chiar dacă utilizați evaluarea producției în timp real, aveți nevoie în continuare de un set offline stabil pentru testarea regresiei. Dacă nu aveți un răspuns de referință pentru sarcini deschise, stocați în schimb o rubrică, informații necesare, comportamente interzise sau preferințe perechi.
2. Asociați fiecare dimensiune a calității evaluatorului potrivit
Cele mai puternice suite de evaluare combină tipuri de evaluatori, deoarece niciun evaluator nu este ideal pentru fiecare întrebare.
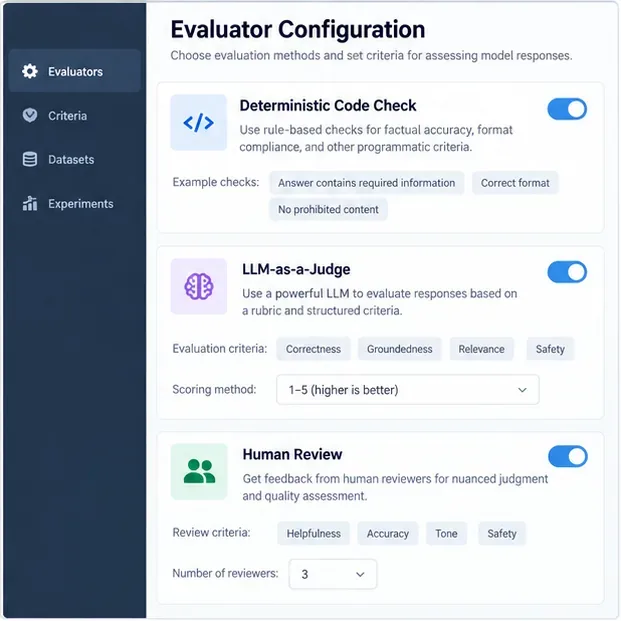
Verificările deterministe sunt cele mai bune atunci când cerința este lipsită de ambiguitate: JSON valid, etichete exacte, chei necesare, toleranță numerică, reguli regex sau dacă un apel de instrument a folosit argumente aprobate.
Metricile bazate pe referințe pot ajuta atunci când există un răspuns cunoscut, dar similaritatea șirurilor în sine este adesea prea fragilă pentru parafraze valide și prea permisivă față de textul semantic greșit care are același vocabular.
Metoda LLM-ca-judecător este utilă pentru criterii precum caracterul complet, relevanța, tonul, fidelitatea sau dacă un răspuns deschis îndeplinește o rubrică.
Evaluarea în perechi este utilă atunci când este mai ușor de decis dacă candidatul A sau valoarea de referință B este mai bun decât să se atribuie un scor absolut semnificativ.
Revizuirea umană rămâne importantă pentru calibrarea evaluatorilor automati, rezolvarea cazurilor subiective sau cu miză mare și verificarea dacă indicatorul în sine reflectă valoarea pentru utilizator.
API-ul Evals actual al OpenAI definește o evaluare ca fiind criterii de testare plus o schemă sursă de date și acceptă evaluatori reutilizabili. API-ul său de evaluatori include verificări deterministe ale șirurilor de caractere, evaluatori de similaritate a textului și evaluatori bazați pe modele; consultați referința API-ului OpenAI Evals și referința evaluatorilor OpenAI . Serviciul de evaluare Vertex AI Gen AI din Google Cloud acceptă metrici bazate pe modele punctuale și pe perechi, precum și metrici bazate pe calcul; rezultatele sale pot include scoruri per instanță, explicații, medii agregate, abateri standard și rate de câștig pe perechi. Consultați documentația rezultatelor evaluării Vertex AI .
Folosiți reguli deterministe acolo unde este posibil, adăugați evaluatori LLM bazați pe rubrici pentru calitatea semantică și mențineți disponibilă revizuirea umană pentru calibrare și cazuri nuanțate.
Când această abordare este potrivită: se utilizează verificări deterministe pentru cerințe verificabile de mașină, evaluări LLM pentru calități semantice și evaluări umane acolo unde dezacordul are consecințe semnificative asupra afacerii sau siguranței. Pentru un sistem RAG, Ragas expune metrici precum precizia contextului, reamintirea contextului, relevanța răspunsului și fidelitatea, plus metrici de utilizare a agentului/instrumentului, inclusiv precizia apelului instrumentului și precizia obiectivului agentului. Consultați documentația metricilor Ragas . De asemenea, DeepEval oferă metrici specifice sarcinii și evaluare personalizată a evaluărilor LLM, inclusiv scorare în stil G-Eval; consultați documentația metricilor DeepEval .
3. Rulați același set de date împotriva unei baze și a unui candidat
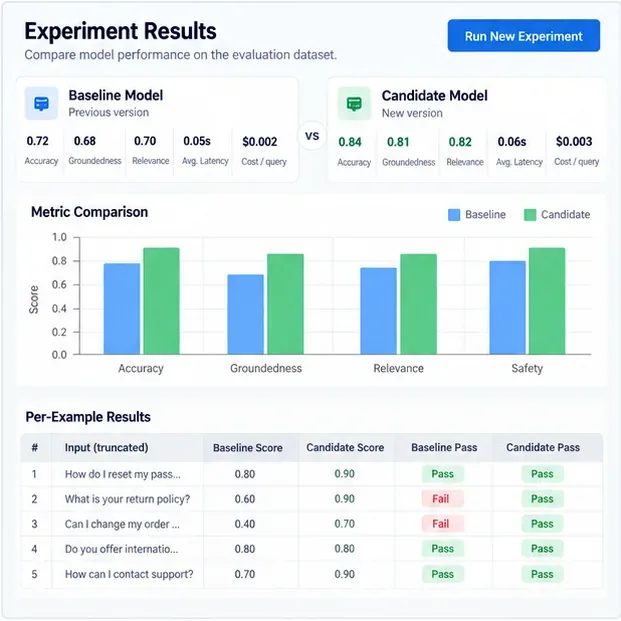
Scorurile absolute sunt utile, dar deciziile privind lansarea sunt de obicei mai clare atunci când noua configurație este testată în raport cu versiunea în care aveți deja încredere. Mențineți setul de date, definițiile evaluatorului, parametrii modelului și setările de eșantionare cât mai stabile posibil. Apoi comparați aceleași exemple unul lângă altul.
Urmăriți cel puțin trei niveluri de rezultate:
Scoruri per exemplu: Care dintre solicitări s-au îmbunătățit sau au regresat?
Rezultate per secțiune: S-a modificat performanța pentru întrebări cu context lung, un anumit limbaj, cazuri dificile, o categorie de produse sau inputuri contradictorii?
Rezultate agregate: Ce s-a întâmplat cu rata de promovabilitate, scorul mediu, latența, utilizarea token-urilor, costul și numărul de eșecuri grave?
Pentru sistemele nedeterministe, reluați testele importante de suficient de multe ori pentru a înțelege variabilitatea, în loc să presupuneți că o singură finalizare reprezintă modelul. Dacă decizia de lansare este semnificativă, utilizați comparații pereche pe aceleași exemple și raportați incertitudinea în loc să vă bazați doar pe o mică modificare a mediei.
LangSmith acceptă experimente offline pentru compararea versiunilor și evaluatori în perechi, în timp ce stiva actuală de evaluare GenAI a MLflow acceptă seturi de date de evaluare, evaluatori încorporați și personalizați, evaluatori LLM, feedback uman, urmărire și monitorizare a producției. Consultați Evaluarea LangSmith și MLflow LLM și Evaluarea Agenților .
Comparați un candidat cu linia de bază actuală pe aceleași exemple, apoi inspectați atât valorile agregate, cât și rezultatele de succes sau eșec per exemplu.
Când se potrivește această abordare: ori de câte ori modificați un model, o solicitare de sistem, o conductă de recuperare, o implementare a instrumentului sau setările de decodare. Un candidat nu ar trebui promovat doar pentru că o metrică agregată crește; acesta ar trebui să îndeplinească pragurile de lansare pentru dimensiunile critice și să evite regresiile inacceptabile la nivel de porțiune.
4. Inspectați eșecurile, calibrați arbitrul și transformați regresiile în teste noi
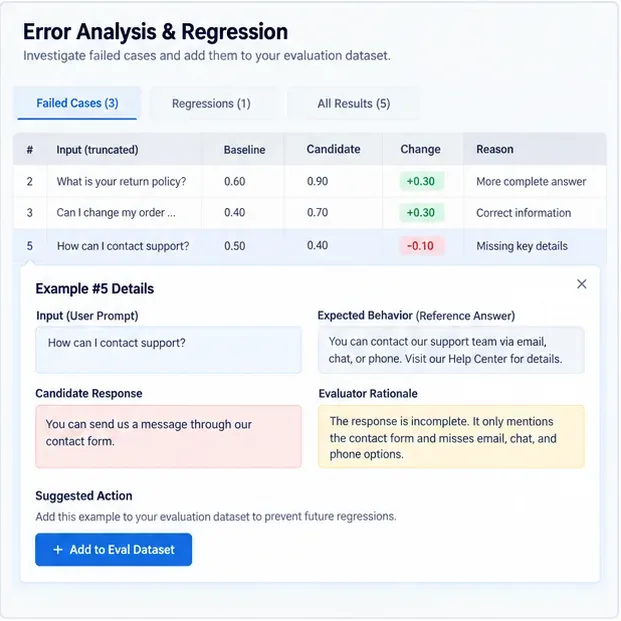
O evaluare este valoroasă doar dacă schimbă ceea ce faci în continuare. Sortează eșecurile după severitate și cauză principală. Un scor scăzut de bază poate proveni dintr-o recuperare slabă, o solicitare care încurajează ghicirea, o rubrică de evaluare prea vagă sau un răspuns de referință incorect. Citește exemplele de bază înainte de a schimba modelul.
Apoi, eșecurile importante sunt promovate în cazuri de regresie permanente. Aceasta creează o situație de tip „roată de inerție”: producția dezvăluie o eșec, o persoană o confirmă, cazul este adăugat la setul de date offline, remedierea este testată în raport cu suita completă, iar versiunile viitoare sunt blocate pentru a reintroduce aceeași problemă.
Evaluatorii LLM au nevoie și de evaluare. Documentația Google descrie explicit compararea rezultatelor metrice bazate pe modele cu evaluările umane pentru a evalua dacă evaluatorul este suficient de bun pentru un anumit caz de utilizare. În mod similar, studiul GDPval al OpenAI folosește notarea perechilor de către experți ca standard principal și descrie notarea automată ca o aproximare, mai degrabă decât un înlocuitor pentru judecata experților. Consultați îndrumările Vertex AI privind evaluarea unui model de evaluator și metodologia GDPval a OpenAI .
Revizuiți exemplele reale eșuate, confirmați că evaluatorul judecă corect și adăugați regresii importante la setul permanent de teste.
Când se potrivește această abordare: întotdeauna pentru erori cu impact ridicat și ori de câte ori un judecător LLM influențează o poartă de eliberare. Dacă evaluatorii umani nu sunt de acord în mod repetat cu judecătorul, corectați rubrica, oferiți referințe mai clare, schimbați modelul de judecător sau mutați criteriul respectiv înapoi la evaluarea umană.
Cât de fiabil este LLM-ul ca judecător?
Evaluatorii LLM sunt puternici deoarece pot evalua rezultatele deschise la o scară pe care evaluarea exclusiv umană nu o poate egala. Cercetarea originală G-Eval a raportat o corelație substanțial mai bună cu judecata umană decât metricile automate tradiționale în contextul de sumarizare studiat. Cu toate acestea, aceeași lucrare a avertizat că evaluatorii LLM pot favoriza textul generat de LLM. Consultați lucrarea originală G-Eval .
Cercetări separate efectuate pe MT-Bench și Chatbot Arena au descoperit că judecătorii LLM puternici se pot alinia bine cu preferințele umane, documentând în același timp poziția, verbositatea, auto-îmbunătățirea performanței și prejudecățile legate de raționament. Consultați studiul original LLM-as-a-judge .
Concluzia practică nu este „nu folosiți niciodată evaluări LLM”. Ci: calibrați-le. Construiți un eșantion etichetat de om, măsurați acordul, inspectați categoriile de dezacord, randomizați sau schimbați ordinea răspunsurilor în testele perechi atunci când efectele de poziție sunt plauzibile și evitați să lăsați același prompt vag de evaluare să determine în tăcere fiecare decizie de lansare.
Ce framework de evaluare ar trebui să alegeți?
Cadru
Cea mai bună potrivire
Forță notabilă
Evaluări și evaluatori OpenAI
Echipe care utilizează deja API-uri OpenAI și doresc rulări de evaluare native pentru API
Definiții de evaluare reutilizabile cu evaluatori determiniști și bazați pe modele
LangSmith
Aplicații LLM care necesită urmărire, seturi de date, teste de regresie offline și evaluare online
Comparație puternică a experimentelor și buclă de feedback pentru producție
Ragas
Evaluarea utilizării agenților/instrumentelor în conducte RAG și a utilizării acestora
Recuperare, fidelitate, relevanță și metrici ale instrumentului construite special
DeepEval
Echipe axate pe Python care doresc evaluări în stil de testare și judecători LLM personalizabili
Catalog extins de metrici, evaluarea componentelor/end-to-end și metrici ale traiectoriei agenților
Evaluare MLflow GenAI
Echipe care utilizează deja MLflow sau doresc evaluări legate de urmărire și gestionarea ciclului de viață
Seturi de date, evaluatori, feedback uman, urmărirea experimentelor și monitorizarea producției
Evaluarea Vertex AI Gen AI
Implementări Google Cloud
Fluxuri de lucru de evaluare punctuală, pereche, bazate pe modele și bazate pe calcule
Alegerea cadrului de lucru contează mai puțin decât designul evaluării. Puteți construi o suită de evaluare slabă într-o platformă sofisticată sau una puternică cu câteva scripturi. Preferați instrumentul care face testele reproductibile, versionabile, ușor de inspectat și ușor de rulat înainte de fiecare modificare semnificativă.
Un tabel de scor practic pentru lansări
Pentru un asistent de producție, o decizie utilă privind lansarea poate fi exprimată ca un set de porți în loc de un scor combinat. De exemplu, să fie necesare zero erori critice de siguranță în setul de siguranță selectat, nicio regresie semnificativă statistic în corectitudinea sarcinilor, o rată minimă de promovabilitate cu privire la fundamentare pentru întrebările RAG, un rezultat structurat valid pentru fiecare caz de schemă și o latență sau un cost în limita bugetului operațional. Pragurile exacte trebuie să provină din toleranța la risc și cerințele utilizatorilor; nu există un procent universal care să facă un LLM „suficient de bun”.
De asemenea, păstrați exemplele brute din spatele scorului. Dacă o versiune trece de la 0,84 la 0,86, trebuie să știți în continuare care două cazuri s-au modificat și dacă aceste modificări contează. În practică, echipele învață mai mult dintr-un număr mic de erori clar clasificate decât dintr-o medie impresionantă a tabloului de bord, fără trasabilitate.
Greșeli frecvente de evaluare
Testarea doar a căilor fericite: adăugarea de ambiguitate, cazuri limită, încercări de injectare promptă, context lipsă și eșecuri istorice cunoscute.
Utilizarea potrivirii exacte pentru răspunsuri deschise: rezervați potrivirea exactă pentru rezultatele în care exactitatea este cu adevărat necesară.
Încrederea într-un judecător de masterat în drept fără calibrare: comparați-l cu etichetele umane și analizați dezacordurile.
Optimizarea mediei ascunzând în același timp defecțiunile severe: păstrarea siguranței, politicii și a altor dimensiuni critice ca porți explicite.
Modificarea setului de date în timpul unei comparări de modele: înghețarea setului de comparații sau versiunea acestuia astfel încât rezultatele să rămână interpretabile.
Ignorarea derivei de producție: evaluările offline protejează versiunile; evaluarea online și revizuirea umană eșantionată dezvăluie noi comportamente ale utilizatorilor și noi moduri de eșec.
Concluzie
Măsurarea calității răspunsului LLM este o disciplină inginerească, nu o verificare a vibrațiilor. Începeți cu un set de date reprezentativ, definiți dimensiuni de calitate specifice sarcinii, alegeți verificări deterministe oriunde poate fi calculată cerința, utilizați evaluări LLM acolo unde este necesară judecata semantică, calibrați acei evaluări cu oameni și comparați modificările candidatelor cu o bază stabilă. Apoi, transformați fiecare eșec important din lumea reală într-un test de regresie viitor.
Dacă urmați această buclă, cadrul de evaluare devine mai mult decât un tablou de bord de raportare: devine sistemul de control al calității care vă spune dacă o solicitare, un model, o modificare de recuperare sau o actualizare a agentului a îmbunătățit de fapt produsul.