Acasă
» domenii
»
Cum se remediază eroarea „API Timeout” la rularea fluxurilor de lucru cu mai mulți agenți
Cum se remediază eroarea „API Timeout” la rularea fluxurilor de lucru cu mai mulți agenți
O „eroare de expirare API” într-un flux de lucru cu mai mulți agenți este rareori remediată prin modificarea unui singur număr. Un planificator poate apela trei agenți, fiecare agent poate apela un LLM, un serviciu de căutare, o bază de date sau un API de instrumente, iar fiecare strat poate avea propriul timeout, propria politică de reîncercare, propriul pool de conexiuni și propria limită de concurență. Soluția practică este de a identifica care strat expiră primul, apoi de a alege între așteptări mai lungi, mai puține apeluri simultane, reîncercări mai inteligente, o cale critică mai scurtă sau un design asincron al jobului.
Compromisul contează: creșterea unui timeout este simplă, dar menține resursele mai mult timp; reîncercările agresive pot multiplica sarcina și costul; reducerea concurenței îmbunătățește stabilitatea, dar reduce debitul maxim; agenții paraleli reduc latența ceasului de lucru doar atunci când serviciile din aval pot absorbi extinderea. Nu există o singură setare optimă pentru fiecare sistem multi-agent.
Ce timeout execuți de fapt?
Începeți prin a clasifica eșecul în loc să tratați fiecare timeout ca același eveniment. Clienții HTTP pot expira în timp ce se conectează, citesc, scriu sau așteaptă o conexiune de la un pool. HTTPX, de exemplu, documentează patru tipuri separate de timeout-uri: conectare, citire, scriere și pool. Comportamentul său implicit este de a genera un timeout după cinci secunde de inactivitate a rețelei, nu neapărat cinci secunde de durată totală a solicitării. Consultați documentația oficială HTTPX timeout .
Dacă utilizați SDK-ul OpenAI Python, fișierul README oficial actual precizează că solicitările au implicit un timeout de 10 minute pentru client și că erorile de timeout sunt reîncercate de două ori în mod implicit. SDK-ul reîncearcă automat și erorile de conexiune plus răspunsurile HTTP 408, 409, 429 și 5xx cu o scurtă perioadă de așteptare exponențială. Acestea sunt valori implicite ale SDK-ului, nu o garanție că fiecare proxy, echilibrator de încărcare, gateway sau orchestrator din fața solicitării va aștepta 10 minute. Consultați fișierul README oficial al SDK-ului OpenAI Python .
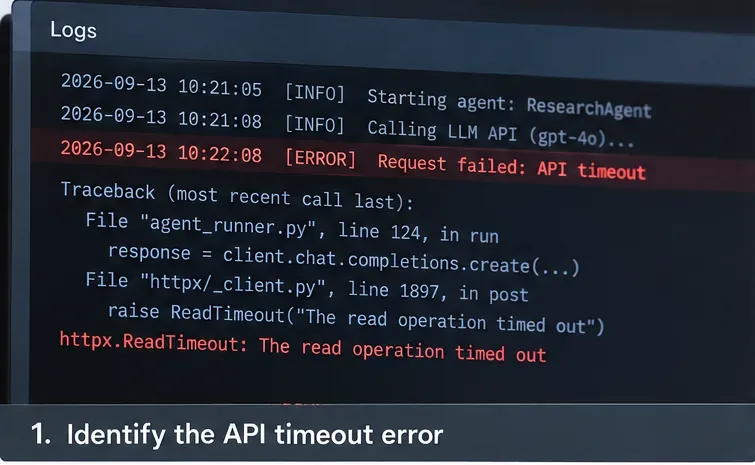
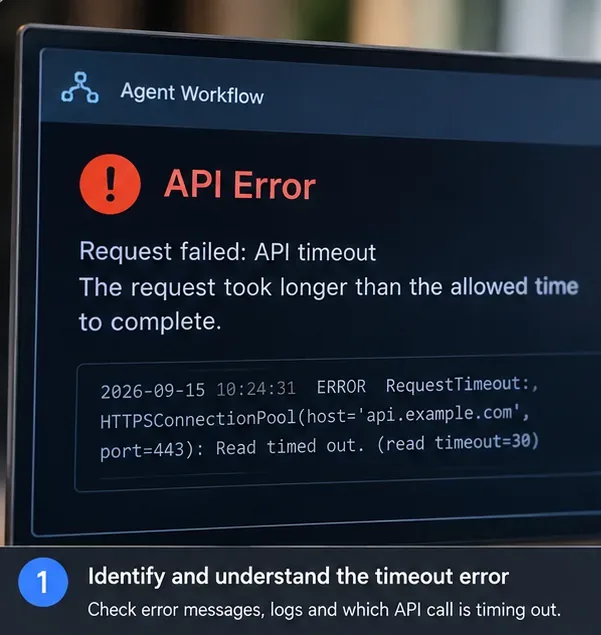
Pasul 1: capturați excepția exactă și agentul, endpoint-ul și stratul de transport care au expirat, în loc să înregistrați doar o eroare generică a fluxului de lucru.
Ce soluție ar trebui să alegi?
Opţiune
Cea mai bună potrivire
Principalul beneficiu
Compromisul principal
Măriți timpul de așteptare pentru solicitare
Apeluri de model/instrument sănătoase, dar în mod legitim lente
Schimbări minime de cod și arhitectură
Lucrătorii și conexiunile rămân ocupate mai mult timp; un gateway din amonte poate totuși termina mai întâi cererea
Reîncercați cu o pauză exponențială
Erori tranzitorii de rețea, limite de rată, erori 5xx selectate
Recuperează automat după defecțiuni de scurtă durată
Poate multiplica traficul, latența și costul; nesigur pentru acțiuni non-idempotente, cu excepția cazului în care este proiectat cu atenție
Concurență mai mică a agenților
429s, timeout-uri în pool, saturație în aval
Reduce rafalele și contențiile în coadă
Randament de vârf mai mic și uneori timp de finalizare a fluxului de lucru mai lung
Paralelizarea agenților independenți
Fluxuri de lucru secvențiale cu ramificații independente
Scurtează calea critică
Crește solicitările simultane și poate declanșa limite de rată sau de conexiune
Ieșire parțială a fluxului
UX interactiv unde latența primului octet contează
Utilizatorii văd progresul mai repede
Nu rezolvă automat o expirare a integrării dure sau un serviciu downstream supraîncărcat
Mută lucrul într-o sarcină/coadă asincronă
Fluxuri de lucru care pot dura zeci de secunde sau minute
Decuplează durata de viață a cererii HTTP de durata de viață a fluxului de lucru
Necesită starea jobului, interogări/webhook-uri, idempotență, persistență și monitorizare operațională
Pasul 1: Găsiți primul strat care depășește termenul limită
Înregistrați un ID de corelare pentru întregul flux de lucru și un ID de interval sau copil pentru fiecare apel de agent și instrument. Înregistrați ora de început, ora de sfârșit, punctul final, numărul încercării, tipul excepției, starea răspunsului, atunci când este disponibilă, și dacă anularea a provenit de la apelant sau de la serviciul din aval.
Întrebarea importantă este „cine a încetat primul să aștepte?”. Dacă apelul LLM se termină în 42 de secunde, dar un gateway API renunță la 30 de secunde, creșterea timeout-ului clientului LLM de la 60 la 120 de secunde nu schimbă nimic. Documentația actuală a Amazon pentru API-urile HTTP API Gateway listează un timeout maxim de integrare de 30 de secunde, ceea ce este un bun exemplu al motivului pentru care cel mai scurt termen limită din lanț determină adesea rezultatul. Consultați cotele API HTTP Amazon API Gateway .
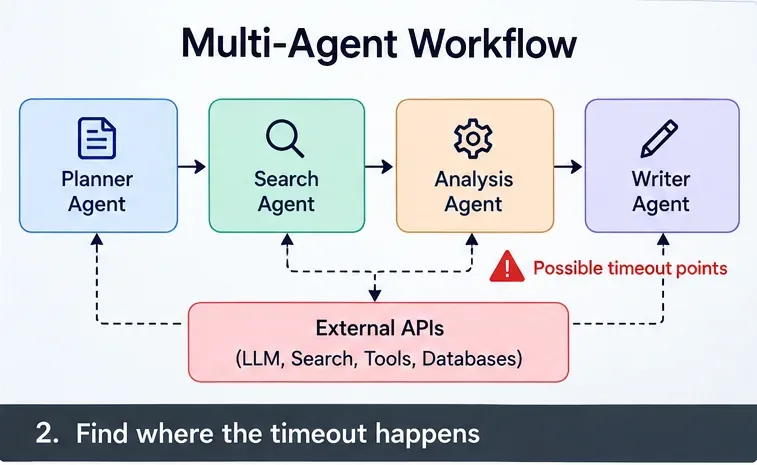
Pasul 2: mapați calea cererii și marcați fiecare loc care poate termina sau întârzia un apel: orchestrator, agent, gateway, API-ul modelului, API-ul de căutare, baza de date și serviciul de instrumente.
Pasul 2: Măsurați calea critică, nu doar latența medie
Latența medie poate părea sănătoasă, în timp ce o serie mică de apeluri lente cauzează majoritatea eșecurilor fluxului de lucru. Urmăriți cel puțin rata de succes per dependență plus latența p50, p95 și p99. Într-o etapă de fan-out, înregistrați și timpul de așteptare la coadă și timpul de așteptare pentru pool-ul de conexiuni, deoarece un „API lent” poate fi de fapt un client supraîncărcat care așteaptă o conexiune liberă.
Folosește urme pentru a răspunde la trei întrebări practice: ce dependență domină calea critică, dacă mai mulți agenți lenți rulează secvențial când ar putea rula concomitent și dacă vârfurile de concurență se aliniază cu erorile 429, pool-timeout sau 5xx.
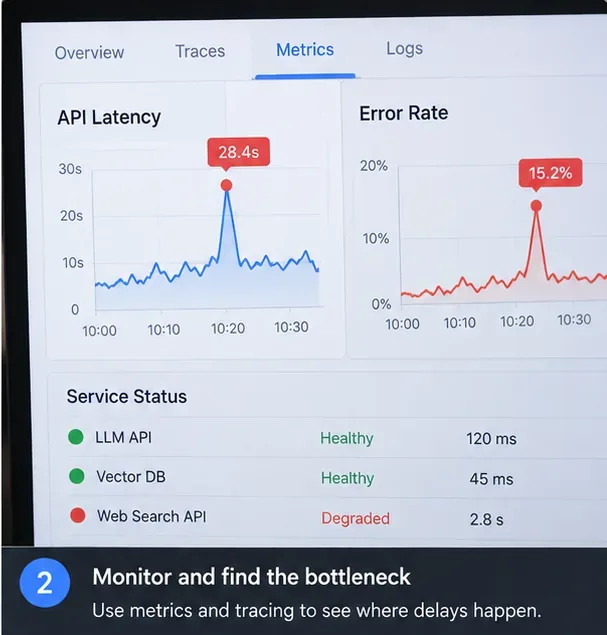
Pasul 3: comparați latența, erorile și starea de sănătate a dependențelor; un vârf de timeout care coincide cu o dependență degradată sugerează o soluție diferită de un vârf de concurență la nivel de sistem.
Pasul 3: Construiți un buget pentru timeout-uri din exterior spre interior
Setați mai întâi un termen limită pentru fluxul de lucru complet, apoi scurtați termenele limită interne, astfel încât nivelurile inferioare să se defecteze suficient de devreme pentru ca orchestratorul să se poată recupera. De exemplu, un termen limită de 120 de secunde pentru utilizator ar putea rezerva 10 secunde pentru orchestrare și gestionarea răspunsurilor, lăsând 110 secunde pentru muncă utilă. Un apel individual de instrument ar putea primi 15 secunde, în timp ce un apel de model ar putea primi 45 sau 60 de secunde, în funcție de latența observată.
Nu copiați aceste valori orbește; acestea sunt un exemplu de metodă de bugetare, nu valori implicite universale. Alegeți valori din distribuția latenței măsurate și din SLO-ul produsului. Termenul limită extern ar trebui să fie suficient de lung pentru a conține apelul intern, reîncercările permise, întârzierile de backoff și timpul de curățare.
Python 3.11 și versiunile ulterioare permit asyncio.timeout()plasarea unui termen limită pentru lucrul asincron. Când termenul limită expiră, sarcina este anulată, iar managerul de context afișează un mesaj TimeoutError. Consultați documentația oficială Python pentru timeout-ul asyncio .
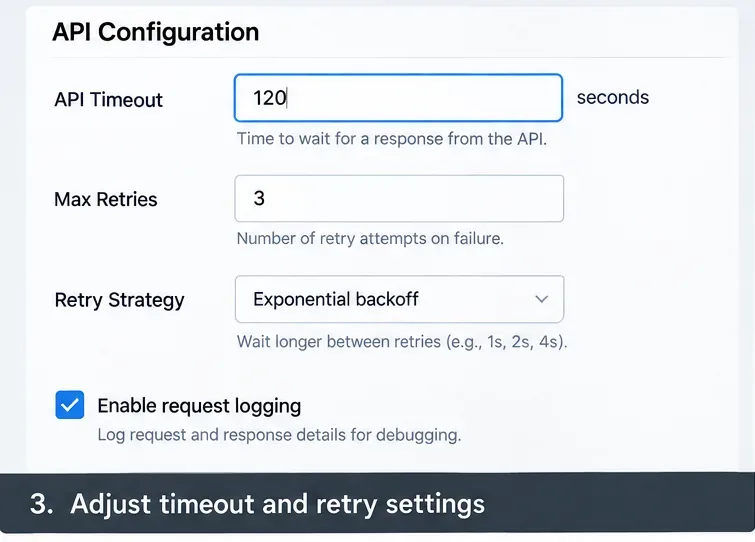
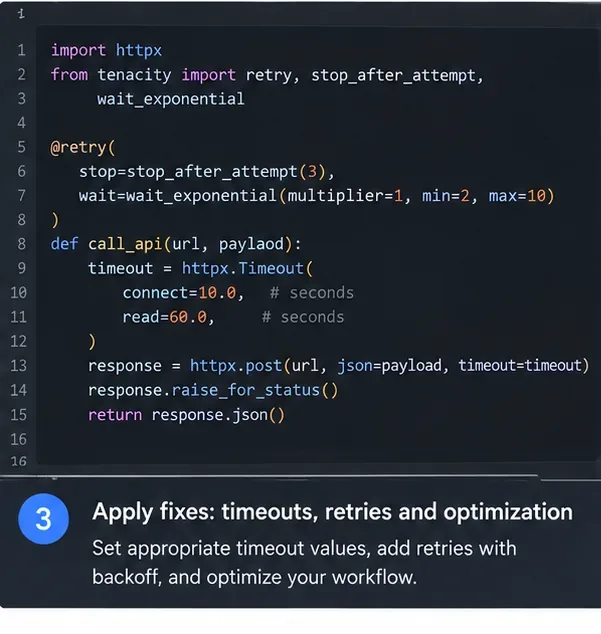
Pasul 4: configurați valorile de timeout și reîncercare ca un buget coordonat, în loc să creșteți fiecare valoare independent.
Pasul 4: Limitați concurența înainte de a crește numărul de reîncercări
Sistemele cu mai mulți agenți eșuează adesea deoarece distribuția fluxului de date crește mai repede decât se aștepta. Dacă 20 de utilizatori solicită fiecare lansarea a câte cinci agenți și fiecare agent lansează două instrumente, sistemul poate crea până la 200 de apeluri downstream înainte de reîncercări. Adăugarea mai întâi a reîncercărilor poate transforma congestia într-o furtună de reîncercări.
Un limitator de concurență este adesea prima mișcare mai bună atunci când observați răspunsuri 429, timeout-uri de pool, creștere a timpului de așteptare sau o dependență downstream la saturație. Python asyncio.Semaphoreoferă o modalitate simplă, bazată pe contor, de a limita câte corutine intră simultan într-o secțiune protejată. Consultați documentația oficială a semaforului Python .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Compromisul este deliberat: o limită inferioară protejează serviciile din aval, dar poate crește așteptarea în coadă în cadrul aplicației. Ajustați-o în funcție de debit, latență p95, limite de rată și capacitate a pool-ului de conexiuni, în loc să alegeți cel mai mare număr pe care mașina dvs. îl poate programa.
Pasul 5: asociați concurența delimitată cu setări de transport explicite, astfel încât un pool complet de conexiuni să nu se deghizeze într-un model sau instrument lent.
Pasul 5: Reîncercați doar eșecurile care au șanse să reușească mai târziu
Reîncercările sunt valoroase pentru erori tranzitorii de conexiune, limite de rată, erori selectate de server și expirarea solicitărilor atunci când repetarea operațiunii este sigură. Acestea reprezintă o opțiune implicită nepotrivită pentru erori de validare, erori de autentificare, erori deterministe ale instrumentelor sau acțiuni cu efecte secundare fără protecție împotriva idempotenței.
Fiți atenți la multiplicarea reîncercărilor. Dacă un SDK face două reîncercări, asta înseamnă până la trei încercări pentru un apel logic. Dacă stratul agentului dvs. reîncearcă, de asemenea, întregul apel de două ori, maximul teoretic devine nouă încercări pentru acea operație logică: trei încercări externe înmulțite cu trei încercări SDK. Dacă orchestratorul reîncearcă apoi o întreagă etapă cu cinci agenți, volumul solicitărilor poate crește rapid.
Centralizați responsabilitatea pentru reîncercări acolo unde este posibil. Pentru apelurile LLM care utilizează SDK-ul OpenAI Python, rețineți că SDK-ul curent reîncearcă deja anumite clase de eșecuri de două ori în mod implicit. Adăugați o reîncercare externă numai atunci când aveți un motiv specific și puteți limita bugetul total de încercări.
Pasul 6: clasificați eroarea înainte de reîncercare; o expirare a timpului de citire poate justifica o reîncercare limitată, în timp ce o eroare de configurare permanentă nu o face de obicei.
Pasul 6: Scurtați calea critică fără a crea o problemă de tip fan-out
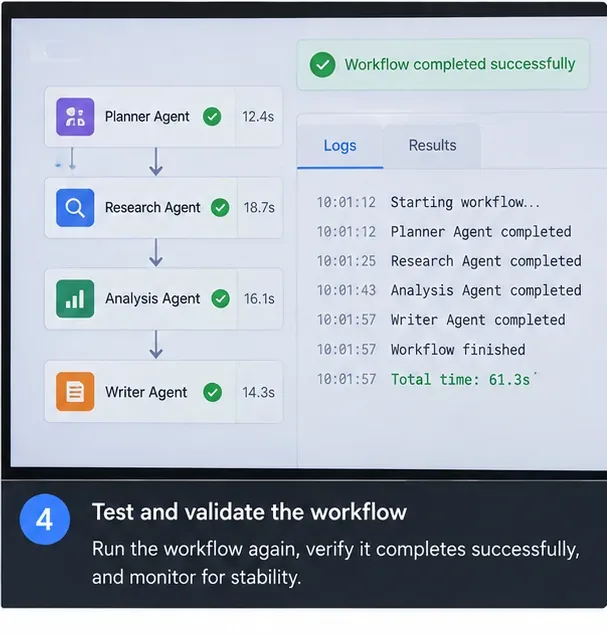
Dacă agenții planificator, cercetător, evaluator și scriitor rulează strict unul după altul, latența totală este aproximativ suma duratelor lor. Ramificațiile independente pot rula uneori concomitent, reducând timpul de funcționare către ramificația cea mai lentă, mai degrabă decât suma tuturor ramificațiilor.
Python asyncio.TaskGroupoferă o modalitate structurată de a executa concomitent sarcini corelate. Documentația actuală Python menționează că TaskGroup așteaptă sarcinile din grup și anulează sarcinile rămase atunci când una eșuează cu o excepție de neanulare, oferind un comportament de siguranță mai puternic decât generarea nestructurată de sarcini. Consultați documentația oficială Python TaskGroup .
Paralelizarea nu este gratuită. Dacă același furnizor impune o limită strictă de solicitări pe minut sau de solicitări concurente, rularea a patru agenți simultan poate transforma un flux de lucru lent, dar eficient, într-o rafală rapidă de 429 de răspunsuri. Paralelizați doar lucrările cu adevărat independente și mențineți limitatorul global de concurență activ.
Pasul 7: Când ar trebui să încetați să utilizați o cerere HTTP sincronă?
Dacă fluxurile de lucru normale depășesc în mod obișnuit cel mai scurt timeout de solicitare din calea rețelei dvs., trecerea la un model de job asincron este de obicei mai curată decât extinderea continuă a fiecărui timeout. Solicitarea HTTP inițială poate valida intrarea, poate crea un job durabil și poate returna imediat un ID de job. Apoi, lucrătorii execută graful multi-agent în afara ciclului de viață al solicitării, în timp ce clientul primește progresul prin interogări, evenimente trimise de server, WebSockets sau un webhook.
Streaming-ul este util atunci când serverul poate începe să trimită ieșiri semnificative din timp. SDK-ul OpenAI Python, de exemplu, acceptă streaming de evenimente trimise de server pentru apelurile API Responses. Streaming-ul îmbunătățește receptivitatea percepută și poate menține o conexiune activă care produce date, dar nu rezolvă automat durata maximă de viață a solicitărilor fiecărui proxy. Consultați referința oficială a evenimentelor de streaming OpenAI .
Alegeți o lucrare asincronă atunci când durabilitatea contează mai mult decât simplitatea imediată: sarcini de cercetare lungi, fluxuri de lucru ale agenților cu aprobare umană, numeroase apeluri de instrumente, operațiuni costisitoare pe care nu doriți să le repetați sau sarcini de lucru care trebuie să supraviețuiască deconectărilor clienților. Costul constă în gestionarea suplimentară a stării: starea lucrării, punctele de control, cheile de idempotență, anularea, stocarea rezultatelor și proprietatea asupra reîncercărilor.
Pasul 7: pentru fluxuri de lucru lungi, urmăriți finalizarea agentului ca o stare durabilă a fluxului de lucru, în loc să vă bazați pe o conexiune client care să rămână deschisă până când fiecare agent termină.
Pasul 8: Validați corecția sub o sarcină realistă
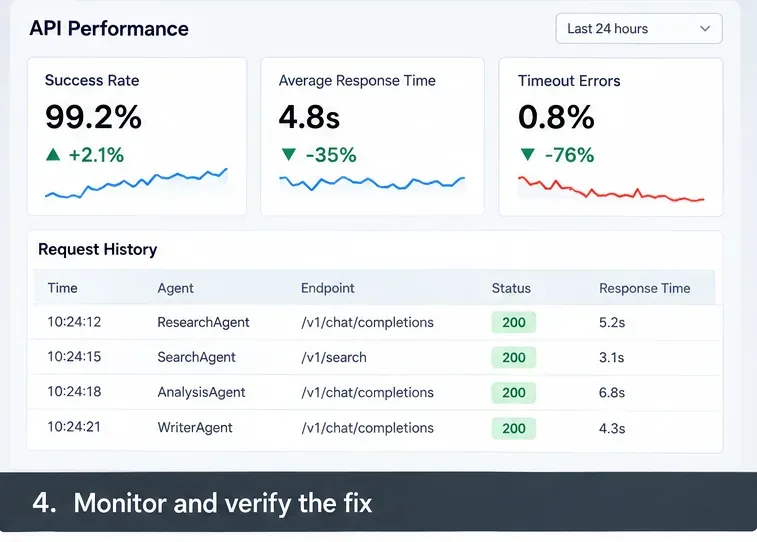
O soluție nu este dovedită deoarece o solicitare are succes. Testați la concurența așteptată în producție și măsurați rata de succes, rata de timeout, încercările de reîncercare per sarcină logică, latența p95 și p99, întârzierea cozii, așteptarea la pool-ul de conexiuni, ratele downstream 429/5xx și costul per flux de lucru finalizat.
Dacă rulați agenți în Kubernetes, utilizați parametrii de pregătire și funcționare (leaveness) în scopuri diferite. Kubernetes documentează sondele de pregătire ca mecanism care determină dacă un Pod ar trebui să primească trafic, în timp ce sondele de funcționare determină când ar trebui repornit un container. Documentația sa avertizează în mod explicit că verificările de funcționare implementate defectuos pot provoca erori în cascadă sub sarcină. Consultați documentația oficială a sondelor Kubernetes .
Pentru supraîncărcarea temporară, a deveni „indisponibil” este adesea mai sigur decât a ucide în mod repetat lucrătorii sănătoși, dar ocupați. Rezervați erorile de funcționare pentru condițiile în care repornirea procesului este cu adevărat acțiunea de recuperare corectă.
Pasul 8: verificați modificarea cu metrici de trafic și latență de tip „tail” similare cu cele din producție, nu doar cu o singură rulare de test reușită.
Cum îți dai seama care soluție este potrivită pentru tiparul tău de eșec?
Model observat
Cea mai utilă primă schimbare
Ce să nu faci mai întâi
Apelurile se termină imediat după termenul limită al clientului; apelurile din aval sunt sănătoase
Măriți termenul limită intern specific și reevaluați termenul limită extern
Creșteți numărul de reîncercări
429s și timeout-urile pool cresc odată cu concurența
Reduceți concurența și adăugați așteptare/contrapresiunea
Lansează mai mulți agenți în paralel
Erori ocazionale de tip 408/5xx sau de rețea
Folosește reîncercări exponențiale limitate pentru operații idempotente
Reîncercați fiecare excepție pe termen nelimitat
Fluxul de lucru durează în mod obișnuit mai mult decât limitele gateway-ului
Folosește o arhitectură de joburi asincrone sau un design de streaming acceptat
Continuă să crești doar timeout-ul SDK-ului
O dependență lentă domină latența p99
Optimizați, memorați în cache, înlocuiți sau izolați dependența respectivă; luați în considerare o soluție de rezervă
Reglați timeout-urile agenților nelegați
Eșecurile apar numai după adăugarea agenților paraleli
Păstrați paralelismul util, dar adăugați un semafor global și limite per furnizor
Presupunem că paralelul este întotdeauna mai rapid
O bază practică de producție
Pentru o API multi-agent tipică, o bază robustă este de a atribui fiecărui flux de lucru un ID de corelație, de a urmări fiecare apel de agent și instrument, de a defini un termen limită end-to-end, de a atribui termene limită mai scurte per apel în cadrul acestuia, de a impune o limită globală de concurență per furnizor din aval, de a menține reîncercările limitate și idempotente și de a persista suficientă stare pentru a relua sau a raporta finalizarea parțială.
Apoi, ajustați pornind de la măsurători. Dacă sistemul este stabil, dar prea lent, paralelizați selectiv munca independentă. Dacă este rapid la sarcină mică, dar eșuează la sarcină maximă, reduceți fan-out-ul și adăugați contrapresiunea. Dacă fluxurile de lucru reușite durează în mod natural mai mult decât permite calea de solicitare sincronă, schimbați arhitecturile în loc să încercați să faceți fiecare proxy să aștepte mai mult.