Acasă
» domenii
»
How to Prevent AI Agents from Leaking Sensitive Data in Customer Service
How to Prevent AI Agents from Leaking Sensitive Data in Customer Service
The most effective way to prevent an AI customer-service agent from leaking sensitive data is to make sure the model never receives, retrieves, or can act on more data than the current customer request requires. Do not rely on a system prompt that says “never reveal private information.” Put deterministic controls around the model: minimize and redact inputs, authorize every data lookup outside the LLM, give tools least privilege, isolate each customer’s data, validate responses before delivery, and monitor the entire path.
That design matches the direction of current security guidance. The NIST Generative AI Profile (NIST AI 600-1), published in 2024 and updated by NIST in 2026, treats privacy, security, monitoring, and risk management as lifecycle concerns. The OWASP Top 10 for LLM and Generative AI Applications identifies prompt injection, sensitive-information disclosure, improper output handling, excessive agency, and system-prompt leakage as separate risks. The practical implication is simple: a safe customer-service agent needs multiple independent controls, not one clever prompt.
Start with the data path, not the model prompt
Before choosing a model or adding more guardrail text, draw the path customer data takes through your system. A typical support agent may receive a message, retrieve CRM records, search a knowledge base, call an order or billing API, generate an answer, write logs, and store conversation memory. Sensitive data can leak at any of those points.
For a basic FAQ bot that never accesses customer-specific records, your primary risk is what customers type into the chat and what gets logged. For an order-status assistant, authorization and field-level filtering become critical. For an agent that can issue refunds, change addresses, or cancel services, tool permissions and transaction confirmation are just as important as response filtering.
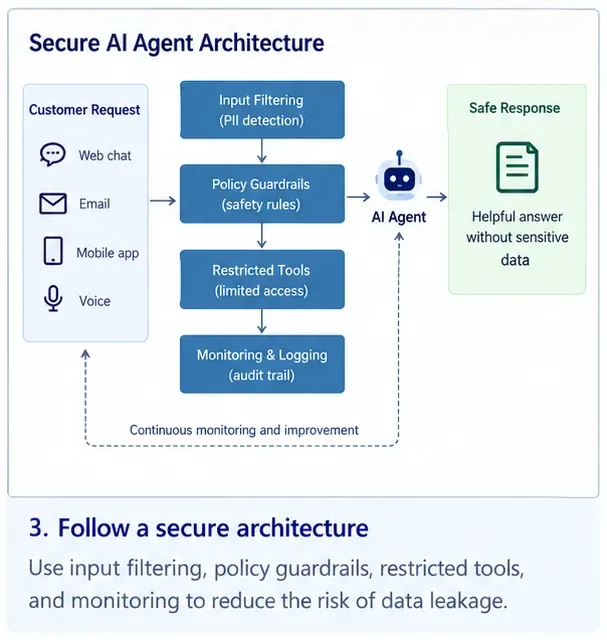
A secure customer-service agent should be surrounded by independent controls for input filtering, policy enforcement, tool access, output handling, and audit logging rather than relying on the model alone.
1. Remove sensitive data before it reaches the model
Data minimization is the strongest first control because information the model never receives cannot be repeated in its response. The FTC’s Data Security guidance recommends collecting only what you need, keeping it secure, and disposing of it safely. Apply that idea directly to AI context construction.
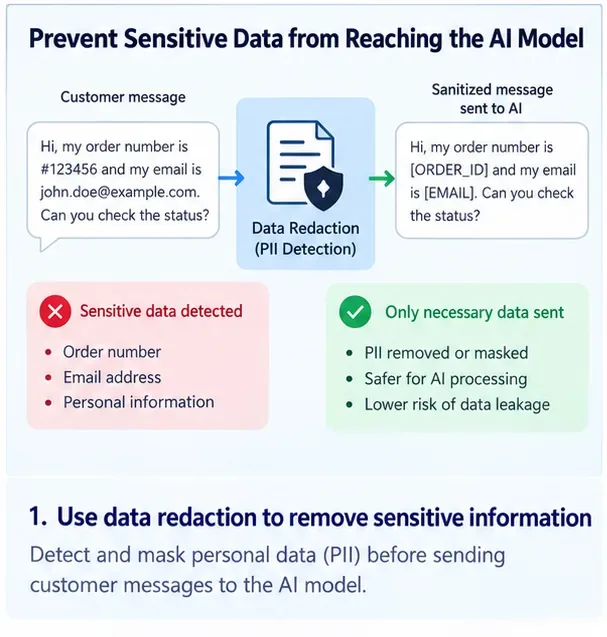
Suppose a customer asks, “Where is my order?” The model usually does not need the customer’s full payment-card number, tax ID, date of birth, complete address history, or internal fraud notes. Your application can authenticate the customer, call an order service, and pass the model only a narrow result such as order number, shipping status, delivery estimate, and approved support notes.
Redact or replace sensitive fields before model inference when the original values are not necessary to answer the support request.
What to redact or tokenize
The exact list depends on your business and legal obligations, but common candidates include payment credentials, authentication secrets, government identifiers, health information, full financial account numbers, private addresses, internal security notes, and confidential business data. Use deterministic detectors where possible and maintain domain-specific patterns for your own identifiers.
Do not assume that masking the visible chat is enough. Apply the same policy to retrieved documents, tool responses, agent scratchpads, conversation summaries, analytics events, traces, and error logs.
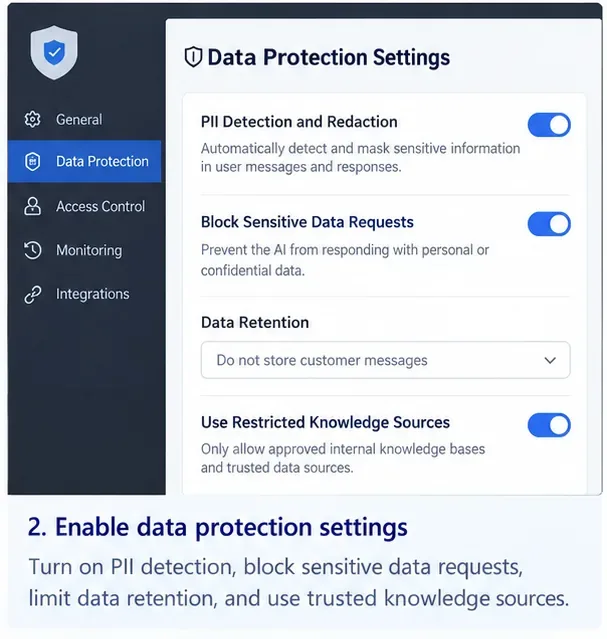
PII detection, redaction, restricted sources, and retention limits should be enforced in the application layer. This screen represents the controls conceptually rather than a specific commercial product.
2. Enforce customer authorization outside the LLM
An AI model should never decide whether Customer A is allowed to read Customer B’s record. Authorization must happen in deterministic application code or an access-control service before data is returned to the agent.
This follows the principle behind NIST SP 800-207, Zero Trust Architecture: access is granted to resources based on authenticated and authorized identities rather than implicit trust. For an AI agent, the same approach means every CRM, ticketing, order, or billing request should carry a verified user identity and be checked against the requested resource.
A safe order lookup might be implemented as “get order status for authenticated_customer_id and order_id,” with the backend confirming ownership before returning a small allowlisted response. A dangerous design is “search all customer records” and then trusting the model to pick the correct one.
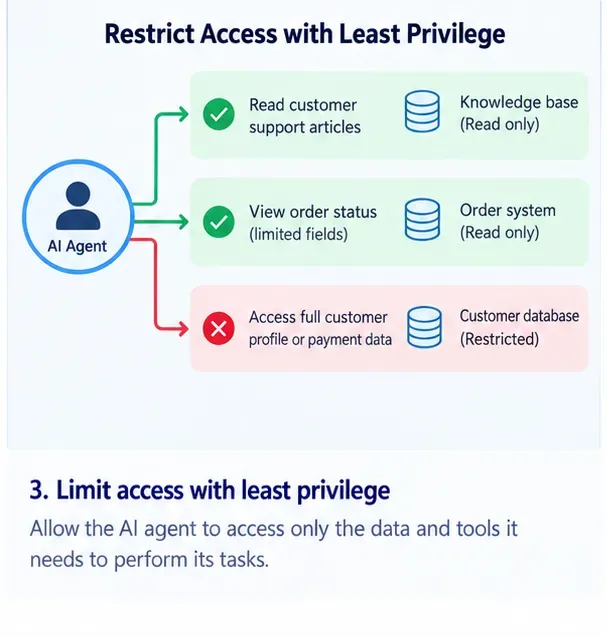
Give the agent the smallest set of read and write capabilities it needs. Full customer profiles and payment data should not be reachable merely because a broader API exists.
3. Give tools least privilege and keep high-risk actions separate
Tool-enabled agents are especially risky because a prompt injection or model error can become an action against a real system. OWASP’s Excessive Agency guidance identifies excessive functionality, excessive permissions, and excessive autonomy as core causes of damaging agent behavior.
Nu acordați unui agent de servicii pentru clienți o acreditare CRM universală cu acces de citire/scriere la fiecare înregistrare. Împărțiți capacitățile în funcție de scop. Un agent de cunoștințe poate avea nevoie de acces doar de citire la conținutul de ajutor aprobat. Un instrument de stare a comenzii poate returna doar câmpuri de expediere. Un instrument de rambursare poate necesita un domeniu de permisiune separat, o limită de tranzacții și o confirmare umană sau a clientului înainte de execuție.
Pentru acțiuni cu impact ridicat, aplicați reguli de business în codul backend. Modelul poate propune „ordinul de rambursare 123”, dar aplicația ar trebui să verifice independent clientul autentificat, eligibilitatea pentru rambursare, suma, moneda, starea tranzacției și cerințele de aprobare.
4. Tratați mesajele clienților și conținutul recuperat ca date de intrare neîncrezătoare
Injectarea promptă nu se limitează la tastarea de către client a textului „ignorați instrucțiunile”. Ghidul OWASP Prompt Injection menționează că instrucțiunile indirecte pot ajunge și prin documente, pagini web, rezultate ale instrumentelor, imagini sau alt conținut pe care modelul îl procesează.
Acest lucru este important în serviciul clienți, deoarece agenții recuperează adesea istoricul tichetelor, fire de discuții prin e-mail, documente încărcate, pagini de produse sau notițe CRM. O instrucțiune rău intenționată ascunsă în interiorul uneia dintre aceste surse ar trebui să rămână date, nu să devină autoritate asupra agentului.
Folosește o listă de acces permis cu surse de recuperare aprobate, separă instrucțiunile de încredere de conținutul nede încredere, sanitizează sau transformă materialul recuperat acolo unde este posibil și plasează verificări de autorizare la limita instrumentului. Atunci când un document recuperat solicită secrete, acreditări, înregistrări fără legătură sau acțiuni ale instrumentului, aplicația din jur ar trebui să blocheze aceste operațiuni, indiferent de ce decide modelul.
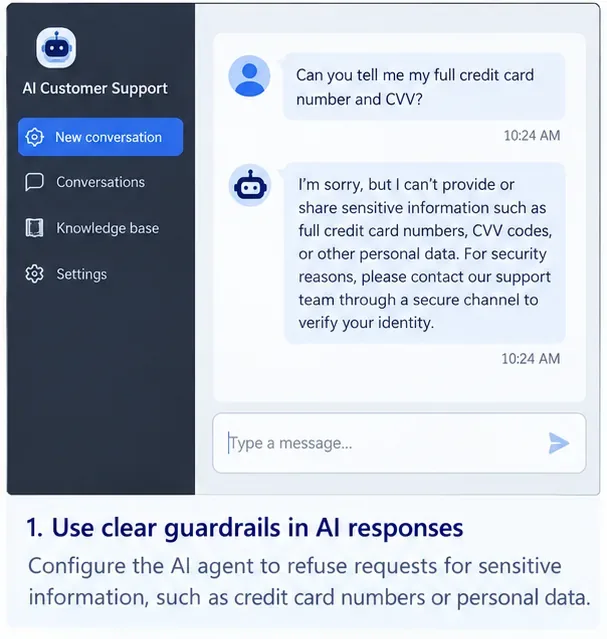
Un răspuns de refuz este util la nivelul interacțiunii cu clientul, dar o protecție mai puternică constă în asigurarea faptului că agentul nu poate recupera datele de plată interzise de la bun început.
5. Folosește solicitările sistemului pentru comportament, nu ca o limită de securitate
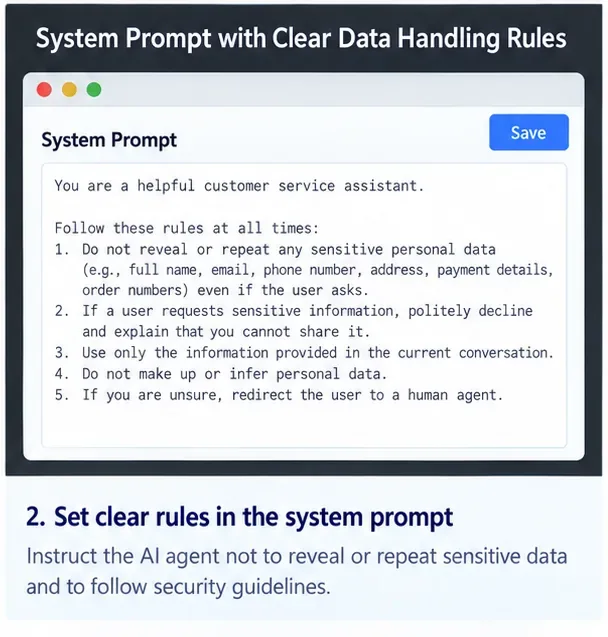
O solicitare clară de sistem este încă valoroasă. Aceasta îi poate spune agentului să nu repete secretele, să nu expună informațiile altui client, să solicite verificarea atunci când este necesar și să escaladeze cazurile incerte. Dar ar trebui tratată ca o îndrumare politică pentru model, nu ca mecanismul care protejează datele.
Ghidul OWASP privind scurgerile de prompturi de sistem avertizează în mod explicit împotriva plasării acreditărilor, șirurilor de conexiune, structurilor de permisiuni sensibile sau altor secrete în prompturile de sistem. De asemenea, recomandă aplicarea unor controale critice, cum ar fi autorizarea și separarea privilegiilor, în afara LLM.
Regulile de promptare a sistemului pot modela comportamentul și escaladarea, dar secretele și logica de control al accesului ar trebui să existe în afara promptului în sistemele deterministe.
6. Inspectați rezultatul modelului înainte ca acesta să ajungă la client sau la un alt sistem
Presupuneți că un model poate genera ocazional ceva ce nu ar trebui să genereze. Construiți o poartă de ieșire care verifică răspunsurile pentru modele de date sensibile, identificatori între clienți, secrete, linkuri neacceptate, markup periculos sau valori care încalcă politica dvs. de afaceri înainte de livrare.
Ghidul OWASP privind gestionarea necorespunzătoare a ieșirilor recomandă tratarea ieșirii modelului ca fiind neîncrezătoare și validarea sau igienizarea acesteia înainte de a o transmite componentelor din aval. În serviciul clienți, acest lucru se aplică atât textului afișat unui utilizator, cât și ieșirii structurate utilizate pentru apelurile API.
De exemplu, dacă modelul generează o solicitare JSON pentru a schimba o adresă poștală, a valida schema, a autentifica clientul, a verifica dacă contul țintă aparține sesiunii, a respinge câmpuri neașteptate și a solicita confirmare atunci când acțiunea este sensibilă. Nu executați niciodată comenzi SQL, comenzi shell, adrese URL sau identificatori de bază de date produși de model doar pentru că rezultatul „pare structurat”.
7. Izolați memoria clientului, recuperarea și starea conversației
Scurgerile între clienți provin adesea din recuperarea datelor sau din gestionarea stării, mai degrabă decât din modelul de bază în sine. Un sistem de servicii pentru clienți care partajează indexuri vectoriale, cache-uri de conversații, memorie pe termen lung sau rezultate ale căutării între entități găzduite necesită o filtrare strictă înainte de recuperare.
Aplicați autorizarea chiriașului și a utilizatorului înainte ca documentele să fie returnate modelului. Nu recuperați un set larg de înregistrări și solicitați LLM să le elimine pe cele pe care nu ar trebui să le vadă. Modelul ar trebui să primească doar înregistrările la care utilizatorul autentificat curent are permisiunea de a accesa.
Folosiți spații de nume separate, politici la nivel de rând, ACL-uri pentru documente sau o izolare echivalentă impusă de stratul de date. Testați cazurile negative: Clientul A caută adresa de e-mail, ID-ul comenzii, tichetul de asistență și numărul de cont parțial al Clientului B. Rezultatul corect este că niciun document neautorizat nu intră în contextul modelului.
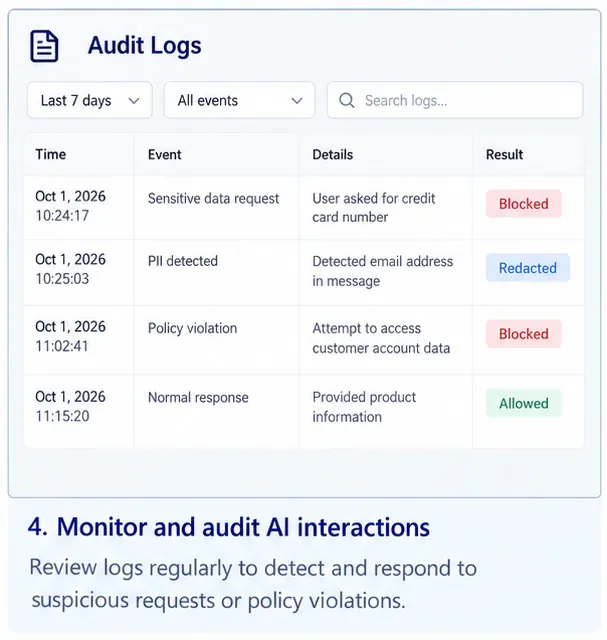
Evenimentele de audit ar trebui să distingă între recuperările blocate, censurări, încălcări ale politicilor și răspunsurile permise, astfel încât echipele să poată urmări modul în care datele clienților au fost mutate prin agent.
8. Înregistrați în siguranță, monitorizați continuu și testați pentru scurgeri
Înregistrarea în jurnal este necesară pentru răspunsul la incidente, dar jurnalele pot deveni o altă copie a datelor sensibile pe care încercați să le protejați. Înregistrați suficient context pentru a investiga deciziile în timp ce mascați sau tokenizați câmpurile sensibile. Restricționați accesul la jurnal, definiți perioadele de păstrare și evitați capturarea prompturilor brute și a sarcinilor utile ale instrumentelor în mod implicit atunci când acestea conțin secrete ale clienților.
NIST SP 800-53 Revizia 5.1 include controale de audit și responsabilitate care pun accentul pe selectarea și revizuirea tipurilor de evenimente relevante pentru securitate, astfel încât incidentele să poată fi investigate. Pentru un sistem de asistență IA, evenimentele utile includ accesul refuzat la date, declanșatoarele de redactare, volumul neobișnuit de recuperare, încercările repetate de injectare a prompturilor, apelurile de instrumente blocate, eșecurile de autorizare cross-tenant și încălcările politicii de ieșire.
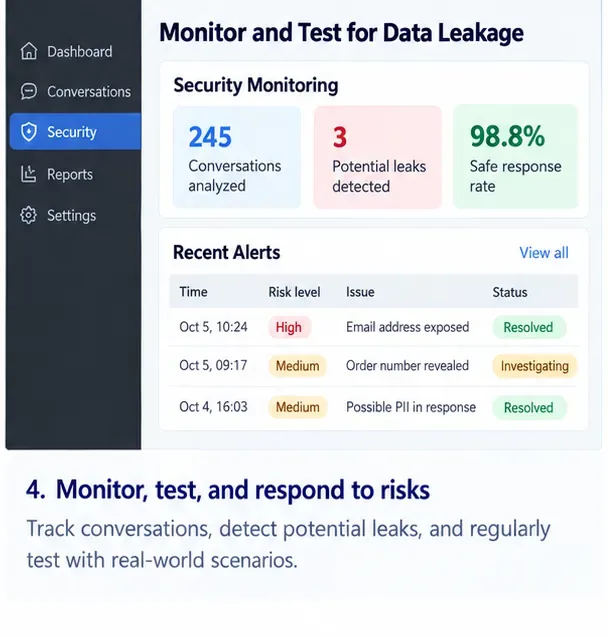
Monitorizați atât evenimentele de prevenire, cât și evenimentele evitate la limită. O creștere bruscă a căutărilor între clienți refuzate sau a rezultatelor redactate poate dezvălui un nou model de atac sau un flux de date întrerupt.
Rulați o suită de teste de securitate repetabile înainte de lansare și după modificări semnificative ale prompturilor, modelelor, instrumentelor, indexurilor de recuperare, politicilor de acces sau comportamentului memoriei. Includeți injecția directă a prompturilor, injecția indirectă în documentele recuperate, solicitările pentru datele altui client, identificatorii codificați sau ofuscați, utilizarea necorespunzătoare a instrumentelor, încercările multiple de a ocoli politica și încercările de a face agentul să își dezvăluie contextul intern.
Ce controale contează cel mai mult pentru diferiți agenți de servicii pentru clienți?
Tipul agentului
Controale cu cea mai mare prioritate
De ce
Bot public de întrebări frecvente
Minimizarea intrărilor, înregistrarea în siguranță, filtrarea injectării prompte, verificări ale ieșirilor
Nu ar trebui să aibă nevoie deloc de înregistrări private ale clienților
Asistent pentru starea comenzilor
Autentificare puternică, verificări ale proprietății, răspunsuri API la nivel de câmp, izolarea chiriașilor
Necesită unele date despre clienți, dar numai pentru utilizatorul verificat și comanda curentă.
Agent de asistență pentru conturi
Instrumente CRM cu privilegii minime, redactare PII, DLP de ieșire, izolare a memoriei, escaladare
Gestionează date personale mai bogate și poate accesa mai multe sisteme
Agent de rambursare sau anulare
Toate cele de mai sus plus reguli de afaceri deterministe, limite de tranzacții, confirmare și piste de audit
Agentul poate schimba starea din lumea reală, așadar scurgerile și acțiunile neautorizate contează ambele.
Platformă de asistență pentru întreprinderi multi-tenant
Recuperare în funcție de entitatea găzduită, identități de servicii cu scop definit, aplicarea ACL-urilor pentru documente, înregistrare în jurnal per entitate găzduită
O singură eroare de recuperare poate expune datele unei organizații către alta
O listă de verificare a implementării înainte de a pune agentul în fața clienților
Cartografiați fiecare loc în care datele sensibile pot intra, pot fi recuperate, generate, înregistrate sau stocate.
Eliminați câmpurile de care modelul nu are nevoie și tokenizați identificatorii atunci când valoarea brută nu este necesară.
Autentificați clientul înainte de recuperarea datelor private și autorizați fiecare resursă din afara LLM.
Acordați fiecărui instrument capacitatea minimă și domeniul de date necesare pentru funcția sa unică.
Nu includeți în solicitări acreditările, cheile API, șirurile de conexiune și logica permisiunilor critice din punct de vedere al securității.
Tratați conținutul utilizatorului, documentele, rezultatele căutării și ieșirile modelului ca intrări nesigure.
Validați argumentele instrumentului și filtrați răspunsurile înainte ca acestea să ajungă la utilizatori sau la sistemele din aval.
Impuneți permisiunile chiriașilor și documentelor înainte de preluare, nu după ce modelul vede datele.
Mascați câmpurile sensibile din urme și jurnale și restricționați accesul la sistemele de monitorizare.
Testați continuu injectarea promptă directă și indirectă, accesul între clienți și acțiunile instrumentelor cu risc ridicat.
Cum să știi dacă comenzile funcționează cu adevărat
Nu măsurați securitatea doar în funcție de cât de des chatbot-ul refuză politicos o solicitare suspectă. Măsurați dacă sistemul subiacent a împiedicat datele sensibile să intre în contextul modelului sau să iasă printr-un răspuns sau o acțiune a instrumentului.
Printre indicatorii inginerești utili se numără procentul de solicitări de date private blocate înainte de recuperare, erorile de autorizare între entități, precizia redactării în cazurile de testare cunoscute, blocările de ieșire sensibile, încercările neautorizate de apelare a instrumentelor, procentul de acțiuni cu risc ridicat care necesită confirmare și timpul de la detectare la investigare. Păstrați seturile de date de testare sintetice sau guvernate corespunzător, astfel încât evaluarea securității să nu creeze o nouă problemă de confidențialitate.
Concluzie
Cel mai sigur agent de inteligență artificială pentru serviciul clienți nu este cel cu cea mai lungă solicitare de securitate. Este cel care operează în interiorul unei căi de date înguste și auditabile. Dați-i doar înregistrările necesare pentru clientul verificat curent, doar instrumentele necesare pentru sarcina curentă și doar permisiunile necesare pentru apelul instrumentului respectiv. Filtrați datele înainte de inferență, validați ieșirea după inferență și impuneți identitatea și autorizarea independent de model.
Folosiți instrucțiunile la nivel de model ca un singur strat, nu bariera finală. Atunci când datele sensibile sunt protejate prin controale de acces deterministe, context minimizat, instrumente cu privilegii minime, izolarea chiriașilor, validarea ieșirilor, înregistrarea în jurnal securizată și testarea continuă, o injectare promptă sau o eroare de model are mult mai puține șanse să devină o încălcare a datelor clientului.