การใช้งาน Meta Llama 3 8B รุ่นดั้งเดิมบนแล็ปท็อประดับกลางนั้น ไม่ได้อยู่ที่การค้นหาการตั้งค่าวิเศษเพียงอย่างเดียว แต่อยู่ที่การรักษาพื้นที่หน่วยความจำให้เพียงพอเพื่อให้โมเดลทำงานได้อย่างเสถียร พร้อมทั้งรักษาคุณภาพของผลลัพธ์ให้อยู่ในระดับที่ใช้งานได้ดี สำหรับแล็ปท็อปส่วนใหญ่ที่มี VRAM เฉพาะ 4 ถึง 8 GB จุดเริ่มต้นที่ดีที่สุดคือการใช้การควอนไทเซชัน GGUF 4 บิต หน้าต่างบริบท 2K ถึง 4K การใช้งานเจเนอเรชันเดียวในแต่ละครั้ง และการถ่ายโอนภาระ GPU ให้มากที่สุดเท่าที่เครื่องจะรับได้โดยไม่ทำให้ VRAM หมด
บทความนี้มุ่งเน้นไปที่ โมเดล Llama 3 8B รุ่นดั้งเดิม ที่วางจำหน่ายในเดือนเมษายน 2024 โดยเฉพาะ ดัชนีโมเดลปัจจุบันของ Meta ยังคงแยกความแตกต่างระหว่างโมเดลนี้กับ Llama 3.1, 3.2 และรุ่นต่อๆ มา โมเดล Llama 3 8B และ 70B รุ่นดั้งเดิมได้รับการฝึกฝนด้วยความยาวบริบท 8K ในขณะที่ Llama 3.1 และรุ่นต่อๆ มาในตระกูลเดียวกันใช้ขีดจำกัดที่แตกต่างกัน คลังเก็บข้อมูล GitHub ของ Llama 3 รุ่นดั้งเดิมของ Meta ถูกเก็บถาวรในเดือนมีนาคม 2026 และปัจจุบันแนะนำให้นักพัฒนาไปที่คลังเก็บข้อมูล Meta llama-models ที่รวมกันไว้แล้ว ข้อมูลจำเพาะดั้งเดิมยังได้รับการบันทึกไว้ในเอกสารแนะนำโมเดล Llama 3 8B อย่างเป็นทางการของ Metaด้วย
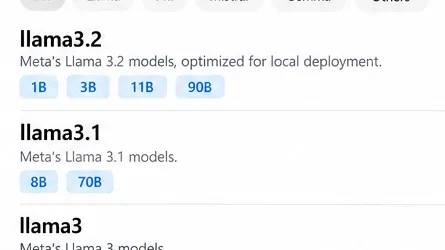 Llama 3 รุ่นดั้งเดิมเป็นตระกูลรุ่นที่แยกต่างหากจาก Llama 3.1 และ Llama 3.2 การตั้งค่าด้านล่างนี้มุ่งเป้าไปที่รุ่น 8B ดั้งเดิมซึ่งมีข้อจำกัดด้านเนื้อหาที่ความละเอียด 8K
การตั้งค่าพื้นฐานที่ดีที่สุดสำหรับ VRAM 4–8 GB
หากคุณต้องการค่าพื้นฐานที่ใช้งานได้จริงเพียงค่าเดียวก่อนการปรับแต่งอย่างละเอียด ให้เริ่มต้นด้วยLlama 3 8B Instruct ใน Q4_K_M GGUFตั้งค่าคอนเท็กซ์เป็น 4,096 โทเค็น รักษาการร้องขอแบบขนานไว้ที่หนึ่ง เปิดใช้งานหรือปล่อยให้ Flash Attention เป็นแบบอัตโนมัติ และปล่อยให้รันไทม์ของคุณเลือกการถ่ายโอนข้อมูล GPU สูงสุดที่ยังคงเหลือพื้นที่ว่างใน VRAM สำหรับ GPU ขนาด 4 GB ให้ลดคอนเท็กซ์ลงเหลือ 2,048 โทเค็น และคาดหวังการถ่ายโอนข้อมูล CPU เพียงบางส่วน
| VRAM เฉพาะ | การกำหนดปริมาณที่แนะนำ | บริบทเริ่มต้น | แบทช์ / ไมโครแบทช์ | การประมวลผล GPU | ผลลัพธ์ที่ดีมีลักษณะอย่างไร |
|---|
| 4 GB | Q4_K_M พร้อมการถ่ายโอนข้อมูลบางส่วน; Q3_K_M เฉพาะเมื่อจำเป็นเท่านั้น | 2,048 | 128 / 64–128 | อัตโนมัติหรือบางส่วน | ไม่มีข้อผิดพลาดหน่วยความจำไม่เพียงพอ ระบบปฏิบัติการยังคงตอบสนองได้ดี ความเร็วในการสร้างข้อมูลอยู่ในระดับที่ยอมรับได้ |
| 6 GB | คิว4_เค_เอ็ม | 4,096 | 256 / 128–256 | อัตโนมัติ; ถ่ายโอนเต็มที่หากพอดี | เลเยอร์ส่วนใหญ่หรือทั้งหมดทำงานบน GPU โดยที่ VRAM ไม่เต็มประสิทธิภาพ |
| 8 GB | Q5_K_M สำหรับคุณภาพ หรือ Q4_K_M สำหรับพื้นที่บริบทที่มากขึ้น | 4,096; ทดสอบ 8,192 ครั้งหลังจากนั้น | 512 / 256 | อัตโนมัติหรือเต็มรูปแบบ | เน้นการใช้งาน 4K ที่เสถียรก่อน ส่วน 8K นั้นค่อยพิจารณาเมื่อหน่วยความจำยังเหลือเพียงพอ |
นี่เป็นเพียงจุดเริ่มต้น ไม่ใช่การรับประกัน การ์ดจอแล็ปท็อปมักจะสงวน VRAM บางส่วนไว้สำหรับจอแสดงผล และระบบระบายความร้อน ไดรเวอร์ หน่วยความจำระบบ และโครงสร้างของ GGUF ล้วนส่งผลต่อปริมาณหน่วยความจำที่ใช้งานได้จริง การกำหนดค่าที่ใช้งานได้กับ GPU 8 GB เครื่องหนึ่ง อาจใช้งานไม่ได้กับแล็ปท็อป 8 GB อีกเครื่องหนึ่ง หากส่วนประมวลผลกราฟิกหรือภาระงานบนเดสก์ท็อปใช้หน่วยความจำมากกว่านั้น
เหตุใด Q4_K_M จึงมักเป็นจุดเริ่มต้นที่ดีที่สุดสำหรับ VRAM ต่ำ
การควอนไทเซชันหมายถึงการจัดเก็บน้ำหนักของโมเดลด้วยความแม่นยำที่ต่ำกว่า เพื่อให้โมเดลใช้หน่วยความจำน้อยลง วิธีนี้ช่วยลดขนาดของน้ำหนักโมเดล แต่การควอนไทเซชันที่มากเกินไปก็อาจลดคุณภาพของคำตอบได้เช่นกัน ข้อมูลอ้างอิงของตัวควอนไทเซอร์ llama.cpp ในปัจจุบันสำหรับ Llama-3-8B ให้การเปรียบเทียบที่เป็นประโยชน์: Q3_K_M อยู่ที่ประมาณ 3.74G โดยมีค่า perplexity เพิ่มขึ้นมาก Q4_K_M อยู่ที่ประมาณ 4.58G โดยมีค่าเพิ่มขึ้นน้อยกว่า และ Q5_K_M อยู่ที่ประมาณ 5.33G โดยมีค่าเพิ่มขึ้นน้อยกว่าเช่นกัน คุณสามารถตรวจสอบค่าเหล่านี้ได้โดยตรงในซอร์สโค้ดของตัวควอนไทเซอร์ llama.cpp
| ปริมาณ | ขนาดอ้างอิงของไฟล์ llama.cpp สำหรับ Llama-3-8B | อ้างอิง Δ ความซับซ้อน | การใช้งานที่ดีที่สุด |
|---|
| คิว3_เค_เอ็ม | ประมาณ 3.74 กรัม | +0.6569 | หน่วยความจำมีจำกัดมากจน Q4_K_M ไม่สามารถทำงานได้อย่างสะดวกสบาย |
| คิว4_เค_เอ็ม | ประมาณ 4.58 กรัม | +0.1754 | สมดุลโดยรวมที่ดีที่สุดสำหรับแล็ปท็อปที่มี VRAM 4–6 GB |
| Q5_K_M | ประมาณ 5.33 กรัม | +0.0569 | ตัวเลือกที่เน้นคุณภาพเป็นหลักสำหรับ VRAM 8 GB เมื่อยังมีพื้นที่เหลือเฟือ |
ความซับซ้อนไม่ใช่สิ่งเดียวกับคุณภาพที่ผู้ใช้รับรู้ ดังนั้นอย่าใช้ตัวเลขเหล่านั้นเป็นการจัดอันดับสากลสำหรับทุกงาน ตัวเลขเหล่านั้นมีประโยชน์ที่สุดสำหรับการเลือกจัดลำดับการทดลองที่เหมาะสม หาก Q4_K_M ตอบคำถามของคุณได้ดี การลดไปใช้ Q3 เพียงเพื่อให้โมเดลพอดีกับ VRAM อย่างสมบูรณ์อาจไม่ใช่การแลกเปลี่ยนที่คุ้มค่า การถ่ายโอนงานบางส่วนไปยัง GPU สามารถรักษาน้ำหนักของโมเดล Q4 ไว้ได้ ในขณะที่ย้ายงานบางส่วนไปยัง RAM ของระบบ
เอกสารประกอบการใช้งานปัจจุบันของ LM Studio อธิบายในทำนองเดียวกันว่า รุ่น 4 บิตเป็นค่าเริ่มต้นที่เหมาะสมเมื่อเครื่องสามารถรองรับได้ ดูคู่มือการดาวน์โหลดโมเดลอย่างเป็นทางการของ LM Studio ส่วนไลบรารี Llama 3 อย่างเป็นทางการของ Ollama ปัจจุบันระบุว่าแพ็กเกจ 8 บิตดั้งเดิมมีขนาดประมาณ 4.7 GB พร้อมหน้าต่างบริบทขนาด 8K ซึ่งเป็นการย้ำเตือนอีกครั้งว่าไฟล์โมเดลเพียงอย่างเดียวก็เกินงบประมาณ VRAM 4 GB แล้ว ดูหน้าไลบรารี Llama 3 อย่างเป็นทางการของ Ollama
ความยาวของบริบท: ลดความยาวลงก่อนที่จะลดคุณภาพของโมเดลลง
ความยาว ของบริบทคือจำนวนโทเค็นที่โมเดลสามารถพิจารณาได้ในพรอมต์ที่ใช้งานอยู่และประวัติการสนทนา บริบทที่ยาวขึ้นต้องการหน่วยความจำแคช KV มากขึ้น สำหรับแล็ปท็อปที่มี VRAM ต่ำ การลดความยาวของบริบทเป็นหนึ่งในค่าการตั้งค่าที่ปลอดภัยที่สุด เนื่องจากไม่เปลี่ยนแปลงน้ำหนักของโมเดลที่จัดเก็บไว้
เริ่มต้นที่ 2,048 โทเค็นสำหรับ VRAM 4 GB และ 4,096 โทเค็นสำหรับ VRAM 6–8 GB ค่อยเพิ่มเป็น 8,192 โทเค็นหลังจากยืนยันแล้วว่าการตั้งค่า 4K เสถียร การ์ดกราฟิก Llama 3 รุ่นดั้งเดิมจำกัดจำนวนบริบทที่ฝึกฝนไว้ที่ 8K ดังนั้นการใช้จำนวนที่มากกว่านั้นไม่ได้ทำให้ Llama 3 รุ่นดั้งเดิมกลายเป็นโมเดลสำหรับบริบทขนาดใหญ่ หากคุณต้องการโทเค็นหลายหมื่นโทเค็น ให้ใช้โมเดลที่ได้รับการฝึกฝนมาสำหรับบริบทนั้นโดยเฉพาะ เช่น รุ่น Llama ที่ออกมาในภายหลัง
เอกสารเกี่ยวกับคอนเท็กซ์ของ Ollama ในปัจจุบันระบุไว้อย่างชัดเจนว่า การเพิ่มขนาดคอนเท็กซ์จะทำให้ความต้องการหน่วยความจำเพิ่มขึ้น ณ ปี 2026 Ollama กำหนดค่าเริ่มต้นให้กับระบบที่มี VRAM น้อยกว่า 24 GiB ให้ใช้คอนเท็กซ์ขนาด 4K ซึ่งทำให้ 4K เป็นขนาดสูงสุดที่เหมาะสมสำหรับการทดสอบทั่วไปก่อนที่จะเพิ่มขนาดให้สูงขึ้นในแล็ปท็อป ดูเอกสารอย่างเป็นทางการเกี่ยวกับความยาวคอนเท็กซ์ของ Ollama ได้ที่ นี่
การประมวลผลด้วย GPU: เพิ่มประสิทธิภาพให้สูงสุด แต่เว้นพื้นที่สำรองไว้บ้าง
การประมวล ผลแบบ GPU offloadจะควบคุมจำนวนเลเยอร์ของโมเดลที่จัดเก็บและประมวลผลบน GPU แทนที่จะเป็น CPU โดยทั่วไปแล้ว เลเยอร์ที่อยู่บน GPU มากขึ้นจะช่วยเพิ่มความเร็วในการสร้างโมเดล แต่การใช้ VRAM จนเต็มเพียงไม่กี่เมกะไบต์สุดท้ายนั้นมีความเปราะบาง เนื่องจากรันไทม์ยังต้องการแคช KV, บัฟเฟอร์การคำนวณ และการจัดสรรแบ็กเอนด์ด้วย
ในไฟล์ llama.cpp เวอร์ชันปัจจุบัน บรรทัดคำสั่งยอมรับค่า--n-gpu-layers autoดังนั้นการเลือกอัตโนมัติจึงเป็นวิธีเริ่มต้นที่ดี หากการโหลดล้มเหลว ให้ลดบริบทก่อน หากยังคงล้มเหลว ให้ลดจำนวนเลเยอร์บน GPU แทนที่จะเปลี่ยนไปใช้การควอนไทเซชันที่ต่ำกว่ามากทันที ตัวเลือกบรรทัดคำสั่งปัจจุบันมีเอกสารอยู่ในเอกสารอ้างอิง CLI อย่างเป็นทางการของ llama.cpp
การเปิดตัว Llama 3 8B Q4_K_M แบบอนุรักษ์นิยมจะมีลักษณะดังนี้:
llama-cli -m Meta-Llama-3-8B-Instruct-Q4_K_M.gguf -c 4096 -b 256 -ub 128 -ngl auto -fa auto
ชื่อไฟล์ GGUF ที่แน่นอนอาจแตกต่างกันไป ลองใช้ดูก่อนบน GPU ขนาด 4 GB -c 2048 -b 128 -ub 64เป้าหมายไม่ใช่การเพิ่มตัวเลขทุกอย่างให้สูงสุด แต่เป็นการสร้างพื้นฐานที่เสถียร จากนั้นค่อยๆ เพิ่มบริบทหรือถ่ายโอนงานไปทีละน้อย
ขนาดชุดข้อมูล: ลดขนาดลงเมื่อการโหลดแบบทันทีทำให้เกิดการกระชากของข้อมูล
ขนาดแบทช์เชิงตรรกะจะควบคุมจำนวนโทเค็นพรอมต์ที่สามารถประมวลผลพร้อมกันได้ แบทช์ขนาดใหญ่ขึ้นสามารถเร่งความเร็วในการรับพรอมต์ได้ แต่ก็อาจเพิ่มความต้องการหน่วยความจำชั่วคราวได้ เช่นกัน ไมโครแบทช์คือส่วนทางกายภาพที่ใช้ในการประมวลผล ปัจจุบันไฟล์ llama.cpp เปิดเผยสิ่งเหล่านี้ในรูปแบบ--batch-sizeและ--ubatch-size
หากโมเดลโหลดสำเร็จแต่เกิดข้อผิดพลาดเมื่อคุณวางข้อความยาวๆ ให้ลดขนาดแบตช์ก่อนที่จะเปลี่ยนค่าควอนไทเซชัน แบตช์เชิงตรรกะ 256 พร้อมไมโครแบตช์ 128 เป็นค่ากลางที่เหมาะสมสำหรับ VRAM 6 GB สำหรับ 4 GB การใช้ 128/64 จะปลอดภัยกว่า สำหรับ 8 GB ควรทดสอบ 512/256 แบตช์ขนาดเล็กอาจทำให้การประมวลผลข้อความช้าลง แต่โดยทั่วไปแล้วจะมีผลกระทบต่อขั้นตอนการสร้างโทเค็นทีละโทเค็นน้อยกว่า
Flash Attention และ KV cache: มีประโยชน์ แต่ควรทดสอบระบบแบ็กเอนด์ของคุณด้วย
Flash Attentionคือเส้นทางความสนใจที่ได้รับการปรับปรุงให้เหมาะสม ซึ่งสามารถลดการใช้หน่วยความจำและเพิ่มความเร็วบนแบ็กเอนด์ที่รองรับ ไฟล์ llama.cpp ปัจจุบันมีโหมดอัตโนมัติ และเอกสาร API การโหลดปัจจุบันของ LM Studio ระบุว่า Flash Attention เป็นตัวเลือกหนึ่งที่สามารถลดการใช้หน่วยความจำและเพิ่มความเร็วในการสร้างสำหรับเอนจินที่ใช้ llama.cpp ดูเอกสารAPI การโหลดโมเดลของ LM Studio
สำหรับแล็ปท็อประดับกลาง ให้ตั้งค่า Flash Attention เป็นอัตโนมัติก่อน หากพบปัญหาการทำงานผิดพลาดที่เกี่ยวข้องกับแบ็กเอนด์หรือความไม่เสถียรของไดรเวอร์กราฟิก ให้ลองทดสอบข้อความแจ้งเตือนเดียวกันโดยปิดใช้งาน Flash Attention ก่อนที่จะเปลี่ยนการตั้งค่าอื่นๆ พร้อมกัน วิธีนี้จะช่วยให้ระบุสาเหตุที่แท้จริงได้ง่ายขึ้น
llama.cpp ยังรองรับแคช KV แบบควอนไทซ์ เช่น Q8_0 ด้วย การควอนไทซ์แคช KV สามารถลดการใช้หน่วยความจำได้ แต่เป็นขั้นตอนการปรับแต่งขั้นสูง ควรเปลี่ยนความยาวของคอนเท็กซ์และขนาดแบทช์ก่อน เพราะการปรับเปลี่ยนเหล่านี้เข้าใจได้ง่ายกว่าและไม่เปลี่ยนแปลงความแม่นยำของ KV หากคุณต้องการพื้นที่เพิ่มเติมสำหรับคอนเท็กซ์ขนาด 8K ในภายหลัง ให้ทดสอบแคช KV Q8 กับชุดพรอมต์ของคุณเองก่อนที่จะนำไปใช้ถาวร
ใช้การร้องขอแบบขนานเพียงครั้งเดียวบนแล็ปท็อป
การทำงานแบบขนานนั้นมักถูกมองข้ามไปได้ง่าย การทำงานแบบขนานหลายรุ่นต้องการความจุของบริบทที่ใช้งานอยู่แยกต่างหาก และอาจทำให้การกำหนดค่าที่เสถียรอยู่แล้วเกินขีดจำกัดของหน่วยความจำ สำหรับแล็ปท็อปผู้ใช้คนเดียว ควรตั้งค่าการทำงานแบบขนานไว้ที่หนึ่งขณะปรับแต่ง คำถามที่พบบ่อยอย่างเป็นทางการของ Ollama ระบุว่าหน่วยความจำที่ต้องการจะแปรผันตามคำขอแบบขนานและขนาดของบริบท และollama psแสดงให้เห็นว่าโมเดลทำงานบน GPU, CPU หรือแบ่งการทำงานระหว่างทั้งสองอย่าง ดูคำถามที่พบบ่อยอย่างเป็นทางการของ Ollama
จะตัดสินได้อย่างไรว่าการตั้งค่าเหล่านั้นดีจริงหรือไม่
การตั้งค่าจะมีประโยชน์ก็ต่อเมื่อให้คำตอบที่ยอมรับได้สม่ำเสมอ ไม่ใช่เพียงแค่โมเดลโหลดได้เท่านั้น ควรใช้ชุดข้อมูลประเมินขนาดเล็กชุดเดิมทุกครั้งที่เปลี่ยนการตั้งค่า คำถาม 5-10 ข้อก็เพียงพอสำหรับการทดสอบบนแล็ปท็อปในทางปฏิบัติ ได้แก่ คำอธิบายข้อเท็จจริง 1 ข้อ งานสรุป 1 ข้อ งานแยกข้อมูลแบบมีโครงสร้าง 1 ข้อ งานเข้ารหัส 1 ข้อ และบทสนทนาหลายรอบที่มีความยาวใกล้เคียงกับบริบทปกติของคุณ
- ความเสถียรของหน่วยความจำ:โมเดลควรโหลดซ้ำได้โดยไม่เกิดข้อผิดพลาดหน่วยความจำไม่เพียงพอ และเดสก์ท็อปควรตอบสนองได้ดีในระหว่างการแสดงผลข้อความแจ้งเตือนเป็นเวลานาน
- ความเร็วในการสร้างข้อความ:วัดจำนวนโทเค็นต่อวินาทีหลังจากประมวลผลข้อความแจ้งเตือน เปรียบเทียบข้อความแจ้งเตือนเดียวกัน ไม่ใช่บทสนทนาที่แตกต่างกัน
- ความเร็วในการประมวลผลแบบทันที:หากการนำเข้าข้อมูลที่มีขนาดใหญ่ใช้เวลานานเกินไป ให้ลองเพิ่มขนาดชุดข้อมูลเฉพาะในกรณีที่ยังมีพื้นที่ VRAM เหลืออยู่
- คำแนะนำต่อไปนี้:ตรวจสอบว่าโมเดลยังคงเคารพรูปแบบ ข้อจำกัด และคำสั่งหลายขั้นตอนที่ร้องขอหลังจากเปลี่ยนการกำหนดปริมาณแล้ว
- พฤติกรรมในบริบทที่ยาว:วางข้อเท็จจริงไว้ใกล้กับจุดเริ่มต้นของคำถามที่ยาว และถามถึงข้อเท็จจริงนั้นอีกครั้งเมื่อใกล้ถึงจุดสิ้นสุด หากโมเดลทำงานล้มเหลวแม้จะมีบริบทที่เหมาะสม ปัญหาอาจอยู่ที่คุณภาพของโมเดลหรือการตั้งคำถามมากกว่าปัญหาเรื่องหน่วยความจำ
เพื่อให้ได้ผลลัพธ์ที่น่าเชื่อถือในการเปรียบเทียบ ให้คงค่าอุณหภูมิและการตั้งค่าการสุ่มตัวอย่างให้คงที่ อุณหภูมิมีความเกี่ยวข้องเพียงเล็กน้อยกับการปรับแต่ง VRAM แต่การเปลี่ยนแปลงอุณหภูมิในเวลาเดียวกันอาจทำให้ผลลัพธ์ดูดีขึ้นหรือแย่ลงด้วยเหตุผลที่ไม่เกี่ยวข้องกับการตั้งค่าหน่วยความจำ
เมื่อใดควรเปลี่ยนวิธีการ
หากโมเดลไม่โหลด
ลดขนาดคอนเท็กซ์ลงเหลือ 2K ปิดแอปพลิเคชันที่ใช้ GPU หนัก ใช้ Q4_K_M และอนุญาตให้มีการถ่ายโอนงาน GPU บางส่วน หาก Q4_K_M ยังคงทำให้เครื่องมีการสลับหน่วยความจำอย่างหนัก อาจพิจารณาใช้ Q3_K_M อย่าคิดว่าโมเดลขนาด 3.7 GB จะพอดีกับ VRAM 4 GB อย่างราบรื่น เพราะรันไทม์ต้องการหน่วยความจำมากกว่าไฟล์น้ำหนัก
หากโหลดเสร็จแล้วแต่มีข้อความแจ้งเตือนยาวๆ จะทำให้โปรแกรมล่ม
ลดขนาดบริบทและขนาดแบทช์ก่อนเปลี่ยนการกำหนดปริมาณโมเดล ข้อความแจ้งเตือนที่ยาวจะเพิ่มการใช้งานแคช KV ในขณะที่แบทช์ขนาดใหญ่สามารถทำให้เกิดการจัดสรรทรัพยากรที่พุ่งสูงขึ้นในช่วงเวลาสั้นๆ
ถ้ามันเสถียรแต่ช้าเกินไป
เพิ่มค่าการประมวลผล GPU จนกว่าจะใกล้เคียงกับ VRAM ที่มีอยู่ แต่อย่าให้หมด หากระบบทำงานหนักด้วย CPU อยู่แล้วเนื่องจากโมเดลมีขนาดใหญ่เกินไป การลดค่าควอนไทเซชันอาจทำให้ทำงานได้เร็วกว่าแม้ว่าจะลดคุณภาพลงบ้างก็ตาม ทดสอบก่อนตัดสินใจ
หากคำตอบแย่ลงอย่างเห็นได้ชัด
ย้ายจาก Q3_K_M กลับไปที่ Q4_K_M หรือจาก Q4_K_M ไปที่ Q5_K_M หาก GPU ขนาด 8 GB มีพื้นที่เหลือเฟือ นอกจากนี้ โปรดตรวจสอบให้แน่ใจว่าคุณกำลังใช้ตัวเลือก Instruct และเทมเพลตแชทที่ถูกต้อง การลดระดับบริบทไม่ได้ลดคุณภาพการให้เหตุผลโดยเนื้อแท้ เว้นแต่ว่าข้อความแจ้งเตือนนั้นต้องการประวัติที่ถูกลบออกไปจริงๆ
LM Studio และ Ollama เทียบเท่า
หากคุณต้องการใช้งานผ่าน GUI LM Studio จะแสดงความยาวของคอนเท็กซ์และการประมวลผล GPU โดยตรง และสามารถประเมินหน่วยความจำก่อนโหลดได้ นอกจากนี้ CLI ในปัจจุบันยังรองรับการทดลองใช้งานเบื้องต้น (dry run) อีกด้วย
lms load --estimate-only <model-key> --context-length 4096 --gpu auto
ตัวประมาณค่าจะคำนึงถึงความยาวของบริบทและการประมวลผลด้วย GPU ดังนั้นจึงเป็นวิธีที่สะดวกในการเปรียบเทียบความละเอียด 2K กับ 4K ก่อนที่จะตัดสินใจใช้งานจริง ดูเอกสารการโหลด LMS อย่างเป็นทางการได้ที่นี่
สำหรับ Ollama คำสั่งดั้งเดิมอย่างเป็นทางการของ Llama 3 ยังคงอยู่:
ollama run llama3
ใช้ollama psเพื่อตรวจสอบว่าโมเดลทำงานบน GPU เต็มรูปแบบหรือแบ่งใช้กับหน่วยความจำ CPU ด้วย หากคอนเท็กซ์ 4K หนักเกินไปสำหรับ GPU ขนาด 4 GB ให้ลดnum_ctxเหลือ 2,048 สำหรับเซสชันนั้น เอกสารอย่างเป็นทางการของ Ollama อธิบายทั้งการกำหนดค่าคอนเท็กซ์และการรายงานการแบ่งโปรเซสเซอร์
โปรไฟล์สุดท้ายที่แนะนำ
สำหรับ VRAM 4 GB:ให้ใช้คำสั่ง Llama 3 8B Instruct Q4_K_M, context 2K, หนึ่งคำขอ, batch และ micro-batch 128/64, Flash Attention เป็นแบบอัตโนมัติ และ offload GPU บางส่วน เลือกใช้ Q3_K_M ก็ต่อเมื่อคุณยืนยันแล้วว่า Q4_K_M ช้าเกินไปหรือไม่เสถียรกับ RAM ที่มีอยู่ของคุณ
สำหรับ VRAM 6 GB:ให้ใช้ Q4_K_M, คอนเท็กซ์ 4K, การร้องขอหนึ่งครั้ง, การตั้งค่าแบตช์ 256/128 หรือ 256/256 และการถ่ายโอนงาน GPU อัตโนมัติ โปรไฟล์นี้มักจะให้พื้นที่ว่างที่ใช้งานได้จริงมากกว่าการพยายามบังคับใช้ Q5_K_M กับการ์ดกราฟิกที่เกือบเต็มแล้ว
สำหรับ VRAM 8 GB:เริ่มต้นด้วย Q5_K_M ที่คอนเท็กซ์ 4K หากความแม่นยำในการตอบสนองเป็นสิ่งสำคัญที่สุด หากคุณต้องการคอนเท็กซ์ 8K เต็มรูปแบบ Q4_K_M อาจให้ความสมดุลที่ดีกว่า เนื่องจากเหลือพื้นที่สำหรับแคช KV และบัฟเฟอร์รันไทม์มากกว่า ยืนยันด้วยชุดพรอมต์เดียวกันก่อนตัดสินใจ
ข้อจำกัดของคำแนะนำนี้
คำแนะนำเหล่านี้ตั้งอยู่บนสมมติฐานว่าแล็ปท็อปมีหน่วยความจำ GPU เฉพาะ 4–8 GB และ RAM ระบบเพียงพอที่จะรองรับการประมวลผลบางส่วน GPU แบบรวมและ Apple Silicon ใช้หน่วยความจำร่วมหรือหน่วยความจำแบบรวม ดังนั้นตาราง VRAM เฉพาะจึงไม่สามารถใช้งานได้อย่างลงตัวกับชิปเหล่านี้ เวอร์ชันไดรเวอร์, แบ็กเอนด์ CUDA/Vulkan/ROCm, ข้อจำกัดด้านพลังงานของแล็ปท็อป และระบบระบายความร้อน ก็สามารถส่งผลต่อประสิทธิภาพได้อย่างมากเช่นกัน
รุ่น 70B Llama 3 ดั้งเดิมนั้นไม่ใช่ตัวเลือกที่เหมาะสมสำหรับแล็ปท็อประดับนี้หากต้องการความเร็วในการใช้งานแบบโต้ตอบ เพราะแพ็คเกจปัจจุบันของ Ollama มีหน่วยความจำประมาณ 40 GB ก่อนที่จะมีค่าใช้จ่ายเพิ่มเติมในการใช้งาน สำหรับระบบระดับกลาง รุ่น 8B จึงเป็นจุดเริ่มต้นที่เหมาะสมกว่า
ดังนั้น กลยุทธ์การปรับแต่งที่น่าเชื่อถือที่สุดจึงเรียบง่าย: รักษาโมเดล Q4_K_M หรือดีกว่าไว้เมื่อเป็นไปได้ ลดบริบทก่อนลดคุณภาพของน้ำหนัก รักษาการทำงานพร้อมกันไว้ที่หนึ่ง และเพิ่มการประมวลผล GPU เฉพาะเมื่อหน่วยความจำยังคงเสถียร การตั้งค่าที่ "ดีที่สุด" คือการตั้งค่าที่สามารถใช้งานได้นานที่สุดในคำถามจริงของคุณ และยังคงให้คำตอบที่คุณต้องการใช้งานจริง
เอกสารอ้างอิงอย่างเป็นทางการ









