คำตอบที่ง่ายที่สุดและใช้ได้จริงคือ:รันโมเดลภาษา โมเดลฝังตัว ดัชนีเอกสาร และอินเทอร์เฟซแชทบนคอมพิวเตอร์ของคุณเอง ชุดซอฟต์แวร์ที่ใช้งานง่ายคือ Ollama สำหรับการให้บริการโมเดลในเครื่อง และ AnythingLLM ที่ติดตั้งเองสำหรับการนำเข้าเอกสาร การสร้างผลลัพธ์ที่เพิ่มประสิทธิภาพการค้นหา (RAG) และการแชท เก็บฐานข้อมูลเวกเตอร์ไว้ในเครื่อง ใช้พื้นที่จัดเก็บข้อมูลแบบถาวร หลีกเลี่ยงผู้ให้บริการโมเดลบนคลาวด์ และทดสอบว่าคำตอบนั้นอิงอยู่กับไฟล์ของคุณจริงๆ
ตัวอย่างประกอบ:ตลอดทั้งคู่มือนี้ ลองจินตนาการว่าจอร์แดนกำลังจัดระเบียบเอกสารส่วนตัว ซึ่งประกอบด้วยคู่มือการใช้บ้าน เอกสารประกันภัยในรูปแบบ PDF บันทึกการประชุม เอกสารอ้างอิงทางการเงินส่วนบุคคล และรายงานโครงการบางส่วน จอร์แดนเป็นตัวละครสมมติ ไฟล์ คำถาม คำตอบ และผลลัพธ์ที่อธิบายไว้ด้านล่างเป็นเพียงตัวอย่างเพื่ออธิบายขั้นตอนการทำงาน ไม่ใช่ผลการทดสอบหรือคำรับรอง
คู่มือนี้ใช้ขั้นตอนการตั้งค่าสี่ขั้นตอนเพื่อให้ขอบเขตความเป็นส่วนตัวเข้าใจได้ง่าย เหมาะสำหรับบุคคลคนเดียวหรือครัวเรือนขนาดเล็กที่ไว้ใจได้ซึ่งต้องการค้นหาเอกสารในพื้นที่และตอบคำถาม หากคุณต้องการการควบคุมข้อมูลประจำตัวระดับองค์กร ความพร้อมใช้งานหลายโหนด การตรวจสอบจากส่วนกลาง หรือการรับประกันตามกฎระเบียบ คุณควรพิจารณาคู่มือนี้เป็นเพียงสถาปัตยกรรมเริ่มต้นมากกว่าโซลูชันการปฏิบัติตามกฎระเบียบที่สมบูรณ์
“ฐานความรู้ AI ท้องถิ่นส่วนตัว” หมายความว่าอย่างไรกันแน่
ฐานความรู้เฉพาะที่ไม่เหมือนกับการฝึกฝนโมเดลด้วยเอกสารของคุณ ในขั้นตอนการทำงานแบบ RAG ทั่วไป ระบบจะดึงข้อความจากไฟล์ของคุณ แบ่งข้อความออกเป็นส่วนๆ แปลงส่วนเหล่านั้นเป็นเวกเตอร์ฝังตัว จัดเก็บไว้ในฐานข้อมูลเวกเตอร์ ดึงส่วนที่เกี่ยวข้องสำหรับแต่ละคำถาม และส่งเฉพาะส่วนเหล่านั้นไปยังโมเดลภาษาเป็นบริบท
เอกสารประกอบการใช้งาน AnythingLLM ในปัจจุบันอธิบายทั้งขั้นตอนการทำงานของเอกสารแนบและเอกสารฝังตัว เอกสารแนบสามารถใส่ข้อความทั้งหมดลงในแชทได้เมื่อหน้าต่างบริบทอนุญาต ในขณะที่ RAG จะดึงข้อมูลส่วนที่เกี่ยวข้องขนาดเล็กกว่าจากเอกสารฝังตัว เอกสารประกอบการใช้งาน LanceDB ในเครื่องปัจจุบันยังระบุว่า LanceDB บนอินสแตนซ์เริ่มต้นจะเก็บข้อความเอกสารและเอกสารฝังตัวไว้ภายในแอปพลิเคชัน AnythingLLM โปรดดูเอกสารประกอบการใช้งานเอกสาร AnythingLLMและเอกสารประกอบการใช้งาน LanceDB ของ AnythingLLM
| ส่วนประกอบ | บทบาทในระบบสแต็กภายในเครื่อง | ตัวเลือกที่คำนึงถึงความเป็นส่วนตัว |
|---|
| โอลาม่า | เรียกใช้โมเดลแชท และอาจรวมถึงโมเดลฝังตัว บนเครื่องของคุณ | ใช้โมเดลในเครื่อง ไม่ใช่เอนด์พอยต์โมเดลที่โฮสต์บนคลาวด์ |
| อะไรก็ได้ LLM | มีส่วนต่อประสานผู้ใช้ การจัดการเอกสาร การแบ่งส่วนข้อมูล RAG และการจัดระเบียบพื้นที่ทำงาน | เรียกใช้งานในเครื่องและคงไดเร็กทอรีจัดเก็บข้อมูลไว้ |
| แบบจำลองการฝังตัว | แปลงส่วนย่อยของเอกสารและคำค้นหาให้เป็นเวกเตอร์สำหรับการค้นหาเชิงความหมาย | ให้ใช้ตัวฝังเอกสารในเครื่องหากไม่จำเป็นต้องส่งเอกสารไปยังบริการภายนอก |
| แลนซ์ดีบี | จัดเก็บเวกเตอร์ที่ใช้ในการค้นหาข้อความที่เกี่ยวข้อง | ให้ใช้ฐานข้อมูลภายในเครื่องตามค่าเริ่มต้น เว้นแต่คุณต้องการใช้ฐานข้อมูลระยะไกลโดยตั้งใจ |
| ไฟล์ต้นฉบับและไฟล์สำรอง | ยังคงเป็นแหล่งข้อมูลที่น่าเชื่อถือต่อไป | ปกป้องข้อมูลเหล่านั้นด้วยการควบคุมการเข้าถึงระบบปฏิบัติการตามปกติ การเข้ารหัส และการสำรองข้อมูล |
ก่อนเริ่มต้น: กำหนดขอบเขตความเป็นส่วนตัว
คำถามสำคัญไม่ใช่ “แอปพลิเคชันนั้นทำงานในเครื่องหรือไม่” แต่เป็น “ส่วนประกอบใดบ้างที่สามารถส่งข้อความเอกสารหรือข้อความแจ้งเตือนออกจากเครื่องได้” ส่วนติดต่อผู้ใช้ในเครื่องยังคงสามารถกำหนดค่าให้เรียกใช้ LLM บนคลาวด์, API สำหรับการฝังข้อมูลบนคลาวด์, การค้นหาเว็บ หรือเครื่องมือระยะไกลได้ สำหรับการตั้งค่าแบบส่วนตัว ควรเก็บ LLM, ตัวฝังข้อมูล และฐานข้อมูลเวกเตอร์ไว้ในเครื่อง เว้นแต่คุณจะยอมรับผลกระทบจากการแบ่งปันข้อมูลของผู้ให้บริการภายนอกโดยเจตนา
เอกสารเกี่ยวกับความเป็นส่วนตัวของ AnythingLLM ระบุถึงการเก็บข้อมูลแบบไม่ระบุตัวตนและมีวิธีการปิดใช้งาน นอกจากนี้ เอกสารเกี่ยวกับความเป็นส่วนตัวยังแยกความแตกต่างระหว่างการลบเอกสารออกจากพื้นที่ทำงานหนึ่งกับการลบออกจากคลังเอกสารทั้งหมด สำหรับการลบอย่างสมบูรณ์ภายใน AnythingLLM เอกสารปัจจุบันระบุให้ลบเอกสารออกจาก " เอกสารของฉัน"ซึ่งจะลบทั้งซอร์สโค้ดที่วิเคราะห์แล้วและข้อมูลที่ฝังไว้ในแคช รวมถึงการอ้างอิงพื้นที่ทำงานด้วย โปรดตรวจสอบเอกสารเกี่ยวกับความเป็นส่วนตัวและการจัดการข้อมูลของ AnythingLLMก่อนเพิ่มข้อมูลที่ละเอียดอ่อน
นอกจากนี้คุณยังต้องมีหน่วยความจำเพียงพอสำหรับโมเดลที่คุณเลือกใช้ ไม่มีขนาดโมเดลที่ถูกต้องเพียงขนาดเดียว เพราะความเร็วในการใช้งานขึ้นอยู่กับ CPU, GPU, RAM หรือ VRAM, การแปลงข้อมูลเป็นดิจิทัล, ความยาวของบริบท และจำนวนเอกสารที่ดึงมา เริ่มต้นด้วยโมเดลที่เหมาะสมกับเครื่องของคุณมากกว่าที่จะเลือกโมเดลขนาดใหญ่ที่สุดที่เครื่องของคุณแทบจะโหลดไม่ไหว
ขั้นตอนที่ 1: ติดตั้ง Ollama และเตรียมแชทในเครื่องและโมเดลการฝังข้อมูล
ติดตั้ง Ollama โดยใช้คำแนะนำปัจจุบันสำหรับระบบปฏิบัติการของคุณ Ollama มีให้ใช้งานสำหรับ macOS, Windows และ Linux และ API ภายในเครื่องจะให้บริการบนพอร์ต 11434 โดยค่าเริ่มต้น คู่มือเริ่มต้นใช้งานฉบับย่ออย่างเป็นทางการของ Ollamaเป็นแหล่งข้อมูลที่ดีที่สุดสำหรับการติดตั้งและไวยากรณ์คำสั่งในปัจจุบัน
หลังจากติดตั้งเสร็จแล้ว ให้เลือกโมเดลแชทที่เหมาะสมกับฮาร์ดแวร์ของคุณ ในที่นี้ไม่ได้กำหนดโมเดลที่แน่นอนไว้ เนื่องจากแคตตาล็อกโมเดลมีการเปลี่ยนแปลง และข้อกำหนดของฮาร์ดแวร์ก็แตกต่างกันไป คำสั่งทั่วไปจะมีรูปแบบดังนี้:
ollama pull <chat-model-name>
สำหรับ RAG คุณยังต้องการโมเดลฝังตัว (embedding model) ด้วย เอกสารเกี่ยวกับโมเดลฝังตัวของ Ollama ฉบับปัจจุบัน (ตรวจสอบเมื่อเดือนกันยายน 2026) ระบุโมเดลต่างๆ เช่นembeddinggemma, qwen3-embedding, และall-minilmเป็นตัวเลือกที่แนะนำ คุณสามารถตรวจสอบรายการปัจจุบันได้ในเอกสารเกี่ยวกับโมเดลฝังตัวของ Ollamaตัวอย่างเช่น:
ollama pull embeddinggemma
อย่าใช้โมเดลแชททั่วไปเป็นโมเดลฝังตัวเพียงเพราะมันปรากฏอยู่ในเมนูดรอปดาวน์ของโมเดล เอกสารประกอบการใช้งาน Ollama embedder ของ AnythingLLM ในปัจจุบันได้เตือนไว้อย่างชัดเจนว่า Ollama สามารถแสดงทั้งโมเดลแชทและโมเดลฝังตัวในรายการเดียวกันได้ ควรใช้โมเดลฝังตัวจริงสำหรับการจัดทำดัชนีเอกสาร ดูวิธีการตั้งค่า Ollama embedder ของ AnythingLLM
 แผนภาพแสดงขั้นตอนการทำงานของเทอร์มินัลสำหรับการดึงข้อมูลโมเดลภายในเครื่องด้วย Ollama หมายเลขเวอร์ชันที่แสดงในตัวอย่างนี้ไม่ใช่เวอร์ชันปัจจุบันที่แนะนำ โปรดตรวจสอบเวอร์ชันที่ติดตั้งไว้กับเอกสารอย่างเป็นทางการของ Ollama
สำหรับสถานการณ์สมมติของจอร์แดน เป้าหมายในขั้นตอนนี้เรียบง่าย คือ การสร้างและการฝังข้อมูลควรทำได้โดยไม่ต้องส่งเอกสารครัวเรือนไปยัง API ระยะไกล
ขั้นตอนที่ 2: เรียกใช้ AnythingLLM บนเครื่องของคุณเองโดยใช้พื้นที่จัดเก็บข้อมูลถาวร และเชื่อมต่อเข้ากับ Ollama
AnythingLLM มีทั้งแบบติดตั้งบนเดสก์ท็อปและแบบโฮสต์เอง คู่มือนี้เลือกใช้ Docker เพราะมีการกำหนดขอบเขตพื้นที่จัดเก็บข้อมูลที่ชัดเจนและสำรองข้อมูลได้ง่าย เอกสาร Docker ในเครื่องปัจจุบันแนะนำให้ผู้ใช้ดึงอิมเมจและเน้นย้ำว่าจำเป็นต้องมีพื้นที่จัดเก็บข้อมูลถาวร มิฉะนั้นข้อมูลแอปพลิเคชันอาจสูญหายเมื่อสร้างคอนเทนเนอร์ใหม่ นอกจากนี้ยังระบุว่าเว็บแอปพลิเคชันสามารถใช้งานได้ที่ [ที่อยู่http://localhost:3001เว็บไซต์] โปรดใช้คู่มือ Docker ในเครื่องอย่างเป็นทางการของ AnythingLLMแทนการคัดลอกคำสั่งเก่าจากฟอรัม
docker pull mintplexlabs/anythingllm:latest
เมื่อคุณเรียกใช้คอนเทนเนอร์ ให้รักษาพื้นที่จัดเก็บข้อมูลของ AnythingLLM โดยการเมานต์ไดเร็กทอรีของโฮสต์ไปยัง/app/server/storage. เอกสารของผู้จำหน่ายระบุอย่างชัดเจนว่าการเมานต์แบบถาวรนี้มีความจำเป็น เก็บไดเร็กทอรีจัดเก็บข้อมูลนั้นไว้ในดิสก์ที่รวมอยู่ในแผนการสำรองข้อมูลของคุณ
จากนั้นกำหนดค่าผู้ให้บริการ LLM เป็น Ollama หาก AnythingLLM ทำงานโดยตรงบนโฮสต์ ที่อยู่ Ollama เริ่มต้นที่ระบุไว้ในเอกสารคือhttp://127.0.0.1:11434หาก AnythingLLM ทำงานอยู่ภายใน Docker ในขณะที่ Ollama ทำงานบนโฮสต์ อย่าใช้localhostจากภายในคอนเทนเนอร์ เอกสารเกี่ยวกับการเชื่อมต่อเครือข่าย Docker ของ AnythingLLM ระบุให้ใช้http://host.docker.internal:11434บนแพลตฟอร์มเดสก์ท็อปที่รองรับ บน Linux เอกสารระบุ172.17.0.1รูปแบบการเชื่อมต่อโฮสต์นี้ โปรดดู หมายเหตุเกี่ยวกับการเชื่อมต่อเครือข่าย localhost และการกำหนดค่า Ollama LLMของAnythingLLM
ในการตั้งค่า ให้เลือก Ollama เป็นทั้งผู้ให้บริการ LLM และหากต้องการ สามารถเลือกเป็นผู้ให้บริการการฝังข้อมูลได้ด้วย เลือกโมเดลแชทสำหรับการสร้าง และโมเดลการฝังข้อมูลสำหรับการจัดทำดัชนี การแยกบทบาทเหล่านี้ออกจากกันจะช่วยป้องกันข้อผิดพลาดในการกำหนดค่าที่พบบ่อย
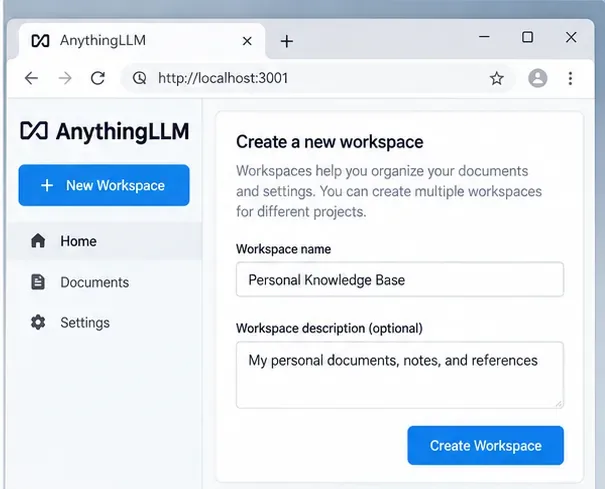 AnythingLLM ที่ติดตั้งบนเซิร์ฟเวอร์ของตนเองนั้นถูกกำหนดให้ทำงานที่ localhost:3001 พื้นที่ทำงานเฉพาะจะช่วยให้ชุดเอกสารชุดหนึ่งมีวัตถุประสงค์ที่ชัดเจน และป้องกันไม่ให้เอกสารที่ไม่เกี่ยวข้องปะปนอยู่ในกลุ่มเอกสารที่สามารถเรียกค้นได้
จอร์แดนสร้างพื้นที่ทำงานชื่อ “ฐานความรู้ส่วนบุคคล” และหลีกเลี่ยงการเชื่อมต่อกับผู้ให้บริการโมเดลคลาวด์ ซึ่งทำให้ขอบเขตที่ต้องการตรวจสอบได้ง่ายในภายหลัง ได้แก่ UI ในเครื่อง, LLM ในเครื่อง, การฝังข้อมูลในเครื่อง และเวกเตอร์ในเครื่อง
ขั้นตอนที่ 3: เพิ่มเอกสาร เลือกรูปแบบการแนบไฟล์แบบ RAG หรือแบบข้อความเต็ม และตรวจสอบความถูกต้องของการนำเข้า
อย่าเริ่มต้นด้วยการอัปโหลดไดรฟ์ทั้งหมดของคุณ เริ่มจากชุดเอกสารขนาดเล็กที่เป็นตัวแทนและคุณรู้จักเนื้อหาเป็นอย่างดีเสียก่อน วิธีนี้จะช่วยให้คุณตรวจจับปัญหาในการดึงข้อมูลหรือเรียกค้นข้อมูลได้อย่างมีประสิทธิภาพก่อนที่ดัชนีจะขยายใหญ่ขึ้น
สำหรับตัวอย่างของจอร์แดน ชุดข้อมูลแรกที่มีประโยชน์อาจประกอบด้วยไฟล์ PDF ที่ค้นหาได้หนึ่งไฟล์ ไฟล์ DOCX หนึ่งไฟล์ และบันทึกข้อความธรรมดาหรือ Markdown หนึ่งไฟล์ หากไฟล์ PDF ที่สแกนมีรูปภาพแทนข้อความที่เลือกได้ โปรดตรวจสอบให้แน่ใจว่าวิธีการประมวลผลเอกสารที่คุณเลือกนั้นสามารถดึงข้อความที่ต้องการได้จริง ไฟล์ที่ดูอ่านได้สำหรับคุณอาจยังคงสร้างการแสดงผลข้อความที่ว่างเปล่าหรือไม่สมบูรณ์สำหรับ RAG ได้
ปัจจุบัน AnythingLLM รองรับลักษณะการทำงานของเอกสารหลักๆ สองแบบ:
- เอกสารแนบ:มีประโยชน์เมื่อข้อความทั้งหมดพอดีกับหน้าต่างบริบทของโมเดล และคุณต้องการให้โมเดลเห็นไฟล์ฉบับสมบูรณ์สำหรับหัวข้อสนทนานั้น
- เอกสารฝังตัวด้วย RAG:มีประโยชน์สำหรับชุดข้อมูลขนาดใหญ่หรือที่สามารถนำกลับมาใช้ใหม่ได้ ระบบจะแบ่งเนื้อหาออกเป็นส่วนๆ ฝังไว้ และดึงส่วนที่เกี่ยวข้องกับคำถามออกมา
คู่มือเอกสาร AnythingLLM ฉบับปัจจุบันระบุว่า เอกสารที่ฝังอยู่ในพื้นที่ทำงานจะสามารถเข้าถึงได้จากทุกเธรดในพื้นที่ทำงานนั้น ซึ่งสะดวกก็จริง แต่ก็หมายความว่า การเป็นสมาชิกพื้นที่ทำงานเป็นส่วนหนึ่งของรูปแบบความเป็นส่วนตัวของคุณในการใช้งานแบบหลายผู้ใช้ ดังนั้น ควรแยกพื้นที่ทำงานส่วนตัวออกจากพื้นที่ทำงานที่ใช้ร่วมกัน
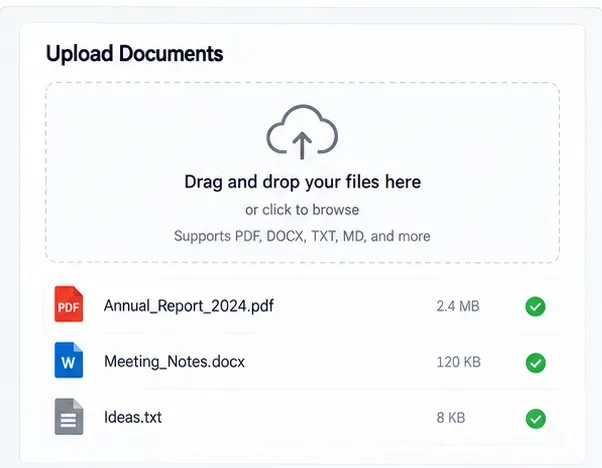 ตัวอย่างมุมมองการนำเข้าข้อมูลที่มีเอกสารหลายประเภท ควรเริ่มต้นด้วยชุดข้อมูลขนาดเล็กที่ใช้งานได้ดีก่อน จากนั้นตรวจสอบการดึงข้อมูลและการจัดทำดัชนี ก่อนที่จะเพิ่มไฟล์เก็บข้อมูลขนาดใหญ่เข้าไป
หลังจากฝังข้อมูลแล้ว ให้ถามคำถามที่มีคำตอบอยู่ในไฟล์เพียงไฟล์เดียว จากนั้นถามหารายละเอียดที่ไม่ปรากฏในไฟล์ใดเลย คำถามแรกเป็นการทดสอบการดึงข้อมูล ส่วนคำถามที่สองเป็นการทดสอบว่าแบบจำลองยอมรับความไม่แน่นอนแทนที่จะสร้างคำตอบขึ้นมาเองหรือไม่
ควรปรับแต่งอะไรบ้างหากการดึงข้อมูลอ่อนแอ
AnythingLLM มีการควบคุม RAG ระดับพื้นที่ทำงาน เช่น การตั้งค่าการค้นหา จำนวนข้อความย่อสูงสุด และเกณฑ์ความคล้ายคลึงของเอกสาร เอกสารประกอบแนะนำให้เริ่มต้นด้วยการตั้งค่าพื้นที่ทำงานแทนที่จะสันนิษฐานว่าโมเดลพื้นฐานเป็นปัญหา การเพิ่มข้อความย่อที่ดึงมาสามารถช่วยได้เมื่อคำตอบครอบคลุมหลายส่วน แต่การส่งข้อความย่อมากเกินไปอาจเพิ่มข้อความที่ไม่เกี่ยวข้องและสิ้นเปลืองความจุของหน้าต่างข้อความย่อได้
หากคุณเปลี่ยนโมเดลการฝังข้อมูลหลังจากทำการจัดทำดัชนีแล้ว ให้ทำการฝังข้อมูลเอกสารที่ได้รับผลกระทบใหม่ เพื่อให้เวกเตอร์ที่จัดเก็บและเวกเตอร์ค้นหามาจากพื้นที่การฝังข้อมูลเดียวกัน การผสมการฝังข้อมูลจากโมเดลที่แตกต่างกันไม่ใช่กลยุทธ์การค้นหาที่มีความหมาย
ขั้นตอนที่ 4: ทดสอบคำตอบที่อิงตามหลักฐาน รักษาความปลอดภัยด้านความเป็นส่วนตัว และสำรองข้อมูลฐานความรู้
ฐานความรู้จะมีประโยชน์ก็ต่อเมื่อคุณสามารถตรวจจับได้ว่าข้อมูลนั้นผิดพลาดเมื่อใด สร้างรายการประเมินขนาดเล็กจากข้อเท็จจริงที่คุณสามารถตรวจสอบได้โดยตรง ตัวอย่างเช่น:
- ขอให้ระบุวันที่ จำนวนเงิน รุ่นสินค้า หรือข้อกำหนดในกรมธรรม์ให้ครบถ้วนในเอกสารฉบับเดียว
- ตั้งคำถามที่ดึงข้อมูลจากเอกสารสองไฟล์
- ตั้งคำถามที่จงใจให้ตอบไม่ได้ และตรวจสอบว่าคำตอบนั้นไม่ได้สร้างแหล่งข้อมูลเท็จขึ้นมา
- ลองถามคำถามเดิมด้วยถ้อยคำที่แตกต่างกัน เพื่อดูว่าการค้นหาข้อมูลยังคงเสถียรหรือไม่
- เปิดเอกสารต้นฉบับและตรวจสอบข้อกล่าวอ้างที่มีความสำคัญสูงทั้งหมดด้วยตนเอง
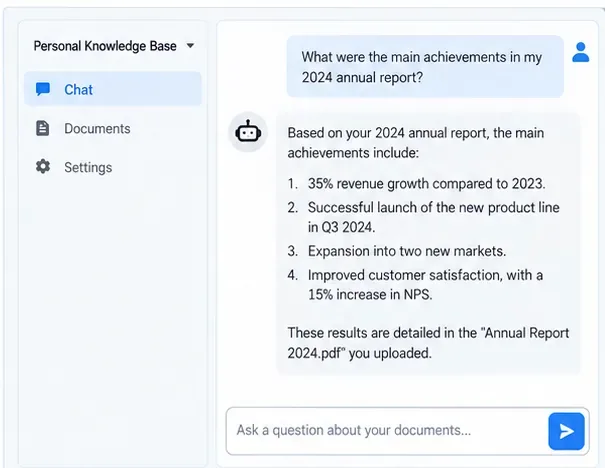 คำตอบสมมติที่อ้างอิงจากเอกสารใช้เพื่อแสดงขั้นตอนการตรวจสอบ ตัวเลขที่แสดงเป็นเพียงตัวอย่างเนื้อหาที่สมมติขึ้น ในฐานความรู้จริง ให้ตรวจสอบข้อกล่าวอ้างที่สำคัญกับไฟล์ต้นฉบับ
สำหรับจอร์แดน หลักเกณฑ์การยอมรับที่ดีไม่ใช่ “คำตอบฟังดูถูกต้อง” แต่เป็น “คำตอบตรงกับแหล่งข้อมูล มีบริบทที่จำเป็น และสามารถใช้ได้อย่างถูกต้องเมื่อแหล่งข้อมูลไม่มีข้อมูลนั้น” หลักเกณฑ์นี้มีความสำคัญอย่างยิ่งสำหรับภาษี ประกันภัย เอกสารทางกฎหมาย บันทึกทางการแพทย์ หรือการตัดสินใจทางการเงิน
เก็บการตั้งค่าไว้เป็นความลับหลังจากที่ใช้งานได้แล้ว
การอนุมานในระดับท้องถิ่นช่วยลดการเปิดเผยข้อมูล แต่ความเป็นส่วนตัวยังคงขึ้นอยู่กับการตั้งค่า ใช้การควบคุมเหล่านี้เป็นรายการตรวจสอบที่ใช้งานได้จริง:
- ควรผูกบริการ AnythingLLM ไว้กับเครื่องคอมพิวเตอร์ภายในเครื่องหรือเครือข่ายส่วนตัวที่เชื่อถือได้ เว้นแต่จะมีการรักษาความปลอดภัยการเข้าถึงจากระยะไกลไว้โดยเจตนา
- อย่าเพิ่มระบบ LLM บนคลาวด์ การฝังข้อมูลบนคลาวด์ การค้นหาเว็บ เบราว์เซอร์ หรือการผสานรวมเอเจนต์ลงในพื้นที่ทำงานที่มีข้อมูลที่ละเอียดอ่อน เว้นแต่คุณจะเข้าใจว่าการผสานรวมเหล่านั้นส่งข้อมูลอะไรบ้าง
- ปิดใช้งานการส่งข้อมูลทางไกลแบบไม่ระบุตัวตน หากนโยบายความเป็นส่วนตัวของคุณกำหนดให้ไม่มีการส่งข้อมูลทางไกลเกี่ยวกับผลิตภัณฑ์เลย
- ใช้การเข้ารหัสดิสก์และสิทธิ์การเข้าถึงบัญชีของระบบปฏิบัติการของคุณ ฐานข้อมูลเวกเตอร์ในเครื่องยังคงเป็นข้อมูลที่อ่านได้แม้ว่าผู้โจมตีจะเข้าถึงเครื่องได้ก็ตาม
- หากต้องการลบข้อมูลสำคัญภายใน AnythingLLM อย่างสมบูรณ์ ควรลบไฟล์สำคัญออกจากคลังเอกสาร ไม่ใช่แค่จากพื้นที่ทำงานเดียวเท่านั้น
- แก้ไขแพทช์ Ollama, AnythingLLM, Docker และระบบปฏิบัติการโฮสต์ คำว่า “ออฟไลน์” ไม่ควรหมายความว่า “ไม่เคยมีการบำรุงรักษา”
สำรองข้อมูลส่วนที่สร้างใหม่ได้ยากไว้ก่อน
เอกสารต้นฉบับยังคงเป็นแหล่งข้อมูลที่ถูกต้องที่สุดของคุณ แต่ไดเร็กทอรีจัดเก็บข้อมูลของ AnythingLLM จะมีฐานข้อมูลแอปพลิเคชัน เอกสารที่ผ่านการประมวลผล ข้อมูลเวกเตอร์ และการกำหนดค่าที่จำเป็นเพื่อหลีกเลี่ยงการสร้างทุกอย่างใหม่หลังจากดิสก์เสียหาย สำรองข้อมูลทั้งโฟลเดอร์เอกสารต้นฉบับและพื้นที่จัดเก็บข้อมูลถาวรของ AnythingLLM หากคุณใช้ Docker volumes แทนไดเร็กทอรีโฮสต์ที่เชื่อมต่อแบบ bind-mounted โปรดปฏิบัติตามเอกสารการสำรองและกู้คืน volume อย่างเป็นทางการของDocker
ทดสอบการกู้คืน ไม่ใช่แค่การสร้างข้อมูลสำรอง ข้อมูลสำรองจะถือว่าเชื่อถือได้ก็ต่อเมื่อคุณสามารถกู้คืนไปยังไดเร็กทอรีหรือเครื่องอื่น เริ่มระบบในเครื่อง เปิดพื้นที่ทำงาน และเรียกข้อมูลที่ทราบได้อย่างถูกต้อง
เมื่อใดที่การตั้งค่าแบบนี้เหมาะสม และเมื่อใดที่ไม่เหมาะสม
สถาปัตยกรรมนี้เหมาะสมอย่างยิ่งเมื่อคุณให้ความสำคัญกับการจัดเก็บเอกสารส่วนตัวบนฮาร์ดแวร์ที่คุณควบคุมได้ คุณคุ้นเคยกับการใช้งานซอฟต์แวร์ในเครื่อง และคุณต้องการการค้นหาเชิงความหมายพร้อมคำตอบที่เป็นภาษาธรรมชาติในคลังเอกสารขนาดไม่ใหญ่มาก นอกจากนี้ยังเป็นประโยชน์เมื่อการเข้าถึงอินเทอร์เน็ตไม่เสถียร หรือเมื่อคุณต้องการค่าใช้จ่ายในเครื่องที่คาดการณ์ได้หลังจากดาวน์โหลดโมเดลแล้ว
ระบบนี้จะไม่เหมาะสมหากคอมพิวเตอร์ของคุณไม่สามารถใช้งานโมเดลโลคอลได้อย่างเพียงพอ คุณต้องการเข้าถึงอย่างราบรื่นจากอุปกรณ์หลายเครื่องนอกเครือข่ายภายในบ้าน หรือคุณต้องการระบบยืนยันตัวตนระดับองค์กร การตรวจสอบ การระงับทางกฎหมาย การจัดการคีย์แบบรวมศูนย์ หรือการรับประกันการสนับสนุน ในกรณีเหล่านั้น คำตอบที่ถูกต้องอาจเป็นการใช้งานแบบส่วนตัวที่มีการจัดการ หรือแพลตฟอร์ม RAG ระดับองค์กร มากกว่าการตั้งค่าบนพีซีเครื่องเดียว
รายการตรวจสอบการติดตั้งขนาดกะทัดรัด
- ติดตั้ง Ollama และตรวจสอบการอนุมานโมเดลในเครื่อง
- ติดตั้งโมเดลการฝังข้อมูลเฉพาะ เช่น โมเดลที่ระบุไว้ในเอกสารการฝังข้อมูลปัจจุบันของ Ollama
- เรียกใช้ AnythingLLM ในเครื่องของคุณโดยใช้พื้นที่จัดเก็บข้อมูลถาวร
- เชื่อมต่อ AnythingLLM กับปลายทาง Ollama ในเครื่องของคุณ โดยใช้ที่อยู่โฮสต์ที่ถูกต้องสำหรับวิธีการปรับใช้ของคุณ
- ใช้ฐานข้อมูลเวกเตอร์ในเครื่อง เช่น LanceDB ซึ่งเป็นฐานข้อมูลเริ่มต้นของ AnythingLLM เมื่อต้องการค้นหาเอกสารเฉพาะในเครื่องเท่านั้น
- สร้างพื้นที่ทำงานที่มีขอบเขตจำกัด
- เริ่มต้นด้วยเอกสารที่รู้จักเพียงไม่กี่ฉบับ แล้วตรวจสอบความถูกต้องของการดึงข้อมูล
- ใช้ RAG สำหรับชุดข้อมูลขนาดใหญ่ที่สามารถนำกลับมาใช้ซ้ำได้ และแนบเอกสารฉบับเต็มเฉพาะเมื่อเอกสารนั้นเหมาะสมกับบริบทของแบบจำลองเท่านั้น
- ทดสอบคำถามที่ตอบได้และตอบไม่ได้ก่อนที่จะเชื่อถือระบบ
- ปิดใช้งานการเชื่อมต่อภายนอกและการส่งข้อมูลทางไกลที่ไม่จำเป็นตามข้อกำหนดด้านความเป็นส่วนตัวของคุณ
- สำรองข้อมูลทั้งเอกสารต้นฉบับและพื้นที่จัดเก็บข้อมูลถาวรของแอปพลิเคชัน จากนั้นทดสอบการกู้คืน
เอกสารอ้างอิงอย่างเป็นทางการ








