วิธีที่เร็วที่สุดในการลดเวลาการเรนเดอร์ในเวิร์กโฟลว์ ComfyUI SDXL คือการลดปริมาณงานการกระจายแสงก่อนที่จะเปลี่ยนแฟล็กการเริ่มต้นระดับต่ำ:ทดสอบที่ความละเอียด SDXL ที่เหมาะสม รักษาขนาดแบทช์ไว้ที่ 1 ในขณะที่ปรับแต่ง ใช้ขั้นตอนการสุ่มตัวอย่างน้อยลงเมื่อคุณภาพยังคงดีอยู่ และข้ามส่วนเสริมที่มีราคาแพงชั่วคราว เช่น ตัวปรับแต่ง การแตกแขนง ControlNet การเพิ่มขนาด หรือตัวประมวลผลล่วงหน้า หลังจากนั้นจึงค่อยปรับแต่ง VRAM ความสนใจ การแสดงตัวอย่าง และพฤติกรรมแคช
ลำดับนี้มีความสำคัญเพราะแฟล็กการเริ่มต้นระบบไม่สามารถชดเชยเวิร์กโฟลว์ที่ขอให้ GPU ทำงานมากกว่าที่จำเป็นถึงสองหรือสามเท่าได้ เอกสาร ComfyUI ฉบับปัจจุบันยังแนะนำให้ลดความละเอียดหรือขนาดแบทช์ก่อนเมื่อการสร้างข้อมูลช้า จากนั้นจึงใช้การเพิ่มประสิทธิภาพหน่วยความจำและความสนใจตามความจำเป็น คำแนะนำด้านล่างนี้ได้รับการตรวจสอบกับเอกสาร ComfyUI และ PyTorch ฉบับปัจจุบันเมื่อวันที่ 13 กันยายน 2026
เหตุใดเวิร์กโฟลว์ SDXL จึงทำงานช้าลงใน ComfyUI
การเรนเดอร์ภาพด้วย SDXL อาจใช้เวลาไปกับหลายส่วน เช่น การโหลดหรือย้ายน้ำหนักโมเดล การเข้ารหัสข้อความ CLIP การลดสัญญาณรบกวนซ้ำๆ ภายใน KSampler การปรับสภาพภาพด้วย ControlNet หรือวิธีการอื่นๆ การถอดรหัส VAE การขยายภาพ และขั้นตอนการปรับแต่งภาพในรอบที่สอง หาก VRAM มีจำกัด การถ่ายโอนข้อมูลระหว่าง CPU และ GPU เพิ่มเติมอาจทำให้เกิดความหน่วงมากขึ้นไปอีก
นั่นหมายความว่าผู้ใช้สองคนที่มี GPU รุ่นเดียวกันอาจเห็นเวลาในการเรนเดอร์ที่แตกต่างกันมาก กราฟข้อความเป็นภาพพื้นฐานระดับ 1024 นั้นไม่สามารถเปรียบเทียบได้กับเวิร์กโฟลว์ที่เพิ่มตัวปรับแต่ง, ControlNet สองตัว, การประมวลผลรอบที่สองที่มีความละเอียดสูง และชุดข้อมูลขนาดใหญ่ เป้าหมายคือการระบุว่าส่วนใดของ กราฟ ของคุณใช้ทรัพยากรมาก จากนั้นลบหรือปรับปรุงส่วนนั้นโดยไม่ลดทอนคุณภาพของผลลัพธ์ที่คุณให้ความสำคัญ
1. วัดค่าพื้นฐานที่สะอาดก่อนทำการเปลี่ยนแปลงใดๆ
ใช้พรอมต์คงที่หนึ่งชุด ค่าเริ่มต้นคงที่หนึ่งค่า ขนาดแบทช์ 1 และความละเอียดเอาต์พุตเดียวกัน รันเวิร์กโฟลว์อย่างน้อยสองครั้ง การรันครั้งแรกอาจรวมถึงการโหลดจุดตรวจสอบ การคอมไพล์ การอ่าน/เขียนข้อมูลลงดิสก์ หรือการถ่ายโอนโมเดล การรันครั้งต่อมาจะเป็นการวัดความเร็วในการสร้างที่สภาวะคงที่ได้ดีกว่า
ตรวจสอบด้วยว่า GPU กำลังทำงานอยู่จริงหรือไม่ ในระบบ NVIDIA nvidia-smiสามารถแสดงการใช้งาน VRAM และการใช้งาน GPU ได้ หากการใช้งาน GPU ยังคงต่ำในขณะที่ระบบกำลังเคลื่อนย้ายข้อมูลหรือโหลดโมเดลอย่างต่อเนื่อง ปัญหาคอขวดอาจอยู่ที่ปริมาณหน่วยความจำหรือ I/O มากกว่าตัวแซมpler เอง
 ตรวจสอบพฤติกรรมของ GPU และ VRAM ก่อนปรับแต่ง ComfyUI ค่าที่แสดงในที่นี้เป็นเพียงตัวอย่างเค้าโครง ไม่ใช่เป้าหมายสำหรับการทดสอบประสิทธิภาพ
2. เริ่มจากกราฟ SDXL ขนาดเล็กที่สุดที่ให้ผลลัพธ์ที่คุณต้องการ
ก่อนที่จะปรับปรุงเวิร์กโฟลว์ที่ซับซ้อน ให้เปรียบเทียบกับเส้นทางที่เรียบง่ายที่สุดก่อน ได้แก่ การโหลดจุดตรวจสอบ การปรับเงื่อนไขข้อความแจ้งเตือน รูปภาพแฝงว่างเปล่า KSampler การถอดรหัส VAE และการบันทึกรูปภาพ ตัวอย่างอย่างเป็นทางการของ ComfyUI แสดงให้เห็นว่าจุดตรวจสอบพื้นฐาน SDXL สามารถใช้งานได้เหมือนจุดตรวจสอบทั่วไป หากกราฟพื้นฐานนี้ทำงานได้เร็ว แต่กราฟที่ใช้งานจริงของคุณทำงานช้า แสดงว่าสาขาเพิ่มเติมเป็นปัญหา
สำหรับการร่างแบบ ให้ปิดใช้งานส่วนประกอบที่ไม่จำเป็นต่อการตัดสินใจในขณะนั้นชั่วคราว ตัวอย่างเช่น ตัวปรับแต่งความละเอียด การเพิ่มความละเอียดรอบที่สอง ตัวประมวลผลภาพเบื้องต้น เครือข่ายควบคุมหลายตัว หรือสาขาการจัดรูปแบบเสริม เปิดใช้งานทีละส่วนหลังจากที่ภาพพื้นฐานเป็นที่ยอมรับแล้ว
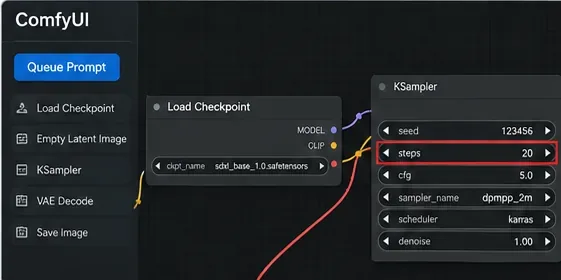 กราฟ SDXL ขนาดเล็กเป็นจุดเริ่มต้นที่ดีที่สุด เพิ่มสาขาที่ใช้เวลานานก็ต่อเมื่อคุณทราบแล้วว่าแต่ละสาขาใช้เวลาเท่าใด
3. ลดจำนวนขั้นตอนของ KSampler ก่อนที่จะลองตั้งค่าความเร็วแบบแปลกๆ
ขั้นตอนการสุ่มตัวอย่างเป็นหนึ่งในตัวแปรที่เห็นได้ชัดเจนที่สุด เพราะแต่ละขั้นตอนการลดสัญญาณรบกวนที่เพิ่มเข้ามาจะเพิ่มภาระงาน หากคุณลดขั้นตอนจากค่าที่สูงกว่าไปสู่ค่าที่ต่ำกว่า ส่วนการสุ่มตัวอย่างของการเรนเดอร์ควรจะสั้นลง แม้ว่าเวลาโดยรวมจะไม่ลดลงในเปอร์เซ็นต์เดียวกันเป๊ะๆ เพราะการโหลดโมเดล การเข้ารหัสข้อความแจ้งเตือน การถอดรหัส VAE และโหนดอื่นๆ ยังคงใช้เวลาอยู่
อย่าคัดลอกจำนวนขั้นตอน "ที่ดีที่สุด" ที่ใช้ได้กับทุกคนจากคนอื่น จำนวนที่เหมาะสมนั้นขึ้นอยู่กับจุดตรวจสอบ ตัวอย่าง ตัวกำหนดเวลา ข้อความแจ้งเตือน CFG และเป้าหมายคุณภาพ วิธีการที่ได้ผลคือการคงค่าเริ่มต้นไว้และทดสอบการลดลงทีละน้อย เช่น การตั้งค่าปัจจุบันของคุณ จากนั้นลดลงเล็กน้อย แล้วลดลงอีก หยุดเมื่อพื้นผิว กายวิภาค การจัดพิมพ์ หรือความถูกต้องของข้อความแจ้งเตือนลดลงมากกว่าที่คุณยอมรับได้
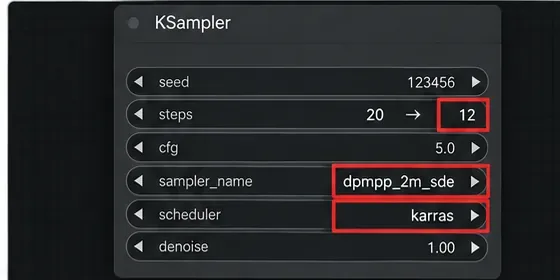 การลดจำนวนขั้นตอนของ KSampler สามารถลดเวลาในการลดสัญญาณรบกวนได้ ค่าที่แสดงเป็นเพียงตัวอย่าง โปรดตรวจสอบคุณภาพด้วยจุดตรวจสอบของคุณเองและค่าเริ่มต้นที่กำหนดไว้
4. ควบคุมความละเอียดของการทดสอบและขนาดของชุดทดสอบให้อยู่ในระดับที่เหมาะสม
สำหรับ SDXL ตัวอย่าง SDXL อย่างเป็นทางการของ ComfyUI แนะนำให้ใช้ขนาดภาพ 1024×1024 หรืออัตราส่วนภาพอื่นๆ ที่มีจำนวนพิกเซลใกล้เคียงกัน เช่น 896×1152 หรือ 1536×640 เพื่อให้ได้ประสิทธิภาพการทำงานที่ดีที่สุดสำหรับโมเดลพื้นฐาน การใช้จำนวนพิกเซลที่สูงกว่านี้มากจะทำให้ขนาดของข้อมูลแฝงเพิ่มขึ้น และส่งผลให้ต้องใช้การประมวลผลและหน่วยความจำมากขึ้น
ในระหว่างการปรับแต่งพรอมต์และเวิร์กโฟลว์ ให้ตั้งค่าไว้batch_sizeที่ 1 เว้นแต่คุณต้องการทดสอบปริมาณงานโดยเฉพาะ การตั้งค่าเป็นชุดสี่จะสั่งให้ไปป์ไลน์สร้างภาพสี่ภาพในการดำเนินการครั้งเดียว ซึ่งอาจช่วยปรับปรุงปริมาณงานในบางกรณี แต่ไม่ใช่แนวทางที่จะลดเวลาในการแสดงภาพแรก และยังเพิ่มความต้องการหน่วยความจำอีกด้วย
หากไฟล์ผลลัพธ์สุดท้ายของคุณต้องมีขนาดใหญ่กว่าความละเอียดพื้นฐานปกติของ SDXL ให้พิจารณาแยก "การทดสอบองค์ประกอบ" ออกจากการประมวลผลความละเอียดสูงขั้นสุดท้าย ทำให้การตั้งค่าเริ่มต้น การปรับสภาพ และองค์ประกอบถูกต้องก่อน จากนั้นค่อยจ่ายค่าใช้จ่ายสำหรับการขยายขนาดหรือการประมวลผลครั้งที่สองที่มีราคาแพงเฉพาะกับส่วนที่เลือกไว้เท่านั้น
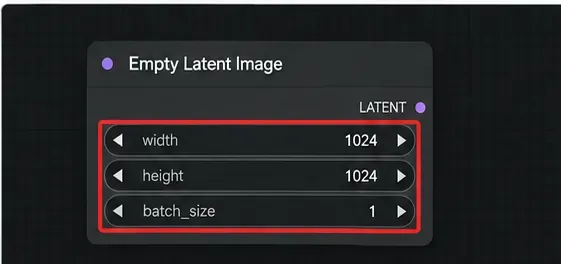 การใช้ข้อมูลแฝง 1024 คลาสที่มีขนาดแบทช์ 1 เป็นค่าพื้นฐานที่เหมาะสมสำหรับการปรับแต่ง SDXL ก่อนที่จะทำการทดสอบด้วยความละเอียดสูงขึ้นหรือการประมวลผลหลายภาพ
5. ควรเปรียบเทียบประสิทธิภาพของตัวสุ่มตัวอย่างและตัวจัดตารางเวลา แทนที่จะคิดว่าตัวใดตัวหนึ่งจะเร็วที่สุดเสมอไป
ComfyUI มีตัวเลือกตัวสุ่มตัวอย่างและตัวกำหนดเวลาหลายแบบใน KSampler การผสมผสานที่แตกต่างกันอาจให้คุณภาพที่ยอมรับได้ในจำนวนขั้นตอนที่แตกต่างกัน ดังนั้น "เร็วที่สุด" ควรหมายถึงเร็วที่สุดในคุณภาพที่คุณต้องการไม่ใช่เพียงแค่การทำงานครั้งเดียวที่สั้นที่สุด
ให้ใช้จุดตรวจสอบ (checkpoint), ข้อความแจ้งเตือน (prompt), ค่าเริ่มต้น (seed), ความละเอียด (resolution) และ CFG เดียวกันในการเปรียบเทียบ เปลี่ยนเฉพาะตัวอย่าง (sampler) หรือตัวกำหนดเวลา (scheduler) จากนั้นเปรียบเทียบทั้งเวลาในการเรนเดอร์และคุณภาพที่มองเห็นได้ หากการผสมผสานแบบใดแบบหนึ่งใช้ขั้นตอนในการสร้างจุดตรวจสอบน้อยกว่าอย่างเห็นได้ชัด ในขณะที่ยังคงรักษาผลลัพธ์ที่คุณต้องการไว้ได้ นั่นคือข้อได้เปรียบด้านความเร็วที่แท้จริง แต่หากต้องใช้ขั้นตอนเพิ่มเติมเพื่อกู้คืนรายละเอียด ข้อได้เปรียบที่เห็นได้ชัดอาจหายไป
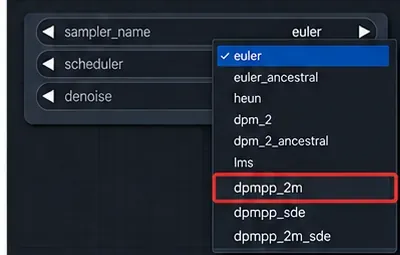 เปลี่ยนตัวแปรแซมpler ทีละตัว แล้วเปรียบเทียบที่ seed คงที่ อย่าคิดว่าแซมpler ตัวใดตัวหนึ่งจะทำงานได้เร็วกว่าสำหรับทุก checkpoint หรือเป้าหมายคุณภาพใน SDXL
6. ลบขั้นตอนการทำงานกราฟที่ซ้ำซ้อนออก และใช้โมเดลการทำงานของ ComfyUI ให้เป็นประโยชน์
ComfyUI ถูกออกแบบมาให้ทำงานเฉพาะส่วนของกราฟที่จำเป็นเท่านั้น เอกสารประกอบโครงการระบุว่าส่วนที่ไม่เปลี่ยนแปลงสามารถนำกลับมาใช้ซ้ำได้ระหว่างการทำงาน และแบ็กเอนด์ปัจจุบันมีการแคชผลลัพธ์ของโหนดที่สามารถกำหนดค่าได้ ซึ่งมีประโยชน์เมื่อคุณต้องการเปลี่ยนแปลงเฉพาะค่าปลายทางแทนที่จะสร้างเวิร์กโฟลว์ทั้งหมดใหม่
ควรคงความเสถียรของโหนดโหลดและกระบวนการประมวลผลต้นทางที่มีค่าใช้จ่ายสูงไว้ให้มากที่สุดเท่าที่จะเป็นไปได้ หากคุณสลับจุดตรวจสอบบ่อยๆ ปรับขนาดภาพขนาดใหญ่ซ้ำๆ หรือทำให้โหนดต้นทางไม่ถูกต้อง คุณจะสูญเสียประโยชน์จากงานที่แคชไว้
ComfyUI ยังมี ฟีเจอร์ การเรียกใช้งานบางส่วน (Partial Execution) ที่มีเอกสารอธิบายไว้ ซึ่งสามารถเรียกใช้งานเฉพาะส่วนของเวิร์กโฟลว์ที่จำเป็นสำหรับโหนดเอาต์พุตที่เลือกไว้เท่านั้น ใช้ฟีเจอร์นี้เมื่อคุณกำลังทดสอบสาขาปลายทางและไม่จำเป็นต้องสร้างเอาต์พุตทั้งหมดในกราฟขนาดใหญ่ขึ้นมาใหม่
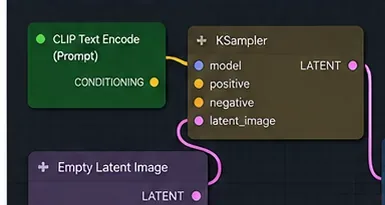 กราฟที่กระชับช่วยให้มองเห็นปัญหาคอขวดได้ง่ายขึ้น ใช้การแคชและการประมวลผลบางส่วนเพื่อไม่ให้งานต้นทางที่ไม่เปลี่ยนแปลงถูกทำซ้ำโดยไม่จำเป็น
7. ปรับแต่งการแสดงตัวอย่าง การแคช โหมด VRAM และ Attention ก็ต่อเมื่อกราฟทำงานได้อย่างมีประสิทธิภาพแล้วเท่านั้น
ตัวเลือกบรรทัดคำสั่ง ComfyUI ในปัจจุบันมีตัวควบคุมประสิทธิภาพหลายอย่าง ผลกระทบของตัวเลือกเหล่านี้ขึ้นอยู่กับฮาร์ดแวร์และหน่วยความจำที่มีอยู่ ดังนั้นควรพิจารณาตัวเลือกเหล่านี้เป็นเพียงตัวอย่างสำหรับการทดสอบประสิทธิภาพ ไม่ใช่ตัวเลือกที่ต้องบังคับใช้
| การตั้งค่า | เมื่อมันสามารถช่วยได้ | ข้อแลกเปลี่ยนหลัก |
|---|
--preview-method none | หากเปิดใช้งานการแสดงตัวอย่างเสียง และคุณสนใจเฉพาะผลลัพธ์สุดท้ายเท่านั้น | คุณจะสูญเสียการแสดงตัวอย่างแบบเรียลไทม์ CLI เวอร์ชันปัจจุบันใช้การไม่แสดงตัวอย่างเป็นค่าเริ่มต้นอยู่แล้ว |
--highvram | หากคุณมี VRAM เพียงพอ และการโหลด/ยกเลิกการโหลดโมเดลซ้ำๆ ทำให้เสียเวลา | ฟังก์ชันนี้จะเก็บโมเดลไว้ในหน่วยความจำ GPU และอาจทำให้เกิดข้อผิดพลาดหน่วยความจำไม่เพียงพอในกราฟิกการ์ดที่มีข้อจำกัดด้านหน่วยความจำ |
--lowvram | หากเวิร์กโฟลว์ดังกล่าวไม่เหมาะสมกับหน่วยความจำ VRAM | โหมดนี้เน้นการประหยัดหน่วยความจำมากกว่าความเร็ว การใช้งาน CPU หรือการถ่ายโอนข้อมูลอาจทำให้เกิดความหน่วงเพิ่มขึ้นได้ |
--use-pytorch-cross-attention | คุ้มค่าที่จะทดสอบประสิทธิภาพบน PyTorch/GPU รุ่นใหม่ๆ | อย่านำเอาตัวเลือกโหมดความสนใจที่ขัดแย้งกันมาใช้ร่วมกันโดยไม่พิจารณาให้รอบคอบ |
--use-flash-attention | คุ้มค่าที่จะทดสอบเมื่อฮาร์ดแวร์/ซอฟต์แวร์ของคุณรองรับเส้นทางที่เหมาะสมที่สุด | ความพร้อมใช้งานและประโยชน์ที่ได้รับขึ้นอยู่กับข้อมูลป้อนเข้าและแกนหลักที่รองรับ |
--cache-classicหรือ--cache-lru N | กระบวนการทำงานซ้ำๆ ที่ยอมรับหน่วยความจำแคชเพิ่มเติมได้ | สามารถใช้ RAM/VRAM เพิ่มได้ |
--cache-none | เฉพาะในกรณีที่การลดหน่วยความจำแคชมีความสำคัญมากกว่าความเร็ว | CLI ของ ComfyUI เองระบุว่าทุกโหนดจะทำงานทุกครั้งที่รัน ดังนั้นโดยทั่วไปแล้วจึงทำให้เวลาในการเรนเดอร์แย่ลง |
CLI ปัจจุบันยังรองรับการถ่ายโอนน้ำหนักแบบอะซิงโครนัส และข้อความช่วยเหลือระบุว่าฟังก์ชันนี้เปิดใช้งานโดยค่าเริ่มต้นบน NVIDIA นั่นหมายความว่าการเพิ่มแฟล็กเพิ่มเติมไม่ได้หมายความว่าจะเป็นการเพิ่มประสิทธิภาพโดยอัตโนมัติ ตรวจสอบคำสั่งการเปิดใช้งานและบันทึกปัจจุบันของคุณก่อน
กลไก Attention แบบ Dot-product ที่ปรับขนาดได้ของ PyTorch สามารถเลือกการใช้งาน CUDA ที่เหมาะสมที่สุดโดยอัตโนมัติ เช่น FlashAttention หรือ Attention ที่ประหยัดหน่วยความจำ เมื่ออินพุตและฮาร์ดแวร์เอื้ออำนวย นั่นคือเหตุผลที่เส้นทาง Attention สมัยใหม่มีความสำคัญ แต่ผลลัพธ์ที่ได้นั้นขึ้นอยู่กับฮาร์ดแวร์ หลีกเลี่ยงการอ้างอิงเปอร์เซ็นต์ทั่วไปราวกับว่ามันใช้ได้กับเวิร์กโฟลว์ SDXL ของคุณ
8. รักษาพฤติกรรมของคิวและแบทช์ให้สอดคล้องกับเป้าหมายของคุณ
หากคุณให้ความสำคัญกับการได้รับผลตอบรับที่รวดเร็วที่สุด ให้จัดคิวรูปภาพทีละภาพขณะทำการปรับแต่ง การจัดคิวจำนวนมากและการประมวลผลเป็นชุดๆ จะมีประโยชน์เมื่อคุณทราบการตั้งค่าแล้วและต้องการปริมาณงานที่สูง แต่ไม่ได้ทำให้รูปภาพแรกมาถึงเร็วขึ้น
เมื่อขั้นตอนการทำงานเสร็จสมบูรณ์แล้ว คุณสามารถวัดประสิทธิภาพการประมวลผลแยกต่างหากได้ ในขั้นตอนนี้ การประมวลผลเป็นชุดใหญ่ขึ้นอาจเหมาะสมกว่า หาก VRAM เอื้ออำนวย และหากจำนวนภาพต่อนาทีทั้งหมดมีความสำคัญมากกว่าความหน่วงต่อภาพ
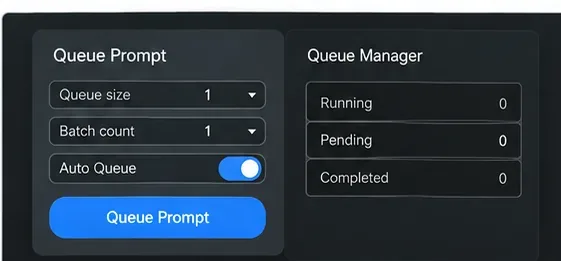 ใช้ภาพที่อยู่ในคิวเพียงภาพเดียวและขนาดแบทช์ 1 สำหรับการปรับแต่งแบบโต้ตอบ ทดสอบแบทช์ขนาดใหญ่ขึ้นในภายหลังเมื่อเป้าหมายคือปริมาณงานที่ทำได้
วิธีตรวจสอบว่าการปรับปรุงประสิทธิภาพได้ผลจริงหรือไม่
การประมวลผลที่เร็วขึ้นจะมีประโยชน์ก็ต่อเมื่อภาพยังคงตรงตามความต้องการของคุณ เปรียบเทียบภาพก่อนและหลังโดยใช้ seed และ prompt เดียวกัน ตรวจสอบบริเวณที่มักเกิดปัญหาเมื่อตั้งค่าสูงเกินไปก่อน เช่น ข้อความขนาดเล็ก มือและใบหน้า ลวดลายซ้ำๆ วัสดุที่มีรายละเอียดสูง รายละเอียดขอบ และการปฏิบัติตามคุณลักษณะเฉพาะของ prompt
บันทึกข้อมูลอย่างน้อยสี่รายการนี้สำหรับแต่ละการทดสอบ: เวลาดำเนินการทั้งหมด ขั้นตอนการสุ่มตัวอย่าง ความละเอียด และว่ามีการโหลดโมเดลเกิดขึ้นหรือไม่ หากการทำงานครั้งแรกใช้เวลา 30 วินาที และครั้งที่สองใช้เวลา 12 วินาที อย่านับว่ามีการเปลี่ยนแปลงตัวสุ่มตัวอย่างโดยอัตโนมัติ เพราะการทำงานครั้งแรกอาจจ่ายเฉพาะค่าใช้จ่ายในการโหลดจุดตรวจสอบเท่านั้น
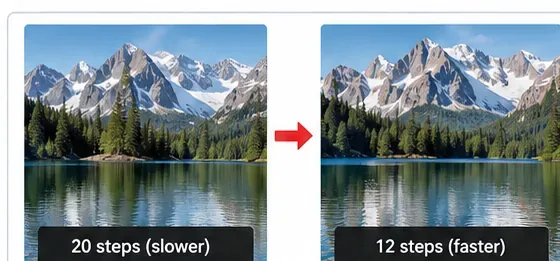 ใช้การเปรียบเทียบแบบคงที่เคียงข้างกันเพื่อตัดสินว่าจำนวนขั้นตอนที่น้อยลงนั้นเป็นที่ยอมรับได้หรือไม่ ป้ายกำกับในภาพแสดงให้เห็นถึงวิธีการและไม่ใช่ผลลัพธ์มาตรฐาน
ลำดับการเพิ่มประสิทธิภาพเชิงปฏิบัติ
- ทดสอบประสิทธิภาพการทำงานหลังจากอุ่นเครื่องแล้วตั้งค่า seed, prompt, resolution และ batch ให้คงที่
- ลบสาขาที่ไม่จำเป็นออก ทดสอบเส้นทาง SDXL พื้นฐานโดยไม่ต้องใช้ตัวปรับแต่ง, ControlNet, การขยายขนาด หรือตัวประมวลผลล่วงหน้าเสริม
- ลดขั้นตอนลงหาจำนวนขั้นตอนที่น้อยที่สุดที่ยังคงได้มาตรฐานคุณภาพที่คุณต้องการ
- รักษาระดับความละเอียดให้เหมาะสมปรับแต่งให้เข้ากับงบประมาณพิกเซลระดับ 1024 ของ SDXL ก่อนที่จะทำการปรับแต่งความละเอียดสูง
- คงจำนวนชุดข้อมูลไว้ที่ 1 ในระหว่างการวนซ้ำปรับปรุงประสิทธิภาพการประมวลผลก็ต่อเมื่อเวิร์กโฟลว์เสถียรแล้วเท่านั้น
- เปรียบเทียบตัวเลือกเครื่องสุ่มตัวอย่าง/เครื่องจัดตารางเวลาประเมินความเร็วโดยพิจารณาจากคุณภาพที่ยอมรับได้
- ใช้การแคชและการประมวลผลบางส่วนหลีกเลี่ยงการรันงานต้นทางที่ไม่เปลี่ยนแปลงซ้ำอีกครั้ง
- จากนั้นทดสอบการทำงานของโปรแกรมทดสอบการแสดงตัวอย่าง, VRAM, แคช และการเปลี่ยนแปลงความสนใจทีละอย่าง
เมื่อใดที่คุณควรเปลี่ยนกลยุทธ์แทนที่จะพยายามปรับปรุงให้ดีที่สุด
หากเวิร์กโฟลว์ SDXL ยังคงใช้เวลานานเกินไปหลังจากทำการเปลี่ยนแปลงเหล่านี้แล้ว ให้ตรวจสอบว่างานนั้นกำลังทำอะไรอยู่จริง ๆ กราฟการผลิตแบบหลาย ControlNet ที่มีการปรับแต่งและขยายขนาดอาจใช้ทรัพยากรการประมวลผลสูงโดยตั้งใจอยู่แล้ว ในกรณีนั้น คุณมีสามทางเลือกที่เหมาะสม: ยอมรับการเรนเดอร์ที่นานขึ้นสำหรับภาพสุดท้าย ใช้เวิร์กโฟลว์ร่างที่ง่ายกว่าสำหรับการทำซ้ำ หรือย้ายภาระงานไปยังฮาร์ดแวร์ที่เร็วกว่า
ในทำนองเดียวกัน หากคุณประสบปัญหาหน่วยความจำ VRAM ไม่เพียงพออยู่ตลอดเวลา การบังคับใช้โหมด "เร็วขึ้น" บน GPU ก็ไม่ใช่วิธีแก้ปัญหาที่ถูกต้อง การทำงานที่เสถียรด้วยการจัดการหน่วยความจำแบบไดนามิกตามค่าเริ่มต้น หรือการกำหนดค่า VRAM ที่ต่ำกว่านั้นดีกว่าการเกิดข้อผิดพลาดหน่วยความจำไม่เพียงพอซ้ำแล้วซ้ำเล่า การตั้งค่าเพื่อประหยัดหน่วยความจำอาจทำให้เวลาในการเรนเดอร์เพิ่มขึ้น แต่การเรนเดอร์ที่สำเร็จแม้จะช้าลงก็ยังมีประโยชน์มากกว่าการเกิดข้อผิดพลาดอย่างรวดเร็ว
เอกสารอ้างอิงอย่างเป็นทางการ
สำหรับพฤติกรรมและแฟล็กปัจจุบัน โปรดดูคำแนะนำการแก้ไขปัญหาและประสิทธิภาพของ ComfyUI , ซอร์สโค้ดอาร์กิวเมนต์บรรทัดคำสั่ง ComfyUI ปัจจุบัน และตัวอย่าง SDXL อย่างเป็นทางการของ ComfyUIสำหรับการเพิ่มประสิทธิภาพในระดับกราฟ โปรดดูการดำเนินการบางส่วนของ ComfyUIและเอกสารประกอบโครงการ ComfyUIสำหรับพฤติกรรมของ Attention โปรดดูเอกสารประกอบเกี่ยวกับ Scaled Dot-Product Attention ของ PyTorch








