คุณอัปโหลดรายงานขนาดยาว ขอให้วิเคราะห์อย่างละเอียด แต่แทนที่จะได้รับคำตอบ คุณกลับได้รับข้อความเช่น “เกินขอบเขตของหน้าต่างบริบท” “เกินความยาวบริบทสูงสุด” หรือคำเตือนอื่นๆ ที่ระบุว่าคำขอมีขนาดใหญ่เกินไป ส่วนที่น่าหงุดหงิดคือไฟล์อาจอัปโหลดสำเร็จแล้ว และเอกสารเดียวกันนี้อาจใช้งานได้ดีสำหรับคำถามที่แคบกว่าด้วยซ้ำ
เหตุผลนั้นง่ายแต่ก็มองข้ามได้ง่าย: ข้อจำกัดในการอัปโหลดและหน้าต่างบริบทของโมเดลนั้นไม่เหมือนกัน โมเดลต้องปรับเนื้อหาที่กำลังพิจารณาอยู่ให้พอดีกับงบประมาณโทเค็นที่มีจำกัด งบประมาณนั้นอาจรวมถึงคำแนะนำของคุณ ประวัติการสนทนา ข้อความที่ดึงมาจากไฟล์ คำจำกัดความของเครื่องมือ ข้อความที่ดึงมา โทเค็นการให้เหตุผล และพื้นที่สำหรับคำตอบ ดังนั้นเอกสารจึงอาจมีขนาดใหญ่เกินกว่าจะอัปโหลดได้ถูกต้องตามกฎหมาย แต่ก็ยังใหญ่เกินกว่าจะวิเคราะห์ได้ในครั้งเดียว
วิธีแก้ไขที่ดีที่สุดมักไม่ใช่การพยายามใช้ข้อความแจ้งเตือนขนาดใหญ่แบบเดิมซ้ำๆ เริ่มต้นด้วยการเปลี่ยนแปลงที่ก่อให้เกิดผลกระทบน้อยที่สุดก่อน จากนั้นค่อยขยายไปสู่การแบ่งส่วน การดึงข้อมูล หรือเวิร์กโฟลว์ที่มีบริบทขนาดใหญ่ขึ้นก็ต่อเมื่อวิธีที่ง่ายกว่ายังคงล้มเหลว
ขั้นแรก ตรวจสอบให้แน่ใจว่าข้อผิดพลาดนั้นเป็นปัญหาเกี่ยวกับหน้าต่างบริบทจริง ๆ
ก่อนที่จะแก้ไขเอกสาร โปรดแยกแยะข้อผิดพลาดเกี่ยวกับบริบทออกจากข้อจำกัดในการอัปโหลดหรือพื้นที่จัดเก็บข้อมูล คำแนะนำเกี่ยวกับการอัปโหลดไฟล์ในปัจจุบันของ OpenAI ระบุว่าไฟล์ที่อัปโหลดไปยัง ChatGPT หรือ GPT มีข้อจำกัดสูงสุด 512 MB ต่อไฟล์ ในขณะที่ไฟล์ข้อความและเอกสารมีข้อจำกัดสูงสุด 2 ล้านโทเค็นต่อไฟล์ ข้อจำกัดเหล่านี้เป็นข้อจำกัดในการอัปโหลด ไม่ใช่คำมั่นสัญญาว่าข้อความทั้งหมดจะถูกใส่เข้าไปในบริบทที่ใช้งานอยู่ของโมเดลพร้อมกัน
คำถามที่พบบ่อยเกี่ยวกับการอัปโหลดไฟล์ของ OpenAI คือแหล่งข้อมูลที่เชื่อถือได้ในการตรวจสอบขีดจำกัดการอัปโหลดในปัจจุบัน ขีดจำกัดที่แน่นอนจะแตกต่างกันไปตามผลิตภัณฑ์ แผน รุ่น และผู้ให้บริการ ดังนั้นอย่าคิดว่าตัวเลขที่คัดลอกมาจากบทความเก่าจะยังคงใช้ได้อยู่
| สิ่งที่คุณเห็น | ปัญหาคอขวดที่อาจเกิดขึ้น | ก้าวแรกที่ดีที่สุด |
|---|
| ไฟล์ถูกปฏิเสธก่อนเริ่มการวิเคราะห์ | ขนาดไฟล์ ประเภทไฟล์ พื้นที่จัดเก็บ หรือโควต้าการอัปโหลด | ตรวจสอบกฎการอัปโหลดปัจจุบัน |
| การอัปโหลดไฟล์สำเร็จ แต่ขั้นตอนการแจ้งเตือนยาวๆ ล้มเหลวเนื่องจากข้อผิดพลาดเกี่ยวกับบริบท | คำขอที่ใช้งานอยู่เกินงบประมาณบริบทของโมเดล | ลดขนาดคำขอและลดบริบทที่ใช้งานอยู่ |
| คำตอบนี้ครอบคลุมหน้าแรกๆ แต่ไม่ได้กล่าวถึงส่วนหลังๆ | เนื้อหาบางส่วนไม่ได้ถูกจัดวางให้อยู่ในบริบทที่เหมาะสม หรือการค้นหาข้อมูลอาจพลาดข้อความสำคัญบางส่วนไป | ตั้งคำถามที่เจาะจงมากขึ้น หรือแบ่งตามหัวข้อ |
| การสนทนาเคยได้ผลในตอนแรก แต่กลับล้มเหลวหลังจากผ่านไปหลายรอบ | ประวัติการสนทนาที่สะสมมานั้นกำลังบั่นทอนบริบท | เริ่มต้นหัวข้อการวิเคราะห์ใหม่ด้วยบทสรุปการส่งต่อที่กระชับ |
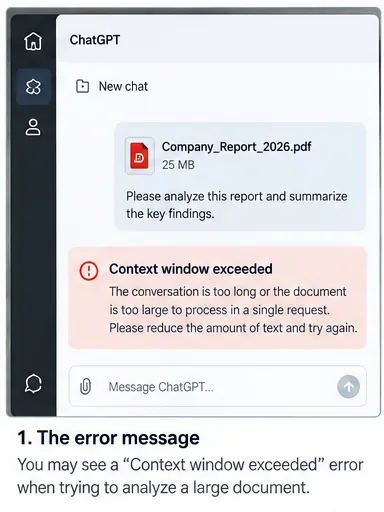 ข้อผิดพลาดในหน้าต่างบริบทอาจปรากฏขึ้นหลังจากอัปโหลดเอกสารสำเร็จ เนื่องจากคำขอที่ใช้งานอยู่ยังคงต้องอยู่ในขอบเขตงบประมาณโทเค็นของโมเดล
ขั้นตอนที่ 1: วัดขนาดเอกสารก่อนทำการแก้ไข
จำนวนหน้าและขนาดไฟล์เป็นข้อมูลเบื้องต้นที่มีประโยชน์ แต่จำนวนโทเค็นต่างหากที่เป็นตัววัดที่สำคัญสำหรับบริบทของข้อความ การแบ่งโทเค็นขึ้นอยู่กับภาษา รูปแบบ การใช้เครื่องหมายวรรคตอน และการเข้ารหัสของโมเดล ดังนั้นคู่มือทางเทคนิค 100 หน้าจึงอาจใช้จำนวนโทเค็นที่แตกต่างจากสไลด์นำเสนอ 100 หน้าอย่างมาก
คำแนะนำการนับโทเค็นของ OpenAI แนะนำให้ตรวจสอบหน้าต่างบริบทของโมเดลเป้าหมายและเว้นที่ว่างไว้สำหรับเอาต์พุต และสำหรับโมเดลการให้เหตุผล ให้เว้นที่ว่างไว้สำหรับโทเค็นการให้เหตุผลด้วย นอกจากนี้ยังระบุว่าโครงสร้างข้อความ เครื่องมือ ไฟล์ รูปภาพ และสคีมา สามารถเพิ่มโทเค็นนอกเหนือจากข้อความธรรมดาที่คุณนับได้
เพื่อการคัดกรองเบื้องต้น ให้จดบันทึกจำนวนหน้า จำนวนคำโดยประมาณ จำนวนส่วนหลัก และตรวจสอบว่าไฟล์นั้นมีภาคผนวก ภาษาทางกฎหมายที่ซ้ำซ้อน บันทึกดิบ บันทึกการถอดเสียง ตาราง หรือเอกสารอ้างอิงที่คุณไม่จำเป็นต้องใช้สำหรับงานนั้นหรือไม่
 ตรวจสอบขนาดของเอกสารก่อนทำการแก้ไขปัญหา ขนาดไฟล์และจำนวนหน้าเป็นเพียงตัวชี้วัดโดยประมาณเท่านั้น การใช้งานโทเค็นเป็นข้อจำกัดที่เกี่ยวข้องมากกว่าสำหรับการวิเคราะห์ข้อความ
ขั้นตอนที่ 2: ลดจำนวนการสนทนาที่กำลังดำเนินอยู่ก่อนที่จะแตะไฟล์
หากเอกสารไม่ใหญ่มาก วิธีแก้ไขที่ประหยัดที่สุดอาจเป็นการลบเนื้อหาส่วนเกินออกแทนที่จะแบ่งไฟล์ เริ่มการสนทนาหรือคำขอใหม่ และคัดลอกเฉพาะคำแนะนำที่สำคัญเท่านั้น แทนที่การสนทนาโต้ตอบที่ยาวเหยียดด้วยการส่งต่อสั้นๆ เช่น “วิเคราะห์รายงานที่แนบมาเพื่อหาปัจจัยขับเคลื่อนรายได้ ความเสี่ยงที่สำคัญ และแนวทางการจัดการ ส่งคืนข้อค้นพบห้าข้อพร้อมอ้างอิงหน้าหรือส่วน”
นอกจากนี้ ให้ลบข้อมูลพื้นหลังที่ซ้ำซ้อน ตัวอย่างที่ไม่จำเป็นอีกต่อไป ข้อความที่คัดลอกมาซ้ำ และผลลัพธ์ฉบับร่างก่อนหน้าออกด้วย หากคุณใช้เวิร์กโฟลว์ API ให้พิจารณาคำขอทั้งหมดแทนที่จะพิจารณาเฉพาะเอกสาร คำขอที่พอดีเป๊ะจะเหลือพื้นที่สำหรับคำตอบน้อย และอาจล้มเหลวโดยไม่คาดคิดเมื่อคำแนะนำหรือโครงสร้างของเครื่องมือขยายตัวขึ้น
สัญญาณแห่งความสำเร็จ:ไฟล์เดียวกันนี้ใช้งานได้ในเธรดใหม่ที่มีพรอมต์ที่เน้นเฉพาะเรื่อง หากเป็นเช่นนั้น ปัญหาจึงเกิดจากบริบทที่สะสมมาบางส่วน ไม่ใช่ตัวเอกสารเอง
ขั้นตอนที่ 3: จำกัดขอบเขตคำถามและผลลัพธ์ที่ต้องการให้แคบลง
การสั่งให้ “วิเคราะห์ทุกอย่างในเอกสาร 400 หน้าฉบับนี้และเขียนรายงานที่ครอบคลุม” จะบังคับให้ระบบพิจารณาหลายหัวข้อพร้อมกัน ควรสอบถามทีละคำถามแทน ตัวอย่างเช่น ควรขอข้อมูลเกี่ยวกับความเสี่ยงหลักของเอกสารก่อน จากนั้นจึงขอข้อมูลเกี่ยวกับสมมติฐานทางการเงิน และสุดท้ายคือความขัดแย้งระหว่างคำกล่าวอ้างของผู้บริหารกับข้อมูลสนับสนุน
ควรจำกัดรูปแบบของคำตอบ การขอผลลัพธ์ 20 หน้าจะใช้ทรัพยากรมากกว่าการขอตารางหลักฐาน 10 แถวมาก คุณสามารถขยายคำตอบสุดท้ายได้เสมอหลังจากรวบรวมหลักฐานเสร็จแล้ว
ตัวอย่างคำถามที่ตรงประเด็นและมีประโยชน์คือ: “โดยใช้เอกสารฉบับนี้เพียงอย่างเดียว ระบุข้อกล่าวอ้างที่เกี่ยวข้องกับการสูญเสียลูกค้าได้มากถึงแปดข้อ สำหรับแต่ละข้อกล่าวอ้าง ให้ระบุส่วนหรือหมายเลขหน้า คำอธิบายหนึ่งประโยค และข้อจำกัดใดๆ ที่ระบุไว้ หากเอกสารไม่มีหลักฐานเพียงพอ ให้ระบุด้วย”
เมื่อใดควรดำเนินการต่อไป:หากคำถามที่เจาะจงยังคงให้ข้อผิดพลาดเดิม หรือหากคุณต้องการข้อมูลที่เชื่อถือได้ครอบคลุมทั้งเอกสารแทนที่จะเป็นเพียงหัวข้อเดียว ให้แยกแหล่งข้อมูลออก
ขั้นตอนที่ 4: แบ่งเอกสารตามความหมาย ไม่ใช่แค่ตามจำนวนหน้าที่เท่ากัน
การแบ่งเอกสารออกเป็นส่วนๆ (Chunking) เป็นวิธีแก้ปัญหาที่น่าเชื่อถือที่สุดสำหรับเอกสารขนาดยาว แบ่งไฟล์ตามขอบเขตที่เป็นธรรมชาติ เช่น บทต่างๆ ส่วนของรายงาน สัญญา ภาคผนวก ช่วงวันที่ หรือลำดับการพูด การแบ่งเป็นส่วนๆ อย่างมีเหตุผลจะช่วยรักษาบริบทได้ดีกว่าการแบ่งแบบสุ่มทุกๆ 50 หน้า
หากส่วนใดส่วนหนึ่งขึ้นอยู่กับส่วนก่อนหน้าอย่างมาก ให้ใส่ส่วนที่ทับซ้อนกันเล็กน้อยหรือหมายเหตุเชื่อมโยงสั้นๆ เพื่ออธิบายส่วนก่อนหน้า ตั้งชื่อส่วนต่างๆ ให้ชัดเจน เช่น01_Executive_Summary.pdf, 02_Financial_Results.pdf, และ03_Risk_Factors.pdfพยายามรักษาหมายเลขหน้าเดิมไว้เพื่อให้สามารถตรวจสอบการสังเคราะห์ขั้นสุดท้ายได้
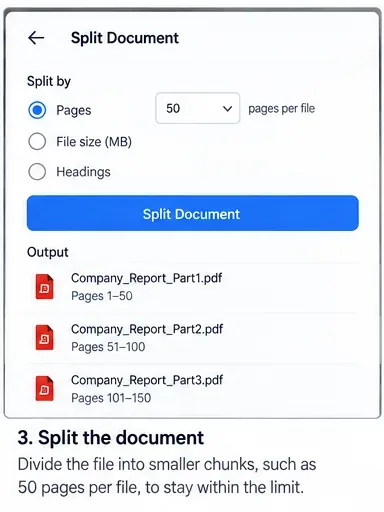 แบ่งแหล่งข้อมูลที่ยาวมากออกเป็นส่วนๆ ที่มีเหตุผลและตั้งชื่อให้ชัดเจน รักษาการอ้างอิงหน้าหรือส่วนเดิมไว้ เพื่อให้สามารถตรวจสอบความถูกต้องของการสังเคราะห์ข้อมูลในภายหลังกับแหล่งข้อมูลได้
ขั้นตอนที่ 5: วิเคราะห์แต่ละส่วนโดยใช้รูปแบบหลักฐานเดียวกัน
อย่าขอเพียงบทสรุปแบบไม่มีรูปแบบตายตัวสำหรับแต่ละส่วน ควรใช้โครงสร้างเดียวกันสำหรับทุกส่วนเพื่อให้สามารถรวมผลลัพธ์เข้าด้วยกันได้โดยไม่สูญเสียความแตกต่างที่สำคัญ โครงสร้างที่ใช้งานได้จริงอาจประกอบด้วย ชื่อส่วน ผลการค้นพบที่สำคัญ หลักฐานสนับสนุน การอ้างอิงหน้าหรือหัวข้อ ความไม่แน่นอน และคำถามที่ยังเปิดอยู่
ตัวอย่างเช่น: “วิเคราะห์เฉพาะส่วนที่ 3 เท่านั้น ส่งคืน: (1) ข้อค้นพบสำคัญไม่เกินห้าข้อ (2) หลักฐานสำหรับแต่ละข้อค้นพบ (3) การอ้างอิงหน้าหรือส่วนเดิม (4) ข้อควรระวังใดๆ ที่ผู้เขียนระบุไว้ และ (5) คำถามที่ต้องตรวจสอบในส่วนอื่น ห้ามอนุมานข้อเท็จจริงที่ไม่ได้อยู่ในส่วนนี้”
วิธีการนี้ยังช่วยให้ประเมินคุณภาพได้ง่ายขึ้นด้วย หากบทสรุปของกลุ่มข้อมูลมีข้ออ้างที่ไม่มีการระบุแหล่งที่มา ให้แก้ไขกลุ่มข้อมูลนั้นก่อนดำเนินการต่อ แทนที่จะหวังว่าการสังเคราะห์ขั้นสุดท้ายจะแก้ไขได้เอง
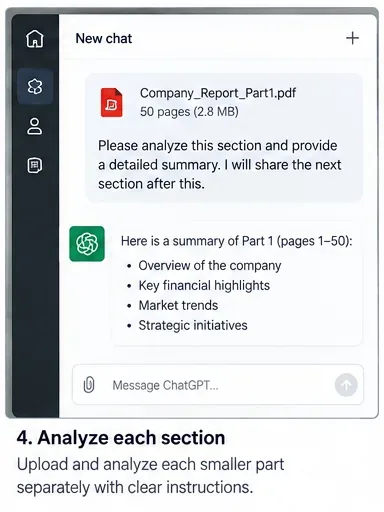 วิเคราะห์ทีละส่วนโดยใช้รูปแบบผลลัพธ์ที่กำหนดไว้ เพื่อให้สามารถนำผลลัพธ์ย่อยแต่ละส่วนมารวมกันและตรวจสอบย้อนกลับไปยังแหล่งที่มาได้ในภายหลัง
ขั้นตอนที่ 6: สร้างบทสรุปของบทสรุปแทนที่จะโหลดข้อมูลทั้งหมดใหม่ทุกครั้ง
เมื่อวิเคราะห์ส่วนต่างๆ เสร็จแล้ว ให้สร้างชุดหลักฐานที่กระชับจากผลลัพธ์ของแต่ละส่วนและสังเคราะห์ข้อมูลเหล่านั้นเข้าด้วยกัน อย่าส่งส่วนข้อมูลต้นฉบับทั้งหมดรวมถึงบทสรุปทั้งหมดกลับไปในคำขอสุดท้ายเพียงครั้งเดียว เพราะอาจทำให้เกิดปัญหาบริบทซ้ำเดิมได้
คำสั่งสังเคราะห์ควรบอกให้แบบจำลองคงไว้ซึ่งความขัดแย้งและช่องว่าง ตัวอย่างเช่น: “รวมการวิเคราะห์ส่วนต่างๆ เหล่านี้เข้าไว้ในรายงานฉบับเดียว รวมผลการค้นพบที่ซ้ำกัน เก็บหลักฐานที่ขัดแย้งกันไว้เป็นประเด็นแยกต่างหาก รักษาการอ้างอิงแหล่งที่มาทั้งหมด และทำเครื่องหมายคำถามใดๆ ที่ไม่สามารถหาคำตอบได้จากบทสรุป”
วิธีการจัดลำดับชั้นนี้มีประโยชน์อย่างยิ่งสำหรับหนังสือ เอกสารทางกฎหมาย ชุดข้อมูลสำหรับการค้นหา ชุดข้อมูลการสัมภาษณ์ขนาดยาว และการวิจัยที่มีเอกสารหลายฉบับ ข้อจำกัดหลักคือการบีบอัดข้อมูล: รายละเอียดที่ถูกละเว้นระหว่างการสรุปข้อมูลเป็นส่วนๆ จะไม่สามารถปรากฏขึ้นมาอีกครั้งได้โดยอัตโนมัติ นั่นคือเหตุผลที่โครงสร้างหลักฐานและการอ้างอิงแหล่งที่มามีความสำคัญ
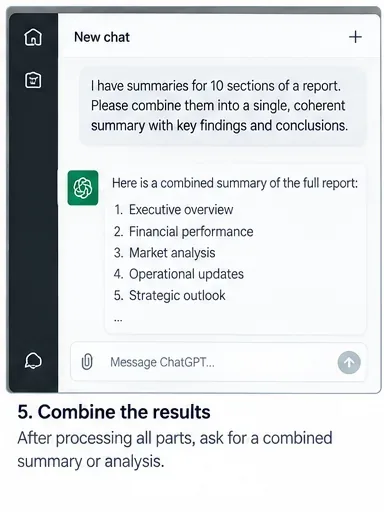 รวมการวิเคราะห์ส่วนย่อยที่กระชับแทนการโหลดข้อความต้นฉบับทั้งหมดใหม่ รักษาการอ้างอิง ข้อโต้แย้ง และคำถามที่ยังไม่ได้รับการแก้ไขไว้ในระหว่างการสังเคราะห์
ขั้นตอนที่ 7: พิจารณาแบบจำลองในบริบทที่กว้างขึ้น แต่ไม่ควรนำไปใช้เป็นวิธีแก้ปัญหาที่สมบูรณ์
โมเดลที่มีช่วงบริบทที่กว้างกว่าสามารถลดความถี่ในการแบ่งข้อมูลเป็นส่วนๆ ได้เอกสารประกอบโมเดล ปัจจุบันของ OpenAI ระบุขีดจำกัดช่วงบริบทและเอาต์พุตสูงสุดสำหรับโมเดล API และตัวเลขเหล่านั้นอาจเปลี่ยนแปลงได้เมื่อมีการอัปเดตโมเดล
อย่างไรก็ตาม ขนาดของบริบทส่วนหัวของโมเดลไม่จำเป็นต้องเท่ากับปริมาณของไฟล์ที่อัปโหลดซึ่งผลิตภัณฑ์จะวางลงในข้อความแจ้งเตือนโดยตรง คำแนะนำเกี่ยวกับไฟล์เฉพาะสำหรับองค์กรของ OpenAI ในปัจจุบันอธิบายถึงกระบวนการ "การเติมบริบท" แยกต่างหากสำหรับเอกสารข้อความที่อัปโหลด: สามารถวางโทเค็นจากเอกสารที่อัปโหลดได้สูงสุด 110,000 โทเค็นในบริบทโดยตรง โดยมีเนื้อหาเพิ่มเติมที่สามารถเข้าถึงได้ผ่านดัชนีการค้นหาส่วนตัว OpenAI ระบุอย่างชัดเจนว่าพฤติกรรมนี้อยู่ระหว่างการพัฒนาอย่างต่อเนื่องและอาจมีการเปลี่ยนแปลง ดูการเพิ่มประสิทธิภาพการอัปโหลดไฟล์ใน ChatGPT Enterprise
บทเรียนเชิงปฏิบัติคือ ควรเลือกใช้แบบจำลองที่มีบริบทกว้างขึ้นเมื่อช่วยลดความซับซ้อนของขั้นตอนการทำงานได้อย่างมีนัยสำคัญ แต่ก็ยังต้องตรวจสอบด้วยว่าส่วนที่เกี่ยวข้องได้รับการพิจารณาอย่างแท้จริงหรือไม่ บริบทกว้างขึ้นไม่ได้หมายความว่าจะขจัดความจำเป็นในการกำหนดขอบเขตที่ดี การอ้างอิงแหล่งที่มา หรือการตรวจสอบยืนยัน
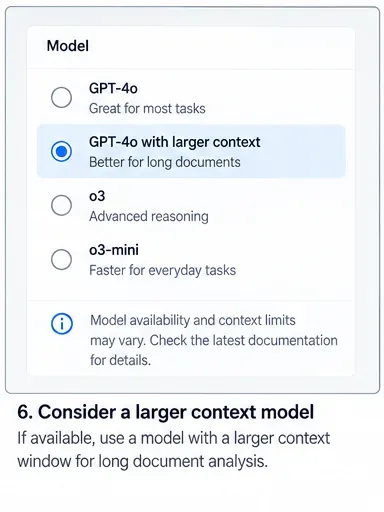 แบบจำลองในบริบทที่กว้างขึ้นอาจช่วยได้ แต่ควรตรวจสอบข้อจำกัดสำหรับแบบจำลองและพื้นผิวผลิตภัณฑ์ที่คุณใช้จริง แทนที่จะพึ่งพาตัวเลขทั่วไป
ขั้นตอนที่ 8: สำหรับคลังข้อมูลขนาดใหญ่มาก ให้เปลี่ยนจาก “ใส่ทุกอย่างลงไป” เป็นการดึงข้อมูลออกมา
หากงานนั้นเกี่ยวข้องกับเอกสารหลายร้อยหรือหลายพันหน้า ระบบการค้นหาข้อมูลมักเป็นโครงสร้างที่ดีกว่าการพยายามนำเนื้อหาทั้งหมดมาใส่ไว้ในคำถามเดียว ระบบการค้นหาข้อมูลจะจัดทำดัชนีแหล่งข้อมูล ค้นหาข้อความที่เกี่ยวข้องกับคำถามปัจจุบัน และนำเฉพาะข้อความเหล่านั้นไปใส่ในบริบทที่ใช้งานได้
เอกสารประกอบการใช้งานการค้นหาไฟล์ของ OpenAI อธิบายถึงเครื่องมือที่ให้บริการโดยผู้ให้บริการสำหรับการค้นหาไฟล์ที่อัปโหลดผ่านแหล่งเก็บข้อมูลเวกเตอร์ การดึงข้อมูลใช้งานได้ดีเป็นพิเศษสำหรับคำถามที่เจาะจง เช่น “ส่วนใดที่กำหนดการยุติเพื่อความสะดวก?” หรือ “รายงานกล่าวถึงความเข้มข้นของห่วงโซ่อุปทานในส่วนใด?”
การค้นหาข้อมูลจะมีความน่าเชื่อถือน้อยลงเมื่อภารกิจนั้นต้องการการรับรู้ทุกข้อความพร้อมกันอย่างแท้จริง เช่น การพิสูจน์ว่าหัวข้อหนึ่งไม่เคยปรากฏ การเปรียบเทียบทุกเซลล์ในตารางในชุดข้อมูลขนาดใหญ่ หรือการสร้างการแปลงข้อมูลแบบบรรทัดต่อบรรทัดอย่างละเอียด ในกรณีเหล่านั้น ควรใช้การประมวลผลแบบกลุ่มอย่างเป็นระบบหรือการประมวลผลล่วงหน้าโดยใช้โค้ดควบคู่ไปกับการค้นหาข้อมูล
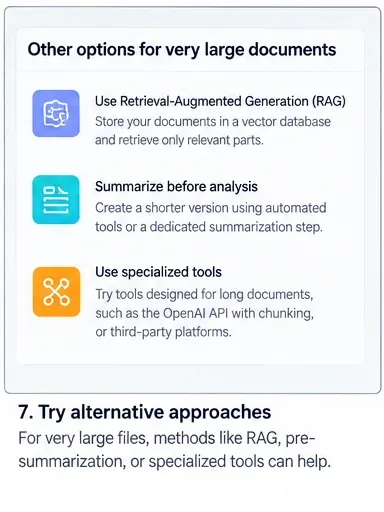 สำหรับชุดข้อมูลที่ยังคงมีขนาดใหญ่เกินไปหลังจากทำการแบ่งกลุ่มแล้ว การดึงข้อมูลจะสามารถนำเฉพาะข้อความที่เกี่ยวข้องมากที่สุดเข้ามาในบริบทที่ใช้งานอยู่สำหรับแต่ละคำถามได้เท่านั้น
การแก้ไข API ขั้นสูง: ควบคุมการตัดทอนอย่างจงใจ
นักพัฒนาที่ใช้ OpenAI Responses API มีตัวเลือกเพิ่มเติม เอกสารอ้างอิง API ระบุtruncationการตั้งค่าไว้ดังนี้: หากใช้disabled`true` ซึ่งเป็นค่าเริ่มต้นที่ระบุไว้ คำขอที่เกินขอบเขตบริบทของโมเดลจะล้มเหลว หากใช้auto`false` รายการสนทนาก่อนหน้าจะถูกตัดออกเพื่อให้คำขอพอดี ดู รายละเอียดเพิ่มเติมได้ในเอกสาร อ้างอิงResponses API
การตัดทอนอัตโนมัติสามารถป้องกันความล้มเหลวอย่างร้ายแรงได้ แต่จะเปลี่ยนข้อมูลที่มีให้แก่โมเดล สำหรับการวิเคราะห์เอกสาร การละทิ้งบริบทในช่วงต้นโดยไม่แจ้งให้ทราบอาจแย่กว่าการได้รับข้อผิดพลาด ควรใช้เฉพาะเมื่อแอปพลิเคชันของคุณได้รับการออกแบบมาเพื่อให้รายการสนทนาเก่าๆ ไม่จำเป็นหรือได้รับการสรุปไว้แล้วในที่อื่น
วิธีตรวจสอบว่าการแก้ไขได้ผลจริงหรือไม่
การร้องขอที่ประสบความสำเร็จเพียงอย่างเดียวไม่เพียงพอ เป้าหมายคือการวิเคราะห์ที่น่าเชื่อถือซึ่งครอบคลุมเนื้อหาที่ถูกต้องโดยไม่ละเลยหลักฐาน ตรวจสอบผลลัพธ์ก่อนที่จะคิดว่าปัญหาได้รับการแก้ไขแล้ว
- ตรวจสอบความครอบคลุม:ยืนยันว่าทุกบท ช่วงวันที่ หรือไฟล์ต้นฉบับที่จำเป็นปรากฏอยู่ในแผนการวิเคราะห์หรือตารางหลักฐานขั้นสุดท้าย
- การตรวจสอบที่มา:สุ่มตัวอย่างข้อกล่าวอ้างที่สำคัญและตรวจสอบการอ้างอิงหน้า ส่วน หรือไฟล์กับแหล่งที่มาดั้งเดิม
- ตรวจสอบขอบเขต:ตรวจสอบสิ่งที่ค้นพบใกล้กับขอบเขตของกลุ่มข้อมูลเพื่อให้แน่ใจว่าแนวคิดไม่ได้ถูกแบ่งแยกหรือขัดแย้งกันในแต่ละส่วน
- การตรวจสอบโดยใช้ตัวควบคุมเชิงลบ:ถามคำถามหนึ่งข้อที่ทราบว่าไม่มีคำตอบ กระบวนการทำงานที่ดีควรระบุว่าไม่มีหลักฐานอยู่จริง แทนที่จะสร้างหลักฐานขึ้นมาเอง
- ตรวจสอบความน่าเชื่อถือ:ลองถามคำถามตัวอย่างบางข้ออีกครั้ง การเปลี่ยนแปลงอย่างมากในหลักฐานที่อ้างอิงอาจบ่งชี้ถึงการค้นหาข้อมูลที่อ่อนแอหรือคำถามที่กว้างเกินไป
- ตรวจสอบงบประมาณ:หากคุณใช้ API ให้ตรวจสอบการใช้งานโทเค็นขาเข้าและขาออกจริง แทนที่จะพึ่งพาเพียงแค่การประมาณจำนวนคำคร่าวๆ เท่านั้น
 ขั้นตอนสุดท้ายคือการตรวจสอบ: ตรวจสอบความครอบคลุม ข้อมูลอ้างอิง ขอบเขตของกลุ่มข้อมูล และข้อกล่าวอ้างที่ไม่ได้รับการสนับสนุน ก่อนที่จะเชื่อถือการวิเคราะห์แบบรวม
สิ่งที่ไม่ควรทำ
อย่าส่งคำขอขนาดใหญ่ที่เหมือนกันซ้ำๆ แล้วหวังว่าจะได้รับจำนวนโทเค็นที่มากขึ้น อย่าลบการอ้างอิงแหล่งที่มาในระหว่างการแบ่งส่วนข้อมูล อย่าคิดว่าการที่ไฟล์ได้รับการยอมรับหมายความว่าทุกหน้าใช้งานได้ในบริบท และอย่าแก้ไขข้อผิดพลาดโดยการย่อคำตอบมากเกินไปจนการวิเคราะห์ไม่สามารถตอบสนองความต้องการได้อีกต่อไป
นอกจากนี้ ควรหลีกเลี่ยงการมองว่าการตัดทอนข้อมูลอัตโนมัติเป็นเหมือนเวทมนตร์ที่มองไม่เห็น หากระบบตัดรายการเก่าออกไป คำขออาจสำเร็จได้ แต่อาจสูญเสียคำแนะนำหรือหลักฐานที่สำคัญไป สำหรับการวิเคราะห์ที่มีความสำคัญสูง การแบ่งกลุ่มและการดึงข้อมูลอย่างชัดเจนมักตรวจสอบได้ง่ายกว่า
กฎการตัดสินใจเชิงปฏิบัติ
ถ้าการใช้กระทู้ใหม่และคำถามที่แคบลงได้ผล ให้คงขั้นตอนการทำงานให้เรียบง่าย หากงานนั้นต้องการการครอบคลุมกว้างๆ ของเอกสารยาวฉบับเดียว ให้แบ่งเอกสารออกเป็นส่วนๆ ตามตรรกะ และสังเคราะห์การวิเคราะห์แบบเป็นส่วนๆ ที่มีโครงสร้าง หากคุณสอบถามชุดเอกสารขนาดใหญ่ซ้ำๆ ให้ใช้การดึงข้อมูล หากคุณควบคุม API ได้และยังใกล้ถึงขีดจำกัด ให้วัดจำนวนโทเค็น สำรองพื้นที่เอาต์พุต เลือกโมเดลที่เหมาะสม และกำหนดพฤติกรรมการตัดทอนอย่างชัดเจนในการออกแบบ
ผลลัพธ์ที่ดีที่สุดไม่ใช่การยัดเยียดข้อความจำนวนมากที่สุดลงในคำขอเดียว แต่เป็นการครอบคลุมหลักฐานที่จำเป็น รักษาความสามารถในการตรวจสอบย้อนกลับ และทำให้เห็นได้อย่างชัดเจนเมื่อข้อมูลไม่พร้อมใช้งาน
เอกสารอ้างอิงอย่างเป็นทางการ








