คุณมีหน้าเว็บเกี่ยวกับสินค้า เอกสาร หรือบล็อก 300 หน้าที่พร้อมเผยแพร่แล้ว แต่คอลัมน์เมตาเดต้ายังว่างเปล่า การเขียนชื่อเรื่องและคำอธิบายเมตาด้วยมือทีละหน้าเป็นเรื่องช้า การคัดลอกรูปแบบเดียวไปทั่วทั้งเว็บไซต์ทำให้ได้ผลลัพธ์ที่ซ้ำซาก และการขอให้โมเดลภาษาท้องถิ่นช่วยสร้าง "ชื่อเรื่อง SEO" มักจะให้ผลลัพธ์เป็นคำอธิบายเพิ่มเติม ข้อความอ้างสิทธิ์ที่แต่งขึ้น หรือรูปแบบที่ไม่สอดคล้องกัน
แนวทางที่ดีกว่าคือการมองการสร้างเมตาเดต้าเป็นเหมือนไปป์ไลน์ข้อมูลขนาดเล็ก: ให้ข้อมูลเฉพาะหน้าแก่โมเดล กำหนดให้มีเอาต์พุตที่มีโครงสร้าง ตรวจสอบความถูกต้องในโค้ด จากนั้นตรวจสอบข้อผิดพลาดก่อนเผยแพร่ Ollama เหมาะสมกับเวิร์กโฟลว์นี้เป็นอย่างดี เนื่องจาก API ในเครื่องพร้อมใช้งานhttp://localhost:11434/apiหลังจากการติดตั้ง และ Ollama รองรับเอาต์พุตที่มีโครงสร้างแบบ JSON-schema เอกสารของ Ollama และ Google Search ที่อ้างอิงในที่นี้ได้รับการตรวจสอบเมื่อวันที่ 13 กันยายน 2026
เหตุใดเมตาเดต้า SEO อัตโนมัติจึงทำงานผิดพลาด
ความล้มเหลวส่วนใหญ่เกิดจากขั้นตอนการทำงานรอบๆ โมเดลมากกว่าจาก "คำถามที่ไม่ถูกต้อง" เพียงอย่างเดียว สาเหตุทั่วไป ได้แก่ การป้อนเนื้อหาหน้าเว็บน้อยเกินไป การปล่อยให้โมเดลตอบด้วยข้อความอิสระ การใช้สูตรคำหลักเดียวกันกับทุก URL และการเผยแพร่ผลลัพธ์โดยไม่ได้ตรวจสอบการซ้ำซ้อนในระดับเว็บไซต์
นอกจากนี้ยังมีความเข้าใจผิดเกี่ยวกับการจำกัดจำนวนตัวอักษรอยู่ด้วย Google ระบุว่าไม่มีการจำกัดความยาวตายตัวสำหรับ<title>องค์ประกอบหรือคำอธิบายเมตาของหน้าเว็บ ลิงก์ชื่อเรื่องและข้อความย่อจะถูกตัดทอนตามความจำเป็น โดยทั่วไปจะขึ้นอยู่กับความกว้างของอุปกรณ์ Google อาจสร้างลิงก์ชื่อเรื่องหรือข้อความย่อที่แตกต่างจากเนื้อหาหน้าเว็บเมื่อระบบของ Google พิจารณาว่าการแสดงผลแบบอื่นมีประโยชน์มากกว่า โปรดดูคำแนะนำอย่างเป็นทางการของ Google เกี่ยวกับลิงก์ชื่อเรื่อง ข้อความ ย่อและคำอธิบายเม ตา
นั่นหมายความว่าสคริปต์สามารถบังคับใช้ข้อจำกัดด้านความยาวในการแก้ไขเพื่อให้เกิดความสม่ำเสมอ แต่ไม่ควรระบุตัวเลขเหล่านั้นว่าเป็นข้อกำหนดของ Google ในตัวอย่างด้านล่าง 65 ตัวอักษรสำหรับชื่อเรื่องและ 165 ตัวอักษรสำหรับคำอธิบายเป็นเพียงข้อจำกัดภายในเท่านั้น เปลี่ยนให้ตรงกับ CMS แบรนด์ ความต้องการด้านการแปล และกระบวนการตรวจสอบของคุณ
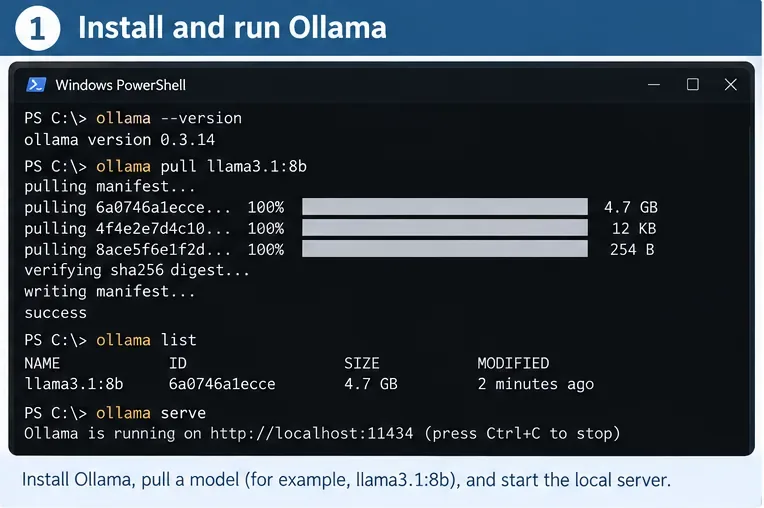
ขั้นตอนที่ 1: ติดตั้ง Ollama และตรวจสอบว่า API ในเครื่องใช้งานได้หรือไม่
คู่มือ เริ่มต้นใช้งานฉบับย่ออย่างเป็นทางการ ของ Ollama ระบุว่ารองรับ macOS, Windows และ Linux หลังจากติดตั้งแล้ว ให้ดาวน์โหลดโมเดลสำหรับใช้งานในเครื่อง เอกสารปัจจุบันของ Ollama มักใช้โมเดลนี้gemma3ในตัวอย่าง API ดังนั้นจึงเป็นตัวอย่างที่เป็นกลางและสะดวกสำหรับบทช่วยสอนนี้:
ollama pull gemma3จากนั้นทดสอบเอนด์พอยต์ในเครื่อง:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'เอกสารAPI ของ Ollama ระบุว่า API ภายในเครื่องนั้นให้บริการอยู่ที่http://localhost:11434/apiOllama ยังระบุอีกว่าการเข้าถึงภายในเครื่องที่ที่อยู่ดังกล่าวไม่จำเป็นต้องมีการตรวจสอบสิทธิ์ หากบริการภายในเครื่องของคุณไม่ได้ทำงานollama serveคำสั่ง CLI ที่ระบุไว้สำหรับการเริ่มต้นคือ หลีกเลี่ยงการแทนที่-cloudโมเดลหากเป้าหมายของคุณคือการอนุมานภายในเครื่องอย่างแท้จริง
ขั้นตอนการทำงานในโหมดเทอร์มินัลสำหรับขั้นตอนการตั้งค่า: ตรวจสอบ Ollama ดึงโมเดลมาเก็บไว้ในเครื่อง ยืนยันว่าโมเดลปรากฏในรายการโมเดลในเครื่อง และตรวจสอบให้แน่ใจว่าบริการพร้อมใช้งานบน localhost ชื่อโมเดลและตัวเลขความยาวที่แสดงเป็นเพียงตัวอย่างค่าขั้นตอนการทำงาน ไม่ใช่ข้อกำหนดด้าน SEO
เลือกโมเดลให้เหมาะสมกับฮาร์ดแวร์ของคุณ
บทความนี้จงใจไม่กล่าวอ้างว่าโมเดลใดโมเดลหนึ่งดีที่สุดสำหรับเมตาเดต้า SEO ความพร้อมใช้งานของโมเดลและความเหมาะสมของฮาร์ดแวร์เปลี่ยนแปลงไปตามเวลา และโมเดลขนาดใหญ่ต้องการหน่วยความจำมากขึ้นและโดยทั่วไปจะตอบสนองช้าลง เริ่มต้นด้วยโมเดลที่เครื่องของคุณสามารถใช้งานได้อย่างสะดวกสบาย สร้างชุดรีวิวขนาดเล็ก จากนั้นเปรียบเทียบความถูกต้องของข้อเท็จจริง ความเป็นเอกลักษณ์ ความหน่วง และความสม่ำเสมอ ก่อนที่จะประมวลผลหลายพันหน้า
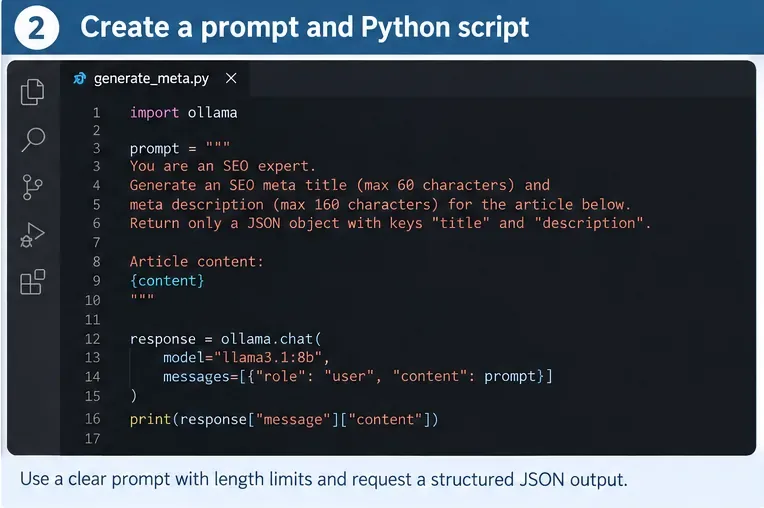
ขั้นตอนที่ 2: บังคับให้แสดงผลแบบมีโครงสร้างแทนการวิเคราะห์ข้อความ
ข้อความแบบอิสระนั้นเปราะบางต่อการทำงานอัตโนมัติ คำตอบเช่น “นี่คือสามตัวเลือกที่ยอดเยี่ยม…” บังคับให้โปรแกรมของคุณต้องเดาว่าชื่อเรื่องที่แท้จริงเริ่มต้นที่ใดเอกสารประกอบการใช้งานเอาต์พุตแบบมีโครงสร้าง ของ Ollama สนับสนุนการส่งผ่าน JSON schema ในformatฟิลด์ เอกสารยังแนะนำให้ใช้ schema ที่นำกลับมาใช้ใหม่ได้ผ่าน Pydantic ใน Python และระบุว่าอุณหภูมิต่ำ เช่น0สามารถปรับปรุงความแน่นอนได้
ติดตั้งแพ็กเกจ Python สองตัวที่ใช้ในตัวอย่างนี้:
python -m pip install -U ollama pydanticจากนั้นสร้างgenerate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
โปรแกรมสร้างข้อความควรระบุหลักฐานของหน้าเว็บ ฟิลด์เอาต์พุต และข้อจำกัดด้านบรรณาธิการอย่างชัดเจน ในการใช้งานจริง ควรเลือกใช้เอาต์พุตที่มีโครงสร้างแบบ JSON-schema ของ Ollama และการตรวจสอบความถูกต้องฝั่งแอปพลิเคชัน มากกว่าการพึ่งพาเพียงแค่ข้อความแจ้งเตือนเท่านั้น
เหตุใดข้อความแจ้งเตือนจึงรวมถึงชื่อเรื่องปัจจุบันและหัวข้อ H1
Google กล่าวว่าระบบการเชื่อมโยงชื่อเรื่องของ Google สามารถพิจารณาชื่อเรื่องหลักของหน้าเว็บ<title>หัวข้อต่างๆ เช่น<h1><br>, og:title<h1>, <h1>, ข้อความเด่น ข้อความลิงก์ และสัญญาณอื่นๆ เครื่องมือสร้างหน้าเว็บในเครื่องของคุณไม่จำเป็นต้องจำลองระบบของ Google แต่การใส่ชื่อเรื่องต้นฉบับ <h1> URL และข้อความเนื้อหาตัวอย่าง จะช่วยให้ข้อมูลเมตาที่เสนอสอดคล้องกับหน้าเว็บที่ผู้อ่านจะเห็นจริง
อย่าป้อนรายการคำหลักที่ไม่เกี่ยวข้องและขอให้โมเดล "ใส่เข้าไป" Google แนะนำอย่างชัดเจนให้ใช้ชื่อเรื่องที่กระชับและสื่อความหมายได้ดี และเตือนไม่ให้ใช้คำหลักมากเกินไปหรือใช้ข้อความซ้ำซาก สำหรับคำอธิบาย Google กล่าวว่าการสร้างคำอธิบายอัตโนมัติเฉพาะหน้าเหมาะสมสำหรับเว็บไซต์ขนาดใหญ่ที่ใช้ฐานข้อมูล เมื่อคำอธิบายนั้นถูกต้อง อ่านง่าย และมีความหลากหลาย
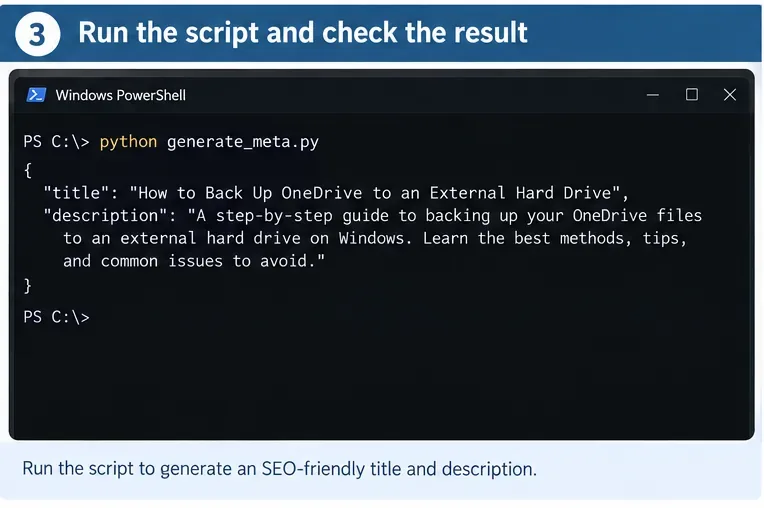
ขั้นตอนที่ 3: ทดลองใช้งานหนึ่งหน้าก่อน แล้วตรวจสอบความถูกต้องก่อนที่จะขยายผล
เรียกใช้สคริปต์:
python generate_meta.pyผลลัพธ์ที่ประสบความสำเร็จควรเป็นอ็อบเจ็กต์ JSON ที่ Pydantic สามารถตรวจสอบความถูกต้องได้ ที่สำคัญกว่านั้น ผู้ตรวจสอบที่เป็นมนุษย์ควรจะสามารถเปรียบเทียบกับหน้าเว็บต้นฉบับและตอบคำถามสี่ข้อได้อย่างรวดเร็ว:
ชื่อเรื่องอธิบายถึงหน้านี้โดยเฉพาะ หรืออธิบายถึงเว็บไซต์โดยทั่วไปใช่หรือไม่?
คำอธิบายนี้หลีกเลี่ยงการกล่าวอ้าง วันที่ ราคา หรือคุณสมบัติใดๆ ที่ไม่มีอยู่ในเนื้อหาต้นฉบับหรือไม่
หากอ่านข้อมูลเมตาเหล่านี้โดยไม่รวมเนื้อหาหน้าเว็บ จะยังคงมีความหมายอยู่หรือไม่?
มันแตกต่างจากเมตาเดต้าที่ใช้ในหน้าเว็บใกล้เคียงอยู่แล้วหรือไม่?
ทดสอบหน้าเว็บตัวอย่างหนึ่งหน้าก่อน และตรวจสอบผลลัพธ์ที่มีโครงสร้างก่อนเริ่มงานแบบกลุ่ม จำเป็นต้องมีผลลัพธ์ JSON ที่สามารถแยกวิเคราะห์ได้ แต่ความถูกต้องของข้อเท็จจริงและความเกี่ยวข้องในระดับหน้าเว็บยังคงต้องได้รับการตรวจสอบเพิ่มเติม
เพิ่มการลองใหม่เมื่อเกิดข้อผิดพลาดด้านการแก้ไข ไม่ใช่แค่ข้อผิดพลาดของ API เท่านั้น
โครงสร้างข้อมูลสามารถจำกัดประเภทและขนาดของข้อมูลได้ แต่ไม่สามารถรับประกันได้ว่าประโยคนั้นเป็นความจริงหรือมีความเฉพาะเจาะจงเพียงพอ ควรสร้างตรรกะการลองใหม่โดยใช้การตรวจสอบที่คุณสามารถวัดผลได้ ตัวอย่างเช่น ปฏิเสธช่องว่างเปล่า ชื่อเรื่องที่ซ้ำกัน ข้อความสำเร็จรูปที่ต้องห้าม หรือคำอธิบายที่ซ้ำกับชื่อเรื่องเกือบทุกคำ หากหน้าเว็บมีข้อความที่อยู่ภายใต้การกำกับดูแลหรือมีความเสี่ยงสูง ควรให้มีการตรวจสอบโดยมนุษย์แทนที่จะพยายามใช้ระบบอัตโนมัติเพื่อสร้างความมั่นใจ
จำกัดขอบเขตการแจ้งเตือนการลองใหม่ให้แคบลง แทนที่จะสร้างทุกอย่างใหม่ด้วยคำว่า “ทำให้ดีขึ้น” ให้บอกโมเดลว่าอะไรที่ล้มเหลว: “ชื่อเรื่องที่เสนอซ้ำกับหน้าอื่น เขียนใหม่โดยใช้หัวข้อที่ไม่ซ้ำกันใน H1 ในขณะที่ยังคงรักษาข้อความอ้างอิงทั้งหมดให้สอดคล้องกับเนื้อหาที่ให้มา” วิธีนี้จะทำให้ตรวจสอบความล้มเหลวได้ง่ายขึ้น
ขั้นตอนที่ 4: แปลงหน้าเว็บเป็นไฟล์ CSV เพื่อตรวจสอบและเผยแพร่
เมื่อการทดสอบแบบหน้าเดียวได้ผลลัพธ์ที่เชื่อถือได้แล้ว ให้จัดเก็บข้อมูลที่ป้อนลงในไฟล์ CSV โดยมีคอลัมน์ต่างๆ เช่นurl<head>, source_title<head>, <head> h1และcontent<head> ช่องเนื้อหาควรมีข้อความที่ทำความสะอาดแล้วของหน้าเว็บ ไม่ใช่เมนูนำทาง ข้อความแจ้งเตือนคุกกี้ หรือลิงก์ส่วนท้ายที่ไม่เกี่ยวข้องจำนวนมาก
เพิ่มตรรกะการประมวลผลแบบกลุ่มนี้ไว้ด้านล่างฟังก์ชันตัวสร้าง หรือวางไว้ในสคริปต์แยกต่างหาก:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
สามารถตรวจสอบไฟล์ CSV ที่ได้ใน Excel, LibreOffice, เครื่องมือการนำเข้าฐานข้อมูล หรือเวิร์กโฟลว์ CMS ของคุณได้ อย่าเขียนทับเมตาเดต้าที่มีอยู่โดยอัตโนมัติในการทำงานครั้งแรก เก็บชื่อและคำอธิบายเดิมไว้ควบคู่กับข้อเสนอที่สร้างขึ้น เพื่อให้ผู้ตรวจสอบสามารถเปรียบเทียบได้ และเพื่อให้สามารถย้อนกลับไปยังเวอร์ชันก่อนหน้าได้อย่างง่ายดาย
คิวตรวจสอบในสเปรดชีตช่วยให้การตรวจสอบการสร้างเนื้อหาจำนวนมากทำได้ง่ายขึ้น: เก็บรักษาตัวระบุหน้าต้นฉบับ ชื่อเรื่องที่สร้างขึ้น คำอธิบายที่สร้างขึ้น ความยาว และเครื่องหมาย QA ก่อนที่จะเผยแพร่การเปลี่ยนแปลง
ทำให้กระบวนการจัดการล็อตสินค้าปลอดภัยยิ่งขึ้น
ตรวจสอบ สิ่งที่ต้องติดธง ทำไมเรื่องนี้ถึงสำคัญ
การตรวจสอบความถูกต้องของสคีมา ช่องข้อมูลที่ขาดหายหรือไม่ถูกต้อง ป้องกันไม่ให้ข้อมูลที่ไม่ถูกต้องเข้าสู่ระบบ CMS ตรวจสอบเอกสารสิทธิ์ซ้ำ ชื่อเรื่องที่ปรับให้เป็นมาตรฐานเดียวกันบน URL สองรายการ ช่วยให้แยกแยะหน้าต่างๆ ได้ง่ายขึ้น ตรวจสอบภาษา ภาษาของเมตาเดตาแตกต่างจากภาษาของหน้าเว็บ Google แนะนำให้เลือกภาษาและระบบการเขียนที่ตรงกับภาษาหลักของหน้าเว็บ การตรวจสอบหลักฐาน ไม่มีข้อมูลตัวเลข ราคา วันที่ ยี่ห้อ หรือการรับประกันจากแหล่งที่มา ลดจำนวนการกล่าวอ้างที่เกิดจากภาพหลอน การตรวจสอบแบบฟอร์มมาตรฐาน วลียาวๆ ที่ใช้ซ้ำทั่วทั้งเว็บไซต์ Google แนะนำไม่ให้ใช้ชื่อเรื่องที่ซ้ำซากจำเจ ตรวจสอบความยาวบทความ นอกช่วงบ้านที่คุณเลือก ช่วยให้ผลลัพธ์ของ CMS มีความสม่ำเสมอ นี่ไม่ใช่กฎจำกัดจำนวนอักขระของ Google การตรวจสอบโดยมนุษย์ หน้าเว็บที่มีความสำคัญเชิงกลยุทธ์ ละเอียดอ่อน มีปริมาณการเข้าชมสูง หรือคลุมเครือ ระบบอัตโนมัติควรแสดงให้เห็นถึงข้อผิดพลาด ไม่ใช่ซ่อนข้อผิดพลาดเหล่านั้น
ปัญหาทั่วไป ตั้งแต่แก้ไขง่ายที่สุดไปจนถึงแก้ไขยากที่สุด
การเชื่อมต่อ API ล้มเหลว
ขั้นแรก ตรวจสอบให้แน่ใจว่า Ollama ทำงานอยู่และhttp://localhost:11434สามารถเข้าถึงได้เอกสารการตรวจสอบสิทธิ์ อย่างเป็นทางการ ระบุว่าไม่จำเป็นต้องมีการตรวจสอบสิทธิ์สำหรับ API ภายใน หากสคริปต์ของคุณชี้ไปยังhttps://ollama.com/apiปลายทางโฮสต์อื่นโดยไม่ได้ตั้งใจ นั่นคือปลายทางโฮสต์ที่แตกต่างกันและต้องมีการตรวจสอบสิทธิ์
คำตอบประกอบด้วยข้อความเชิงอรรถเกี่ยวกับ JSON
ใช้โครงสร้างข้อมูลformat=SeoMeta.model_json_schema()แทนการขอข้อมูล JSON เพียงอย่างเดียวด้วยภาษาธรรมชาติ การจัดโครงสร้างข้อมูลเป็นชั้นควบคุมที่เหมาะสมสำหรับกระบวนการทำงานในระดับการผลิต
ชื่อเรื่องทั้งหมดฟังดูเหมือนกันหมด
ป้อนข้อความ H1 เฉพาะหน้าและเนื้อหาหลักที่มีความหมาย ลบข้อมูลนำทางที่ไม่จำเป็น และขอคำอธิบายเฉพาะหน้าอย่างชัดเจน จากนั้นทำการตรวจสอบความซ้ำซ้อนและความคล้ายคลึงกันระหว่างหน้าต่างๆ การทำซ้ำมักเป็นปัญหาจากการป้อนข้อมูลก่อนที่จะเป็นปัญหาจากแบบจำลอง
แบบจำลองนี้สร้างคุณลักษณะหรือสถิติขึ้นมาเอง
ลดปริมาณข้อมูลป้อนเข้าให้เหลือเพียงข้อความในหน้าเว็บที่น่าเชื่อถือ และเสริมความแข็งแกร่งให้กับกฎพื้นฐาน: ห้ามกล่าวอ้างข้อเท็จจริงใดๆ นอกเหนือจากเนื้อหาที่ให้มา สำหรับหน้าเว็บที่สำคัญ ให้เปรียบเทียบข้อความที่สร้างขึ้นกับฟิลด์แหล่งข้อมูลที่มีโครงสร้างก่อนอนุมัติ หากแหล่งข้อมูลนั้นคลุมเครือ ให้ส่งแถวนั้นไปให้มนุษย์ตรวจสอบแทนที่จะให้โมเดลคาดเดาซ้ำๆ
โมเดลนี้ทำงานช้าเกินไปสำหรับการประมวลผลหลายพันหน้า
วัดผลก่อนเปลี่ยนแปลงโครงสร้างสถาปัตยกรรม บันทึกเวลาในการสร้างต่อหน้า ขนาดข้อมูลนำเข้า ชื่อโมเดล และอัตราความล้มเหลว ตัดข้อความที่ไม่เกี่ยวข้องออก ประมวลผลส่วนของหน้าที่เสถียร และทดสอบโมเดลขนาดเล็กกว่าในเครื่องหากคุณภาพยังคงยอมรับได้ โมเดลที่เร็วที่สุดก็ไม่มีประโยชน์หากเมตาเดตาของมันสร้างงานตรวจสอบมากกว่าที่จะช่วยประหยัด
ตัวเลือกเสริม: ใช้การผสานรวมในรูปแบบ OpenAI ที่มีอยู่แล้ว
หากคุณมีโค้ดที่เขียนไว้สำหรับไคลเอ็นต์ที่เข้ากันได้กับ OpenAI อยู่แล้ว Ollama ได้จัดทำเอกสารเกี่ยวกับความเข้ากันได้กับ API ของ OpenAI บางส่วนไว้ ที่นี่http://localhost:11434/v1/ซึ่งจะช่วยลดงานการย้ายข้อมูลได้ สำหรับเครื่องมือสร้างเมตาเดต้าแบบโลคอลเท่านั้น ไคลเอ็นต์ Python ดั้งเดิมของ Ollama นั้นใช้งานง่ายกว่าและมีตัวอย่างเอาต์พุตแบบมีโครงสร้างแสดงอยู่ในเอกสารของ Ollama โดยตรง
วิธีการตรวจสอบระบบที่เสร็จสมบูรณ์ด้วยตนเอง
ก่อนที่จะสรุปว่าการทำงานอัตโนมัติเสร็จสมบูรณ์แล้ว ให้สร้างชุดตรวจสอบที่มีเนื้อหาประเภทต่างๆ กัน ได้แก่ บทความสั้น คู่มือฉบับยาว หน้าสินค้า หน้าหมวดหมู่ หน้าที่มีตัวเลข และหน้าในทุกภาษาที่รองรับ เรียกใช้โมเดลและข้อความแจ้งเตือนเดียวกันกับทุกชุดตรวจสอบ จากนั้นตรวจสอบรายการตรวจสอบต่อไปนี้
จุดเชื่อมต่อภายในเครื่องคือlocalhostและโมเดลที่เลือกคือโมเดลภายในเครื่อง ไม่ใช่โมเดลที่ติดแท็กบนระบบคลาวด์
ทุกการตอบกลับจะตรวจสอบความถูกต้องกับโครงสร้างข้อมูลโดยไม่ต้องทำการแก้ไข JSON ด้วยตนเอง
ไม่มีชื่อเรื่องที่สร้างขึ้นซ้ำกันในชุดรีวิวทั้งหมด
ข้อเท็จจริงทุกข้อปรากฏอยู่ในเนื้อหาของหน้าเว็บที่ให้มา
ข้อมูลเมตาใช้ภาษาหลักและระบบการเขียนเดียวกันกับหน้าเว็บ
ชื่อเรื่องมีความชัดเจน กระชับ และไม่มีการใช้คำหลักซ้ำซ้อน
คำอธิบายนี้สรุปเฉพาะหน้าเว็บนั้นๆ ไม่ใช่ภาพรวมของเว็บไซต์ทั้งหมด
ขอบเขตความยาวภายในที่คุณกำหนดไว้นั้นระบุว่าเป็นกฎเกณฑ์ด้านบรรณาธิการ ไม่ใช่ข้อกำหนดของ Google
ข้อมูลเมตาเก่า ข้อเสนอที่สร้างขึ้น แฟล็ก QA ชื่อโมเดล และเวอร์ชันของพรอมต์จะถูกบันทึกไว้สำหรับการตรวจสอบและการย้อนกลับ
ผู้ตรวจสอบจะทราบว่าต้องอนุมัติด้วยตนเองในส่วนใดบ้างก่อนเผยแพร่
สุดท้ายนี้ โปรดจำไว้ว่าระบบอัตโนมัติสามารถควบคุมอะไรได้บ้างและควบคุมอะไรไม่ได้บ้าง<title>คำอธิบายเมตาที่ดีและมีประโยชน์จะให้สัญญาณระดับหน้าเว็บที่เป็นประโยชน์แก่เครื่องมือค้นหา แต่ Google สามารถสร้างลิงก์ชื่อเรื่องและข้อความย่อจากเนื้อหาหน้าเว็บอื่นๆ ได้ ดังนั้นเป้าหมายจึงไม่ใช่การบังคับให้แสดงผลการค้นหาแบบใดแบบหนึ่ง เป้าหมายคือการสร้างเมตาเดตาที่ถูกต้อง ชัดเจน และมีประโยชน์ในปริมาณมาก ในขณะเดียวกันก็รักษาการตรวจสอบและการทบทวนให้เพียงพอเพื่อตรวจจับข้อผิดพลาดก่อนที่จะถึงขั้นตอนการผลิต