วิธีที่มีประสิทธิภาพที่สุดในการป้องกันไม่ให้ตัวแทนบริการลูกค้า AI รั่วไหลข้อมูลที่ละเอียดอ่อน คือการทำให้แน่ใจว่าโมเดลจะไม่รับ ดึงข้อมูล หรือดำเนินการกับข้อมูลมากกว่าที่คำขอของลูกค้าในปัจจุบันต้องการ อย่าพึ่งพาข้อความแจ้งเตือนของระบบที่บอกว่า “ห้ามเปิดเผยข้อมูลส่วนตัว” ควรใช้การควบคุมแบบกำหนดได้กับโมเดล: ลดและปกปิดข้อมูลป้อนเข้า อนุญาตการค้นหาข้อมูลทุกครั้งนอก LLM ให้สิทธิ์ขั้นต่ำแก่เครื่องมือ แยกข้อมูลของลูกค้าแต่ละราย ตรวจสอบความถูกต้องของคำตอบก่อนส่ง และตรวจสอบเส้นทางทั้งหมด
การออกแบบดังกล่าวสอดคล้องกับทิศทางของแนวทางการรักษาความปลอดภัยในปัจจุบันเอกสาร NIST Generative AI Profile (NIST AI 600-1) ซึ่งเผยแพร่ในปี 2024 และได้รับการปรับปรุงโดย NIST ในปี 2026 ถือว่าความเป็นส่วนตัว ความปลอดภัย การตรวจสอบ และการจัดการความเสี่ยงเป็นประเด็นสำคัญตลอดวงจรชีวิตOWASP Top 10 สำหรับ LLM และแอปพลิเคชัน Generative AI ระบุการแทรกข้อความแจ้งเตือน การเปิดเผยข้อมูลที่ละเอียดอ่อน การจัดการเอาต์พุตที่ไม่เหมาะสม การให้อำนาจมากเกินไป และการรั่วไหลของข้อความแจ้งเตือนจากระบบ เป็นความเสี่ยงที่แยกต่างหาก ในทางปฏิบัติแล้ว ข้อสรุปนั้นง่ายมาก: ตัวแทนบริการลูกค้าที่ปลอดภัยต้องการการควบคุมอิสระหลายอย่าง ไม่ใช่แค่ข้อความแจ้งเตือนอัจฉริยะเพียงอย่างเดียว
เริ่มจากเส้นทางข้อมูล ไม่ใช่พรอมต์โมเดล
ก่อนที่จะเลือกโมเดลหรือเพิ่มข้อความเตือนเพิ่มเติม ให้ลองวาดเส้นทางที่ข้อมูลลูกค้าไหลผ่านระบบของคุณเสียก่อน โดยทั่วไปแล้ว เจ้าหน้าที่ฝ่ายสนับสนุนอาจได้รับข้อความ ดึงข้อมูลจาก CRM ค้นหาในฐานความรู้ เรียกใช้ API สำหรับการสั่งซื้อหรือการเรียกเก็บเงิน สร้างคำตอบ บันทึกข้อมูล และจัดเก็บหน่วยความจำการสนทนา ข้อมูลที่ละเอียดอ่อนอาจรั่วไหลได้ในจุดใดจุดหนึ่งเหล่านั้น
สำหรับบอทถามตอบพื้นฐานที่ไม่เข้าถึงข้อมูลลูกค้ารายใดเลย ความเสี่ยงหลักของคุณคือสิ่งที่ลูกค้าพิมพ์ลงในแชทและสิ่งที่ถูกบันทึกไว้ สำหรับผู้ช่วยตรวจสอบสถานะคำสั่งซื้อ การอนุญาตและการกรองข้อมูลในระดับฟิลด์มีความสำคัญอย่างยิ่ง สำหรับเจ้าหน้าที่ที่สามารถคืนเงิน เปลี่ยนที่อยู่ หรือยกเลิกบริการได้ สิทธิ์การใช้งานเครื่องมือและการยืนยันธุรกรรมมีความสำคัญไม่แพ้การกรองคำตอบ
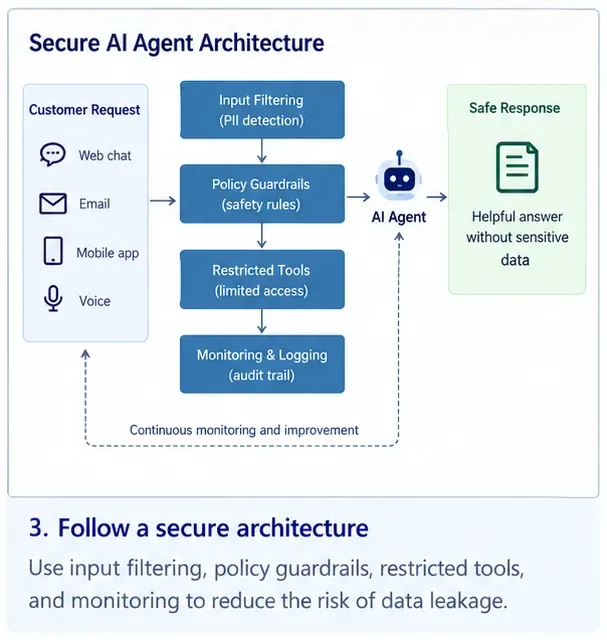
ระบบบริการลูกค้าที่ปลอดภัยควรมีการควบคุมที่เป็นอิสระหลายด้าน เช่น การกรองข้อมูลเข้า การบังคับใช้นโยบาย การเข้าถึงเครื่องมือ การจัดการข้อมูลออก และการบันทึกการตรวจสอบ แทนที่จะพึ่งพารูปแบบเพียงอย่างเดียว
1. ลบข้อมูลที่ละเอียดอ่อนออกก่อนที่จะส่งไปยังโมเดล
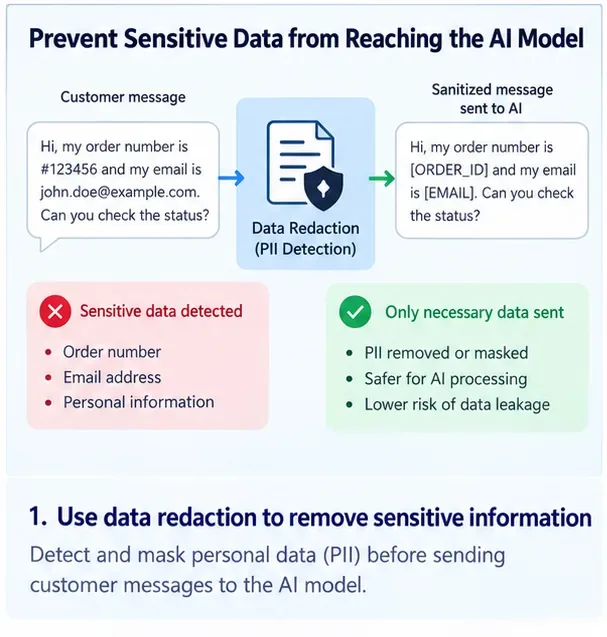
การลดปริมาณข้อมูลเป็นมาตรการควบคุมขั้นแรกที่แข็งแกร่งที่สุด เพราะข้อมูลที่โมเดลไม่เคยได้รับจะไม่สามารถนำมาใช้ซ้ำในผลลัพธ์ได้แนวทางการรักษาความปลอดภัยข้อมูลของ FTC แนะนำให้เก็บรวบรวมเฉพาะสิ่งที่จำเป็น เก็บรักษาให้ปลอดภัย และกำจัดทิ้งอย่างปลอดภัย นำแนวคิดนี้ไปประยุกต์ใช้โดยตรงกับการสร้างบริบทของ AI
สมมติว่าลูกค้าถามว่า “คำสั่งซื้อของฉันอยู่ที่ไหน?” โดยปกติแล้วโมเดลไม่จำเป็นต้องทราบหมายเลขบัตรเครดิต หมายเลขประจำตัวผู้เสียภาษี วันเกิด ประวัติที่อยู่โดยละเอียด หรือบันทึกการป้องกันการฉ้อโกงภายในของลูกค้า แอปพลิเคชันของคุณสามารถตรวจสอบตัวตนของลูกค้า โทรไปยังฝ่ายบริการคำสั่งซื้อ และส่งเฉพาะผลลัพธ์ที่จำกัด เช่น หมายเลขคำสั่งซื้อ สถานะการจัดส่ง การประมาณการจัดส่ง และบันทึกการสนับสนุนที่ได้รับการอนุมัติ ไปยังโมเดลเท่านั้น
ลบหรือแทนที่ข้อมูลที่มีความอ่อนไหว ก่อนทำการสร้างแบบจำลอง หากค่าดั้งเดิมไม่จำเป็นต่อการตอบคำขอความช่วยเหลือ
สิ่งที่ต้องแก้ไขหรือแปลงเป็นโทเค็น
รายการที่แน่นอนขึ้นอยู่กับธุรกิจและข้อผูกพันทางกฎหมายของคุณ แต่โดยทั่วไปแล้ว ข้อมูลที่อาจพบได้บ่อย ได้แก่ ข้อมูลประจำตัวการชำระเงิน รหัสลับการตรวจสอบสิทธิ์ รหัสประจำตัวของหน่วยงานรัฐ ข้อมูลสุขภาพ หมายเลขบัญชีการเงินทั้งหมด ที่อยู่ส่วนตัว บันทึกความปลอดภัยภายใน และข้อมูลธุรกิจที่เป็นความลับ ควรใช้ตัวตรวจจับแบบกำหนดได้ (deterministic detectors) เท่าที่จะเป็นไปได้ และรักษาแบบแผนเฉพาะโดเมนสำหรับรหัสประจำตัวของคุณเอง
อย่าคิดว่าการซ่อนข้อความแชทที่มองเห็นได้นั้นเพียงพอแล้ว ให้ใช้หลักการเดียวกันนี้กับเอกสารที่ดึงมา การตอบสนองของเครื่องมือ บันทึกย่อของเจ้าหน้าที่ สรุปการสนทนา เหตุการณ์การวิเคราะห์ ร่องรอย และบันทึกข้อผิดพลาดด้วย
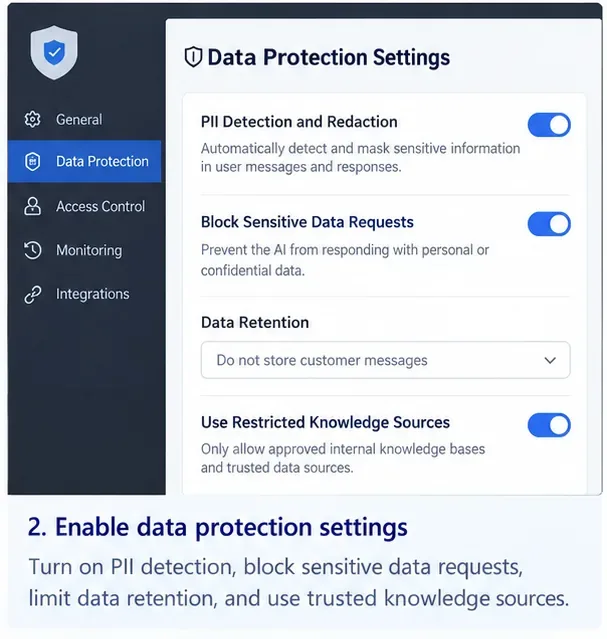
การตรวจจับข้อมูลส่วนบุคคล การปกปิดข้อมูล แหล่งข้อมูลที่จำกัด และข้อจำกัดในการเก็บรักษา ควรบังคับใช้ในระดับแอปพลิเคชัน หน้าจอนี้แสดงถึงการควบคุมในเชิงแนวคิดมากกว่าผลิตภัณฑ์เชิงพาณิชย์เฉพาะเจาะจง
2. บังคับใช้การอนุญาตของลูกค้าภายนอก LLM
แบบจำลอง AI ไม่ควรตัดสินใจว่าลูกค้า A ได้รับอนุญาตให้อ่านข้อมูลของลูกค้า B หรือไม่ การอนุญาตต้องเกิดขึ้นในโค้ดแอปพลิเคชันที่กำหนดได้แน่นอน หรือบริการควบคุมการเข้าถึง ก่อนที่จะส่งข้อมูลกลับไปยังตัวแทน
หลักการนี้สอดคล้องกับหลักการของNIST SP 800-207 สถาปัตยกรรมความไว้วางใจเป็นศูนย์ (Zero Trust Architecture ) กล่าวคือ การเข้าถึงทรัพยากรจะได้รับอนุญาตโดยพิจารณาจากตัวตนที่ได้รับการตรวจสอบและอนุญาตอย่างถูกต้อง แทนที่จะเป็นความไว้วางใจโดยปริยาย สำหรับเอเจนต์ AI แนวทางเดียวกันนี้หมายความว่า ทุกคำขอ CRM การออกตั๋ว การสั่งซื้อ หรือการเรียกเก็บเงิน ควรมีข้อมูลระบุตัวตนผู้ใช้ที่ได้รับการตรวจสอบแล้ว และตรวจสอบกับทรัพยากรที่ร้องขอ
การค้นหาข้อมูลคำสั่งซื้อที่ปลอดภัยอาจทำได้โดยการ "ดึงสถานะคำสั่งซื้อสำหรับ authenticated_customer_id และ order_id" โดยที่ระบบแบ็กเอนด์จะยืนยันความเป็นเจ้าของก่อนที่จะส่งการตอบกลับที่อนุญาตกลับมา ส่วนการออกแบบที่อันตรายคือการ "ค้นหาบันทึกของลูกค้าทั้งหมด" แล้วเชื่อมั่นว่าโมเดลจะเลือกข้อมูลที่ถูกต้องได้เอง
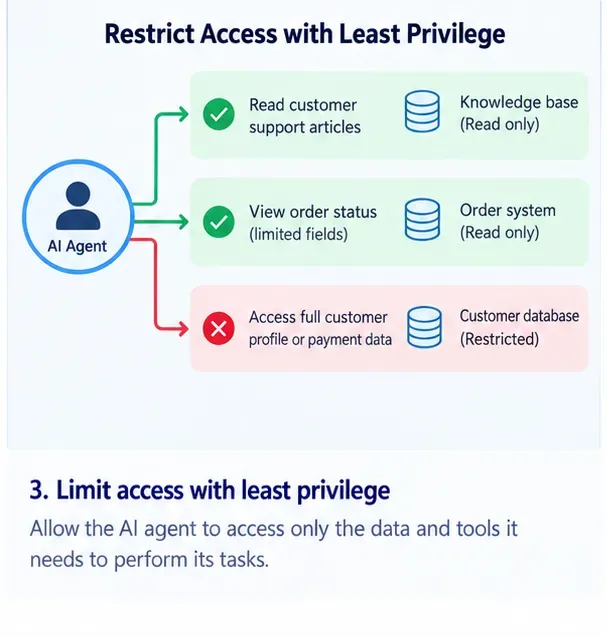
ให้ตัวแทนเข้าถึงข้อมูลด้วยชุดความสามารถในการอ่านและเขียนข้อมูลที่จำเป็นขั้นต่ำที่สุดเท่านั้น ข้อมูลลูกค้าทั้งหมดและข้อมูลการชำระเงินไม่ควรเข้าถึงได้ง่ายเพียงเพราะมี API ที่ครอบคลุมกว่านั้นอยู่
3. กำหนดสิทธิ์การเข้าถึงให้น้อยที่สุดแก่เครื่องมือ และแยกการกระทำที่มีความเสี่ยงสูงออกจากกัน
เอเจนต์ที่ใช้เครื่องมือช่วยนั้นมีความเสี่ยงเป็นพิเศษ เพราะการฉีดข้อมูลผิดพลาดหรือข้อผิดพลาดของโมเดลเพียงเล็กน้อยก็อาจกลายเป็นการโจมตีระบบจริงได้คำแนะนำเรื่องเอเจนต์ที่มี ฟังก์ชันการทำงานมากเกินไป สิทธิ์การเข้าถึงที่มากเกินไป และความเป็นอิสระที่มากเกินไป ระบุว่าเป็นสาเหตุหลักของพฤติกรรมเอเจนต์ที่ก่อให้เกิดความเสียหาย
อย่าให้สิทธิ์การเข้าถึง CRM แบบทั่วไปแก่เจ้าหน้าที่บริการลูกค้าเพียงคนเดียว โดยให้สิทธิ์ในการอ่าน/เขียนข้อมูลทุกรายการ ควรแบ่งสิทธิ์ตามวัตถุประสงค์ เจ้าหน้าที่ฝ่ายความรู้ อาจต้องการสิทธิ์ในการอ่านอย่างเดียวสำหรับเนื้อหาช่วยเหลือที่ได้รับอนุมัติ เครื่องมือตรวจสอบสถานะคำสั่งซื้อ อาจแสดงเฉพาะข้อมูลการจัดส่ง เครื่องมือคืนเงิน อาจต้องการขอบเขตการอนุญาต ขีดจำกัดการทำธุรกรรม และการยืนยันจากบุคคลหรือลูกค้าก่อนดำเนินการ
สำหรับการดำเนินการที่มีผลกระทบสูง ควรบังคับใช้กฎทางธุรกิจในโค้ดแบ็กเอนด์ โมเดลอาจเสนอ "คำสั่งคืนเงิน 123" แต่แอปพลิเคชันควรตรวจสอบความถูกต้องของลูกค้าที่ได้รับการยืนยันตัวตน สิทธิ์ในการคืนเงิน จำนวนเงิน สกุลเงิน สถานะการทำธุรกรรม และข้อกำหนดการอนุมัติอย่างอิสระ
4. ให้ถือว่าข้อความของลูกค้าและเนื้อหาที่ดึงมานั้นเป็นข้อมูลที่ไม่น่าเชื่อถือ
การแทรกคำสั่งแบบป้อนข้อความอัตโนมัติไม่ได้จำกัดอยู่แค่การที่ลูกค้าพิมพ์ “ละเว้นคำสั่งของคุณ” เท่านั้นแนวทางของ OWASP Prompt Injection ระบุว่า คำสั่งทางอ้อมยังสามารถมาในรูปแบบเอกสาร เว็บเพจ ผลลัพธ์จากเครื่องมือ รูปภาพ หรือเนื้อหาอื่นๆ ที่โมเดลประมวลผลได้อีกด้วย
เรื่องนี้สำคัญในงานบริการลูกค้า เพราะเจ้าหน้าที่มักเรียกดูประวัติการแจ้งปัญหา อีเมล เอกสารที่อัปโหลด หน้าสินค้า หรือบันทึกในระบบ CRM คำสั่งที่เป็นอันตรายที่ซ่อนอยู่ภายในแหล่งข้อมูลเหล่านั้นควรคงอยู่เป็นเพียงข้อมูล ไม่ใช่กลายเป็นอำนาจเหนือเจ้าหน้าที่
ใช้รายการแหล่งข้อมูลการเรียกค้นที่ได้รับอนุญาต แยกคำสั่งที่เชื่อถือได้ออกจากเนื้อหาที่ไม่น่าเชื่อถือ ทำความสะอาดหรือแปลงข้อมูลที่เรียกค้นได้เมื่อทำได้ และตรวจสอบการอนุญาตที่ขอบเขตของเครื่องมือ เมื่อเอกสารที่เรียกค้นร้องขอข้อมูลลับ ข้อมูลประจำตัว บันทึกที่ไม่เกี่ยวข้อง หรือการกระทำของเครื่องมือ แอปพลิเคชันโดยรอบควรบล็อกการดำเนินการเหล่านั้นโดยไม่คำนึงถึงสิ่งที่แบบจำลองตัดสินใจ
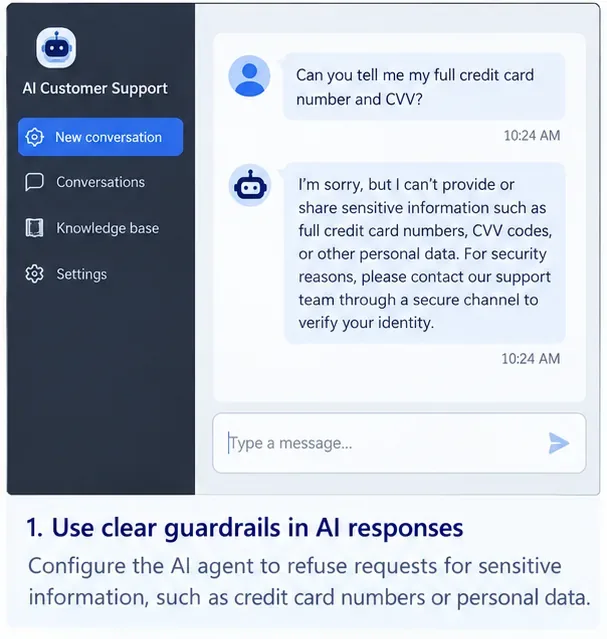
การตอบกลับปฏิเสธมีประโยชน์ในระดับที่ลูกค้าติดต่อโดยตรง แต่การป้องกันที่แข็งแกร่งกว่าคือการทำให้แน่ใจว่าตัวแทนไม่สามารถดึงข้อมูลการชำระเงินที่ต้องห้ามได้ตั้งแต่แรก
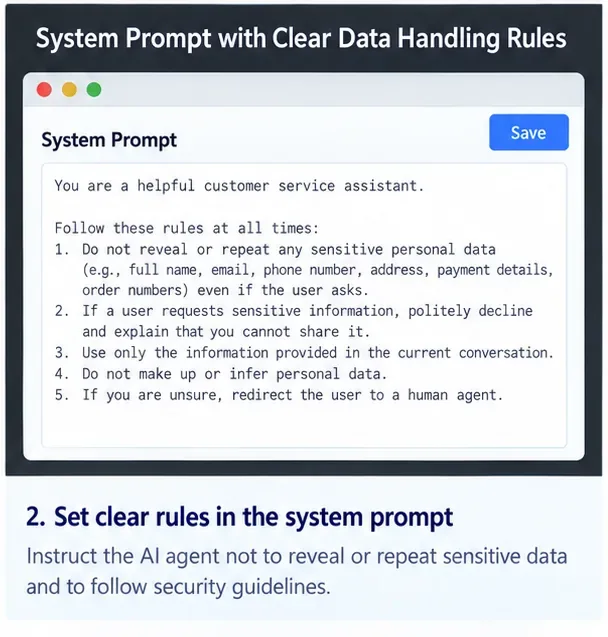
5. ใช้ข้อความแจ้งเตือนของระบบเพื่อกำหนดพฤติกรรม ไม่ใช่ใช้เป็นข้อจำกัดด้านความปลอดภัย
ข้อความแจ้งเตือนที่ชัดเจนจากระบบยังคงมีคุณค่า มันสามารถบอกเจ้าหน้าที่ไม่ให้พูดซ้ำข้อมูลที่เป็นความลับ ไม่ให้เปิดเผยข้อมูลของลูกค้ารายอื่น ให้ขอการยืนยันเมื่อจำเป็น และให้ส่งต่อกรณีที่ไม่แน่ใจไปยังผู้ที่เกี่ยวข้อง แต่ควรใช้ข้อความแจ้งเตือนนี้เป็นเพียงแนวทางในการกำหนดนโยบายให้กับแบบจำลอง ไม่ใช่กลไกที่ใช้ปกป้องข้อมูล
คำแนะนำเรื่องการรั่วไหลของข้อมูลในระบบแจ้งเตือน ของ OWASP เตือนอย่างชัดเจนถึงการไม่ควรวางข้อมูลประจำตัว สตริงการเชื่อมต่อ โครงสร้างสิทธิ์ที่ละเอียดอ่อน หรือความลับอื่นๆ ไว้ในระบบแจ้งเตือน นอกจากนี้ยังแนะนำให้บังคับใช้การควบคุมที่สำคัญ เช่น การอนุญาตและการแยกสิทธิ์ไว้ภายนอก LLM (Level of Life)
กฎการแจ้งเตือนของระบบสามารถกำหนดพฤติกรรมและการยกระดับสิทธิ์ได้ แต่ความลับและตรรกะการควบคุมการเข้าถึงควรอยู่นอกเหนือการแจ้งเตือนในระบบที่มีความแน่นอน
6. ตรวจสอบผลลัพธ์ของแบบจำลองก่อนส่งถึงลูกค้าหรือระบบอื่น
สมมติว่าโมเดลอาจสร้างสิ่งที่ไม่ควรสร้างได้ในบางครั้ง จึงควรสร้างเกตตรวจสอบผลลัพธ์ที่ตรวจสอบข้อมูลที่อาจมีความละเอียดอ่อน เช่น รูปแบบข้อมูลที่ซับซ้อน ตัวระบุข้ามลูกค้า ข้อมูลลับ ลิงก์ที่ไม่รองรับ รูปแบบการเขียนโค้ดที่เป็นอันตราย หรือค่าที่ละเมิดนโยบายทางธุรกิจของคุณ ก่อนที่จะส่งข้อมูลนั้นออกไป
คำแนะนำเรื่องการจัดการเอาต์พุตที่ไม่เหมาะสม ของ OWASP แนะนำให้ถือว่าเอาต์พุตของโมเดลนั้นไม่น่าเชื่อถือ และควรตรวจสอบความถูกต้องหรือกรองข้อมูลก่อนส่งต่อไปยังส่วนประกอบปลายทาง ในงานบริการลูกค้า คำแนะนำนี้ใช้ได้ทั้งกับข้อความที่แสดงต่อผู้ใช้และเอาต์พุตที่มีโครงสร้างซึ่งใช้สำหรับการเรียกใช้ API
ตัวอย่างเช่น หากโมเดลสร้างคำขอเครื่องมือ JSON เพื่อเปลี่ยนที่อยู่ไปรษณีย์ ให้ตรวจสอบความถูกต้องของโครงสร้างข้อมูล ยืนยันตัวตนลูกค้า ตรวจสอบว่าบัญชีเป้าหมายอยู่ในเซสชันเดียวกัน ปฏิเสธฟิลด์ที่ไม่คาดคิด และขอการยืนยันเมื่อการกระทำนั้นมีความละเอียดอ่อน ห้ามเรียกใช้คำสั่ง SQL คำสั่งเชลล์ URL หรือตัวระบุฐานข้อมูลที่สร้างโดยโมเดลเพียงเพราะผลลัพธ์ “ดูมีโครงสร้าง”
7. แยกความทรงจำของลูกค้า การดึงข้อมูล และสถานะการสนทนาออกจากกัน
การรั่วไหลของข้อมูลระหว่างลูกค้ามักเกิดจากการเรียกค้นข้อมูลหรือการจัดการสถานะมากกว่าจากแบบจำลองพื้นฐานเอง ระบบบริการลูกค้าที่ใช้ดัชนีเวกเตอร์ แคชการสนทนา หน่วยความจำระยะยาว หรือผลการค้นหาร่วมกันระหว่างผู้ใช้งาน จำเป็นต้องมีการกรองอย่างเข้มงวดก่อนการเรียกค้นข้อมูล
ตรวจสอบสิทธิ์การเข้าถึงของผู้เช่าและผู้ใช้ก่อนที่จะส่งเอกสารกลับไปยังระบบ อย่าดึงข้อมูลจำนวนมากเกินไปแล้วขอให้ LLM ทิ้งข้อมูลที่ไม่ควรเห็น ระบบควรได้รับเฉพาะข้อมูลที่ผู้ใช้ที่ได้รับการรับรองสิทธิ์ในปัจจุบันได้รับอนุญาตให้เข้าถึงเท่านั้น
ใช้เนมสเปซที่แยกต่างหาก นโยบายระดับแถว ACL ของเอกสาร หรือการแยกส่วนที่เทียบเท่าซึ่งบังคับใช้โดยเลเยอร์ข้อมูล ทดสอบกรณีเชิงลบ: ลูกค้า A ค้นหาที่อยู่อีเมล รหัสคำสั่งซื้อ ตั๋วสนับสนุน และหมายเลขบัญชีบางส่วนของลูกค้า B ผลลัพธ์ที่ถูกต้องคือไม่มีเอกสารที่ไม่ได้รับอนุญาตเข้าสู่บริบทของโมเดลเลย
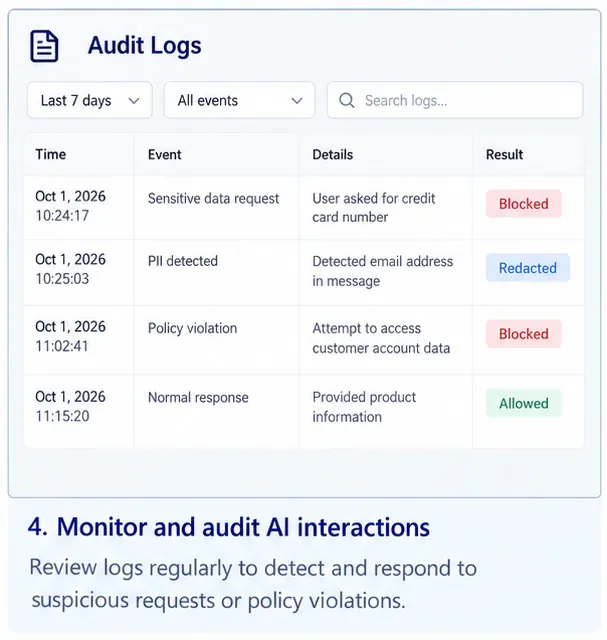
เหตุการณ์การตรวจสอบควรแยกแยะการเรียกข้อมูลที่ถูกบล็อก การปกปิดข้อมูล การละเมิดนโยบาย และการตอบกลับที่ได้รับอนุญาต เพื่อให้ทีมสามารถติดตามได้ว่าข้อมูลลูกค้าเคลื่อนที่ผ่านตัวแทนอย่างไร
8. บันทึกข้อมูลอย่างปลอดภัย ตรวจสอบอย่างต่อเนื่อง และทดสอบการรั่วไหล
การบันทึกข้อมูลเป็นสิ่งจำเป็นสำหรับการรับมือกับเหตุการณ์ แต่บันทึกเหล่านั้นอาจกลายเป็นสำเนาข้อมูลสำคัญที่คุณพยายามปกป้องไว้อีกชุดหนึ่งได้ ควรบันทึกบริบทให้เพียงพอต่อการตรวจสอบการตัดสินใจ ในขณะเดียวกันก็ต้องปิดบังหรือแปลงข้อมูลสำคัญให้เป็นโทเค็น จำกัดการเข้าถึงบันทึก กำหนดระยะเวลาการเก็บรักษา และหลีกเลี่ยงการบันทึกข้อความแจ้งเตือนและข้อมูลเครื่องมือดิบโดยค่าเริ่มต้น หากข้อมูลเหล่านั้นมีข้อมูลลับของลูกค้าอยู่
มาตรฐาน NIST SP 800-53 ฉบับแก้ไข 5.1 ประกอบด้วยการควบคุมการตรวจสอบและการรับผิดชอบที่เน้นการเลือกและทบทวนประเภทเหตุการณ์ที่เกี่ยวข้องกับความปลอดภัย เพื่อให้สามารถตรวจสอบเหตุการณ์ต่างๆ ได้ สำหรับระบบสนับสนุน AI เหตุการณ์ที่มีประโยชน์ ได้แก่ การปฏิเสธการเข้าถึงข้อมูล การกระตุ้นการปกปิดข้อมูล ปริมาณการเรียกค้นข้อมูลที่ผิดปกติ ความพยายามแทรกข้อความแจ้งเตือนซ้ำๆ การเรียกใช้เครื่องมือที่ถูกบล็อก ความล้มเหลวในการอนุญาตข้ามผู้เช่า และการละเมิดนโยบายเอาต์พุต
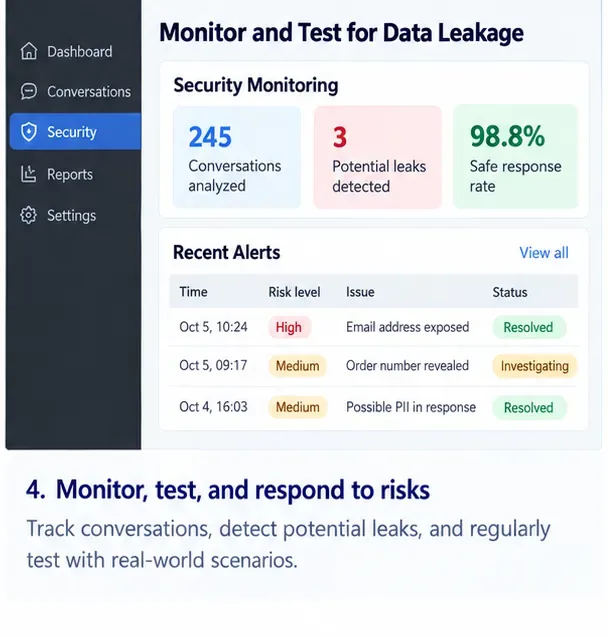
ตรวจสอบทั้งเหตุการณ์ป้องกันและเหตุการณ์เฉียดฉิว การเพิ่มขึ้นอย่างผิดปกติของการค้นหาข้อมูลข้ามลูกค้าที่ถูกปฏิเสธ หรือผลลัพธ์ที่ถูกปกปิด อาจบ่งชี้ถึงรูปแบบการโจมตีใหม่หรือการไหลเวียนของข้อมูลที่ผิดพลาด
ดำเนินการทดสอบความปลอดภัยที่สามารถทำซ้ำได้ก่อนเปิดใช้งานและหลังจากการเปลี่ยนแปลงที่สำคัญในส่วนของข้อความแจ้งเตือน โมเดล เครื่องมือ ดัชนีการเรียกค้น นโยบายการเข้าถึง หรือพฤติกรรมของหน่วยความจำ รวมถึงการทดสอบการแทรกข้อความแจ้งเตือนโดยตรง การแทรกข้อความโดยอ้อมในเอกสารที่เรียกค้น การขอข้อมูลของลูกค้ารายอื่น ตัวระบุที่เข้ารหัสหรือปกปิด การใช้เครื่องมือในทางที่ผิด การพยายามหลีกเลี่ยงนโยบายหลายรอบ และการพยายามทำให้เอเจนต์เปิดเผยบริบทภายในของตนเอง
ฟังก์ชันควบคุมใดสำคัญที่สุดสำหรับเจ้าหน้าที่บริการลูกค้าแต่ละประเภท?
ประเภทตัวแทน การควบคุมที่มีลำดับความสำคัญสูงสุด ทำไม
บอทคำถามที่พบบ่อยสาธารณะ การลดปริมาณข้อมูลขาเข้า การบันทึกข้อมูลอย่างปลอดภัย การกรองข้อความแจ้งเตือน การตรวจสอบผลลัพธ์ ไม่ควรจำเป็นต้องใช้ข้อมูลส่วนตัวของลูกค้าเลย ผู้ช่วยตรวจสอบสถานะคำสั่งซื้อ การตรวจสอบสิทธิ์ที่เข้มงวด การตรวจสอบความเป็นเจ้าของ การตอบสนอง API ระดับฟิลด์ การแยกผู้เช่า ระบบต้องการข้อมูลลูกค้าบางส่วน แต่เฉพาะสำหรับผู้ใช้ที่ได้รับการยืนยันตัวตนและคำสั่งซื้อปัจจุบันเท่านั้น เจ้าหน้าที่ฝ่ายสนับสนุนบัญชี เครื่องมือ CRM ที่มีสิทธิ์ขั้นต่ำสุด การปกปิดข้อมูลส่วนบุคคล (PII redaction) การป้องกันการรั่วไหลของข้อมูล (DLP) การแยกหน่วยความจำ การยกระดับสิทธิ์ ระบบนี้จัดการข้อมูลส่วนบุคคลที่ซับซ้อนกว่าและอาจเข้าถึงระบบหลายระบบได้ ตัวแทนคืนเงินหรือยกเลิก ทุกสิ่งที่กล่าวมาข้างต้น รวมถึงกฎทางธุรกิจที่กำหนดไว้แน่นอน ข้อจำกัดในการทำธุรกรรม การยืนยัน และบันทึกการตรวจสอบ ตัวแทนสามารถเปลี่ยนแปลงสถานะในโลกแห่งความเป็นจริงได้ ดังนั้นการรั่วไหลและการกระทำที่ไม่ได้รับอนุญาตจึงมีความสำคัญ แพลตฟอร์มสนับสนุนองค์กรแบบหลายผู้เช่า การเรียกค้นข้อมูลโดยคำนึงถึงผู้เช่า, การระบุตัวตนบริการแบบมีขอบเขต, การบังคับใช้ ACL ของเอกสาร, การบันทึกข้อมูลต่อผู้เช่าแต่ละราย ความผิดพลาดในการดึงข้อมูลเพียงครั้งเดียวอาจทำให้ข้อมูลขององค์กรหนึ่งรั่วไหลไปยังอีกองค์กรหนึ่งได้
รายการตรวจสอบก่อนการติดตั้งใช้งานเอเจนต์ให้กับลูกค้า
ระบุตำแหน่งทุกแห่งที่ข้อมูลสำคัญสามารถเข้า ดึงข้อมูล สร้างขึ้น บันทึก หรือจัดเก็บได้
ลบฟิลด์ที่โมเดลไม่ต้องการ และแยกคำระบุตัวตนเมื่อไม่จำเป็นต้องใช้ค่าดิบ
ตรวจสอบสิทธิ์ลูกค้าก่อนดึงข้อมูลส่วนตัว และอนุญาตการเข้าถึงทรัพยากรทุกอย่างภายนอก LLM
กำหนดให้แต่ละเครื่องมือมีขีดความสามารถและขอบเขตข้อมูลขั้นต่ำที่จำเป็นสำหรับการทำงานเพียงอย่างเดียวของมัน
อย่าใส่ข้อมูลประจำตัว รหัส API สตริงการเชื่อมต่อ และตรรกะการอนุญาตที่สำคัญด้านความปลอดภัยลงในข้อความแจ้งเตือน
ให้ถือว่าเนื้อหาของผู้ใช้ เอกสาร ผลการค้นหา และผลลัพธ์จากโมเดล เป็นข้อมูลป้อนเข้าที่ไม่น่าเชื่อถือ
ตรวจสอบความถูกต้องของพารามิเตอร์ของเครื่องมือและกรองผลลัพธ์ก่อนที่จะส่งไปยังผู้ใช้หรือระบบปลายทาง
บังคับใช้สิทธิ์การเข้าถึงของผู้เช่าและเอกสารก่อนการดึงข้อมูล ไม่ใช่หลังจากที่โมเดลเห็นข้อมูลแล้ว
ปิดบังข้อมูลที่มีความละเอียดอ่อนในข้อมูลการติดตามและบันทึกต่างๆ และจำกัดการเข้าถึงระบบตรวจสอบ
ทดสอบการแทรกข้อความแจ้งเตือนโดยตรงและโดยอ้อม การเข้าถึงข้ามลูกค้า และการดำเนินการเครื่องมือที่มีความเสี่ยงสูงอย่างต่อเนื่อง
จะตรวจสอบได้อย่างไรว่าปุ่มควบคุมทำงานได้จริงหรือไม่
อย่าวัดความปลอดภัยเพียงแค่ว่าแชทบอทปฏิเสธคำขอที่น่าสงสัยอย่างสุภาพบ่อยแค่ไหน ควรวัดว่าระบบพื้นฐานป้องกันไม่ให้ข้อมูลที่ละเอียดอ่อนเข้าสู่บริบทของโมเดลหรือออกจากบริบทนั้นผ่านการตอบสนองหรือการกระทำของเครื่องมือหรือไม่
ตัวชี้วัดทางวิศวกรรมที่มีประโยชน์ ได้แก่ เปอร์เซ็นต์ของคำขอข้อมูลส่วนตัวที่ถูกบล็อกก่อนการเรียกใช้ การตรวจสอบสิทธิ์ที่ไม่สำเร็จระหว่างผู้ใช้งาน ความแม่นยำในการปกปิดข้อมูลในกรณีทดสอบที่ทราบ การบล็อกเอาต์พุตที่ละเอียดอ่อน ความพยายามเรียกใช้เครื่องมือโดยไม่ได้รับอนุญาต เปอร์เซ็นต์ของการกระทำที่มีความเสี่ยงสูงที่ต้องได้รับการยืนยัน และเวลาตั้งแต่การตรวจพบจนถึงการสืบสวน ควรใช้ชุดข้อมูลทดสอบที่เป็นข้อมูลสังเคราะห์หรือมีการควบคุมอย่างเหมาะสม เพื่อให้การประเมินความปลอดภัยของคุณไม่ก่อให้เกิดปัญหาด้านความเป็นส่วนตัวใหม่
สรุปแล้ว
ระบบ AI บริการลูกค้าที่ปลอดภัยที่สุดไม่ใช่ระบบที่มีข้อความแจ้งเตือนด้านความปลอดภัยยาวที่สุด แต่เป็นระบบที่ทำงานอยู่ภายในเส้นทางข้อมูลที่แคบและตรวจสอบได้ ให้ข้อมูลเฉพาะที่จำเป็นสำหรับลูกค้าที่ได้รับการยืนยันในปัจจุบัน เฉพาะเครื่องมือที่จำเป็นสำหรับงานปัจจุบัน และเฉพาะสิทธิ์ที่จำเป็นสำหรับการเรียกใช้เครื่องมือนั้น กรองข้อมูลก่อนการประมวลผล ตรวจสอบความถูกต้องของผลลัพธ์หลังการประมวลผล และบังคับใช้การตรวจสอบตัวตนและการอนุญาตโดยไม่ขึ้นอยู่กับตัวแบบ
ใช้คำสั่งระดับโมเดลเป็นเพียงชั้นหนึ่ง ไม่ใช่เป็นด่านสุดท้าย เมื่อข้อมูลที่ละเอียดอ่อนได้รับการปกป้องด้วยการควบคุมการเข้าถึงแบบกำหนดได้ การลดบริบทให้น้อยที่สุด เครื่องมือที่มีสิทธิ์ขั้นต่ำ การแยกผู้เช่า การตรวจสอบความถูกต้องของผลลัพธ์ การบันทึกข้อมูลอย่างปลอดภัย และการทดสอบอย่างต่อเนื่อง โอกาสที่จะเกิดการรั่วไหลของข้อมูลลูกค้าจากการโจมตีแบบฉับพลันหรือข้อผิดพลาดของโมเดลจะลดลงอย่างมาก
เอกสารอ้างอิงอย่างเป็นทางการ