ข้อผิดพลาด “API Timeout Error” ในเวิร์กโฟลว์ที่มีเอเจนต์หลายตัว มักไม่สามารถแก้ไขได้ด้วยการเปลี่ยนตัวเลขเพียงตัวเดียว ตัววางแผนอาจเรียกใช้เอเจนต์สามตัว แต่ละตัวอาจเรียกใช้ LLM, บริการค้นหา, ฐานข้อมูล หรือ API ของเครื่องมือ และแต่ละเลเยอร์อาจมีเวลาหมดอายุ นโยบายการลองใหม่ กลุ่มการเชื่อมต่อ และขีดจำกัดการทำงานพร้อมกันเป็นของตัวเอง วิธีแก้ไขที่ได้ผลคือการระบุว่าเลเยอร์ใดหมดเวลาก่อน จากนั้นเลือกวิธีแก้ไขระหว่างการรอที่นานขึ้น การเรียกใช้พร้อมกันน้อยลง การลองใหม่ที่ชาญฉลาดขึ้น เส้นทางวิกฤตที่สั้นลง หรือการออกแบบงานแบบอะซิงโครนัส
ข้อแลกเปลี่ยนมีความสำคัญ: การเพิ่มเวลาหมดอายุทำได้ง่าย แต่จะทำให้ใช้ทรัพยากรนานขึ้น การลองใหม่บ่อยครั้งอาจเพิ่มภาระและค่าใช้จ่าย การลดจำนวนการทำงานพร้อมกันจะช่วยเพิ่มเสถียรภาพ แต่ลดปริมาณงานสูงสุด เอเจนต์แบบขนานจะช่วยลดความหน่วงของเวลาจริงได้ก็ต่อเมื่อบริการปลายทางสามารถรองรับการกระจายการทำงานได้ ไม่มีค่าการตั้งค่าใดที่ดีที่สุดสำหรับระบบหลายเอเจนต์ทุกระบบ
คุณกำลังใช้ฟังก์ชันหมดเวลาตัวไหนกันแน่?
เริ่มต้นด้วยการจำแนกประเภทของความล้มเหลวแทนที่จะมองว่าการหมดเวลาทุกครั้งเป็นเหตุการณ์เดียวกัน ไคลเอนต์ HTTP อาจหมดเวลาขณะเชื่อมต่อ อ่าน เขียน หรือรอการเชื่อมต่อจากพูล ตัวอย่างเช่น HTTPX ระบุประเภทการหมดเวลาแยกกันสี่ประเภท ได้แก่ การเชื่อมต่อ การอ่าน การเขียน และพูล พฤติกรรมเริ่มต้นคือการหมดเวลาหลังจากไม่มีการใช้งานเครือข่ายเป็นเวลาห้าวินาที ไม่จำเป็นต้องเป็นเวลาห้าวินาทีของระยะเวลาการร้องขอทั้งหมด ดู เอกสารอย่างเป็นทางการเกี่ยวกับการหมดเวลา ของHTTPX
หากคุณใช้ OpenAI Python SDK เอกสาร README อย่างเป็นทางการในปัจจุบันระบุว่า การร้องขอจะมีการหมดเวลาฝั่งไคลเอ็นต์โดยค่าเริ่มต้นที่ 10 นาที และหากเกิดความล้มเหลวเนื่องจากหมดเวลา ระบบจะลองเชื่อมต่อใหม่สองครั้งโดยค่าเริ่มต้น SDK ยังลองเชื่อมต่อใหม่โดยอัตโนมัติสำหรับข้อผิดพลาดในการเชื่อมต่อ รวมถึงการตอบสนอง HTTP 408, 409, 429 และ 5xx ด้วยการหน่วงเวลาแบบเลขชี้กำลังสั้นๆ นี่คือค่าเริ่มต้นของ SDK ไม่ใช่การรับประกันว่าพร็อกซี โหลดบาลานเซอร์ เกตเวย์ หรือออร์เชสเตรเตอร์ทุกตัวที่อยู่หน้าการร้องขอจะรอ 10 นาที โปรดดู เอกสาร README อย่างเป็นทางการของ OpenAI Python SDK
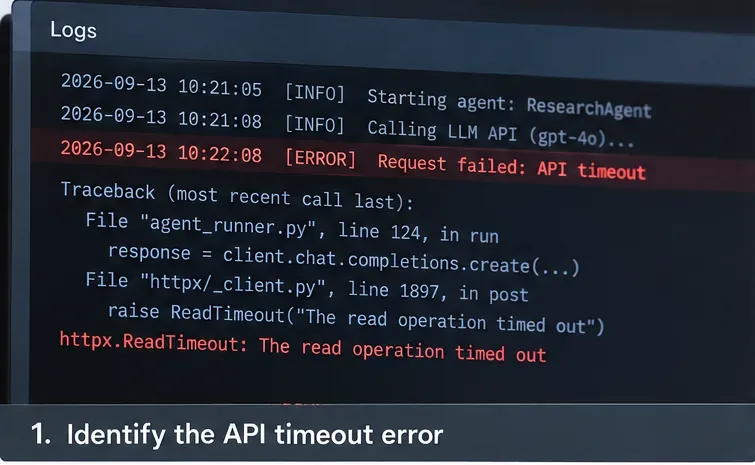 ขั้นตอนที่ 1: บันทึกข้อผิดพลาดที่เกิดขึ้นอย่างแม่นยำ รวมถึงเอเจนต์ ปลายทาง และเลเยอร์การขนส่งที่หมดเวลา แทนที่จะบันทึกเพียงความล้มเหลวของเวิร์กโฟลว์ทั่วไป
คุณควรเลือกวิธีแก้ไขแบบใด?
| ตัวเลือก |
เหมาะสมที่สุด |
ประโยชน์หลัก |
การแลกเปลี่ยนหลัก |
| เพิ่มระยะเวลาหมดเวลาการร้องขอ |
การเรียกใช้โมเดล/เครื่องมือที่มีสุขภาพดีแต่ช้าอย่างแท้จริง |
การเปลี่ยนแปลงโค้ดและสถาปัตยกรรมน้อยที่สุด |
พนักงานและการเชื่อมต่อยังคงถูกใช้งานนานขึ้น เกตเวย์ต้นทางอาจยังคงยุติคำขอเป็นอันดับแรก |
| ลองใหม่โดยใช้การหน่วงเวลาแบบทวีคูณ |
ข้อผิดพลาดเครือข่ายชั่วคราว, ข้อจำกัดอัตรา, ความล้มเหลว 5xx ที่เลือกไว้ |
สามารถกู้คืนระบบได้โดยอัตโนมัติจากความล้มเหลวชั่วคราว |
อาจทำให้ปริมาณการรับส่งข้อมูล ความหน่วง และต้นทุนเพิ่มขึ้นหลายเท่า ไม่ปลอดภัยสำหรับการกระทำที่ไม่สามารถทำซ้ำได้เว้นแต่จะออกแบบอย่างระมัดระวัง |
| ลดจำนวนเอเจนต์ที่ทำงานพร้อมกัน |
429 วินาที, หมดเวลาของพูล, ความอิ่มตัวของปลายทาง |
ลดปัญหาการกระชากของกระแสไฟและการแย่งชิงคิว |
อัตราการประมวลผลสูงสุดต่ำกว่า และบางครั้งอาจใช้เวลานานกว่าในการดำเนินการให้แล้วเสร็จ |
| ดำเนินการขนานตัวแทนอิสระ |
เวิร์กโฟลว์แบบเรียงลำดับที่มีสาขาอิสระ |
ช่วยลดระยะทางวิกฤต |
เพิ่มจำนวนคำขอพร้อมกันและอาจทำให้เกิดข้อจำกัดด้านอัตราหรือจำนวนการเชื่อมต่อ |
| สตรีมเอาต์พุตบางส่วน |
ประสบการณ์ผู้ใช้แบบโต้ตอบที่ความหน่วงแฝงในไบต์แรกมีความสำคัญ |
ผู้ใช้จะเห็นความคืบหน้าได้เร็วขึ้น |
ไม่สามารถแก้ไขปัญหาการหมดเวลาการเชื่อมต่ออย่างรุนแรงหรือบริการปลายทางที่โอเวอร์โหลดได้โดยอัตโนมัติ |
| ย้ายงานไปยังงาน/คิวแบบอะซิงโครนัส |
ขั้นตอนการทำงานที่อาจใช้เวลาหลายสิบวินาทีหรือหลายนาที |
แยกอายุการใช้งานของคำขอ HTTP ออกจากอายุการใช้งานของเวิร์กโฟลว์ |
จำเป็นต้องมีสถานะงาน การตรวจสอบสถานะ/เว็บฮุค การทำงานซ้ำได้ การคงอยู่ของข้อมูล และการตรวจสอบการทำงาน |
ขั้นตอนที่ 1: ค้นหาเลเยอร์แรกที่เกินกำหนดเวลา
บันทึกรหัสความสัมพันธ์สำหรับเวิร์กโฟลว์ทั้งหมด และรหัสช่วงหรือรหัสย่อยสำหรับแต่ละตัวแทนและการเรียกใช้เครื่องมือ บันทึกเวลาเริ่มต้น เวลาสิ้นสุด ปลายทาง จำนวนครั้งที่พยายาม ประเภทข้อยกเว้น สถานะการตอบสนอง (ถ้ามี) และระบุว่าการยกเลิกมาจากผู้โทรหรือบริการปลายทาง
คำถามสำคัญคือ “ใครหยุดรอคนแรก?” หากการเรียกใช้ LLM เสร็จสิ้นใน 42 วินาที แต่เกตเวย์ API ยอมแพ้ที่ 30 วินาที การเพิ่มเวลาหมดอายุของไคลเอ็นต์ LLM จาก 60 เป็น 120 วินาทีจะไม่เปลี่ยนแปลงอะไร เอกสารปัจจุบันของ Amazon สำหรับ API Gateway HTTP API ระบุเวลาหมดอายุการรวมสูงสุดที่ 30 วินาที ซึ่งเป็นตัวอย่างที่ดีว่าทำไมกำหนดเวลาที่สั้นที่สุดในห่วงโซ่มักจะเป็นตัวกำหนดผลลัพธ์ ดูโควต้า Amazon API Gateway HTTP API
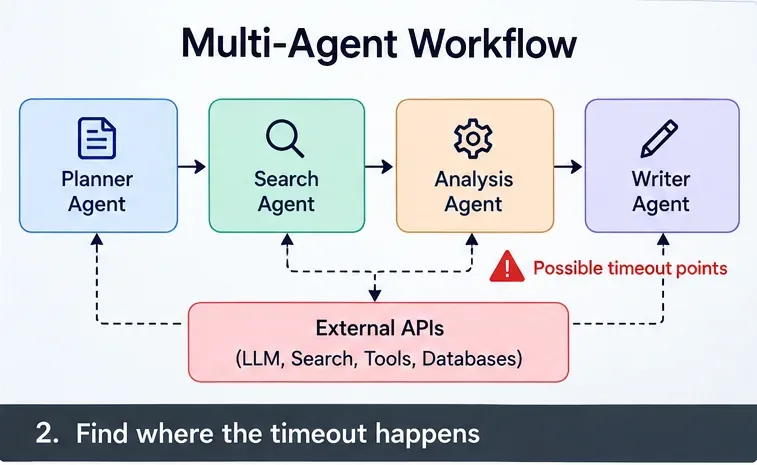 ขั้นตอนที่ 2: จัดทำแผนผังเส้นทางการร้องขอและทำเครื่องหมายทุกจุดที่สามารถยุติหรือหน่วงเวลาการเรียกได้ ได้แก่ ตัวจัดการกระบวนการ (orchestrator), เอเจนต์ (agent), เกตเวย์ (gateway), API โมเดล (model API), API ค้นหา (search API), ฐานข้อมูล (database) และบริการเครื่องมือ (tool service)
ขั้นตอนที่ 2: วัดเส้นทางวิกฤต ไม่ใช่แค่ค่าความหน่วงเฉลี่ย
ค่าความหน่วงเฉลี่ยอาจดูเหมือนปกติ แต่การเรียกใช้งานที่ช้าเพียงเล็กน้อยอาจเป็นสาเหตุหลักของความล้มเหลวในขั้นตอนการทำงาน ควรติดตามอัตราความสำเร็จอย่างน้อยในแต่ละการพึ่งพา รวมถึงค่าความหน่วง p50, p95 และ p99 ด้วย ในขั้นตอนการกระจายข้อมูล ควรบันทึกเวลารอคิวและเวลารอการเชื่อมต่อด้วย เพราะ "API ที่ช้า" อาจเป็นเพราะไคลเอนต์ทำงานหนักเกินไปและกำลังรอการเชื่อมต่อที่ว่างอยู่
ใช้ข้อมูลการติดตามเพื่อตอบคำถามเชิงปฏิบัติสามข้อ ได้แก่ ความสัมพันธ์ใดมีอิทธิพลเหนือเส้นทางวิกฤต ตัวแทนที่ทำงานช้าหลายตัวทำงานตามลำดับเมื่อสามารถทำงานพร้อมกันได้หรือไม่ และการทำงานพร้อมกันที่พุ่งสูงขึ้นสอดคล้องกับข้อผิดพลาด 429, pool-timeout หรือ 5xx หรือไม่
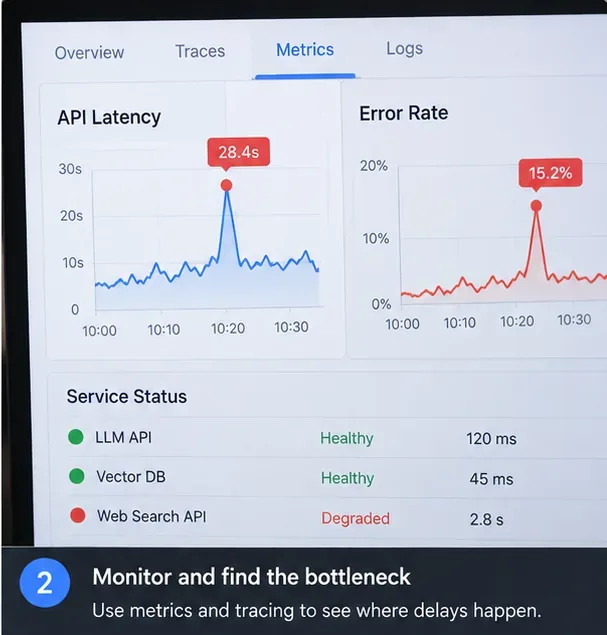 ขั้นตอนที่ 3: เปรียบเทียบค่าความหน่วงแฝง ข้อผิดพลาด และสถานะของส่วนประกอบต่างๆ เข้าด้วยกัน หากพบว่าค่าความหน่วงแฝงเพิ่มขึ้นอย่างผิดปกติพร้อมกับส่วนประกอบใดส่วนประกอบหนึ่งทำงานผิดปกติ แสดงว่าวิธีการแก้ไขควรแตกต่างจากกรณีที่พบปัญหาการทำงานพร้อมกันเพิ่มขึ้นอย่างผิดปกติทั่วทั้งระบบ
ขั้นตอนที่ 3: สร้างงบประมาณเวลาหมดจากภายนอกสู่ภายใน
กำหนดเส้นตายสำหรับเวิร์กโฟลว์แบบครบวงจรตั้งแต่ต้นจนจบก่อน จากนั้นกำหนดเส้นตายย่อยให้สั้นลง เพื่อให้เลเยอร์ล่างล้มเหลวเร็วพอที่ตัวจัดการกระบวนการจะกู้คืนได้ ตัวอย่างเช่น เส้นตายสำหรับผู้ใช้ที่ 120 วินาที อาจสงวนเวลา 10 วินาทีสำหรับการจัดการกระบวนการและการตอบสนอง เหลือเวลา 110 วินาทีสำหรับงานที่มีประโยชน์ การเรียกใช้เครื่องมือแต่ละรายการอาจได้รับเวลา 15 วินาที ในขณะที่การเรียกใช้โมเดลอาจได้รับเวลา 45 หรือ 60 วินาที ขึ้นอยู่กับความหน่วงที่สังเกตได้
อย่าคัดลอกค่าเหล่านั้นโดยไม่คิดไตร่ตรอง เพราะเป็นเพียงตัวอย่างวิธีการจัดทำงบประมาณ ไม่ใช่ค่าเริ่มต้นสากล เลือกค่าจากผลการวัดการกระจายความหน่วงและ SLO ของผลิตภัณฑ์ของคุณ กำหนดเวลาสุดท้ายภายนอกควรนานพอที่จะครอบคลุมการเรียกใช้ภายใน การลองใหม่ที่อนุญาต การหน่วงเวลาการรอ และเวลาในการทำความสะอาด
Python 3.11 และเวอร์ชันที่ใหม่กว่า มีฟังก์ชันasyncio.timeout()สำหรับกำหนดเส้นตายให้กับงานแบบอะซิงโครนัส เมื่อเส้นตายหมดลง งานจะถูกยกเลิก และตัวจัดการบริบทจะแสดงข้อความ แจ้งเตือน โปรดTimeoutErrorตรวจสอบเอกสารอย่างเป็นทางการเกี่ยวกับฟังก์ชันหมดเวลาของ asyncio ใน Python
import asyncio

async def run_stage():
    try:
        async with asyncio.timeout(90):
            return await run_agents()
    except TimeoutError:
        return {"status": "partial", "reason": "stage_timeout"}
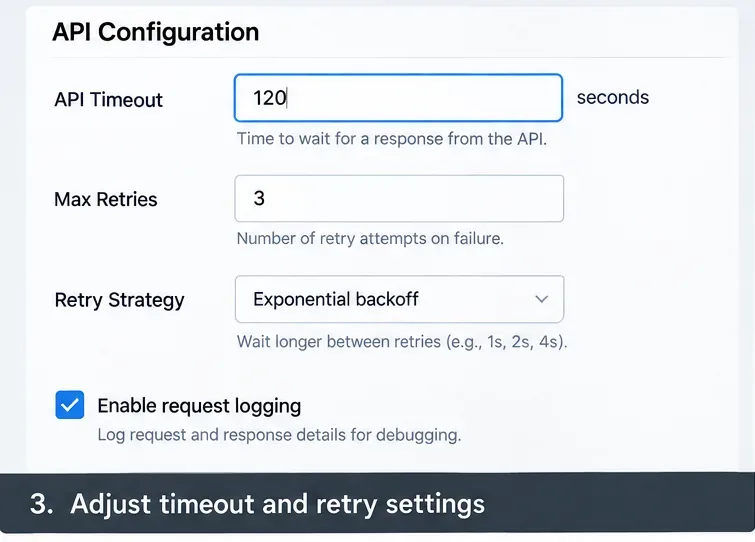 ขั้นตอนที่ 4: กำหนดค่าการหมดเวลาและการลองใหม่โดยใช้การจัดสรรงบประมาณแบบประสานงาน แทนที่จะเพิ่มค่าแต่ละค่าแยกกัน
ขั้นตอนที่ 4: จำกัดจำนวนการทำงานพร้อมกันก่อนที่จะเพิ่มจำนวนการลองใหม่
ระบบที่มีเอเจนต์หลายตัวมักล้มเหลวเนื่องจากการกระจายตัว (fan-out) เติบโตเร็วกว่าที่คาดไว้ หากคำขอของผู้ใช้ 20 รายแต่ละครั้งเรียกใช้เอเจนต์ 5 ตัว และเอเจนต์แต่ละตัวเรียกใช้เครื่องมือ 2 ตัว ระบบอาจสร้างการเรียกใช้ปลายทางได้มากถึง 200 ครั้งก่อนที่จะมีการลองใหม่ การเพิ่มการลองใหม่ก่อนอาจทำให้ความแออัดกลายเป็นพายุการลองใหม่ได้
การใช้ตัวจำกัดการทำงานพร้อมกันมักเป็นมาตรการแรกที่ดีกว่าเมื่อคุณพบปัญหาการตอบสนอง 429, การหมดเวลาของพูล, เวลาคิวที่เพิ่มขึ้น หรือการพึ่งพาปลายทางที่เต็มประสิทธิภาพ Python asyncio.Semaphoreมีวิธีการนับจำนวนแบบง่ายๆ เพื่อจำกัดจำนวนโครูทีนที่เข้าสู่ส่วนที่ได้รับการป้องกันในคราวเดียว ดู เอกสารอย่างเป็นทางการเกี่ยวกับเซมาฟอ ร์ของ Python
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
การแลกเปลี่ยนนี้เป็นสิ่งที่ตั้งใจไว้: การกำหนดขีดจำกัดที่ต่ำกว่าจะช่วยปกป้องบริการปลายทาง แต่ก็อาจทำให้เกิดคิวมากขึ้นภายในแอปพลิเคชันของคุณ ปรับค่าให้เหมาะสมกับปริมาณงาน ความหน่วง p95 ขีดจำกัดอัตรา และความจุของกลุ่มการเชื่อมต่อ แทนที่จะเลือกตัวเลขที่มากที่สุดที่เครื่องของคุณสามารถกำหนดตารางได้
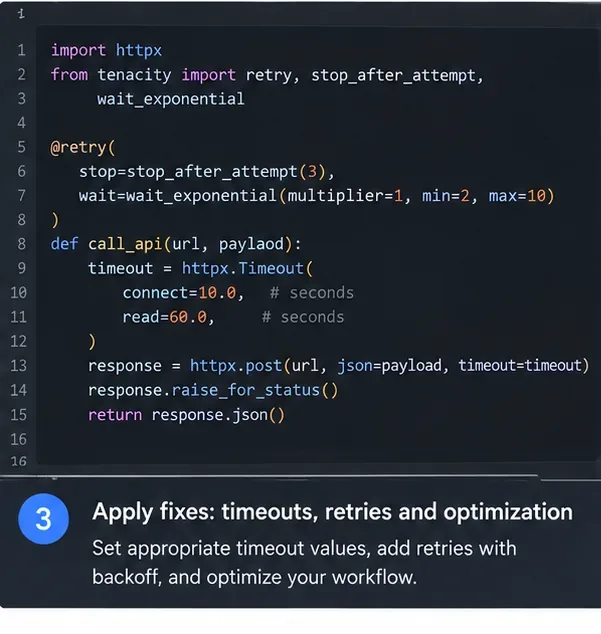 ขั้นตอนที่ 5: จับคู่การทำงานพร้อมกันแบบจำกัดกับการตั้งค่าการขนส่งที่ชัดเจน เพื่อไม่ให้พูลการเชื่อมต่อที่เต็มกลายเป็นแบบจำลองหรือเครื่องมือที่ทำงานช้า
ขั้นตอนที่ 5: ลองทำซ้ำเฉพาะความล้มเหลวที่มีแนวโน้มที่จะสำเร็จในภายหลังเท่านั้น
การลองใหม่มีประโยชน์สำหรับการเชื่อมต่อล้มเหลวชั่วคราว ข้อจำกัดด้านอัตราการใช้งาน ข้อผิดพลาดของเซิร์ฟเวอร์ที่เลือก และการหมดเวลาของคำขอ เมื่อการทำซ้ำการดำเนินการนั้นปลอดภัย แต่ไม่ใช่ตัวเลือกเริ่มต้นที่ดีสำหรับข้อผิดพลาดในการตรวจสอบความถูกต้อง การตรวจสอบสิทธิ์ล้มเหลว ข้อบกพร่องของเครื่องมือแบบกำหนดได้ หรือการกระทำที่มีผลข้างเคียงโดยไม่มีการป้องกันการทำงานซ้ำ
ระวังการคูณจำนวนการลองใหม่ หาก SDK ลองใหม่สองครั้ง นั่นหมายความว่าอาจมีการลองมากถึงสามครั้งสำหรับการเรียกใช้เชิงตรรกะหนึ่งครั้ง หากเลเยอร์เอเจนต์ของคุณลองใหม่การเรียกใช้ทั้งหมดสองครั้งเช่นกัน จำนวนการลองสูงสุดตามทฤษฎีจะกลายเป็นเก้าครั้งสำหรับการดำเนินการเชิงตรรกะนั้น: การลองภายนอกสามครั้งคูณด้วยการลองของ SDK สามครั้ง หากตัวจัดการกระบวนการลองใหม่ขั้นตอนที่มีเอเจนต์ห้าตัวทั้งหมด ปริมาณคำขออาจเพิ่มขึ้นอย่างรวดเร็ว
รวมศูนย์การจัดการการลองใหม่ทุกครั้งที่ทำได้ สำหรับการเรียกใช้ LLM โดยใช้ OpenAI Python SDK โปรดจำไว้ว่า SDK ปัจจุบันจะลองใหม่สองครั้งโดยอัตโนมัติสำหรับความล้มเหลวบางประเภท เพิ่มการลองใหม่ภายนอกเฉพาะเมื่อคุณมีเหตุผลเฉพาะและสามารถจำกัดงบประมาณการลองทั้งหมดได้ citeturn212133view0turn212133view1
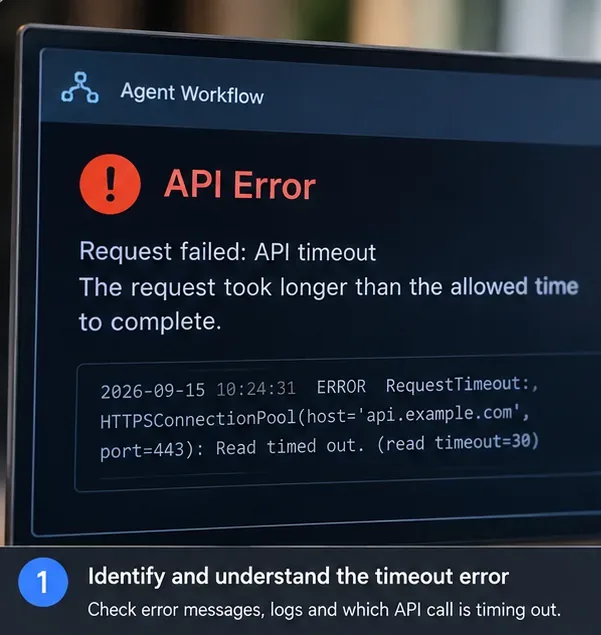 ขั้นตอนที่ 6: จำแนกประเภทข้อผิดพลาดก่อนลองใหม่อีกครั้ง ข้อผิดพลาดเกี่ยวกับการหมดเวลาในการอ่านอาจเป็นเหตุผลที่ควรลองใหม่ภายในระยะเวลาที่กำหนด ในขณะที่ข้อผิดพลาดในการกำหนดค่าถาวรโดยทั่วไปแล้วไม่จำเป็นต้องลองใหม่
ขั้นตอนที่ 6: ลดระยะทางวิกฤตโดยไม่ก่อให้เกิดปัญหาการกระจายตัวของข้อมูล
หากตัวแทนฝ่ายวางแผน ฝ่ายวิจัย ฝ่ายประเมิน และฝ่ายเขียน ทำงานต่อเนื่องกันอย่างเคร่งครัด เวลาแฝงทั้งหมดจะประมาณเท่ากับผลรวมของระยะเวลาของแต่ละฝ่าย อย่างไรก็ตาม บางครั้งสาขาอิสระอาจทำงานพร้อมกันได้ ซึ่งจะลดเวลาแฝงลงโดยอ้างอิงกับสาขาที่ช้าที่สุด แทนที่จะเป็นผลรวมของทุกสาขา
TaskGroup ใน Python asyncio.TaskGroupเป็นวิธีการที่มีโครงสร้างในการเรียกใช้งานงานที่เกี่ยวข้องกันพร้อมกัน เอกสารประกอบของ Python ในปัจจุบันระบุว่า TaskGroup จะรอให้งานในกลุ่มเสร็จสิ้น และจะยกเลิกงานที่เหลือเมื่อมีงานใดงานหนึ่งล้มเหลวด้วยข้อยกเว้นที่ไม่ใช่การยกเลิก ซึ่งให้พฤติกรรมด้านความปลอดภัยที่แข็งแกร่งกว่าการสร้างงานแบบไม่มีโครงสร้าง ดูเอกสารประกอบ TaskGroup อย่างเป็นทางการของ Python
การประมวลผลแบบขนานไม่ใช่เรื่องฟรี หากผู้ให้บริการรายเดียวกันบังคับใช้ข้อจำกัดที่เข้มงวดเกี่ยวกับจำนวนคำขอต่อนาทีหรือจำนวนคำขอพร้อมกัน การเรียกใช้เอเจนต์สี่ตัวพร้อมกันอาจเปลี่ยนเวิร์กโฟลว์ที่ช้าแต่ประสบความสำเร็จให้กลายเป็นการตอบสนองแบบรวดเร็วในหมายเลข 429 ดังนั้น ควรใช้การประมวลผลแบบขนานเฉพาะกับงานที่เป็นอิสระต่อกันอย่างแท้จริง และคงไว้ซึ่งตัวจำกัดการทำงานพร้อมกันโดยรวม
ขั้นตอนที่ 7: คุณควรหยุดใช้คำขอ HTTP แบบซิงโครนัสเมื่อใด?
หากเวิร์กโฟลว์ปกติมักใช้เวลานานกว่าระยะเวลาหมดเวลาการร้องขอที่สั้นที่สุดในเส้นทางเครือข่ายของคุณ การเปลี่ยนไปใช้โมเดลงานแบบอะซิงโครนัสโดยทั่วไปจะสะอาดกว่าการยืดระยะเวลาหมดเวลาของการร้องขอแต่ละครั้งอย่างต่อเนื่อง การร้องขอ HTTP เริ่มต้นสามารถตรวจสอบความถูกต้องของข้อมูลอินพุต สร้างงานที่คงทน และส่งคืนรหัสงานได้ทันที จากนั้นตัวทำงานจะดำเนินการกราฟหลายเอเจนต์นอกวงจรชีวิตของการร้องขอ ในขณะที่ไคลเอนต์จะได้รับความคืบหน้าผ่านการสำรวจ การส่งเหตุการณ์จากเซิร์ฟเวอร์ WebSockets หรือ webhook
การสตรีมมีประโยชน์เมื่อเซิร์ฟเวอร์สามารถเริ่มส่งเอาต์พุตที่มีความหมายได้ตั้งแต่เนิ่นๆ ตัวอย่างเช่น OpenAI Python SDK รองรับการสตรีมเหตุการณ์ที่ส่งจากเซิร์ฟเวอร์สำหรับการเรียกใช้ API การตอบสนอง การสตรีมช่วยปรับปรุงการตอบสนองที่รับรู้ได้และสามารถรักษาการเชื่อมต่อที่ใช้งานอยู่ซึ่งสร้างข้อมูลได้ แต่ไม่ได้แก้ปัญหาอายุการใช้งานสูงสุดของคำขอของพร็อกซีทุกตัวโดยอัตโนมัติ ดูข้อมูลอ้างอิงเหตุการณ์การสตรีมอย่างเป็นทางการของ OpenAI
เลือกใช้การทำงานแบบอะซิงโครนัสเมื่อความทนทานมีความสำคัญมากกว่าความเรียบง่ายในทันที เช่น งานวิจัยที่ใช้เวลานาน เวิร์กโฟลว์ของเอเจนต์ที่ต้องได้รับการอนุมัติจากมนุษย์ การเรียกใช้เครื่องมือจำนวนมาก การดำเนินการที่มีค่าใช้จ่ายสูงที่คุณไม่ต้องการทำซ้ำ หรือเวิร์กโหลดที่ต้องทำงานได้แม้ไคลเอนต์จะตัดการเชื่อมต่อ ค่าใช้จ่ายเพิ่มเติมคือการจัดการสถานะเพิ่มเติม เช่น สถานะของงาน จุดตรวจสอบ คีย์ความไม่เปลี่ยนแปลง การยกเลิก การจัดเก็บผลลัพธ์ และการกำหนดสิทธิ์ในการลองใหม่
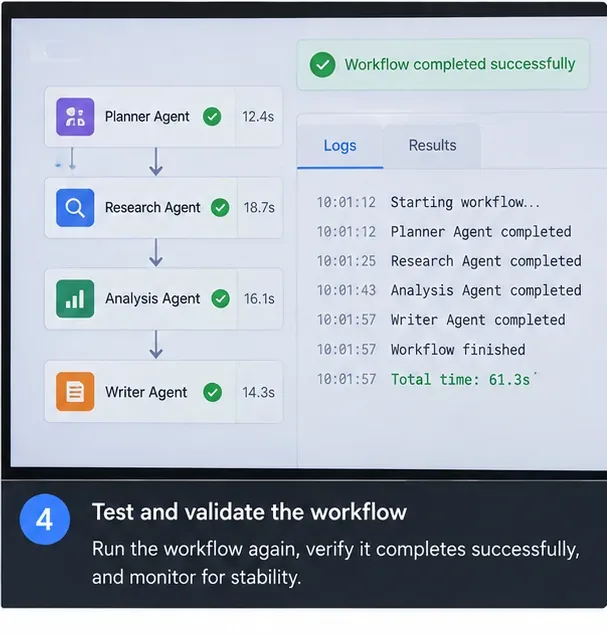 ขั้นตอนที่ 7: สำหรับเวิร์กโฟลว์ที่ใช้เวลานาน ให้ติดตามความสำเร็จของเอเจนต์เป็นสถานะเวิร์กโฟลว์ถาวร แทนที่จะพึ่งพาการเชื่อมต่อไคลเอ็นต์เดียวให้เปิดอยู่จนกว่าเอเจนต์ทุกคนจะทำงานเสร็จสิ้น
ขั้นตอนที่ 8: ตรวจสอบความถูกต้องของการแก้ไขภายใต้ภาระงานที่สมจริง
การแก้ไขปัญหาไม่ได้หมายความว่าการร้องขอหนึ่งครั้งสำเร็จแล้ว ควรทดสอบที่ระดับการทำงานพร้อมกันที่คุณคาดหวังในสภาพแวดล้อมการใช้งานจริง และวัดอัตราความสำเร็จ อัตราการหมดเวลา จำนวนครั้งในการลองใหม่ต่อภารกิจเชิงตรรกะ ความหน่วง p95 และ p99 ความล่าช้าของคิว การรอพูลการเชื่อมต่อ อัตรา 429/5xx ปลายทาง และต้นทุนต่อเวิร์กโฟลว์ที่เสร็จสมบูรณ์
หากคุณใช้งานเอเจนต์ใน Kubernetes ควรใช้ readiness และ liveness ในวัตถุประสงค์ที่แตกต่างกัน Kubernetes ระบุว่า readiness probes เป็นกลไกที่ใช้ตรวจสอบว่า Pod ควรรับทราฟฟิกหรือไม่ ในขณะที่ liveness probes ใช้ตรวจสอบว่าคอนเทนเนอร์ควรเริ่มต้นใหม่เมื่อใด เอกสารของ Kubernetes เตือนไว้อย่างชัดเจนว่าการตรวจสอบ liveness ที่ไม่ได้มาตรฐานอาจทำให้เกิดความล้มเหลวต่อเนื่องภายใต้ภาระงานหนัก โปรดดูเอกสารอย่างเป็นทางการเกี่ยวกับ probe ของ Kubernetes
สำหรับกรณีที่ระบบทำงานหนักเกินไปชั่วคราว การปล่อยให้ระบบ "ไม่พร้อมใช้งาน" มักจะปลอดภัยกว่าการทำให้คนงานที่มีสุขภาพดีแต่กำลังทำงานอย่างหนักเสียชีวิตซ้ำแล้วซ้ำเล่า ควรสงวนการใช้ข้อผิดพลาดด้านความพร้อมใช้งานไว้เฉพาะในกรณีที่การเริ่มต้นกระบวนการใหม่เป็นวิธีการแก้ไขที่ถูกต้องอย่างแท้จริง
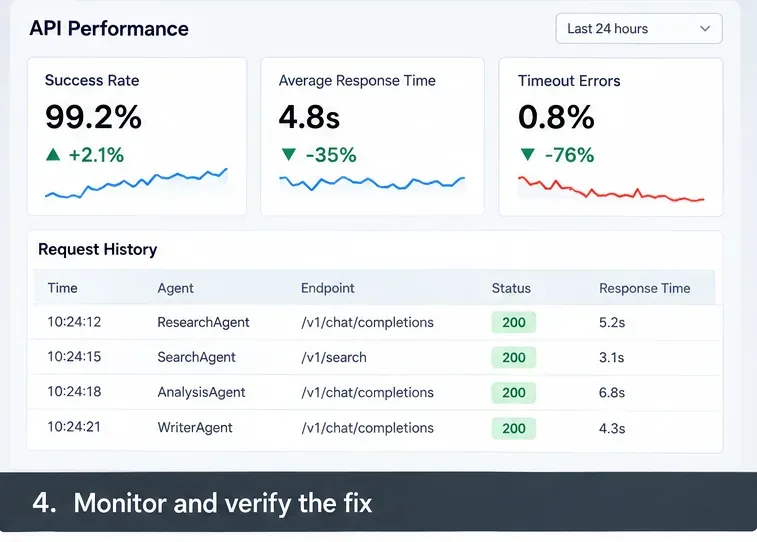 ขั้นตอนที่ 8: ตรวจสอบการเปลี่ยนแปลงด้วยปริมาณการใช้งานที่เหมือนกับการใช้งานจริงและตัวชี้วัดความหน่วงเวลา ไม่ใช่เพียงแค่การทดสอบที่ประสบความสำเร็จเพียงครั้งเดียว
คุณจะระบุได้อย่างไรว่าวิธีแก้ไขใดเหมาะสมกับรูปแบบความล้มเหลวของคุณ?
| รูปแบบที่สังเกตได้ |
การเปลี่ยนแปลงครั้งแรกที่มีประโยชน์ที่สุด |
สิ่งที่ไม่ควรทำเป็นอันดับแรก |
| การโทรเสร็จสิ้นหลังจากกำหนดเวลาของลูกค้าเล็กน้อย ระบบการทำงานปลายทางราบรื่นดี |
เพิ่มระยะเวลาหมดเวลาภายในที่เฉพาะเจาะจง และจัดสรรงบประมาณใหม่สำหรับกำหนดเวลาภายนอก |
เพิ่มจำนวนครั้งในการลองใหม่ |
| ข้อผิดพลาด 429 และการหมดเวลาของพูลจะเพิ่มขึ้นตามจำนวนการทำงานพร้อมกัน |
ลดจำนวนการทำงานพร้อมกันและเพิ่มระบบคิว/การควบคุมแรงดันย้อนกลับ |
เปิดใช้งานเอเจนต์เพิ่มเติมพร้อมกัน |
| อาจเกิดข้อผิดพลาด 408/5xx หรือความล้มเหลวของเครือข่ายเป็นครั้งคราว |
ใช้การลองใหม่แบบจำกัดด้วยเลขชี้กำลังแบบหน่วงเวลาสำหรับการดำเนินการที่ไม่เปลี่ยนแปลงผลลัพธ์เดิม |
ลองทำซ้ำทุกข้อผิดพลาดไปเรื่อยๆ อย่างไม่มีที่สิ้นสุด |
| กระบวนการทำงานมักใช้เวลานานกว่าขีดจำกัดของเกตเวย์ |
ใช้สถาปัตยกรรมงานแบบอะซิงโครนัสหรือการออกแบบสตรีมมิ่งที่รองรับ |
ให้เพิ่มค่าหมดเวลาของ SDK ต่อไปเรื่อยๆ |
| การพึ่งพาที่ช้าอย่างหนึ่งเป็นตัวกำหนดความหน่วงของ p99 |
ปรับปรุงประสิทธิภาพ จัดเก็บในแคช แทนที่ หรือแยกส่วนการพึ่งพาเหล่านั้น พิจารณาทางเลือกสำรอง |
ปรับตั้งค่าหมดเวลาของเอเจนต์ที่ไม่เกี่ยวข้อง |
| ความล้มเหลวจะปรากฏขึ้นหลังจากเพิ่มเอเจนต์คู่ขนานเท่านั้น |
คงไว้ซึ่งการทำงานแบบขนานที่มีประโยชน์ แต่เพิ่มเซมาฟอร์ระดับโลกและข้อจำกัดต่อผู้ให้บริการแต่ละราย |
สมมติว่าการประมวลผลแบบขนานเร็วกว่าเสมอ |
ฐานการผลิตที่เป็นรูปธรรม
สำหรับ API แบบหลายเอเจนต์ทั่วไป แนวทางพื้นฐานที่แข็งแกร่งคือ การกำหนดรหัสความสัมพันธ์ให้กับเวิร์กโฟลว์แต่ละรายการ ติดตามการเรียกใช้เอเจนต์และเครื่องมือทุกรายการ กำหนดเส้นตายแบบครบวงจรหนึ่งรายการ กำหนดเส้นตายที่สั้นกว่าสำหรับการเรียกใช้แต่ละรายการภายในเส้นตายนั้น บังคับใช้ขีดจำกัดการทำงานพร้อมกันทั่วโลกต่อผู้ให้บริการปลายทางแต่ละราย จำกัดจำนวนการลองใหม่และทำให้ผลลัพธ์คงเดิม และจัดเก็บสถานะให้เพียงพอเพื่อดำเนินการต่อหรือรายงานความสำเร็จบางส่วน
จากนั้นปรับแต่งตามผลการวัด หากระบบเสถียรแต่ช้าเกินไป ให้เลือกใช้วิธีขนานการทำงานอิสระบางส่วน หากระบบทำงานได้เร็วในสภาวะโหลดต่ำ แต่ล้มเหลวในสภาวะโหลดสูงสุด ให้ลด fan-out และเพิ่ม backpressure หากเวิร์กโฟลว์ที่สำเร็จใช้เวลานานกว่าที่เส้นทางการร้องขอแบบซิงโครนัสอนุญาต ให้เปลี่ยนสถาปัตยกรรมแทนที่จะพยายามทำให้พร็อกซีทุกตัวรอเป็นเวลานานขึ้น
เอกสารอ้างอิงอย่างเป็นทางการ









