Startseite
» Domänen
»
Schritt-für-Schritt-Anleitung: Automatisierung des wöchentlichen Wettbewerbs-Monitorings mit KI-Agenten
Schritt-für-Schritt-Anleitung: Automatisierung des wöchentlichen Wettbewerbs-Monitorings mit KI-Agenten
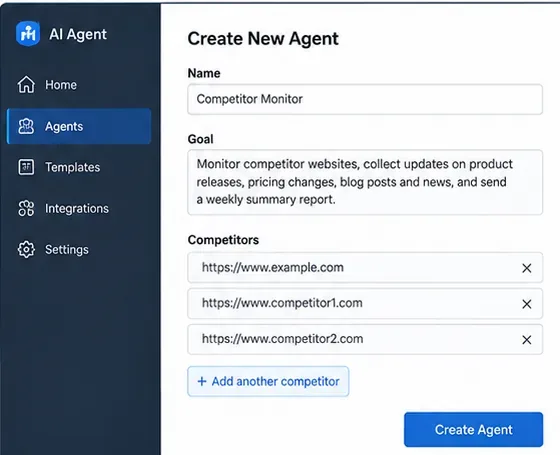
Das Monitoring von Wettbewerbern scheitert oft aus einem einfachen Grund: Die Recherche ist über zu viele Tabs, zu viele Personen und zu viele Definitionen dessen, was als bedeutsame Änderung gilt, verstreut. Eine Person prüft die Preisseiten, eine andere beobachtet die Release Notes, wieder jemand anderes scannt die Branchennews, und bis Freitag hat das Team einen Haufen Links, aber keine zuverlässige Antwort auf die entscheidende Frage: Was hat sich diese Woche geändert, und ist es relevant?
Ein KI-Agent kann diese manuelle Arbeit reduzieren, aber der Agent ist nur ein Teil des Systems. Ein zuverlässiger wöchentlicher Workflow benötigt auch eine Quellenliste, ein Evidenzformat, eine Baseline der Vorwoche, einen Zeitplaner und einen Schritt für die menschliche Überprüfung. Wenn Sie diese Elemente auslassen, können Sie Lärm genauso effizient automatisieren wie Erkenntnisse.
Diese Anleitung baut den Workflow von den einfachsten Entscheidungen bis hin zu den technischeren auf. Die konkrete Implementierung nutzt das aktuelle OpenAI Agents SDK und GitHub Actions, da deren offizielle Dokumentation Websuche, strukturierte Ausgaben, Tracing und geplante Workflows unterstützt. Die Architektur selbst ist anbieterneutral: Sie können jede Komponente ersetzen, wenn eine andere Agent-Laufzeitumgebung oder ein anderer Zeitplaner besser zu Ihrem Stack passt.
Was sollte ein wöchentlicher Wettbewerbs-Monitoring-Agent tatsächlich tun?
Mindestens sollte das System vier Fragen beantworten: Was hat sich geändert, woher stammt die Evidenz, wie unterscheidet sich die Änderung vom zuletzt bekannten Zustand, und sollte eine Person darauf achten? „KI-Agent“ bedeutet hier ein LLM-basierter Workflow, der Anweisungen und Tools hat und eine Abfolge von Aktionen auf ein Ziel hin ausführen kann. Das aktuelle Agents SDK von OpenAI beschreibt Agenten auf dieselbe allgemeine Weise: ein Modell, das mit Anweisungen, Tools und optionalem Runtime-Verhalten wie Guardrails und strukturierten Ausgaben konfiguriert ist. Siehe die offizielle OpenAI Agents SDK-Dokumentation.
Entwerfen Sie die erste Version nicht so, dass sie „alles überwacht“. Beginnen Sie mit einem kleinen Umfang, den Sie noch manuell auditieren können. Sobald Sie der Pipeline vertrauen, erweitern Sie sie.
Schritt 1: Definieren Sie die Wettbewerber, Signale und wöchentlichen Fragen
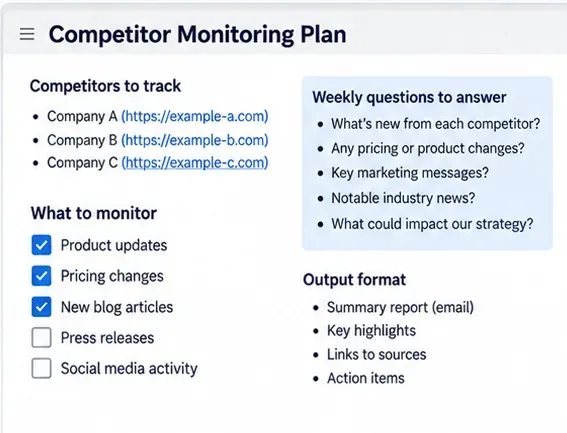
Erstellen Sie ein Monitoring-Briefing, bevor Sie Agent-Code schreiben. Entscheiden Sie für jeden Wettbewerber, welche Änderungen berichtenswert sind. Typische Signale sind öffentliche Preisänderungen, Produktstarts, Release Notes, neue Integrationen, Positionierungsänderungen, wichtige Dokumentations-Updates, öffentliche Partnerschaften, Ankündigungen von Führungskräften und große Einstellungsmuster. Die genaue Liste sollte den Entscheidungen entsprechen, die Ihr Team tatsächlich trifft.
Ein nützliches Briefing trennt Signale von Fragen. „Preisseite geändert“ ist ein Signal. „Macht der neue Plan den Wettbewerber für kleine Teams attraktiver?“ ist eine analytische Frage. Der Agent sollte das Erste sammeln und über das Zweite erst nachdenken, wenn er Evidenz hat.
KI-generierte konzeptionelle Illustration eines Monitoring-Briefings; kein Screenshot eines echten Produkts.
Formulieren Sie für den ersten wöchentlichen Durchlauf einen Satz, der den Erfolg definiert. Zum Beispiel: „Erstellen Sie bis Montagmorgen eine quellverlinkte Zusammenfassung wesentlicher Änderungen der letzten sieben Tage für fünf namentlich genannte Wettbewerber, ohne unbelegte Behauptungen.“ Dieser Satz wird später zu einem praktischen Akzeptanztest.
Schritt 2: Erstellen Sie ein Quellen-Register, anstatt sich auf offene Suche zu verlassen
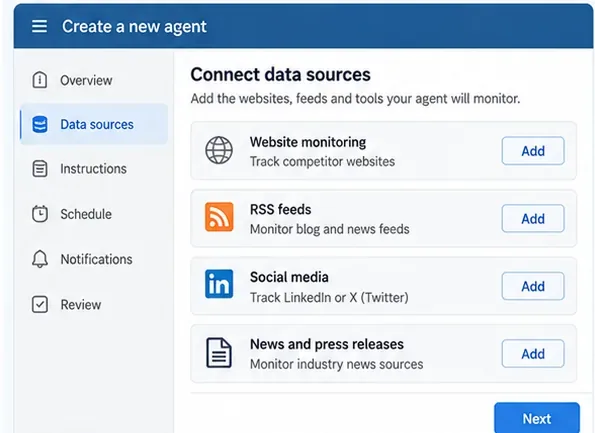
Websuche ist nützlich für die Entdeckung, aber ein Monitoring-System sollte sich nicht allein auf Suchrankings verlassen. Erstellen Sie ein kleines Quellen-Register mit Feldern wie Wettbewerber, Quellentyp, URL, Priorität, erwartete Aktualisierungsfrequenz und welche Frage die Quelle beantworten kann.
Signal
Bevorzugte Quelle
Warum es nützlich ist
Preise
Offizielle Preis- und Pläne-Seiten
Nächste Quelle zum aktuellen kommerziellen Angebot
Produktänderungen
Release Notes, Changelog, Produkt-Blog
Gibt normalerweise Daten und Feature-Kontext
Positionierung
Startseite, Produktseiten, Kampagnenseiten
Zeigt, wie das Unternehmen das Produkt präsentiert
Unternehmensnews
Pressebereich und Unternehmens-Blog
Nützlich für Partnerschaften, Finanzierung, Führung und Starts
Marktkontext
Renommierte öffentliche Nachrichtenquellen
Fügt unabhängigen Kontext zu Erstanbieter-Aussagen hinzu
Bevorzugen Sie öffentliche Seiten, offizielle Feeds, dokumentierte APIs und Quellen, auf die Sie zugreifen dürfen. Entwerfen Sie den Agenten nicht so, dass er Logins, Paywalls, Robots-Einschränkungen oder Zugriffskontrollen umgeht. Für soziale Plattformen bevorzugen Sie offizielle APIs oder öffentliche Feeds, wo verfügbar, anstatt fragiles Scraping.
KI-generierte konzeptionelle Illustration eines Quellen-Registers; verwenden Sie nur Quellen, auf die Sie zugreifen dürfen.
Das aktuelle Agents SDK von OpenAI enthält ein gehostetes WebSearchTool für Agenten, die OpenAI Responses-Modelle nutzen. Die offizielle Tool-Dokumentation unterscheidet auch zwischen gehosteter Websuche und lokalen Funktionstools, was nützlich ist, wenn Sie möchten, dass der Agent Ihren eigenen URL-Fetcher, Ihre Datenbank, Ihren RSS-Reader oder Ihren Änderungserkennungsdienst aufruft. Siehe den offiziellen Agents SDK Tools Guide.
Schritt 3: Definieren Sie das Evidenz-Schema, bevor Sie das Modell bitten, zusammenzufassen
Der einfachste Weg, inkonsistente wöchentliche Berichte zu erhalten, ist, nach „einer Zusammenfassung der Wettbewerber-News“ zu fragen. Definieren Sie stattdessen einen strukturierten Befund. Mindestens sollte jeder Befund den Wettbewerber, die Kategorie, das Beobachtungsdatum, eine kurze Zusammenfassung, die Quell-URL, ein Evidenz-Auszug oder eine Quellennotiz sowie einen Konfidenz- oder Überprüfungs-Flag enthalten.
Fügen Sie Felder für previous_state und current_state hinzu, wenn das Signal direkt verglichen werden kann, wie z. B. ein Planpreis, die Verfügbarkeit von Funktionen, eine Schlagzeile oder eine dokumentierte Integration. Dies macht den Bericht über Änderungen und nicht darüber, was das Modell in dieser Woche zufällig gefunden hat.
Strukturierte Ausgaben machen den Workflow auch leichter testbar. Das Agents SDK unterstützt derzeit einen output_type für einen Agenten, und die offizielle Dokumentation empfiehlt normale Python-Typen wie Pydantic-Modelle oder Dataclasses für strukturierte Ergebnisse. Siehe den offiziellen Agent-Konfigurationsguide.
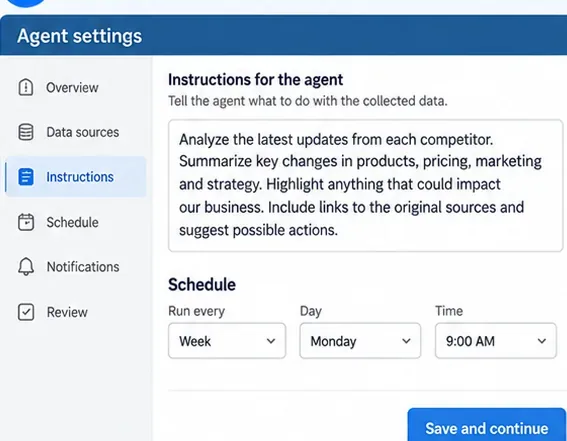
KI-generierte konzeptionelle Illustration von Agent-Anweisungen und Planung; keine echte Produktschnittstelle.
Das letzte Feld ist wichtig. Ein gutes Monitoring-System sollte in der Lage sein, „keine wesentliche Änderung gefunden“ zu sagen, anstatt ein Update zu erfinden, um Platz zu füllen.
Schritt 4: Führen Sie einen manuellen Piloten durch, bevor Sie etwas automatisieren
Führen Sie den Workflow manuell für einen Berichtszeitraum durch und vergleichen Sie das Ergebnis mit Ihrer eigenen Überprüfung derselben Quellen. Dieser Pilot deckt Probleme auf, die nach der Planung schwerer zu bemerken sind: veraltete Suchergebnisse, doppelte Geschichten, eine unklare Kategorie-Taxonomie, unbelegte Schlussfolgerungen, fehlende Quell-URLs und Befunde, die technisch neu, aber strategisch irrelevant sind.
Fragen Sie bei jedem vorgeschlagenen Befund: Ist die Quelle Erstanbieter oder unabhängig renommiert, liegt die Änderung im beabsichtigten Datumsfenster, kann ich auf die genaue Evidenz zeigen, und würde derselbe Punkt nächste Woche erneut gemeldet werden, wenn sich nichts ändert? Wenn die Antwort auf die letzte Frage ja lautet, benötigen Sie noch eine Baseline oder eine Deduplizierungsregel.
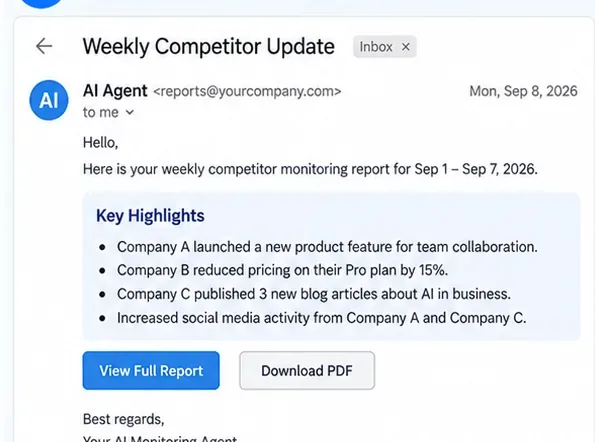
KI-generierte konzeptionelle Illustration eines manuellen Pilotberichts mit Evidenz-Links.
Behandeln Sie Such-Snippets nicht als Evidenz-Datensatz. Speichern Sie die Quell-URL und, wo Ihre Bedingungen und Zugriffsrechte es erlauben, einen normalisierten Snapshot oder extrahierten Text, der für den Vergleich verwendet wird. Die Suche sollte helfen, Evidenz zu lokalisieren; sie sollte kein Ersatz für Evidenz werden.
Schritt 5: Implementieren Sie den Agenten mit Websuche, strukturierter Ausgabe und einer Baseline
Sobald der manuelle Pilot nützliche Befunde liefert, verdrahten Sie den Agenten in Code. Stand September 2026 kann OpenAIs Python Agents SDK ein Agent, ein gehostetes WebSearchTool und strukturierten output_type kombinieren. Das folgende Beispiel ist absichtlich klein: Es demonstriert die Agent-Ebene, nicht die Speicher-Ebene.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
Die Paketinstallation und das Runner-Muster sind im offiziellen Agents SDK Quickstart dokumentiert. Das SDK dokumentiert auch Runner.run_sync() als synchronen Wrapper um den normalen Agent-Lauf.
KI-generierte konzeptionelle Illustration eines Agent-Workflows; Implementierungsdetails hängen von Ihrem Stack ab.
Fügen Sie deterministische Änderungserkennung hinzu, wo möglich
Bitten Sie das Modell nicht, jeden alten Zustand aus dem Gedächtnis neu zu entdecken. Persistieren Sie eine Baseline. Speichern Sie für jede Quelle die letzte erfolgreiche Beobachtung: normalisierter Text, ein Inhalts-Hash, ausgewählte Felder wie Preis oder Planname, der Beobachtungs-Zeitstempel und die Quell-URL. Vergleichen Sie bei der nächsten Ausführung die neue Beobachtung zuerst mit der Baseline. Geben Sie dem Agenten dann die Differenz zur Interpretation.
Dieses hybride Design ist zuverlässiger als „KI vergleicht zwei gesamte Websites“, weil deterministischer Code den exakten Vergleich handhabt, während das Modell Klassifizierung, Relevanz und Erklärung handhabt. Wenn eine Seite nur ihren Footer oder Tracking-Parameter ändert, kann Ihr Normalisierer diesen Lärm entfernen, bevor der Agent ihn sieht.
Schritt 6: Planen Sie den Workflow wöchentlich und halten Sie Zugangsdaten aus dem Code
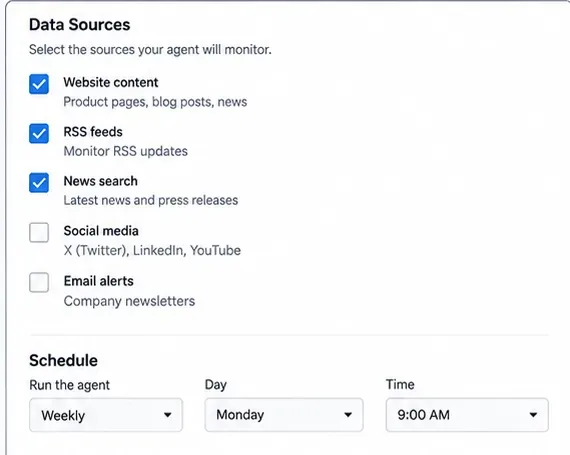
Sie können den Monitor von jedem Zeitplaner ausführen, der zu Ihrer Umgebung passt. GitHub Actions ist eine praktische Option für einen repository-basierten Workflow. Die aktuelle Dokumentation von GitHub besagt, dass geplante Workflows die POSIX-Cron-Syntax verwenden, auf dem Standard-Branch laufen, standardmäßig UTC verwenden und optional eine IANA-Zeitzone angeben können. GitHub warnt auch, dass Läufe während Hochlastphasen verzögert werden können, besonders um den Anfang der Stunde, daher ist eine Minute wie 17 vorzuziehen gegenüber 00, wenn die exakte Ausführung zur vollen Stunde nicht notwendig ist. Siehe die offizielle GitHub Actions Schedule-Dokumentation.
Speichern Sie API-Schlüssel als verschlüsselte Secrets, anstatt sie im Repository zu committen. Der offizielle Secrets-Guide von GitHub erklärt Repository-, Umgebungs- und Organisations-Secrets und empfiehlt, versehentliche Offenlegung in Workflow-Logs zu vermeiden.
KI-generierte konzeptionelle Illustration einer Planungsebene; der Artikel verwendet GitHub Actions als konkretes Beispiel.
Ein betriebliches Detail wird leicht übersehen: GitHub sagt, dass geplante Workflows in öffentlichen Repositories automatisch nach 60 Tagen ohne Repository-Aktivität deaktiviert werden. Wenn dieser Workflow geschäftskritisch ist, überwachen Sie den Monitor – protokollieren Sie die Zeit des letzten erfolgreichen Laufs und alarmieren Sie, wenn der erwartete wöchentliche Job nicht abgeschlossen wird.
Schritt 7: Setzen Sie ein menschliches Überprüfungstor zwischen „Befund“ und „Entscheidung“
Das wöchentliche Wettbewerbs-Monitoring ist ein Lese- und Zusammenfassungs-Workflow, daher sollte es nicht automatisch Preise ändern, Inhalte veröffentlichen oder eine Produkt-Roadmap verändern. Eine Person sollte wesentliche Behauptungen überprüfen, bevor sie eine Entscheidung beeinflussen. Die Überprüfung kann leichtgewichtig sein: genehmigen, ablehnen, mit einem anderen Befund zusammenführen oder als „nächste Woche beobachten“ markieren.
Verlangen Sie eine stärkere Überprüfung für hochwirksame Kategorien wie Preise, rechtliche Behauptungen, Sicherheitsvorfälle, Entlassungen, Übernahmen oder Aussagen, die auf Berichten Dritter beruhen. Für Produkt- und Preisänderungen bevorzugen Sie die eigene Seite des Wettbewerbers als primäre Evidenz, auch wenn eine Nachrichtengeschichte Ihnen geholfen hat, sie zu entdecken.
KI-generierte konzeptionelle Illustration der menschlichen Überprüfungsphase, bevor Befunde geteilt oder gehandelt werden.
Wenn Ihre Implementierung später Tools hinzufügt, die Aktionen ausführen können, enthält das Agents SDK Guardrails und Human-in-the-Loop-Genehmigungsmechanismen. Die offizielle Guardrails-Dokumentation beschreibt Eingabe-, Ausgabe- und Tool-Guardrails, während der Human-in-the-Loop-Guide erklärt, wie sensible Tool-Aufrufe zur Genehmigung pausiert werden.
Schritt 8: Verfolgen Sie Trends, verfolgen Sie Fehler und überprüfen Sie das System selbst
Ein nützlicher wöchentlicher Bericht wird nach mehreren Läufen wertvoller, weil Sie isolierte Ereignisse von Mustern unterscheiden können. Speichern Sie jeden genehmigten Befund in einer einfachen Tabelle oder Datenbank mit Wettbewerber, Kategorie, Datum, Quelle und Überprüfungsstatus. Dann können Sie Fragen beantworten wie, welcher Wettbewerber die Preise am häufigsten geändert hat, welche Themen in Release Notes wiederkehren oder welche überwachten Quellen keine nützlichen Signale mehr liefern.
KI-generierte konzeptionelle Illustration der Trendverfolgung und Selbstüberprüfung über mehrere wöchentliche Läufe.
Behalten Sie für den Agenten selbst die Observability. OpenAIs Agents SDK enthält integriertes Tracing, das Modell-Generierungen, Tool-Aufrufe, Übergaben, Guardrails und benutzerdefinierte Ereignisse aufzeichnet. Der offizielle Tracing-Guide beschreibt, wie Traces und Spans zum Debuggen und Überwachen von Workflows verwendet werden können. Seien Sie bewusst im Umgang mit sensiblen Daten, da Trace-Payloads je nach Konfiguration Modell- und Tool-Eingaben/Ausgaben enthalten können.
Selbstüberprüfung, bevor Sie dem wöchentlichen Bericht vertrauen
Jeder wesentliche Befund hat eine funktionierende Quell-URL und ein Datum innerhalb des Berichtszeitraums.
Erstanbieter-Produkt- und Preisbehauptungen werden nach Möglichkeit durch Erstanbieter-Evidenz belegt.
Das System vergleicht gegen den zuletzt bekannten Zustand, anstatt einfach alte Nachrichten zu wiederholen.
„Keine wesentliche Änderung“ ist ein akzeptables Ergebnis für jeden Wettbewerber.
Doppelte Geschichten aus mehreren Quellen werden zusammengeführt, anstatt als separate Änderungen gezählt zu werden.
Der geplante Job hat einen aufgezeichneten Erfolgs-Zeitstempel, und verpasste Läufe sind erkennbar.
API-Schlüssel und andere Zugangsdaten werden als Secrets gespeichert und erscheinen nicht in Logs oder Berichten.
Ein Mensch überprüft hochwirksame Befunde, bevor das Team darauf reagiert.
Häufige Fehler, die KI-Wettbewerbs-Monitoring unzuverlässig machen
Nur über Suchanfragen überwachen
Die Suche ist hervorragend für die Entdeckung, aber instabil als historischer Baseline. Halten Sie explizite Quell-URLs und persistieren Sie frühere Beobachtungen.
Das Modell nach „wichtigen Nachrichten“ ohne Schema fragen
Wichtigkeit ist subjektiv. Definieren Sie Kategorien, Evidenzanforderungen und einen Überprüfungs-Flag, damit die Ausgabe auditierbar ist.
Den Agenten ohne Daten zusammenfassen lassen
Ein Ergebnis kann relevant, aber alt sein. Immer das Berichtszeitfenster einbeziehen und ein beobachtetes oder veröffentlichtes Datum verlangen, wenn die Quelle eines liefert.
Jeden gefundenen Artikel an Stakeholder senden
Trennen Sie Sammlung von Berichterstattung. Die Sammlungsebene kann viele Kandidatenartikel finden; der endgültige Bericht sollte nur evidenzgestützte, deduplizierte Änderungen enthalten, die Ihren Relevanzregeln entsprechen.
Aktionen zu früh automatisieren
Die sicherste erste Version ist schreibgeschützt: sammeln, vergleichen, zusammenfassen und Überprüfung anfordern. Fügen Sie Schreibaktionen erst hinzu, nachdem Sie False Positives messen und Fehlermodi verstehen können.
Eine einfache Architektur, die Sie wiederverwenden können
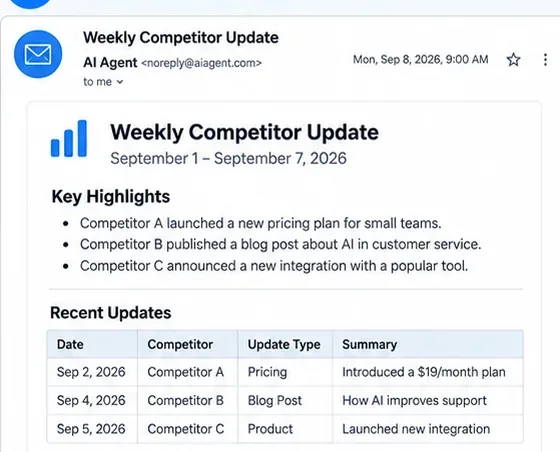
Das dauerhafte Muster ist: Quellen-Register → Sammlung → Normalisierung → Baseline-Vergleich → Agent-Analyse → strukturierte Befunde → menschliche Überprüfung → wöchentlicher Bericht → Trend-Speicher. Der KI-Agent ist in den Interpretationsphasen am stärksten, während gewöhnlicher Code für exakte Planung, Zustandspeicherung, Hashing, Wiederholungen und deterministische Vergleiche normalerweise besser geeignet ist.
Wenn der Workflow die Selbstüberprüfung für mehrere aufeinanderfolgende Läufe besteht, können Sie vorsichtig erweitern: mehr Wettbewerber hinzufügen, spezialisierte Agenten für Preis- oder Produktänderungen hinzufügen, eine Datenbank hinzufügen oder genehmigte Berichte an E-Mail, Slack oder Ihre interne Wissensdatenbank weiterleiten. Das Ziel ist nicht, den autonomsten Agenten zu erstellen. Es ist, das kleinste wiederholbare System zu erstellen, das Ihrem Team zeitnahe, quellgestützte Wettbewerberänderungen jede Woche liefert.