Startseite
» Domänen
»
So erstellen Sie eine kostenlose KI-Pipeline zur Wiederverwendung von Inhalten mit n8n und Claude (Was wirklich kostenlos ist)
So erstellen Sie eine kostenlose KI-Pipeline zur Wiederverwendung von Inhalten mit n8n und Claude (Was wirklich kostenlos ist)
Sie können die Automatisierungsebene einer KI-Pipeline zur Wiederverwendung von Inhalten kostenlos gestalten, indem Sie die n8n Community Edition selbst hosten, aber ein Claude-basierter n8n-Workflow ist nicht garantiert end-to-end kostenlos. Diese Unterscheidung ist wichtig. n8n gibt an, dass die selbst gehostete Community Edition unbegrenzt kostenlos genutzt werden kann, während die Claude API von Anthropic ein abgerechneter Entwicklerdienst ist. Der kostenlose Claude-Chat-Plan auf der Claude-Website ist nicht dasselbe wie die API-Nutzung innerhalb von n8n.
Stand 11. September 2026 dokumentiert n8n die Community Edition als kostenlose selbst gehostete Edition mit nahezu dem vollständigen Kernfunktionsumfang. Die aktuelle API-Preisgestaltung von Anthropic listet Claude Sonnet 5 mit 2 USD pro Million Eingabe-Tokens und 10 USD pro Million Ausgabe-Tokens sowie Claude Haiku 4.5 mit 1 USD pro Million Eingabe-Tokens und 5 USD pro Million Ausgabe-Tokens. Preise und Modelle können sich ändern, überprüfen Sie diese daher vor der Bereitstellung. Siehe die Dokumentation zur Community Edition von n8n und die aktuelle Preisseite von Anthropic.
Die praktische Version von „kostenlos“ lautet also: kostenlose n8n-Software auf Infrastruktur, die Sie kontrollieren, plus die Claude-API-Nutzung, die Ihr Workflow generiert. Wenn Sie bereits über Infrastruktur und API-Guthaben verfügen, können Ihre inkrementellen Kosten vorübergehend null sein. Wenn nicht, rechnen Sie mindestens mit Kosten für die Modellnutzung und möglicherweise mit Hosting-Kosten.
Was diese Pipeline tun wird
Der folgende Workflow nimmt ein Quellenelement – wie einen Blogbeitrag, einen Newsletter-Entwurf, ein Podcast-Transkript, ein Webinar-Transkript oder eine ausführliche Notiz – und verwandelt es in mehrere strukturierte Entwurfs-Assets. Ein nützlicher Start-Ausgang ist:
Ein LinkedIn-ähnlicher Beitrag
Drei kurze Social-Media-Beiträge
Eine E-Mail-Betreffzeile und Einleitung
Ein kurzer Video-Hook und ein Skript
Fünf zentrale Erkenntnisse
Ein Review-Flag, wenn die Quelle nicht genügend Informationen enthält
Die Pipeline erzeugt absichtlich zunächst Entwürfe. Die automatische Veröffentlichung kann später hinzugefügt werden, aber es ist in der Regel sicherer, die Inhaltsqualität, das Format, die Quellentreue und die Berechtigungen für das Ziel zu überprüfen, bevor ein KI-Workflow ohne Review veröffentlicht.
Ist dieser Ansatz für Sie geeignet?
Situation
Empfehlung
Warum
Sie verwenden Ihre eigenen Artikel oder genehmigte Unternehmensinhalte neu
Gute Wahl
Die Quelle ist kontrolliert und das Transformationsziel ist vorhersehbar.
Sie benötigen konsistente Entwürfe für mehrere Kanäle
Gute Wahl
n8n kann dieselbe Transformation wiederholt orchestrieren.
Sie möchten eine dauerhaft kostenlose Claude API
Nicht geeignet wie beschrieben
Die Claude-API-Nutzung wird abgerechnet; der kostenlose Claude-Chat-Plan macht die API-Automatisierung nicht kostenlos.
Sie benötigen live faktische Recherche, die jedem Entwurf hinzugefügt wird
Verwenden Sie eine separate Recherche-/Verifizierungsstufe
Die Wiederverwendung sollte nicht stillschweigend in Fakten-Generierung übergehen.
Sie verarbeiten nicht vertrauenswürdige Webseiten oder Dokumente von Drittanbietern
Fügen Sie stärkere Eingabeisolierung und Review hinzu
Externe Inhalte können Anweisungen enthalten, die den Workflow nicht steuern sollten.
Sie benötigen komplexe Tool-Auswahl und autonome Entscheidungen
Erwägen Sie einen KI-Agenten
Eine Basic LLM Chain ist einfacher, wenn die Aufgabe eine vorhersehbare Texttransformation ist.
Die empfohlene Architektur
Beginnen Sie in der ersten Version nicht mit einem autonomen Agenten. Die Basic LLM Chain von n8n ist so konzipiert, dass sie eine Eingabeaufforderung an ein verbundenes Sprachmodell übergibt und einen Ausgabe-Parser anhängen kann. Das reicht für einen deterministischen Workflow „Quelle rein, formatierte Entwürfe raus“. Siehe die Dokumentation zur Basic LLM Chain von n8n.
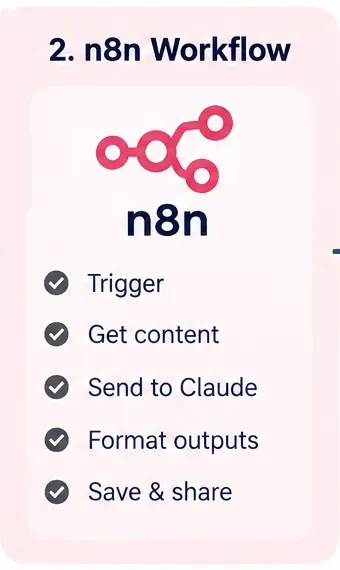
KI-generierte Illustration einer n8n-Workflow-Stufe; es ist kein tatsächlicher n8n-Screenshot.
Die aktuelle Dokumentation von n8n unterstützt das Self-Hosting mit Docker und beschreibt die Community Edition als kostenlos. Docker ist ein guter Ausgangspunkt, da es die n8n-Instanz leicht reproduzierbar macht und Ihnen ein persistentes Volume für Workflow- und Zugangsdaten gibt.
Der offizielle Docker-Leitfaden erstellt ein n8n_data-Volume, stellt Port 5678 bereit, setzt zeitzonenbezogene Umgebungsvariablen und bindet das persistente Datenverzeichnis ein. Für n8n 2.x weist die Dokumentation darauf hin, dass N8N_RUNNERS_ENABLED veraltet ist und nicht mehr gesetzt werden muss. Verwenden Sie den aktuellen Befehl aus dem Docker-Installationsleitfaden von n8n, anstatt einen alten Befehl aus einem Tutorial zu kopieren.
Für einen lokalen Proof of Concept reicht es aus, http://localhost:5678 zu öffnen. Für eine internetseitige Produktionsinstanz sollten Sie den lokalen Port nicht einfach öffentlich freigeben. Befolgen Sie die Hosting- und Sicherheitsrichtlinien von n8n für HTTPS, Authentifizierung, Backups und Reverse-Proxy-Konfiguration.
Verwenden Sie diesen Schritt, wenn: Sie sich damit auskennen, Ihren eigenen Docker-Host zu warten. Wenn Sie keinen Server patchen, sichern, überwachen und sichern möchten, ist n8n Cloud einfacher, aber nicht die hier beschriebene dauerhaft kostenlose Option.
Schritt 2: Wählen Sie, wie der Workflow startet
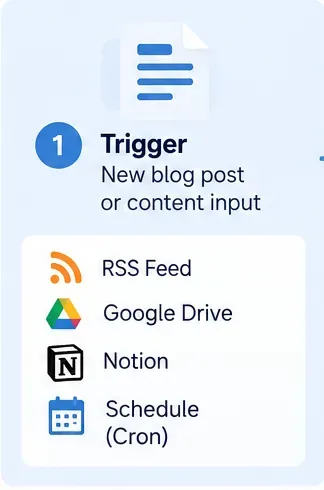
KI-generierte Illustration möglicher Workflow-Trigger und Inhaltsquellen; die tatsächliche Verfügbarkeit und Konfiguration der n8n-Knoten sollte in Ihrer Instanz überprüft werden.
Verwenden Sie einen Webhook, wenn eine andere App Inhalte bei Bedarf an n8n senden soll. Verwenden Sie einen Schedule Trigger, wenn n8n zu einer festen Zeit oder in einem Intervall nach Inhalten suchen soll.
Der Webhook-Knoten von n8n stellt separate Test- und Produktions-URLs bereit. Die Test-URL ist für die Entwicklung konzipiert; die Produktions-URL wird registriert, wenn der Workflow veröffentlicht wird. Der Webhook-Knoten unterstützt auch Authentifizierungsoptionen, einschließlich Basic Auth, Header Auth und JWT Auth. Siehe die Webhook-Dokumentation von n8n.
Für geplante Wiederverwendung läuft der Schedule Trigger von n8n zu festen Zeiten oder Intervallen, und n8n gibt an, dass der Workflow gespeichert und veröffentlicht werden muss, damit die geplante Auslösung funktioniert. Siehe die Schedule Trigger-Dokumentation von n8n.
Beispiel: Wenn Ihr CMS einen Webhook aufrufen kann, nachdem ein Redakteur einen Artikel genehmigt hat, verwenden Sie den Webhook. Wenn Sie genehmigte Quellinhalte in einem Ordner aufbewahren und jeden Werktagmorgen einen Batch wünschen, kann ein Zeitplan einfacher sein.
Schritt 3: Definieren Sie einen sauberen Eingabevertrag
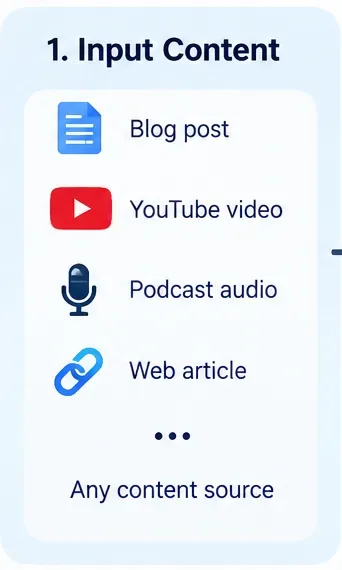
KI-generierte Illustration von Quellentypen, die einen Wiederverwendungs-Workflow speisen können; sie stellt keinen echten n8n-Bildschirm dar.
Lassen Sie nicht zu, dass jede Quelle in einer anderen Form eintrifft. Normalisieren Sie die Eingaben in eine interne Struktur, bevor Sie Claude aufrufen. Ein praktisches JSON-Payload ist:
Übergeben Sie wann immer möglich den tatsächlichen Quelltext. Eine URL allein ist nicht dasselbe wie verifizierter Quellinhalt. Das Abrufen und Parsen einer Seite fügt einen weiteren Fehlerpunkt hinzu und kann Navigation, Cookies, Werbung oder irrelevanten Text in die Eingabeaufforderung einbringen.
Trennen Sie außerdem Anweisungen vom Quellmaterial. Wenn Sie Seiten von Drittanbietern, E-Mails oder hochgeladene Dokumente aufnehmen, behandeln Sie deren Inhalte als nicht vertrauenswürdige Daten und nicht als Workflow-Befehle. Die Sicherheitsrichtlinien von Anthropic beschreiben explizit indirekte Prompt-Injection als böswillige Anweisungen, die in Inhalte eingebettet sind, die das Modell liest. Siehe die Richtlinien von Anthropic zur Minderung von Prompt-Injection.
Schritt 4: Validieren und normalisieren vor dem Modellaufruf
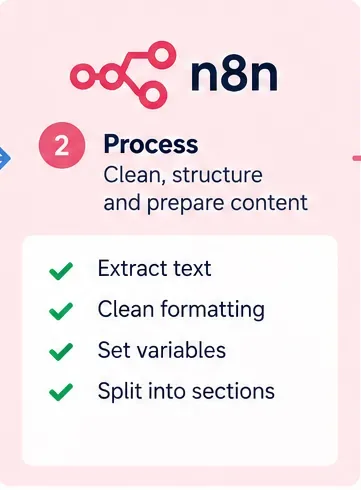
KI-generierte Illustration einer Vorverarbeitungsstufe; es ist kein tatsächlicher n8n-Workflow-Screenshot.
Lehnen Sie schlechte Eingaben ab, bevor Sie Tokens ausgeben. Prüfen Sie mindestens, ob source_id, title und source_text vorhanden sind und ob source_text nicht leer ist. Normalisieren Sie offensichtliches Formatierungsrauschen, bewahren Sie aber Fakten, Zitate, URLs, Überschriften und andere Quellendetails auf, die Claude möglicherweise benötigt.
Eine nützliche Vorverarbeitungsstufe kann:
Führende und nachfolgende Leerzeichen entfernen
Wiederholte Leerzeilen in ein konsistentes Format umwandeln
Standardwerte für Zielgruppe und Stimme festlegen
Quelltext unter einer minimalen nützlichen Länge ablehnen
Eine stabile source_id zur Deduplizierung erstellen
Die angeforderten Ausgabetypen aufzeichnen
Teilen Sie einen normalen Artikel nicht in viele Modellaufrufe auf, es sei denn, Sie müssen es tatsächlich. Mehrere Aufrufe erhöhen die Orchestrierungskomplexität und können zu inkonsistentem Ton führen. Bei großen Quellmaterialien sollten Sie das Zusammenfassen oder Chunking absichtlich in Betracht ziehen, anstatt Eingaben versehentlich zu kürzen.
Schritt 5: Claude korrekt verbinden – und die Kosten verstehen
KI-generierte Illustration der Rolle von Claude im Workflow; es ist kein Anthropic Console- oder n8n-Screenshot.
n8n stellt einen Anthropic Chat Model-Knoten und Anthropic-Zugangsdaten bereit, die einen API-Schlüssel verwenden. Die Zugangsdaten-Dokumentation von n8n weist Benutzer an, einen Schlüssel in der Anthropic Console zu erstellen und ihn in den n8n-Zugangsdaten zu speichern, anstatt ihn hart im Workflow-Text zu codieren. Siehe die Anthropic-Zugangsdaten-Dokumentation von n8n und die Anthropic Chat Model-Dokumentation von n8n.
Verbinden Sie für diese Pipeline das Anthropic Chat Model mit einer Basic LLM Chain. Eine praktische Modellwahl hängt von Ihren Qualitäts- und Kostenzielen ab:
Modellwahl
Wann es sinnvoll ist
Aktuelle API-Preise, überprüft am 11. Sep. 2026
Claude Haiku 4.5
Hohes Volumen, einfachere Umschreibungen und erste Entwürfe
1 USD/MTok Eingabe; 5 USD/MTok Ausgabe
Claude Sonnet 5
Stärkere Standardwahl für nuancierte Multi-Format-Wiederverwendung
2 USD/MTok Eingabe; 10 USD/MTok Ausgabe
Claude Opus 5
Nur wenn die Aufgabe wirklich tieferes Denken erfordert
5 USD/MTok Eingabe; 25 USD/MTok Ausgabe
Die oben genannten Preise stammen von der aktuellen Preisseite von Anthropic und können sich ändern. Vermeiden Sie auch, alte Modell-IDs aus älteren Tutorials zu kopieren. Anthropic führt eine Seite zur Modell-Deprecation, da Modelle regelmäßig eingestellt und ausgemustert werden. Prüfen Sie die Dokumentation zur Modell-Deprecation von Anthropic, bevor Sie einen Modellnamen hart codieren.
Schritt 6: Verwenden Sie eine Eingabeaufforderung, die die Quellentreue bewahrt
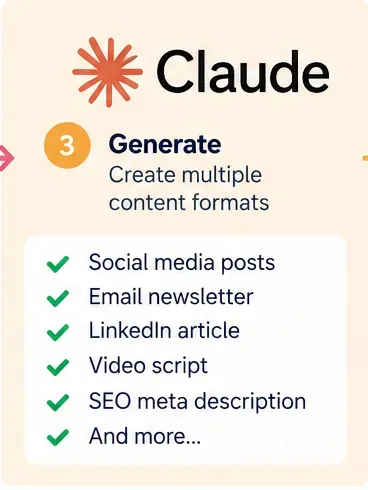
KI-generierte Illustration der Multi-Format-Inhaltsgenerierung; die aufgeführten Ausgaben sind Beispiele, keine garantierten Produktfunktionen.
Die Eingabeaufforderung sollte die Transformationsgrenze explizit machen: Claude darf die Quelle umformulieren und komprimieren, aber keine Fakten erfinden, die nicht vorhanden sind. Die aktuelle Prompting-Richtlinie von Anthropic empfiehlt klare Anweisungen und strukturierte Tags für komplexe Eingaben. Siehe die Dokumentation zu den Best Practices für Prompting von Anthropic.
Eine praktische Systemnachricht ist:
You are a content repurposing editor.
Use only factual claims supported by the supplied source.
Do not invent statistics, quotes, customer results, dates, or product capabilities.
Preserve the original meaning while adapting format and tone.
If an output requires information not present in the source, set needs_review to true
and explain the missing information in review_notes.
Return the requested structured fields only.
Erstellen Sie dann die Benutzernachricht aus n8n-Ausdrücken:
Beispiel: Wenn die Quelle besagt, dass ein Produkt im Mai gestartet wurde, aber nie Kundenzahlen angibt, darf Claude die Startfakt in einen kürzeren Beitrag umwandeln, aber er sollte nicht „10.000 Kunden“ hinzufügen, um den Beitrag stärker klingen zu lassen.
Schritt 7: Erzwingen Sie strukturierte Ausgabe, anstatt Prosa zu parsen
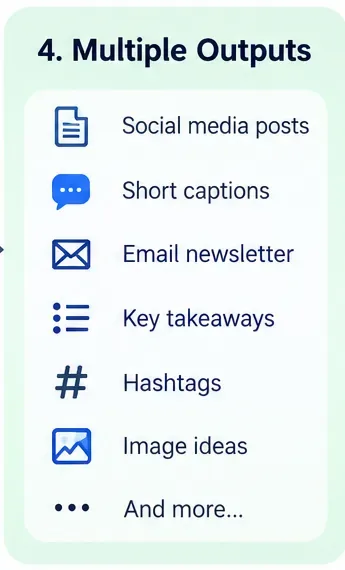
KI-generierte Illustration strukturierter Inhaltsausgaben; es ist kein Screenshot der Claude-API-Antwort.
Freitext ist schwierig zu routen. Wenn Claude Überschriften zurückgibt, die sich von einer Ausführung zur nächsten ändern, werden nachgelagerte Knoten fragil. Der Structured Output Parser von n8n kann Felder basierend auf einem JSON-Schema zurückgeben, und die Basic LLM Chain kann ein spezifisches Ausgabeformat erzwingen. Siehe die Dokumentation zum Structured Output Parser von n8n.
Wenn Sie sich entscheiden, die Claude Messages API direkt mit dem HTTP Request-Knoten von n8n anstelle der Anthropic Chat Model-Integration aufzurufen, unterstützt Anthropic auch native strukturierte Ausgaben über output_config.format bei unterstützten Modellen. Siehe die Dokumentation zu Structured Outputs von Anthropic und die Claude Messages API-Referenz.
Schritt 8: Entwürfe speichern, überprüfen und dann die Veröffentlichung automatisieren
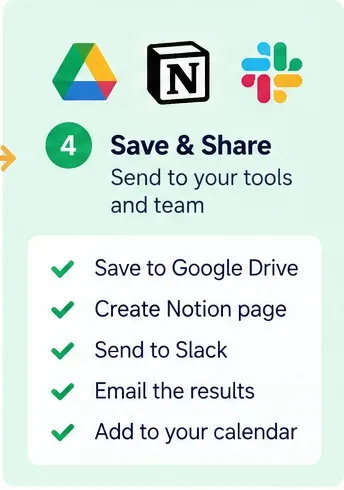
KI-generierte Illustration von Entwurfszielen; es ist kein Screenshot einer Live-Integration oder ein Beweis dafür, dass ein Konto verbunden ist.
Speichern Sie für die erste Produktionsversion die generierten Felder an einem Review-Speicherort, anstatt sie direkt an öffentliche Kanäle zu senden. Übliche Ziele sind eine Datenbank, Google Drive, Google Sheets, Notion, ein CMS-Entwurf oder eine interne Review-Nachricht.
Verwenden Sie needs_review als hartes Gate. Erwägen Sie auch einen menschlichen Review-Schritt für alles, was eine externe Nachricht sendet oder ein Produktionssystem ändert. n8n unterstützt derzeit Human-in-the-Loop-Genehmigung für KI-Tool-Aufrufe, bei der ein Reviewer ausgewählte Aktionen genehmigen oder ablehnen kann. Siehe die Human-in-the-Loop-Dokumentation von n8n.
Empfohlene Einführung:
Woche 1: Nur Entwürfe generieren.
Woche 2: Ausgaben mit der Quelle vergleichen und Prompt-/Schema-Fehler beheben.
Woche 3: Genehmigte Entwürfe automatisch in Ziel-Entwurfsordner verschieben lassen.
Erst wenn der Workflow stabil ist: Automatische Veröffentlichung für risikoarme Formate erwägen.
Ein konkreter End-to-End-n8n-Workflow
Erstellen Sie für eine einfache webhook-gesteuerte Version diese Knoten in dieser Reihenfolge:
#
Knoten
Zweck
1
Webhook
Das genehmigte Quellenelement empfangen.
2
Edit Fields / Code
Feldnamen und Standardwerte normalisieren.
3
If
Fehlenden oder leeren Quelltext ablehnen.
4
Basic LLM Chain
Die Wiederverwendungsanweisungen und dynamischen Quellinhalte halten.
5
Anthropic Chat Model
Die wiederverwendeten Entwürfe generieren.
6
Structured Output Parser
Stabile JSON-Felder erzwingen.
7
If
needs_review=true an manuelles Review routen.
8
Zielknoten
Genehmigte Ausgabe als Entwürfe speichern.
9
Respond to Webhook
Status und generierte Datensatz-ID an den Aufrufer zurückgeben.
Wenn Sie einen geplanten Pipeline bevorzugen, ersetzen Sie den Webhook durch einen Schedule Trigger und fügen Sie einen Quellknoten hinzu, der genehmigte, unverarbeitete Elemente abruft.
Wie Sie vermeiden, dieselbe Quelle zweimal wiederzuverwenden
Fügen Sie jedem Element eine unveränderliche source_id hinzu und speichern Sie verarbeitete IDs. Prüfen Sie vor dem Ausführen von Claude, ob diese ID bereits erfolgreich abgeschlossen wurde. Dies ist grundlegende Idempotenz: Das Wiederholen desselben Triggers sollte keine doppelten Entwürfe erstellen, es sei denn, Sie fordern explizit eine neue Version an.
Verwenden Sie für Revisionen einen zusammengesetzten Schlüssel wie source_id + source_revision. Das ermöglicht es Version 2 eines Artikels, neue Entwürfe zu generieren, ohne so zu tun, als wäre es dieselbe Quelle wie Version 1.
Wie Sie die Claude API-Kosten senken
Die Modellwahl ist nur ein Hebel. Die größte vermeidbare Kosten ist oft das Senden unnötigen Textes oder das Generieren unnötig langer Ausgaben.
Entfernen Sie Navigation, Boilerplate und irrelevantes HTML vor dem Modellaufruf.
Fordern Sie nur Formate an, die Sie tatsächlich benötigen.
Legen Sie sinnvolle Ausgabe-Längenbeschränkungen in der Eingabeaufforderung fest.
Verwenden Sie Haiku 4.5 für einfache Hochvolumen-Transformationen, wenn die Qualität ausreicht.
Verwenden Sie Sonnet 5, wenn die Quelle mehr Nuancen oder stärkere Cross-Format-Anpassung erfordert.
Senden Sie nicht bei jedem Aufruf denselben langen Markenleitfaden, wenn Sie ihn mit prägnanten stabilen Anweisungen darstellen können.
Messen Sie Token-Nutzung und Kosten, anstatt anzunehmen, dass ein kurzer Workflow billig ist.
Anthropic bietet auch Prompt-Caching und Batch-Verarbeitung für anwendbare Workloads an, aber diese Funktionen haben ihre eigenen Anforderungen und Preise. Fügen Sie sie nicht dem ersten Workflow hinzu, es sei denn, wiederholter Kontext oder nicht dringende Hochvolumen-Verarbeitung machen die zusätzliche Komplexität lohnenswert.
Drei Fehlermodi, die vor der Veröffentlichung getestet werden sollten
1. Halluzinierte Fakten
Füttern Sie den Workflow mit einer Quelle, die absichtlich eine Statistik auslässt. Das erwartete Verhalten ist, dass die Ausgabe keine erfindet. Wenn sie es tut, verstärken Sie die Anweisungen zur Quellentreue und das Review-Gate.
2. Defekte strukturierte Ausgabe
Testen Sie jedes erforderliche Feld, leere Arrays, ungewöhnlich langen Quelltext und Sonderzeichen. Eine Pipeline ist nicht zuverlässig, nur weil eine attraktive Demo-Ausgabe korrekt aussah.
3. Doppelte Ausführungen
Senden Sie dieselbe source_id zweimal. Der zweite Lauf sollte stoppen, den vorhandenen Datensatz aktualisieren oder absichtlich eine Revision gemäß Ihrem Design erstellen – nicht stillschweigend jeden Entwurf duplizieren.
Brauchen Sie einen KI-Agenten dafür?
In der Regel nein. Ein KI-Agent ist hilfreich, wenn das Modell entscheiden muss, welche Tools aufgerufen werden oder basierend auf einem offenen Ziel unterschiedliche Aktionen ausführen soll. Die Wiederverwendung von Inhalten ist normalerweise eine vorhersehbare Transformation, daher ist eine Kette einfacher zu inspizieren, zu testen und zu steuern.
Wechseln Sie nur zu einem Agenten, wenn Sie einen konkreten Bedarf haben, wie z. B. das dynamische Auswählen von Recherche-Tools, das Entscheiden, welches Ziel einen Entwurf erhält, oder das Fragen eines Menschen nach fehlenden Informationen. Selbst dann halten Sie irreversible Veröffentlichungsaktionen hinter explizitem Review, bis der Workflow gut getestet ist.
Abschließende Build-Checkliste
Hosten Sie die n8n Community Edition selbst, wenn die n8n-Software-Ebene kostenlos bleiben soll.
Beschreiben Sie die Claude-API-Nutzung nicht als dauerhaft kostenlos.
Verwenden Sie einen Webhook für On-Demand-Verarbeitung oder einen Schedule Trigger für zeitgesteuerte Batches.
Normalisieren Sie jede Quelle in einen Eingabevertrag.
Übergeben Sie Quelltext, nicht nur eine URL.
Speichern Sie den Anthropic-API-Schlüssel in den n8n-Zugangsdaten.
Verwenden Sie ein aktives Claude-Modell und prüfen Sie die Deprecation-Seite regelmäßig.
Verwenden Sie eine Basic LLM Chain für vorhersehbare Wiederverwendung.
Erzwingen Sie ein strukturiertes Ausgabe-Schema.
Fügen Sie needs_review und Review-Notizen zum Schema hinzu.
Deduplizieren Sie mit einer stabilen Quell-ID.
Speichern Sie Entwürfe, bevor Sie die automatische Veröffentlichung aktivieren.
Testen Sie Halluzinationen, fehlerhafte Eingaben, doppelte Trigger und Fehlerpfade.
Überwachen Sie Token-Nutzung und Kosten externer Dienste.
Die beste erste Version ist absichtlich langweilig: eine saubere Eingabe, ein kontrollierter Claude-Aufruf, eine validierte JSON-Antwort und ein Entwurfsziel. Diese Architektur ist leicht zu debuggen und günstig im Betrieb. Sobald sie zuverlässig auf echten Quellmaterialien funktioniert, können Sie weitere Kanäle, Planung, menschliche Genehmigungen, Analysen oder Veröffentlichungsintegrationen hinzufügen, ohne die Kernpipeline neu aufzubauen.