Startseite
» Domänen
»
So führen Sie DeepSeek offline unter Windows 11 mit LM Studio aus
So führen Sie DeepSeek offline unter Windows 11 mit LM Studio aus
Ja – Sie können DeepSeek vollständig offline unter Windows 11 mit LM Studio ausführen, benötigen jedoch zunächst einen Online-Einrichtungsschritt. Installieren Sie LM Studio, laden Sie ein kompatibles DeepSeek-Modell und die erforderliche Laufzeitumgebung herunter, laden Sie das Modell einmal und trennen Sie anschließend die Internetverbindung. Die offizielle Offline-Dokumentation von LM Studio besagt, dass das Chatten mit heruntergeladenen Modellen, das Chatten mit lokalen Dokumenten und das Ausführen des lokalen Servers keinen Internetzugang erfordern.
Für einen typischen Windows 11-PC ist das größte aktuelle DeepSeek-Modell nicht der praktischste Ausgangspunkt. Ein kleineres GGUF-Modell wie DeepSeek-R1-0528-Qwen3-8B ist lokal viel einfacher auszuführen. LM Studio hat im Mai 2025 die Unterstützung für dieses 8B-distillierte Modell veröffentlicht und gibt an, dass es im GGUF-Format mit LM Studio 0.3.16 oder neuer funktioniert. Im Gegensatz dazu besagt die August-2026-Empfehlung von LM Studio für DeepSeek V4 Flash, dass die lokale Nutzung etwa 156 GB Systemspeicher erfordert. Das macht V4 Flash zu einer schlechten Wahl für die meisten Consumer-Windows-Maschinen, obwohl es neuer und leistungsfähiger ist.
Dieser Leitfaden wurde am 11. September 2026 überprüft. Das Changelog von LM Studio listet Version 0.4.24 vom 9. September 2026. Da sich die Oberfläche von LM Studio weiterentwickelt, kann sich eine Schaltfläche zwischen den Builds leicht verschieben, aber der Kernarbeitsablauf – ein Modell herunterladen, laden, lokal chatten und optional eine localhost-API bereitstellen – bleibt von LM Studio dokumentiert.
Vor dem Start: Passt Ihr Windows 11-PC?
LM Studio unterstützt derzeit sowohl x64-Windows-PCs als auch ARM-basierte Windows-Systeme. Für x64 muss die CPU AVX2 unterstützen. LM Studio empfiehlt mindestens 16 GB RAM und mindestens 4 GB dedizierten VRAM. Dies sind Empfehlungen auf Anwendungsebene, keine Garantie, dass jedes Modell passt. Modellgröße, Quantisierung, Kontextlänge und GPU-Offload beeinflussen alle die Speichernutzung.
Was Sie haben
Praktische Empfehlung
Warum
16 GB RAM, moderate GPU oder integrierte Grafik
Beginnen Sie mit einem 8B- oder kleineren DeepSeek-distillierten Modell in einer 4-Bit-GGUF-Variante
Dies hält den Modell-Fußabdruck relativ überschaubar, während die nützliche Schlussfolgerungsfähigkeit erhalten bleibt.
Mehr RAM und eine stärkere GPU
Versuchen Sie größere distillierte Varianten erst, nachdem Sie die Gerätekompatibilitätsschätzung von LM Studio überprüft haben
Größere Modelle können die Qualität verbessern, verbrauchen jedoch erheblich mehr Speicher und können viel langsamer sein.
Gewöhnlicher Gaming-PC oder Laptop
Beginnen Sie nicht mit DeepSeek V4 Flash
LM Studio gibt an, dass das lokale V4 Flash-Modell mindestens 156 GB Systemspeicher benötigt.
Die Dokumentation zum Modell-Download von LM Studio erklärt, dass quantisierte Builds etwas Treue gegen kleinere Dateien und geringeren Speicherdruck eintauschen. Die allgemeine Empfehlung lautet, eine 4-Bit-Option oder höher zu wählen, wenn Ihre Hardware dies bewältigen kann. Wenn Sie unsicher sind, ist eine 4-Bit-GGUF-Version ein sinnvoller erster Test.
Schritt 1: Installieren Sie LM Studio unter Windows 11
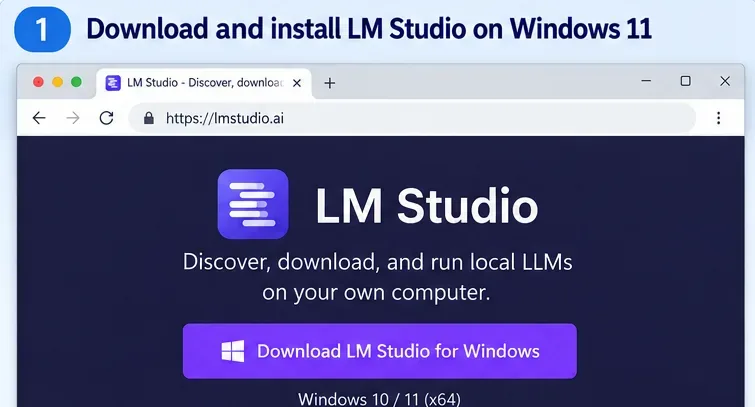
Laden Sie den aktuellen stabilen Windows-Build von der offiziellen LM Studio-Download-Seite herunter. Verwenden Sie den Installer, der zu Ihrer Windows-Architektur passt. Stellen Sie auf einem x64-PC sicher, dass Ihr Prozessor AVX2 unterstützt, bevor Sie später Modell-Ladefehler beheben.
Die Windows-Download-Ansicht für LM Studio. Wählen Sie den Installer, der zu Ihrem Windows 11-System passt, bevor Sie mit dem Modell-Download fortfahren.
Starten Sie LM Studio, solange Sie noch eine Internetverbindung haben. Dies ist wichtig, da die App möglicherweise eine LM Runtime herunterladen oder aktualisieren muss. LM Studio beschreibt Runtimes als verpackte Inferenz-Engines, wie z. B. die auf llama.cpp basierende Runtime für GGUF-Modelle. Runtime-Downloads erfordern Konnektivität, obwohl die Inferenz danach offline funktionieren kann.
Schritt 2: Laden Sie ein DeepSeek-Modell herunter, das zu Ihrem PC passt
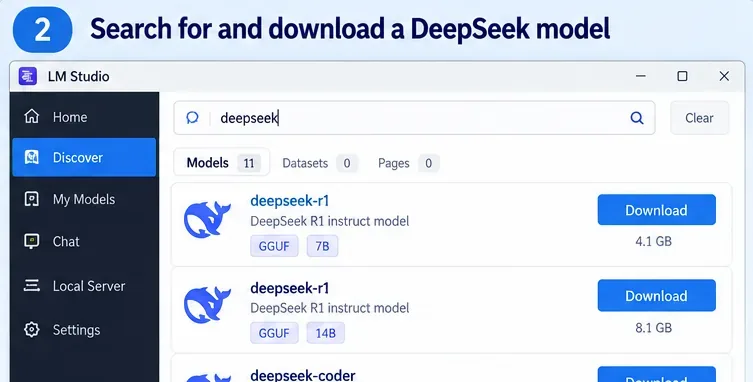
Öffnen Sie den Bereich Discover in LM Studio und suchen Sie nach DeepSeek. LM Studio kann unterstützte Hugging Face-Modelle nach Schlüsselwort, nach einer user/model-Kennung oder sogar nach einer vollständigen Hugging Face-URL durchsuchen.
Suchen Sie in Discover nach DeepSeek und wählen Sie dann ein Modell und eine Quantisierung, die für Ihre Hardware geeignet sind. Die genauen Katalogeinträge und Dateigrößen ändern sich im Laufe der Zeit.
Welches DeepSeek-Modell sollten Sie wählen?
Für die meisten Personen, die diesem Leitfaden folgen, beginnen Sie mit DeepSeek-R1-0528-Qwen3-8B. LM Studio gibt an, dass dieses distillierte 8B-Modell Schlussfolgerungen und Tool-Nutzung unterstützt, als GGUF verfügbar ist und mit deutlich weniger Speicher als die Flaggschiff-DeepSeek-Modelle ausgeführt werden kann. Die Windows-Empfehlungen von LM Studio empfehlen weiterhin 16 GB RAM für die Anwendung insgesamt, behandeln Sie daher eine modellspezifische Niedrigspeicher-Aussage nicht als komfortables Ziel für das gesamte System.
DeepSeek hat auch frühere R1-distillierte Varianten mit 1,5B, 7B, 8B, 14B, 32B und 70B Parametern veröffentlicht. Diese geben Ihnen Spielraum, um Geschwindigkeit und Speichernutzung gegen Leistungsfähigkeit abzuwägen. Siehe das offizielle DeepSeek-R1-Repository für die Modellfamilie und Lizenzdetails sowie den Hinweis von LM Studio zum lokalen Ausführen von DeepSeek-R1-0528 für die 8B-Option.
Wenn Sie von DeepSeek V4 Flash verführt werden, weil es neuer ist, überprüfen Sie zuerst die Hardware-Anforderung. Der offizielle V4 Flash-Artikel von LM Studio besagt, dass das 284B Mixture-of-Experts-Modell mindestens 156 GB Systemspeicher für die lokale Nutzung benötigt. Es ist auf High-Memory-Workstations praktikabel, nicht auf einem normalen Windows-Laptop.
Schritt 3: Laden Sie das Modell in den Speicher
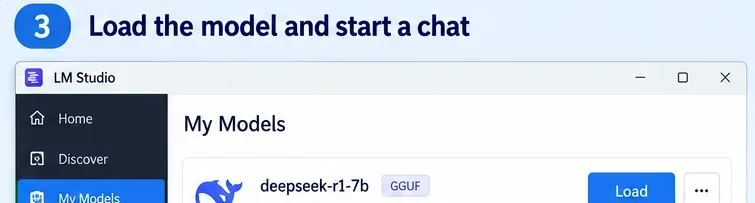
Nachdem der Download abgeschlossen ist, gehen Sie zu Ihren heruntergeladenen Modellen oder öffnen Sie den Modell-Lader aus dem Chat. Wählen Sie das DeepSeek-Modell aus und laden Sie es. LM Studio erklärt, dass das Laden eines Modells Speicher für die Modellgewichte und den zugehörigen Runtime-Zustand zuweist.
Ein heruntergeladenes DeepSeek GGUF-Modell, bereit zum Laden. Wenn das Laden fehlschlägt, versuchen Sie ein kleineres Modell oder eine Quantisierung mit geringerem Speicherbedarf, bevor Sie erweiterte Einstellungen ändern.
Halten Sie die Ladeeinstellungen für den ersten Durchlauf konservativ. Ein sehr großes Kontextfenster kann erheblichen zusätzlichen Speicher verbrauchen, daher gibt es wenig Grund, den Kontext sofort zu maximieren. Laden Sie das Modell mit einem bescheidenen Kontext, überprüfen Sie, ob es funktioniert, und erweitern Sie es nur, wenn Ihre Arbeitslast dies erfordert.
Wenn LM Studio meldet, dass das Modell nicht passt, ist die zuverlässigste Lösung normalerweise, ein kleineres Modell oder eine kompaktere Quantisierung zu wählen. Das Schließen von speicherintensiven Anwendungen kann helfen, ändert aber nicht den grundlegenden Modell-Fußabdruck.
Schritt 4: Trennen Sie das Internet und überprüfen Sie, ob DeepSeek wirklich offline funktioniert
Dies ist der Schritt, der „lokales Modell“ von bloßem „Verwenden eines Desktop-Clients“ unterscheidet. Sobald das Modell und seine Runtime installiert sind, schalten Sie Wi-Fi aus und trennen Sie Ethernet. Starten Sie dann einen neuen Chat und senden Sie eine einfache Eingabeaufforderung wie:
Erklären Sie den Unterschied zwischen RAM und VRAM in fünf Stichpunkten.
Wenn das Modell antwortet, während der PC keine Netzwerkverbindung hat, ist die Inferenz lokal. LM Studio gibt an, dass ein LLM, sobald er auf Ihrem Rechner ist, vollständig offline ausgeführt werden kann und dass Text, der in lokale LLM-Chats eingegeben wird, Ihr Gerät nicht verlässt. Die Offline-Dokumentation besagt auch, dass die lokale Dokumentverarbeitung und RAG auf dem Rechner bleiben.
Ein geladenes DeepSeek-Modell, das in LM Studio Chat antwortet. Um den Offline-Betrieb selbst zu überprüfen, trennen Sie den Netzwerkzugriff, nachdem das Modell und die Runtime vollständig heruntergeladen sind, und wiederholen Sie eine einfache Eingabeaufforderung.
Es gibt eine wichtige Grenze: Das Suchen nach Modellen, das Herunterladen neuer Modelle, das Herunterladen von Runtimes und das Prüfen auf App-Updates erfordern Internetzugang. Wenn Sie später Cloud-Modelle, Remote-MCP-Server, Web-Tools oder andere Netzwerkintegrationen hinzufügen, erfordern diese Funktionen möglicherweise ebenfalls Konnektivität. Offline-Datenschutzbehauptungen gelten für den lokalen Arbeitsablauf, nicht für Dienste, die Sie anschließend absichtlich verbinden.
Schritt 5: Optional – Verwenden Sie DeepSeek über eine lokale API
Wenn eine andere Windows-Anwendung, ein Skript, eine IDE-Erweiterung oder ein internes Tool Ihr lokales DeepSeek-Modell aufrufen soll, kann LM Studio einen lokalen Server ausführen. Die aktuelle Entwicklerdokumentation besagt, dass Sie ihn von der Entwicklerseite aus oder mit:
lms server start
Standardmäßig ist der Server unter http://localhost:1234 verfügbar. LM Studio bietet native REST-Endpunkte und OpenAI-kompatible Endpunkte. Der Server selbst kann offline arbeiten, solange das Modell und die Runtime bereits lokal sind. Wenn Sie den Server jedoch über localhost hinaus freigeben, überprüfen Sie zuerst die Authentifizierungs- und Netzwerkzugriffseinstellungen.
Nicht genug RAM/VRAM, überdimensionierter Kontext oder nicht unterstützte CPU/Runtime
Versuchen Sie ein kleineres DeepSeek-Modell, eine kleinere Quantisierung oder eine geringere Kontextlänge. Bestätigen Sie auf x64 Windows die AVX2-Unterstützung.
LM Studio funktioniert online, aber nicht nach dem Trennen
Das Modell oder die erforderliche Runtime wurde nicht vollständig heruntergeladen
Verbinden Sie sich einmal neu, schließen Sie alle Modell-/Runtime-Downloads ab, laden Sie das Modell erfolgreich und wiederholen Sie dann den Offline-Test.
Die Generierung ist sehr langsam
Das Modell ist zu groß für die verfügbare GPU-Beschleunigung und verlässt sich stark auf CPU/Systemspeicher
Wählen Sie ein kleineres Modell oder eine kleinere Quantisierung. Ein größeres Modell ist nicht nützlich, wenn die Latenz den Arbeitsablauf unpraktisch macht.
Sie können offline kein Modell finden
Die Discover-Suche benötigt Netzwerkzugriff
Laden Sie Modelle herunter, bevor Sie offline gehen, oder laden Sie eine Modelldatei über einen anderen kontrollierten Prozess nachträglich hoch.
Sie erwarteten, dass V4 Flash auf einem normalen Laptop läuft
Der lokale Speicherbedarf ist auf Workstation-Niveau
Verwenden Sie stattdessen ein R1-distilliertes Modell, es sei denn, Ihr Rechner hat ungefähr 156 GB oder mehr Systemspeicher.
Wann diese Einrichtung gut passt
Das Ausführen von DeepSeek offline mit LM Studio ist eine starke Wahl, wenn Sie private lokale Inferenz, vorhersehbare Kosten nach dem Herunterladen des Modells, Experimentieren ohne API-Schlüssel oder eine localhost-API für die Entwicklung wünschen. Es ist auch nützlich, wenn Ihr Rechner ohne Internetzugang weiterarbeiten muss.
Es ist eine schwächere Wahl, wenn Sie das stärkste verfügbare DeepSeek-Modell benötigen, aber nur Consumer-Hardware haben, wenn Sie extrem hohen Durchsatz benötigen oder wenn Ihre Arbeitslast von Live-Web-Informationen abhängt. Lokale Modelle wissen nur, was in ihren Gewichten und dem von Ihnen bereitgestellten Kontext enthalten ist, es sei denn, Sie verbinden absichtlich externe Tools oder Datenquellen.
Schnelle Checkliste
Verwenden Sie ein Windows 11-System, das die Anforderungen von LM Studio erfüllt; x64-CPUs benötigen AVX2.
Halten Sie den Internetzugang für die anfänglichen LM Studio-, Runtime- und Modell-Downloads aktiv.
Beginnen Sie mit einem kleineren DeepSeek GGUF-Modell, insbesondere einem distillierten Modell der 8B-Klasse.
Wählen Sie eine Quantisierung von 4 Bit oder höher, wenn Ihre Hardware dies unterstützen kann.
Laden Sie das Modell erfolgreich, bevor Sie das Netzwerk trennen.
Schalten Sie Wi-Fi/Ethernet aus und führen Sie eine neue Eingabeaufforderung aus, um die Offline-Inferenz zu überprüfen.
Reduzieren Sie die Modellgröße oder Kontextlänge, wenn Sie auf Speicherfehler stoßen.
Verwenden Sie den localhost-Server von LM Studio nur, wenn Sie lokalen API-Zugriff benötigen.
Fazit
Der einfachste Weg, DeepSeek offline unter Windows 11 auszuführen, besteht darin, LM Studio mit einem kleineren GGUF-DeepSeek-Modell zu kombinieren, das tatsächlich zu Ihrer Hardware passt. Für einen normalen PC ist ein distilliertes R1-Modell der 8B-Klasse ein weitaus realistischerer Ausgangspunkt als DeepSeek V4 Flash. Schließen Sie die Downloads online ab, laden Sie das Modell, trennen Sie das Netzwerk und überprüfen Sie, ob ein neuer Chat weiterhin antwortet. Sobald dies funktioniert, haben Sie eine wirklich lokale DeepSeek-Einrichtung und keinen Desktop-Wrapper um eine Cloud-API.