Startseite
» Domänen
»
Wie man verhindert, dass CrewAI-Agenten redundante Aufgaben ausführen: Ein praktischer Leitfaden zur Deduplizierung
Wie man verhindert, dass CrewAI-Agenten redundante Aufgaben ausführen: Ein praktischer Leitfaden zur Deduplizierung
Wenn CrewAI-Agenten dieselbe Aufgabe scheinbar zweimal ausführen, liegt die Ursache in der Regel nicht in einer einzelnen Einstellung für doppelte Aufgaben. Wiederholungen können durch sich überschneidende Aufgabenbeschreibungen, hierarchische Delegierung, Wiederholungsverhalten, mehrere Flow-Trigger, wiederholte Crew-Starts oder Tools mit Nebenwirkungen entstehen, die nicht durch einen Idempotenzschlüssel geschützt sind.
Diese praktische Anleitung wurde am 13. September 2026 anhand der offiziellen CrewAI-Dokumentation überprüft. Die aktuelle Dokumentation bezieht sich auf CrewAI Version 1.15.14. Der wichtigste Unterschied ist folgender: Redundante Schlussfolgerungen innerhalb eines Durchlaufs zu vermeiden, ist etwas anderes, als zu verhindern, dass dieselbe Geschäftsaktion zweimal in verschiedenen Durchläufen ausgeführt wird . CrewAI bietet Aufgabenkontext, bedingte Aufgaben, Rückruffunktionen, Flow-Status, Persistenz und Tool-Caching. Dennoch müssen Sie explizite Überspringbedingungen für Arbeiten definieren, die nur einmal ausgeführt werden dürfen.
Kurzdiagnose: Warum wird die gleiche Arbeit zweimal ausgeführt?
Symptom
Wahrscheinliche Ursache
Erster Lösungsansatz
Zwei Agenten recherchieren zum selben Thema.
Überschneidende Rollen oder Aufgabenbeschreibungen
Weisen Sie jeder Aufgabe einen Verantwortlichen zu und leiten Sie die vorherige Ausgabe weiter.context
Ein Manager verlangt Arbeit, die ein anderer Mitarbeiter bereits erledigt hat.
Hierarchische Delegation und unklare Verantwortlichkeiten
Anweisungen für Manager, Rollen der Agenten und Zuständigkeiten für Tools klären.
Die gleiche Aufgabe wird nach einem Validierungsfehler mehrmals ausgeführt.
Schutzplanken-Wiederholungen
Überprüfen Sie den Schutzplankenfehler und reduzieren Sie ihn guardrail_max_retrieswährend des Debuggens.
Ein Agent ruft wiederholt dasselbe Tool auf.
Hohes Iterationsbudget, schwache Abbruchbedingung oder Wiederholungsversuche bei Tool-Aufrufen
Reduzieren Sie max_iterdie erwartete Ausgabe, passen Sie sie an und überprüfen Sie die Schrittprotokolle.
Eine Flow-Methode wird mehr als einmal ausgelöst.
Mehrere @start()Methoden oder mehrere vorgelagerte Ereignisse
Verwenden Sie einen einzigen Einstiegspunkt, einen Router, Statusflags oder and_gegebenenfalls andere geeignete Methoden.
Eine E-Mail-/Zahlungs-/API-Mutation tritt nach dem Neustart zweimal auf.
Keine Cross-Run-Idempotenz-Schutzfunktion
Verwenden Sie einen deterministischen Operationsschlüssel in persistentem oder externem Transaktionsspeicher.
Sie haben den Speicher aktiviert, aber die Aufgaben werden trotzdem erneut ausgeführt.
Der Speicher liefert Kontext; er ist kein Deduplizierer auf Scheduler-Ebene.
Erfassen Sie die erledigten Arbeiten explizit, anstatt sich auf das Erinnerungsvermögen zu verlassen.
Sie haben den Cache aktiviert, aber der gesamte Vorgang wird erneut ausgeführt.
Der CrewAI-Cache ist für die Ausführungsergebnisse des Tools dokumentiert.
Fügen Sie eine Skip-Logik auf Aufgabenebene oder einen Idempotenzspeicher hinzu.
1. Beginnen Sie mit einem Eigentümer pro Arbeitseinheit.
Die einfachste Regel gegen Duplikate ist gleichzeitig die effektivste: Jede sinnvolle Arbeitseinheit sollte genau einen Verantwortlichen haben. In einem sequenziellen CrewAI-Prozess werden Aufgaben in der Reihenfolge ihrer Deklaration ausgeführt. Das contextAttribut ermöglicht es einer nachfolgenden Aufgabe, die Ausgabe einer vorherigen Aufgabe zu nutzen, anstatt dieselben Informationen unabhängig voneinander erneut zu ermitteln.
Die Aufteilung der Zuständigkeiten ist leichter nachzuvollziehen: Eine Aufgabe führt Recherchen durch, die nächste Aufgabe analysiert die Rechercheergebnisse, anstatt sie zu wiederholen.
Ein typisches Anti-Pattern sieht konzeptionell folgendermaßen aus:
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
Alle drei Aufgaben beinhalten die Erlaubnis zur Recherche, daher ist eine wiederholte Suche vorhersehbar. Eine kürzere Suchkette ist vorzuziehen:
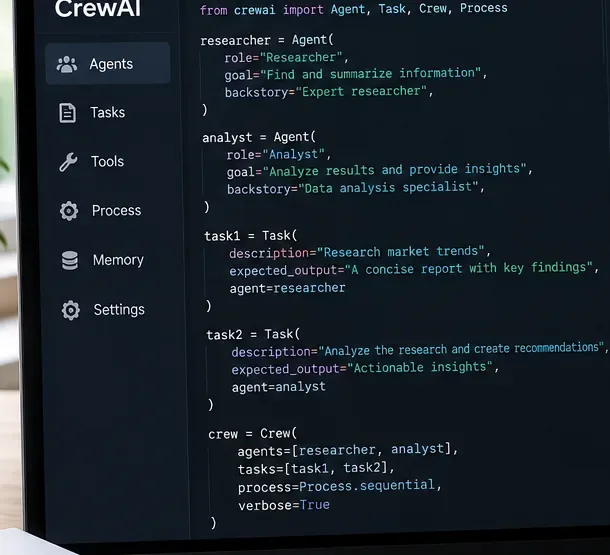
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
Weisen Sie jeder Aufgabe ein anderes Verb zu: recherchieren, normalisieren, analysieren, schreiben, überprüfen.
Beschreiben Sie, was die Aufgabe nicht tun darf, wenn Überschneidungen teuer sind.
Gestalten Sie das erwartete Ergebnis so konkret, dass die nächste Aufgabe es direkt verarbeiten kann.
Die bisherigen Ergebnisse sollten weitergegeben werden, contextanstatt späteren Agenten zu sagen, sie sollten „bei Bedarf recherchieren“.
Beschränken Sie die Tools auf Aufgaben- oder Agentenebene, wenn nur eine Rolle das Suchen, Schreiben in eine Datenbank, Senden von Nachrichten oder Aufrufen einer externen API erlauben soll.
2. Überspringen Sie Aufgaben, die bereits mit ConditionalTask erledigt wurden.
Wenn eine Aufgabe nur dann benötigt wird, wenn ein vorheriges Ergebnis unvollständig ist, sollte der Agent nicht informell entscheiden müssen, ob die Arbeit wiederholt werden soll. CrewAI bietet eine ConditionalTaskFunktion, deren Bedingung die Ausgabe der vorherigen Aufgabe empfängt und die die Ausführung überspringen kann, wenn die Bedingung nicht erfüllt ist.
Das offizielle Beispiel verwendet eine Bedingung, die prüft, ob genügend Ereignisdatensätze zurückgegeben wurden; sind bereits genügend Daten vorhanden, wird der zusätzliche Abruf übersprungen. Siehe CrewAI Bedingte Aufgaben .
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
Dieses Muster ist aussagekräftiger als die Aufforderung an einen Agenten, doppelte Arbeit zu vermeiden, da die Entscheidung zum Überspringen auf deterministischer Python-Logik beruht und nicht auf einem anderen Sprachmodellurteil.
3. Erkennen, wann eine Delegation scheinbare Doppelarbeit erzeugt.
CrewAI unterstützt sowohl sequentielle als auch hierarchische Prozesse. In einem hierarchischen Team teilt ein Manager Aufgaben zu, delegiert Arbeit, prüft die Ergebnisse und entscheidet über die zufriedenstellende Aufgabenerfüllung. Diese Flexibilität ist nützlich, wenn die Arbeitsverteilung dynamisch erfolgen muss, bedeutet aber auch, dass die Verantwortlichkeiten weniger eindeutig sind als in einem sequentiellen Team.
Die Agentendokumentation von CrewAI gibt derzeit an, dass der allow_delegationStandardwert „“ ist False. Behalten Sie diesen Standardwert für Spezialisten bei, es sei denn, ein Agent muss Aufgaben unbedingt an einen anderen Agenten delegieren. In einem hierarchischen Prozess ist der Manager selbst für die Delegation verantwortlich. Siehe den Leitfaden zum hierarchischen Prozess .
Ein sicherer Ausgangspunkt für ein Team, das redundante Anrufe tätigt, ist:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)
Fügen Sie die Delegierung nur dann wieder hinzu, wenn sie einen messbaren Nutzen bringt. Wenn keine hierarchische Orchestrierung erforderlich ist, Process.sequentiallässt sich das Problem leichter beheben, da Aufgabenreihenfolge und Zuständigkeit explizit festgelegt sind.
4. Verwechseln Sie Wiederholungsversuche nicht mit doppelter Terminplanung.
Bei wiederholten Arbeitsvorgängen ist ein entsprechendes Wiederholungsverhalten zu erwarten. Die CrewAI-Aufgabenschutzmechanismen können die Ausgabe validieren und bei einem Validierungsfehler eine Rückmeldung an den Agenten senden. Laut der aktuellen Aufgabendokumentation ist guardrail_max_retriesder Standardwert auf 3 gesetzt, und ein fehlgeschlagener Schutzmechanismus wiederholt die Aufgabe bis zu diesem Limit.
Agenten geben außerdem Auskunft max_retry_limitüber mögliche Ausführungsfehler und max_iterdie maximale Anzahl an Agenteniterationen, bevor die bestmögliche Antwort ermittelt wird. Die aktuelle Agentendokumentation nennt einen Standardwert max_itervon 20 und ein Standardlimit für Fehlerwiederholungen von 2.
Diese Mechanismen lösen unterschiedliche Probleme:
Einstellung
Was es einschränkt
Warum es redundant wirken kann
guardrail_max_retries
Wiederholungsversuche nach Fehlschlagen der Aufgabenausgabevalidierung
Dieselbe Aufgabe wird absichtlich mit Schutzmaßnahmen erneut ausgeführt.
max_retry_limit
Wiederholungsversuche nach Ausführungsfehlern
Bei einem fehlgeschlagenen Versuch kann ein Tool-Aufruf wiederholt werden.
max_iter
Agentenlogik/Tool-Iterationen
Ein unsicherer Agent kann mehrere ähnliche Tool-Aufrufe durchführen, bevor er fertig ist.
Reduzieren Sie diese Grenzwerte während der Fehlersuche vorübergehend. Falls die Wiederholungen verschwinden, untersuchen Sie, warum die Validierung fehlgeschlagen ist oder warum der Agent eine weitere Tool-Iteration für notwendig hielt. Setzen Sie in der Produktionsumgebung nicht einfach alle Wiederholungswerte auf null; Wiederholungen können bei vorübergehenden Fehlern sinnvoll sein.
5. Verfolgen Sie, was tatsächlich ausgeführt wurde, bevor Sie die Eingabeaufforderungen überschreiben.
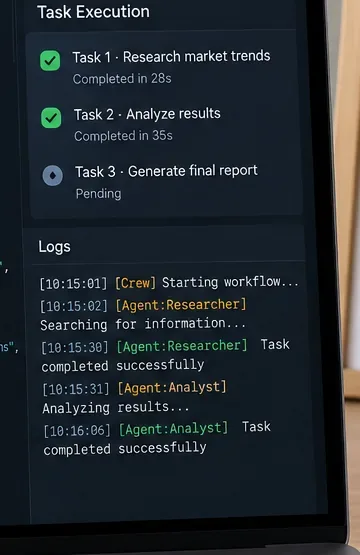
Ausführungsprotokolle helfen dabei, einen echten zweiten Aufgabenlauf von mehreren Schritten, Wiederholungsversuchen oder Toolaufrufen innerhalb einer Aufgabe zu unterscheiden.
CrewAI stellt verschiedene Möglichkeiten zur Beobachtung bereit. Auf Crew-Ebene umfasst die aktuelle Dokumentation die Steuerelemente `observability` verbose, step_callback`debug` task_callback, `debug` output_log_fileund `debug` sowie die Tracing-Steuerung. Agenten unterstützen ebenfalls `debug` step_callback. Diese Funktionen sind hilfreich, um vier Fragen zu beantworten:
Hat der Scheduler dieselbe Aufgabe zweimal gestartet?
Hat ein Agent innerhalb einer Aufgabe mehrere Iterationen durchgeführt?
Hat eine Schutzbarriere die Ausgabe zurückgewiesen und einen Wiederholungsversuch ausgelöst?
Wurde ein Toolaufruf wiederholt, obwohl die Aufgabe selbst nur einmal ausgeführt wurde?
Aktivieren Sie für einen ersten Diagnoselauf die ausführliche Ausgabe und die Erstellung einer JSON-Protokolldatei:
Anschließend können Sie Rückruffunktionen hinzufügen, falls Sie strukturierte Zähler oder benutzerdefinierte Telemetriedaten benötigen. Weitere Informationen finden Sie in der Dokumentation zu den Crew-Attributen von CrewAI .
6. Doppelte Flow-Trigger verhindern
Flows führen zu einer weiteren Art von Wiederholung. Die aktuelle Flow-Dokumentation von CrewAI besagt, dass alle erfüllten @start()Methoden beim Start oder der Fortsetzung des Flows ausgeführt werden. Wenn Sie mehrere unbedingte Starts definieren und zwei davon schließlich dieselbe Crew starten, entsteht die Duplikation im Ablaufdiagramm, nicht innerhalb der Crew.
Ebenso or_können Listener ausgeführt werden, sobald eine vorgelagerte Methode eine Ausgabe erzeugt. Das Beispiel von CrewAI zeigt, dass der Listener bei jeder Ausgabe einer vorgelagerten Methode einmal ausgelöst wird. Verwenden Sie Listener, and_wenn die nachgelagerte Operation warten soll, bis alle Voraussetzungen erfüllt sind, oder @router()wenn genau ein Zweig ausgeführt werden soll.
Bevor Sie einen zweiten Einstiegspunkt hinzufügen @start(), prüfen Sie, ob dieser tatsächlich einen unabhängigen Einstiegspunkt darstellt. Falls nicht, verwenden Sie eine Startmethode und explizite Listener.
7. Fügen Sie einen Abschluss-Key für die Cross-Run-Idempotenz hinzu.
Dies ist das wichtigste Produktionsmuster, wenn eine Aufgabe einen externen Nebeneffekt auslöst, wie z. B. das Versenden einer E-Mail, das Belasten einer Zahlungsmethode, das Erstellen eines CRM-Datensatzes, das Veröffentlichen einer Nachricht oder das Starten eines Auftrags.
CrewAI Flows unterstützen strukturierten Zustand und den @persistDecorator. Dank Persistenz kann ein Flow seinen Zustand nach einem Neustart wiederherstellen. Der persistente Zustand allein entscheidet jedoch nicht darüber, ob eine Geschäftsaktion übersprungen werden soll. Speichern Sie daher Ihren eigenen deterministischen Operationsschlüssel und prüfen Sie diesen, bevor Sie die Nebenwirkung ausführen.
Persistenz und Speicher sind nützliche Bausteine, aber ein Produktionsworkflow benötigt dennoch eine explizite „Bereits abgeschlossen?“-Regel für Aktionen, die nur einmal ausgeführt werden müssen.
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
CrewAI-Dokumente @persistkönnen den Flow-Status über Neustarts hinweg speichern, und beim Fortsetzen mit derselben Status-ID wird der letzte Snapshot neu geladen. Siehe CrewAI-Dokumentation zur Flow-Persistenz .
Wichtiger Hinweis für die Produktion: Das obige Beispiel eignet sich zwar für die übliche Workflow-Deduplizierung, reicht aber nicht aus, um finanziell oder rechtlich kritische Nebeneffekte abzufangen. Ein Prozess kann abstürzen, nachdem die externe Aktion erfolgreich war, aber bevor der Abschlussschlüssel gespeichert wurde. Um ein exakt einmalig lesbares Verhalten zu gewährleisten, verwenden Sie einen externen Transaktionsspeicher oder den Idempotenzschlüssel der Ziel-API und protokollieren Sie die Operation nach Möglichkeit atomar.
8. Wiederholte Tool-Aufrufe zwischenspeichern, aber Zwischenspeicherung nicht mit Aufgabenidempotenz verwechseln.
CrewAI-Agenten und -Crews legen cachedie Ergebnisse der Tool-Ausführung zwischen, und die offizielle Dokumentation beschreibt dies als Zwischenspeicherung. Die aktuelle Agentendokumentation zeigt, dass die Zwischenspeicherung standardmäßig aktiviert ist, und die Leistungshinweise empfehlen, sie bei wiederholter Tool-Nutzung aktiviert zu lassen.
Das ist hilfreich, wenn ein Agent dieselbe aufwändige Suche oder denselben deterministischen Toolaufruf mehrfach durchführt. Das bedeutet jedoch nicht , dass crew.kickoff()die Aufgaben des Teams automatisch übersprungen werden, wenn der Aufruf zweimal erfolgt. Die Aufgabe gehört weiterhin zum Ausführungsgraphen.
Verwenden Sie den Cache für wiederholte Lesevorgänge. Verwenden Sie einen Idempotenzschlüssel für wiederholte Schreibvorgänge.
Betrieb
Bevorzugter Schutz
Durchsuchen Sie die gleiche Dokumentation
Werkzeugcache
Vorwissen aufgabenübergreifend wiederverwenden
Gedächtnis- oder Aufgabenkontext
Eine optionale Aufgabe kann übersprungen werden, wenn bereits genügend Daten vorhanden sind.
ConditionalTask
Verhindern, dass ein Flow-Zweig fälschlicherweise ausgelöst wird
Router-, Zustands- and_oder Graph-Neugestaltung
Verhindern Sie doppelte externe Schreibvorgänge bei Wiederholungsversuchen/Neustarts.
Persistenter Idempotenzschlüssel oder externer Transaktionsspeicher
9. Das Gedächtnis reduziert wiederholte Entdeckungen, hebt aber keine Aufgaben auf.
Das einheitliche Speichersystem von CrewAI speichert Fakten nach Aufgaben und ruft relevanten Kontext vor Aufgaben ab. Laut der aktuellen Dokumentation werden bei aktiviertem Crew-Speicher einzelne Fakten aus den Aufgabenausgaben extrahiert und relevante Erinnerungen in spätere Aufgabenaufforderungen eingefügt.
Das kann unnötige Wiederentdeckungen reduzieren, insbesondere wenn ein Autor wissen sollte, was ein Forscher bereits herausgefunden hat. Der Speicher dient jedoch als Abrufkontext und ist kein Überspringen-Flag. Eine explizit geplante Aufgabe wird weiterhin ausgeführt, sofern Ihre Crew- oder Flow-Logik nichts anderes festlegt.
Verwenden Sie den Speicher für die Frage „Was wissen wir bereits?“. Verwenden Sie den Zustand oder eine bedingte Aufgabe für die Frage „Soll diese Operation ausgeführt werden?“. Siehe CrewAI Memory .
10. Verwenden Sie strukturierte Ausgaben, um Überspringentscheidungen zuverlässig zu gestalten.
Die Ausgabe in natürlicher Sprache ist für die deterministische Workflow-Steuerung schwer zu handhaben. CrewAI-Aufgaben können über `pydantic` und `json` Ausgaben im Pydantic- oder JSON-Format zurückgeben output_pydantic. output_jsonEin strukturiertes Ergebnis ermöglicht es, unkompliziert zu entscheiden, ob eine Anreicherung, Überprüfung, Eskalation oder eine andere Aufgabe erforderlich ist.
Leiten Sie die Anfragen dann anhand der Felder weiter, anstatt einen anderen Agenten einen Prosatext interpretieren zu lassen. Dies reduziert in der Regel sowohl Doppelarbeit als auch Unklarheiten in den Anfragen.
Empfohlene Antiredundanzkonfiguration
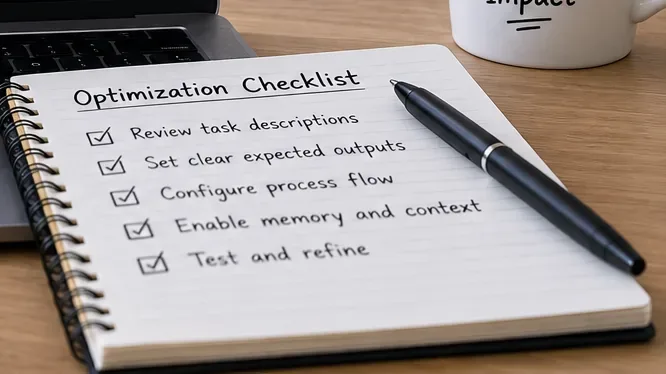
Eine kompakte Checkliste zur Überprüfung ist hilfreich, bevor die Modellkomplexität erhöht wird: Die meisten Redundanzprobleme lassen sich leichter lösen, indem man zunächst die Aufgabengestaltung und den Kontrollfluss optimiert.
Bei einem typischen Recherche-zu-Bericht-Prozess sollte man konservativ vorgehen:
Füge die Komplexität erst dann hinzu, wenn eine Anforderung dies erfordert:
Fügen Sie Speicherplatz hinzu , wenn Fakten aufgaben- oder laufübergreifend wiederverwendet werden sollen.
Fügen Sie eine ConditionalTask hinzu , wenn eine Aufgabe nur dann ausgeführt werden soll, wenn die vorherige Ausgabe unvollständig ist.
Nutzen Sie einen hierarchischen Prozess, wenn eine dynamische Managerzuweisung wirklich erforderlich ist.
Die Delegierung sollte nur für Agenten aktiviert werden , die Aufgaben an Kollegen weitergeben müssen.
Es werden Schutzmechanismen für die Ausgabequalität hinzugefügt , wobei in Kauf genommen wird, dass ein Fehlschlagen eines Schutzmechanismus absichtlich Wiederholungsversuche auslöst.
Fügen Sie Flow-Persistenz hinzu , wenn der Zustand Neustarts überstehen muss.
Fügen Sie eine externe Idempotenzschicht hinzu , wenn doppelte Nebenwirkungen inakzeptabel sind.
Abschließende Checkliste zur Fehlerbehebung
Ist derselbe TaskEintrag zweimal in der Aufgabenliste der Besatzung aufgeführt?
Berechtigen zwei Aufgabenbeschreibungen zur gleichen Recherche oder zum gleichen Tool-Aufruf?
Kann eine spätere Aufgabe die frühere Aufgabe contextstattdessen verbrauchen?
Sollte die wiederholte Aufgabe ein ? sein ConditionalTask?
Nutzen Sie hierarchische Orchestrierung, obwohl sequentielle Orchestrierung ausreichend wäre?
Ist es allow_delegationauf Agenten aktiviert, die es nicht benötigen?
Führt eine Ablehnung durch die Schutzbarriere zu einem erneuten Versuch?
Ist max_iterder Umfang groß genug, dass eine Aufgabe viele ähnliche Werkzeugaufrufe ausführt?
Werden von mehreren @start()Methoden oder or_Zuhörern dieselben nachgelagerten Teams ausgelöst?
Stellt die zweite Eingabe kickoff()einen beabsichtigten neuen Aufruf oder einen versehentlichen doppelten Aufruf dar?
Verwenden Sie Arbeitsspeicher oder Cache so, als ob es sich um Idempotenzkontrollen auf Aufgabenebene handeln würde?
Besitzen externe Schreibvorgänge einen deterministischen Idempotenzschlüssel?
Können Protokolle beweisen, ob das Duplikat auf Aufgaben-, Agentenschritt-, Tool- oder Flow-Ebene aufgetreten ist?
Fazit
Das Vermeiden redundanter CrewAI-Arbeit ist hauptsächlich ein Orchestrierungsproblem. Machen Sie die Zuständigkeiten explizit, verketten Sie Aufgaben context, überspringen Sie bedingt bereits erledigte Arbeit, halten Sie die Delegation eng, erkennen Sie, wann Wiederholungsversuche beabsichtigt sind, und verfolgen Sie die Ausführung, bevor Sie Eingabeaufforderungen ändern. Für Flows und Produktionsnebenwirkungen gehen Sie noch einen Schritt weiter: Speichern Sie einen deterministischen Abschlussschlüssel oder verwenden Sie einen externen Idempotenzmechanismus.
Das hilfreiche mentale Modell ist einfach: Kontext verhindert erneutes Entdecken, Bedingungen verhindern unnötige Aufgaben, Cache verhindert wiederholte Werkzeugberechnungen und Idempotenz verhindert wiederholte Nebenwirkungen . Sie lösen verwandte Probleme, sind aber nicht austauschbar.