Eine Reduzierung der LLM-API-Rechnung um 50 % ist bei vielen Workloads möglich, stellt jedoch keine universelle Garantie dar. Das Ergebnis hängt davon ab, woher Ihre Ausgaben stammen: nicht gecachte Eingabe-Tokens, gecachte Eingabe-Tokens, Ausgabe-Tokens, Reasoning-Tokens, Tool-Aufrufe oder Wiederholungsversuche. Die Prompt-Komprimierung funktioniert am besten, wenn lange oder sich wiederholende Eingaben einen erheblichen Anteil der Rechnung ausmachen. Das praktische Ziel ist daher nicht, „jeden Prompt halb so lang zu machen“. Es lautet: „Entfernen Sie Tokens, die die Antwort nicht verändern, bewahren Sie die Tokens, die dies tun, und überprüfen Sie die Einsparungen bei echtem Traffic.“
Dieser Leitfaden verwendet vier Implementierungsschritte: Messen der Baseline, Entfernen redundanter Eingaben, Organisieren von Prompts für die Cache-Wiederverwendung und Verschieben ausführlicher Ausgabe-Anweisungen in strukturierte Steuerungen, sofern die API diese unterstützt. Die Beispiele sind illustrativ und keine Benchmark-Aussagen. Anbieterpreise und Cache-Verhalten ändern sich im Laufe der Zeit, daher sollten Sie die aktuellen Tarife überprüfen, bevor Sie eine Produktions-Schätzung vornehmen.
Was erfordert eine tatsächliche Reduzierung der API-Kosten um 50 %?
Beginnen Sie mit der Abrechnungsgleichung für Ihr Modell. Für einen einfachen Text-Workload entsprechen die gesamten Anfragekosten ungefähr den Kosten für nicht gecachte Eingaben plus gecachte Eingaben plus Ausgaben. Einige Modelle oder Funktionen fügen weitere abrechenbare Kategorien hinzu. Die aktuellen API-Antworten von OpenAI legen die Nutzung von Eingabe- und Ausgabe-Tokens offen, einschließlich Details zu gecachten Tokens, und die Modellseiten veröffentlichen separate Tarife für Eingaben, gecachte Eingaben und Ausgaben.
| Illustrativer Workload | Eingabe-Tokens | Ausgabe-Tokens | Relatives Ergebnis |
|---|
| Baseline-Anfrage | 10.000 | 1.000 | 100 % der Baseline-Kosten |
| Nur Eingabe wird halbiert | 5.000 | 1.000 | Weniger als 50 % Gesamteinsparung, wenn die Ausgabe unverändert bleibt |
| Eingabe und Ausgabe werden beide halbiert | 5.000 | 500 | Ungefähr 50 % niedrigere tokenbasierte Kosten, wenn die Tarife unverändert bleiben |
Für ein konkretes aktuelles Beispiel listete die offizielle GPT-5.6 Sol-Modellseite am 11. September 2026 4 $ pro Million Eingabe-Tokens, 0,40 $ pro Million gecachter Eingabe-Tokens und 20 $ pro Million Ausgabe-Tokens. Zu diesen Tarifen kostet eine Anfrage mit 10.000 Eingabe- und 1.000 Ausgabe-Tokens etwa 0,06 $ vor anderen Gebühren. Eine Reduzierung der Eingabe auf nur 5.000 Tokens bringt dieses Beispiel auf etwa 0,04 $, eine Reduzierung um 33 %. Eine Halbierung von Eingabe und Ausgabe bringt es auf etwa 0,03 $, eine Reduzierung um 50 %. Diese Preise können sich ändern, daher sollten Sie die Berechnung als Methode und nicht als dauerhaftes Angebot betrachten. Siehe die offizielle GPT-5.6 Sol-Modellseite für aktuelle Preise.
Schnellreferenz: Die vier wertvollsten Maßnahmen
| Technik | Beste Eignung | Haupt-Risiko | Was zu messen ist |
|---|
| Token-Audit | Jeder Produktions-Workload | Optimierung der falschen Komponente | Eingabe, gecachte Eingabe, Ausgabe, Wiederholungen, Kosten pro erfolgreicher Aufgabe |
| Entfernen von Redundanz | Lange System-Prompts, wiederholte Richtlinien, ausführliche Beispiele | Löschen einer Einschränkung, die tatsächlich wichtig ist | Aufgabenerfolg und Parität bei der Befolgung von Anweisungen |
| Cache-freundliches Layout | Wiederholte Anfragen mit stabilen Anweisungen oder Kontext | Geringe Cache-Wiederverwendung, weil dynamischer Text zu früh erscheint | Verhältnis gecachter Tokens und Latenz |
| Strukturierte Ausgabe-Steuerungen | JSON-Extraktion, Klassifizierung, feste Antwortformate | Schema zu starr für die Aufgabe | Ausgabe-Tokens, Parse-Fehler, Wiederholungen |
Schritt 1: Messen der echten Token-Baseline vor der Änderung von Prompts
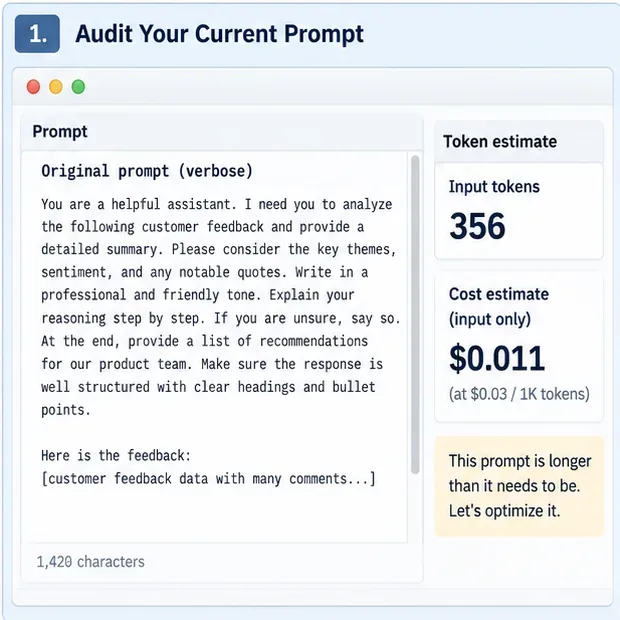
Bildunterschrift: Eine illustrative Token-Audit-Schnittstelle erfasst die ursprüngliche Prompt-Größe und eine Beispiel-Kostenschätzung vor der Komprimierung; die Zahlen sind keine aktuellen Anbieterpreise.
Erfassen Sie eine repräsentative Stichprobe von Produktionsanfragen, anstatt einen handverlesenen Prompt zu optimieren. Erfassen Sie mindestens Eingabe-Tokens, gecachte Eingabe-Tokens (falls verfügbar), Ausgabe-Tokens, Modellname, Latenz, Wiederholungen und ob die endgültige Antwort Ihre geschäftliche Qualitätsprüfung bestanden hat. Wenn Ihr Anbieter einen Endpunkt zur Zählung von Eingabe-Tokens anbietet, verwenden Sie diesen vor dem Senden von Anfragen, wenn Sie eine deterministische Budgetierung benötigen. OpenAI dokumentiert derzeit einen Endpunkt zur Zählung von Eingabe-Tokens in der offiziellen API-Referenz.
Berechnen Sie die Kosten pro erfolgreicher Aufgabe, nicht nur die Kosten pro API-Aufruf. Ein komprimierter Prompt, der mehr Wiederholungen verursacht, kann teurer sein, auch wenn jede Anfrage kürzer ist. Segmentieren Sie die Baseline auch nach Aufgabentyp: Zusammenfassung, Extraktion, RAG-Frage-Antwort, agentische Tool-Nutzung und lange Konversationen haben normalerweise unterschiedliche Token-Profile.
Schritt 2: Entfernen von Redundanz ohne Löschung entscheidungsrelevanter Informationen

Bildunterschrift: Ein illustratives Vorher-Nachher-Prompt behält die gleichen angeforderten Ausgaben bei, während wiederholte Formulierungen und unnötige Prozessanweisungen entfernt werden.
Der sicherste erste Komprimierungsdurchgang ist die semantische Deduplizierung. Löschen Sie wiederholte Rollenbeschreibungen, duplizierte Einschränkungen, höfliche Füllwörter, Erklärungen offensichtlicher Formatierungen und Beispiele, die dasselbe Muster mehr als einmal lehren. Fassen Sie überlappende Regeln zu einer einzigen Anweisung zusammen. Bevorzugen Sie einen präzisen Satz gegenüber mehreren Sätzen, die dieselbe Anforderung wiederholen.
Vorher
Sie sind ein hilfreicher Assistent, der ein Experte für Produktanalyse ist.
Ich brauche Sie, um das folgende Kundenfeedback zu analysieren und eine
detaillierte Zusammenfassung bereitzustellen. Bitte identifizieren Sie die
Hauptthemen, die Gesamtstimmung, bemerkenswerte Zitate und Empfehlungen
für unser Produktteam. Stellen Sie sicher, dass Ihre Antwort professionell,
klar, prägnant und gut strukturiert ist.
Nachher
Analysieren Sie das Kundenfeedback.
Geben Sie zurück: Hauptthemen, Gesamtstimmung, bemerkenswerte Zitate und
Produktempfehlungen.
Seien Sie prägnant und faktenbasiert.
Komprimieren Sie keine Ausnahmen, Policy-Grenzen, Domänendefinitionen, Tool-Sicherheitsregeln oder Nachweisanforderungen nur deshalb, weil sie lang sind. Diese sind oft wertvolle Tokens. Ein nützlicher Test ist die Frage: „Wenn ich diesen Satz entferne, kann sich die akzeptable Ausgabe ändern?“ Wenn ja, behalten Sie ihn, es sei denn, eine API-Steuerung oder ein Schema kann dasselbe Verhalten zuverlässiger durchsetzen.
Schritt 3: Stabile Inhalte zuerst und dynamische Inhalte zuletzt platzieren
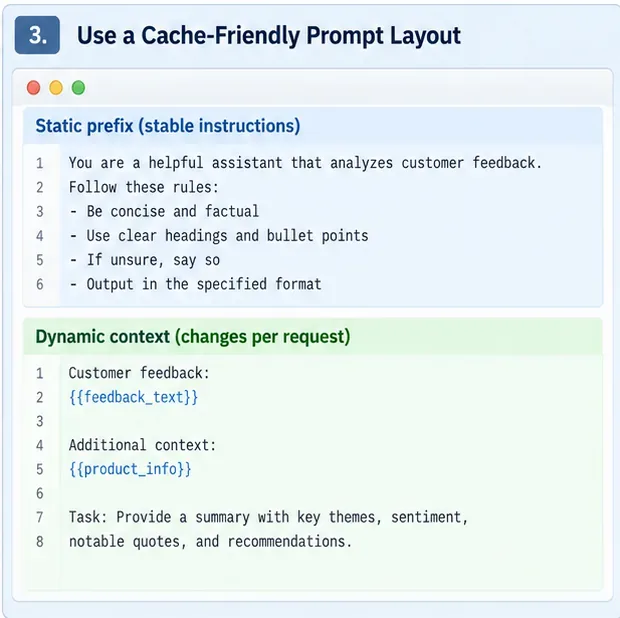
Bildunterschrift: Ein illustratives Prompt-Layout platziert stabile Anweisungen in einem wiederverwendbaren Präfix und fügt anfragespezifischen Kontext später hinzu.
Prompt-Caching reduziert nicht die Roh-Token-Anzahl, kann aber die Menge, die zum normalen Eingabetarif abgerechnet wird, reduzieren und die Prompt-Verarbeitungs-Latenz senken. Dies macht das Prompt-Layout zu einem Teil der Kostenoptimierung. Gruppieren Sie Systemanweisungen, gemeinsame Beispiele, Tool-Anleitungen und andere stabile Inhalte zusammen. Platzieren Sie anfragespezifische Fakten, abgerufene Passagen, Benutzerdaten und die aktuelle Frage später.
Die Modellrichtlinien von OpenAI empfehlen ausdrücklich, statische Inhalte zuerst und dynamische Inhalte zuletzt zu platzieren, um die Wiederverwendung des Prompt-Caches zu verbessern, und das Nutzungsobjekt der Antwort legt Informationen zu gecachten Tokens zur Messung offen. Siehe die offiziellen Modellrichtlinien und die Responses API-Referenz.
Vermeiden Sie es, harmlose Leerzeichen, Beispielreihenfolgen, Zeitstempel, zufällige IDs oder benutzerspezifischen Text innerhalb eines ansonsten wiederverwendbaren Präfixes zu ändern, es sei denn, die Cache-Semantik des Anbieters besagt, dass diese Änderungen sicher sind. Messen Sie Cache-Treffer aus der API-Antwort, anstatt anzunehmen, dass ein Prompt wiederverwendet wird.
Schritt 4: Ersetzen von Prosa über das Format durch strukturierte Ausgabe-Steuerungen
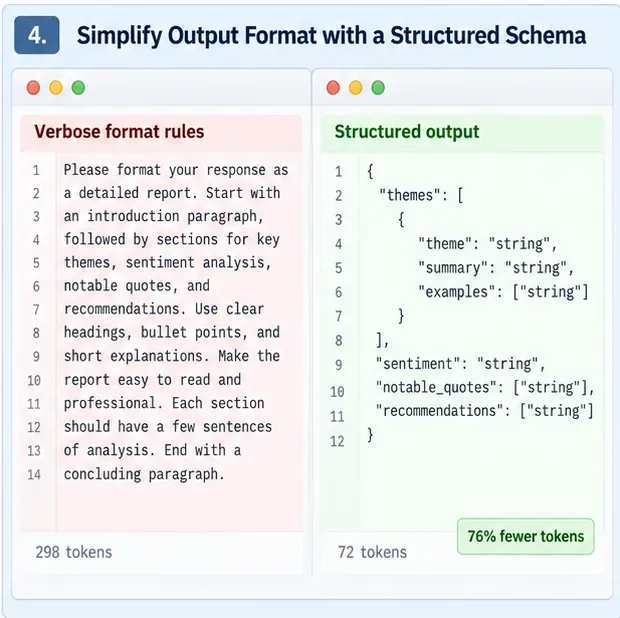
Bildunterschrift: Eine illustrative Ansicht für strukturierte Ausgaben zeigt, wie ein Schema viele Zeilen Prosa ersetzen kann, die wiederholt dieselbe Antwortform beschreiben.
Extraktions- und Klassifizierungs-Prompts verschwenden oft Tokens damit, JSON-Felder, erlaubte Werte, Verschachtelungen, Reihenfolgen und Validierungsregeln in natürlicher Sprache zu beschreiben. Wenn die API strukturierte Ausgaben oder typisierte Tool-Argumente unterstützt, verschieben Sie so viel dieses Vertrags wie möglich in die strukturierte Schnittstelle und konzentrieren Sie die Anweisung in natürlicher Sprache auf die Bedeutung.
Die aktuellen OpenAI-Richtlinien empfehlen ausdrücklich, Ausgabe-Schema-Definitionen aus dem Prompt zu entfernen, wo möglich, und stattdessen Structured Outputs zu verwenden. Dies kann den Prompt-Text reduzieren und auch Wiederholungen aufgrund fehlerhafter Ausgaben verringern. Der genaue Mechanismus variiert je nach Anbieter, daher sollten Sie ein OpenAI-spezifisches Anfrageformat nicht in eine andere API kopieren, ohne die Dokumentation dieses Anbieters zu prüfen.
Fortgeschrittene Komprimierung für RAG, lange Dokumente und Konversationen
Nachdem die vier grundlegenden Schritte stabil sind, stammen größere Einsparungen normalerweise aus der Reduzierung des Kontexts, anstatt die Satzformulierung zu polieren. In RAG-Systemen rufen Sie weniger, aber relevantere Passagen ab, deduplizieren nahezu identische Chunks und vermeiden das Anhängen von Dokumenten, die die Antwort nicht beeinflussen können. Für lange Konversationen behalten Sie dauerhafte Fakten und ungelöste Entscheidungen bei, fassen aber zusammen oder verwerfen Sie Wendungen, die die aktuelle Aufgabe nicht mehr beeinflussen. Für Agentensysteme exponieren Sie nur die Tools und Tool-Beschreibungen, die für die aktuelle Phase relevant sind, wenn Ihre Architektur dies sicher zulässt.
Gelernte Prompt-Kompressoren sind eine weitere Option für sehr lange Kontexte. Das Open-Source-Projekt LLMLingua von Microsoft implementiert die Prompt-Komprimierung auf Token-Ebene. Das ursprüngliche LLMLingua-Paper berichtete über Komprimierungsverhältnisse von bis zu 20× mit begrenzter Benchmark-Verschlechterung in den evaluierten Einstellungen. LongLLMLingua zielt auf Aufgaben mit langem Kontext ab, während LLMLingua-2 einen aufgabenunabhängigen gelernten Kompressor verwendet. Dies sind Forschungsergebnisse, kein Versprechen, dass dieselben Verhältnisse die Qualität auf Ihren Daten erhalten. Benchmarken Sie Ihre eigenen Aufgaben, Sprachen, Modelle und Prompt-Typen, bevor Sie aggressive Komprimierung bereitstellen.
Wie man beweist, dass die Optimierung tatsächlich besser ist
Führen Sie eine A/B-Evaluierung auf denselben repräsentativen Anfragen durch. Die Baseline- und komprimierten Versionen sollten dasselbe Modell, dieselben Reasoning-Einstellungen, Tools, Retrieval-Eingaben und Erfolgskriterien verwenden. Ändern Sie nach Möglichkeit jeweils nur eine Komprimierungstechnik, damit Sie identifizieren können, was eine Regression verursacht hat.
| Metrik | Warum sie wichtig ist | Vorgeschlagene Interpretation |
|---|
| Reduzierung der Eingabe-Tokens | Zeigt die Schrumpfung des Roh-Prompts | Nützlich, aber allein nicht ausreichend |
| Verhältnis gecachter Tokens | Zeigt, ob stabile Präfixe wiederverwendet werden | Höher ist normalerweise besser, wenn die Qualität unverändert bleibt |
| Reduzierung der Ausgabe-Tokens | Kann die Gesamtkosten wesentlich verändern | Überprüfen Sie, ob die prägnante Ausgabe die Aufgabe noch abschließt |
| Kosten pro erfolgreicher Aufgabe | Beinhaltet Wiederholungen und Fehler | Dies ist die primäre Geschäftsmetrik |
| Aufgabenerfolg / Genauigkeit | Erkennt Informationsverlust | Legen Sie vor dem Testen eine akzeptable Nicht-Unterlegenheits-Schwelle fest |
| p50- und p95-Latenz | Zeigt die tatsächliche Auswirkung auf den Benutzer | Die Vorverarbeitung der Komprimierung kann die Einsparungen bei der Inferenz aufheben |
Erklären Sie keinen Sieg, nur weil ein Prompt 50 % kürzer ist. Die stärkere Akzeptanzbedingung lautet: Die komprimierte Konfiguration reduziert die gemessenen Kosten um ungefähr Ihren Zielbetrag, während sie innerhalb Ihrer vordefinierten Toleranzen für Qualität, Latenz und Zuverlässigkeit bleibt.
Wann sollten Sie mit der Komprimierung aufhören?
Stoppen oder reduzieren Sie die Komprimierung, wenn die nächste Reduzierung Fakten entfernt, die für korrekte Entscheidungen erforderlich sind, Halluzinationen erhöht, Tool-Aufruf-Fehler verursacht, die Policy-Compliance schwächt oder die Wiederholungen so stark erhöht, dass die Einsparungen zunichte gemacht werden. Die Komprimierung kann auch die Latenz erhöhen, wenn Sie ein separates Modell ausführen, um jeden Prompt zu komprimieren. Eine Studie aus dem Jahr 2026 über Prompt-Komprimierung in realen Inferenzumgebungen ergab, dass der Vorverarbeitungsaufwand die Inferenzgewinne außerhalb günstiger Prompt-Längen- und Hardware-Regimes aufheben kann, was ein weiterer Grund ist, die End-to-End-Leistung zu messen, anstatt nur die Token-Anzahl.
Für kleine Prompts sind manuelle Bereinigung und cache-freundliche Organisation normalerweise leichter zu rechtfertigen als das Hinzufügen eines dedizierten Komprimierungsmodells. Für große RAG-Nutzlasten oder Multi-Dokument-Workflows werden die Kontextauswahl und gelernte Komprimierung attraktiver, da das entfernbare Token-Volumen viel größer ist.
Schnelle Implementierungs-Checkliste
- Erfassen Sie eine Produktions-Baseline mit Eingabe, gecachter Eingabe, Ausgabe, Latenz, Wiederholungen und Aufgabenerfolg.
- Entfernen Sie zuerst duplizierte Anweisungen, Prosa mit geringem Wert und redundante Beispiele.
- Bewahren Sie Domänendefinitionen, Ausnahmen, Nachweisanforderungen und Sicherheitsbeschränkungen bei.
- Platzieren Sie stabile Prompt-Inhalte vor dynamischen anfragespezifischen Inhalten, wenn die Cache-Semantik wiederverwendbare Präfixe belohnt.
- Verwenden Sie strukturierte Ausgaben oder Tool-Schemas, anstatt feste Antwortformate wiederholt in Prosa zu beschreiben.
- Reduzieren Sie bei RAG irrelevanten und doppelten Kontext, bevor Sie die Komprimierung auf Token-Ebene versuchen.
- Begrenzen Sie die Ausgabelänge nur, wenn die Aufgabe noch korrekt abgeschlossen werden kann.
- Vergleichen Sie die Kosten pro erfolgreicher Aufgabe, nicht nur die Anzahl der Prompt-Tokens.
- Führen Sie vor und nach jeder sinnvollen Komprimierungsänderung Regressionstests durch.
- Überprüfen Sie die Anbieterpreise und Cache-Regeln erneut, wann immer Sie Modelle oder API-Versionen ändern.
Fazit
Eine Reduzierung um 50 % ist ein vernünftiges Ingenieursziel für einige ausführliche, kontextlastige Workloads, sollte aber als ein Ergebnis behandelt werden, das validiert werden muss, und nicht als Standarderwartung. Der zuverlässigste Weg besteht darin, zuerst zu messen, semantisch redundanten Text zu entfernen, die sichere Cache-Wiederverwendung zu maximieren, Ausgabe-Verträge mit strukturierten Steuerungen zu verkürzen und dann die größten verbleibenden Kontextblöcke mit Retrieval-Pruning, Zusammenfassung oder einem getesteten Prompt-Kompressor anzugreifen. Wenn die endgültigen Kosten pro erfolgreicher Aufgabe sinken, während die Qualität innerhalb Ihres Akzeptanzbands bleibt, funktioniert die Komprimierung. Wenn sich die Qualität oder die Wiederholungen verschlechtern, stellen Sie die fehlenden Informationen wieder her und optimieren Sie einen anderen Teil der Anfrage.
Hauptreferenzen








