Ein gutes Ollama-Obsidian-Setup ist nicht einfach eines, bei dem ein Chat-Fenster Text zurückgibt. Für das persönliche Wissensmanagement ist der bessere Test, ob das System die von Ihnen vorgesehenen Notizen nutzen kann, Ihre Kontrolle über den Vault bewahrt, mit akzeptabler Geschwindigkeit antwortet und zugibt, wenn Ihre Notizen die Antwort nicht enthalten. Wenn diese Bedingungen nicht erfüllt sind, ist es nützlicher, das Modell, das Retrieval-Setup oder die Plugin-Konfiguration zu ändern, als Prompts immer wieder anzupassen.
Stand September 2026 wird die lokale API von Ollama standardmäßig weiterhin unter http://localhost:11434 bereitgestellt, mit API-Routen unter /api, und der lokale Zugriff erfordert keine Authentifizierung. Ollama bietet auch Einbettungen (Embeddings) für die semantische Suche und die Retrieval-Augmented Generation (RAG) an, was den Teil ausmacht, der die Beantwortung von Fragen zum gesamten Vault wesentlich vom gewöhnlichen Chat unterscheidet. Siehe die offizielle Ollama-API-Einführung, die Dokumentation zur lokalen Authentifizierung und die Dokumentation zu Einbettungen.
Dieser Leitfaden verwendet Copilot for Obsidian als Beispiel-Community-Plugin, da sein Projekt derzeit lokale Ollama-Modelle und vault-orientierte Workflows unterstützt. Der genaue Wortlaut der Einstellungen kann sich zwischen Plugin-Releases ändern, daher verwenden Sie das aktuelle Copilot for Obsidian Repository und dessen Einrichtungsleitfaden für lokale Modelle, falls eine Bezeichnung in Ihrer Installation von den Screenshots oder Schritten unten abweicht.
Was sollte ein erfolgreiches lokales PKM-Setup tatsächlich erreichen?
Definieren Sie das gewünschte Ergebnis, bevor Sie etwas installieren. Ein nützliches lokales Setup sollte vier praktische Tests bestehen:
- Verbindung: Obsidian kann ein Modell erreichen, das Ollama tatsächlich auf Ihrem Rechner bereitstellt.
- Verankerung (Grounding): Wenn Sie nach einer Notiz oder Ihrem Vault fragen, spiegelt die Antwort den relevanten Notizinhalt wider, anstatt sich nur auf das allgemeine Training des Modells zu verlassen.
- Leistung: Antwortzeiten und Speichernutzung sind akzeptabel genug, dass Sie den Workflow realistisch nutzen werden.
- Kontrolle: Sie wissen, welches Plugin Notizen lesen oder ändern kann, welchen Modell-Endpunkt es verwendet und ob optionale Web- oder Cloud-Funktionen aktiviert sind.
Diese Kriterien sind wichtig, weil „lokales Modell verbunden“ und „gutes persönliches Wissensmanagement“ nicht dasselbe sind. Der Chat kann perfekt funktionieren, während das Vault-Retrieval schwach ist, und ein starkes Modell kann immer noch schlechte Antworten liefern, wenn die falschen Notizen abgerufen werden.
Schritt 1: Ollama installieren, ein Modell abrufen und die lokale API überprüfen
Installieren Sie Ollama gemäß den offiziellen Anweisungen für Ihr Betriebssystem. Ollama unterstützt derzeit macOS, Windows und Linux; der offizielle Quickstart ist der sicherste Ausgangspunkt, da sich Installation und Modell-Empfehlungen im Laufe der Zeit ändern.
Rufen Sie ein Chat-Modell ab, bevor Sie Obsidian öffnen. Zum Beispiel:
ollama pull gemma3
ollama ls
Sie müssen nicht gemma3 verwenden. Der wichtige Teil ist, dass der Modellname, den Sie später in Obsidian eingeben, mit einem Modell übereinstimmen muss, das Ollama lokal auflisten kann. Beginnen Sie mit einem Modell, das Ihr Computer komfortabel ausführen kann, anstatt automatisch das größte verfügbare Modell auszuwählen.
Überprüfen Sie anschließend die API unabhängig von Obsidian:
curl http://localhost:11434/api/tags
Wenn dieser Befehl eine JSON-Liste zurückgibt, die Ihr Modell enthält, arbeitet der grundlegende Ollama-Dienst. Sie können auch ollama ps ausführen, während ein Modell aktiv ist. Ollama dokumentiert diesen Befehl als Möglichkeit zu sehen, ob ein Modell im CPU-Speicher, GPU-Speicher oder einer Mischung aus beiden geladen ist. Wenn Antworten schmerzhaft langsam sind oder der Rechner nicht mehr reagiert, ist das ein Signal, zu einem kleineren Modell zu wechseln oder die Kontextanforderungen zu reduzieren, anstatt anzunehmen, dass Obsidian das Problem ist.
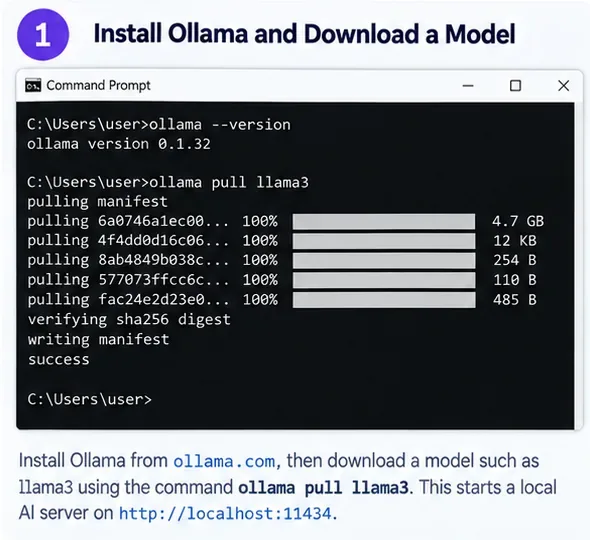
KI-generierte Illustration des Ollama-Installationsschritts und des Modellabrufs. Die im Bild gezeigten Versionsnummern und Details zum Modell-Download sind illustrativ und kein aktueller Release-Datensatz.
Schritt 2: Das Obsidian-Plugin installieren und sein Chat-Modell mit Ollama verbinden
Obsidian betrachtet Community-Plugins als Code von Drittanbietern. Die offizielle Dokumentation warnt, dass diese Plugins Code in Ihrem Auftrag ausführen, daher sollten Sie den Plugin-Quellcode und die Berechtigungen überprüfen, wenn Ihr Vault sensible Materialien enthält. Um eines zu installieren, öffnen Sie Einstellungen → Community-Plugins, aktivieren Sie Community-Plugins falls erforderlich, wählen Sie Durchsuchen, installieren Sie dann das Plugin und aktivieren Sie es. Der genaue Prozess ist auf der offiziellen Hilfe-Seite für Community-Plugins von Obsidian dokumentiert.
Installieren Sie für diesen Leitfaden Copilot aus dem Community-Verzeichnis und stellen Sie sicher, dass das Plugin auf das oben verlinkte verifizierte Copilot for Obsidian-Projekt verweist. Vermeiden Sie es, ein ähnlich benanntes Plugin nur deshalb auszuwählen, weil es in den Suchergebnissen zuerst erscheint.
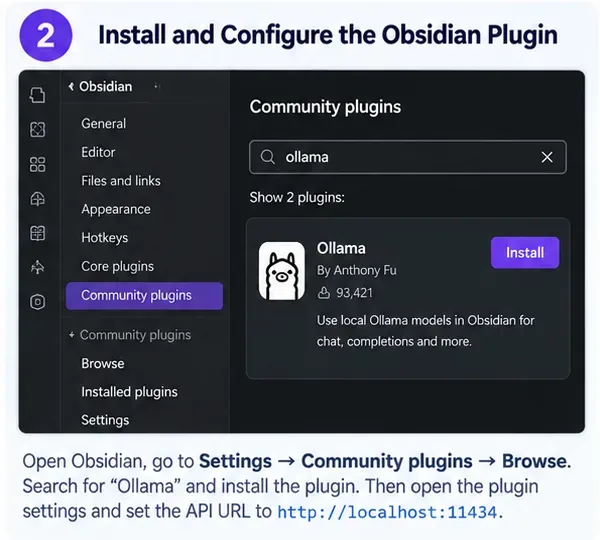
KI-generierte konzeptionelle Illustration des Community-Plugins-Browsers. Die angezeigte Plugin-Karte, der Autorenname und die Download-Anzahl sind illustrativ und sollten nicht als verifizierte Verzeichnis-Daten betrachtet werden; verwenden Sie das in diesem Artikel verlinkte verifizierte Copilot-Projekt.
Öffnen Sie die Einstellungen von Copilot und suchen Sie den Bereich für die Modellkonfiguration, der derzeit unter den Modelleinstellungen organisiert ist. Fügen Sie ein benutzerdefiniertes Chat-Modell mit diesen Werten hinzu:
- Anbieter: Ollama.
- Modell: der exakte lokale Modellname, der von
ollama ls gemeldet wird.
- Basis-URL:
http://localhost:11434.
- API-Schlüssel: Ollama selbst benötigt keinen für den localhost-Zugriff. Wenn ein Plugin-Feld einen Platzhalter erfordert, folgen Sie den aktuellen Anweisungen dieses Plugins, anstatt einen Cloud-Schlüssel zu erfinden.
Es gibt einen einfachen URL-Fehler, den es zu vermeiden gilt. Wenn Sie Ollama manuell testen, sehen API-Endpunkte wie http://localhost:11434/api/chat aus. Der native Ollama-Anbieter von Copilot erwartet jedoch die Basis-Serveradresse und konstruiert den Endpunkt intern, verwenden Sie also http://localhost:11434, es sei denn, das aktuelle Plugin fragt spezifisch nach einem vollständigen Endpunkt. Fügen Sie auch kein /v1 hinzu, wenn Sie den nativen Ollama-Anbieter verwenden. Die separate OpenAI-kompatible API von Ollama verwendet /v1, aber das ist ein anderer Integrationspfad.
Schritt 3: Testen Sie die Notiz-Verankerung, bevor Sie Ihren gesamten Vault indexieren
Beginnen Sie nicht damit, Tausende von Notizen zu indexieren. Beweisen Sie zunächst, dass die grundlegende Chat-Verbindung mit einem kleinen, kontrollierten Test funktioniert. Erstellen Sie eine temporäre Notiz, die drei leicht überprüfbare Fakten enthält, wie einen Projektnamen, eine Frist und eine Entscheidung. Hängen Sie dann diese Notiz in Copilot an oder erwähnen Sie sie und bitten Sie das Modell, nur das zusammenzufassen, was die Notiz sagt.
Ein gutes Ergebnis sollte diese Fakten genau wiedergeben, vermeiden, nicht unterstützte Behauptungen hinzuzufügen, und im von Ihnen angeforderten Rahmen bleiben. Ein schlechtes Ergebnis könnte aus dem allgemeinen Wissen antworten, während es die Notiz ignoriert, Details erfinden oder ein wichtiges Faktum auslassen, das offensichtlich vorhanden ist.
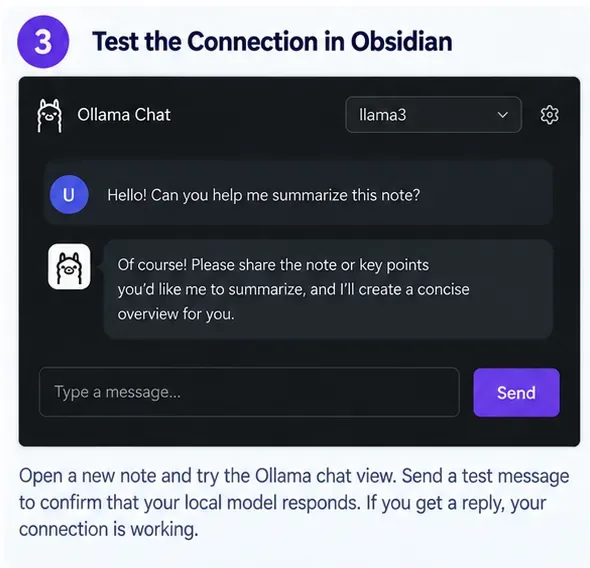
KI-generierte konzeptionelle Illustration eines lokalen Chat-Tests in Obsidian. Sie zeigt die Art des Ergebnisses, das überprüft werden sollte, keinen echten Screenshot eines bestimmten Plugin-Releases.
Wenn keine Antwort erfolgt, beheben Sie Fehler von unten nach oben. Führen Sie zuerst curl http://localhost:11434/api/tags erneut aus. Wenn das fehlschlägt, liegt das Problem bei Ollama, nicht bei Obsidian. Wenn die API funktioniert, aber Copilot nicht, überprüfen Sie den Modellnamen und die Basis-URL erneut. Erst nach diesen Überprüfungen sollten Sie ein Origin/CORS-Problem untersuchen. Der aktuelle Copilot-Code enthält einen Anfragepfad, der für die lokale Ollama-Zugriffsbehandlung gedacht ist, während sein lokaler Einrichtungsleitfaden auch OLLAMA_ORIGINS für Konfigurationen dokumentiert, die einen direkten Zugriff vom Obsidian-Origin erfordern. Verwenden Sie die für Ihre installierte Copilot-Version dokumentierte Methode, anstatt alte Umgebungsvariablen-Workarounds automatisch anzuwenden.
Schritt 4: Fügen Sie vault-bewusstes Retrieval nur hinzu, wenn der Notiz-Chat bestanden hat
Für das persönliche Wissensmanagement kommt die größte Qualitätsverbesserung oft vom Retrieval, nicht vom Wechsel zu einem größeren Chat-Modell. RAG bedeutet, dass das System zuerst Chunks Ihrer Notizen abruft, die relevant erscheinen, und diese Chunks dann dem Sprachmodell als Kontext gibt. Das ermöglicht es einem lokalen Modell, Fragen zu Informationen zu beantworten, mit denen es nie trainiert wurde.
Um das Retrieval ebenfalls lokal zu machen, verwenden Sie ein Ollama-Einbettungsmodell. Die aktuelle Dokumentation von Ollama empfiehlt Modelle wie embeddinggemma, qwen3-embedding und all-minilm. Zum Beispiel:
ollama pull embeddinggemma
Konfigurieren Sie dieses Modell in den Vault-Such- oder QA-Einbettungseinstellungen von Copilot unter Verwendung des Ollama-Anbieters, erstellen oder erstellen Sie dann den lokalen Index neu. Verwenden Sie das gleiche Einbettungsmodell für Indexierung und Abfragen; Ollama empfiehlt dies ausdrücklich, da Vektoren, die von verschiedenen Modellen erzeugt werden, nicht direkt austauschbar sind.

KI-generierte konzeptionelle Illustration eines Ollama-gestützten Notiz-Workflows. Die Befehlsnamen und das Menü-Layout sind Beispiele, keine Behauptung über die genaue UI des aktuellen Copilot-Releases.
Sobald die Indexierung abgeschlossen ist, testen Sie das Retrieval mit Fragen, deren Antworten Sie bereits kennen. Fragen Sie nach einem Faktum, das in einer Notiz erscheint, dann nach einer Beziehung, die zwei Notizen erfordert. Fragen Sie schließlich nach etwas, das nicht im Vault ist. Das beste Ergebnis ist nicht die flüssigste Antwort; es ist die, die die richtigen Beweise nutzt und es ablehnt, fehlende Fakten zu erfinden.
So beurteilen Sie, ob das Ergebnis gut genug ist
| Qualitätsprüfung | Bestehensignal | Wann Sie den Ansatz ändern sollten |
|---|
| Lokale Verbindung | /api/tags funktioniert und dasselbe Modell antwortet in Obsidian | Wenn curl fehlschlägt, beheben Sie zuerst Ollama; wenn nur Obsidian fehlschlägt, überprüfen Sie die Modell-/URL-Einstellungen des Plugins |
| Notiz-Verankerung | Bekannte Fakten aus der angehängten Notiz werden genau wiedergegeben | Wenn der Chat die Notiz ignoriert, beheben Sie die Kontextauswahl, bevor Sie Modelle ändern |
| Vault-Retrieval | Relevante Notizen werden bei Fragen mit bekannten Antworten konsistent gefunden | Wenn das Retrieval schwach ist, verbessern Sie Einbettungen/Indexierung oder schränken Sie den indexierten Umfang ein |
| Generierungsqualität | Das Modell trennt unterstützte Fakten von Unsicherheit | Wenn das Retrieval gut ist, aber die Antworten schwach sind, versuchen Sie ein stärkeres Chat-Modell |
| Latenz | Sie können interagieren, ohne wiederholte lange Wartezeiten | Wenn Ollama hauptsächlich CPU-gebunden oder speicherarm ist, verwenden Sie ein kleineres Modell oder weniger Kontext |
| Datenschutz | Der konfigurierte Endpunkt ist localhost und optionale Cloud-/Web-Funktionen sind deaktiviert | Wenn ein Remote-Endpunkt oder ein Web-Tool aktiv ist, ist der Workflow nicht mehr vollständig lokal |
Wann ein größeres Modell nicht die richtige Lösung ist
Wenn Antworten falsch sind, weil das System die falschen Notizen abruft, kann ein Upgrade des Chat-Modells den Text verbessern, ohne die Beweise zu korrigieren. Verbessern Sie zuerst das Retrieval. Umgekehrt kann ein besseres Chat-Modell helfen, wenn die richtigen Passagen abgerufen werden, das Modell sie aber nicht zuverlässig synthetisieren kann.
Die Hardware setzt auch eine praktische Obergrenze. Ollama weist darauf hin, dass Modelldateien erheblichen Speicherplatz verbrauchen können und größere Kontexte mehr Speicher verbrauchen. Verwenden Sie ollama ps, um zu sehen, wie das aktuelle Modell geladen wird. Ein Workflow, der technisch läuft, aber so lange dauert, dass Sie ihn nicht mehr nutzen, ist kein erfolgreiches PKM-System.
Datenschutz- und Sicherheitsgrenzen von „lokaler“ Obsidian-KI
Die localhost-API von Ollama selbst erfordert keine Authentifizierung, was auf einem Rechner praktisch ist, aber auch bedeutet, dass Sie Port 11434 nicht leichtfertig einem Netzwerk aussetzen sollten. Halten Sie ihn lokal gebunden, es sei denn, Sie sichern eine Remote-Konfiguration absichtlich.
Denken Sie auch daran, dass „Ollama ist lokal“ nicht automatisch bedeutet, dass „der gesamte Obsidian-Workflow offline ist“. Community-Plugins können Cloud-Anbieter-Integrationen, Websuche, Telemetrie oder Agent-Tools enthalten. Überprüfen Sie die aktuellen Einstellungen des Plugins und deaktivieren Sie Funktionen, die Sie nicht nutzen möchten. Wenn Ihr Ziel eine strikte Offline-Verarbeitung ist, testen Sie mit getrenntem Netzwerk, nachdem alle Modelle und Plugins bereits installiert sind.
Abschließende Selbstprüfung
Ihr Setup ist bereit für das tägliche persönliche Wissensmanagement, wenn alle diese Aussagen wahr sind: Die API von Ollama antwortet lokal; Obsidian verwendet das exakte lokale Modell, das Sie beabsichtigt haben; ein kontrollierter Notiztest liefert die korrekten Fakten; das Vault-Retrieval findet die richtigen Notizen für Fragen mit bekannten Antworten; nicht unterstützte Fragen lösen keine selbstbewusste Erfindung aus; und die Leistung ist schnell genug, dass Sie den Workflow tatsächlich nutzen werden.
Wenn nur die ersten beiden Aussagen wahr sind, haben Sie Ollama erfolgreich mit Obsidian verbunden, aber Sie haben noch keinen zuverlässigen Wissensmanagement-Assistenten. Betrachten Sie Retrieval-Qualität, Modellverhalten und Datenschutzkonfiguration als separate Teile des Systems und ändern Sie den Teil, der tatsächlich fehlschlägt.









