Una buena configuración de Ollama–Obsidian no es simplemente aquella en la que una caja de chat devuelve texto. Para la gestión del conocimiento personal, la mejor prueba es si el sistema puede utilizar las notas que pretendías, preservar tu control sobre el cofre, responder a una velocidad aceptable y admitir cuando tus notas no contienen la respuesta. Si no se cumplen esas condiciones, cambiar el modelo, la configuración de recuperación o la configuración del complemento es más útil que ajustar repetidamente las indicaciones.
A partir de septiembre de 2026, la API local de Ollama todavía se sirve por defecto en http://localhost:11434, con rutas de API bajo /api, y el acceso local no requiere autenticación. Ollama también proporciona incrustaciones (embeddings) para búsqueda semántica y generación aumentada por recuperación (RAG), que es la parte que hace que la respuesta a preguntas sobre todo el cofre sea materialmente diferente del chat ordinario. Consulta la introducción oficial a la API de Ollama, la documentación de autenticación local y la documentación de incrustaciones.
Esta guía utiliza Copilot for Obsidian como ejemplo de complemento comunitario porque su proyecto actualmente admite modelos locales de Ollama y flujos de trabajo orientados al cofre. La redacción exacta de la configuración puede cambiar entre las versiones del complemento, así que usa el repositorio actual de Copilot for Obsidian y su guía de configuración de modelos locales si una etiqueta en tu instalación difiere de las capturas de pantalla o los pasos siguientes.
¿Qué debe lograr realmente una configuración local exitosa de PKM?
Antes de instalar nada, define el resultado que deseas. Una configuración local útil debe pasar cuatro pruebas prácticas:
- Conexión: Obsidian puede alcanzar un modelo que Ollama está sirviendo realmente en tu máquina.
- Fundamentación: cuando preguntas sobre una nota o tu cofre, la respuesta refleja el contenido relevante de la nota en lugar de depender solo del entrenamiento general del modelo.
- Rendimiento: el tiempo de respuesta y el uso de memoria son suficientemente aceptables como para que uses el flujo de trabajo de manera realista.
- Control: sabes qué complemento puede leer o modificar notas, qué endpoint de modelo utiliza y si alguna función opcional de web o nube está habilitada.
Estos criterios importan porque "modelo local conectado" y "buena gestión del conocimiento personal" no son lo mismo. El chat puede funcionar perfectamente mientras la recuperación del cofre es débil, y un modelo fuerte aún puede producir malas respuestas si se recuperan las notas equivocadas.
Paso 1: Instala Ollama, extrae un modelo y verifica la API local
Instala Ollama usando las instrucciones oficiales para tu sistema operativo. Ollama actualmente admite macOS, Windows y Linux; la guía de inicio rápido oficial es el punto de partida más seguro porque la instalación y las recomendaciones de modelos cambian con el tiempo.
Extrae un modelo de chat antes de abrir Obsidian. Por ejemplo:
ollama pull gemma3
ollama ls
No necesitas usar gemma3. La parte importante es que el nombre del modelo que ingreses más tarde en Obsidian debe coincidir con un modelo que Ollama pueda listar localmente. Comienza con un modelo que tu computadora pueda ejecutar cómodamente en lugar de elegir automáticamente el modelo más grande disponible.
A continuación, verifica la API independientemente de Obsidian:
curl http://localhost:11434/api/tags
Si ese comando devuelve una lista JSON que contiene tu modelo, el servicio básico de Ollama está funcionando. También puedes ejecutar ollama ps mientras un modelo está activo. Ollama documenta este comando como una forma de ver si un modelo está cargado en memoria de CPU, memoria de GPU o una mezcla de ambas. Si las respuestas son dolorosamente lentas o la máquina se vuelve irresponsiva, eso es una señal para cambiar a un modelo más pequeño o reducir los requisitos de contexto en lugar de asumir que Obsidian es el problema.
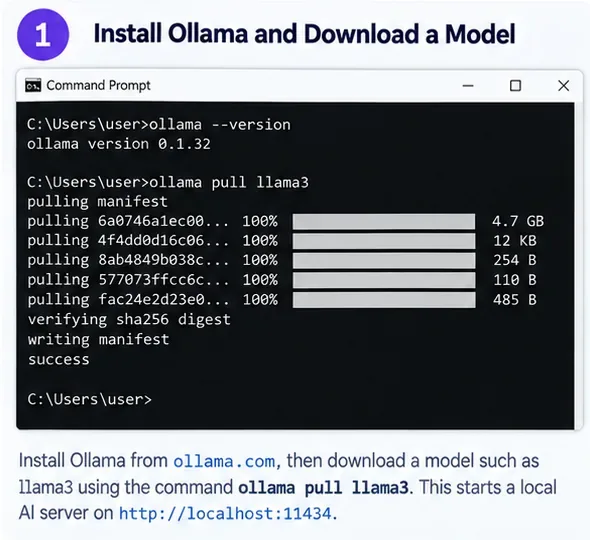
Ilustración generada por IA del paso de instalación de Ollama y extracción de modelo. Los números de versión y los detalles de descarga de modelos mostrados en la imagen son ilustrativos, no un registro de lanzamiento actual.
Paso 2: Instala el complemento de Obsidian y conecta su modelo de chat a Ollama
Obsidian trata los complementos comunitarios como código de terceros. Su documentación oficial advierte que estos complementos ejecutan código en tu nombre, así que revisa el código fuente y los permisos del complemento si tu cofre contiene material sensible. Para instalar uno, abre Configuración → Complementos comunitarios, activa los complementos comunitarios si es necesario, elige Explorar, luego instala y habilita el complemento. El proceso exacto está documentado en la página de ayuda oficial de Complementos comunitarios de Obsidian.
Para esta guía, instala Copilot desde el directorio comunitario y confirma que el complemento apunta al proyecto verificado de Copilot for Obsidian enlazado arriba. Evita elegir un complemento con nombre similar solo porque aparece primero en los resultados de búsqueda.
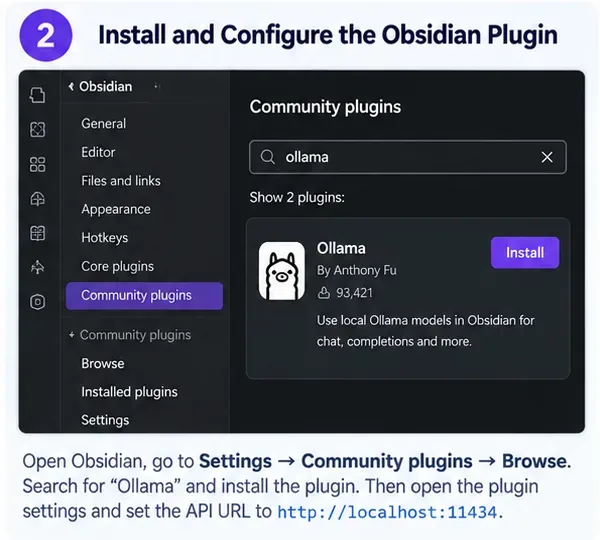
Ilustración conceptual generada por IA del explorador de complementos comunitarios. La tarjeta del complemento, el nombre del autor y el recuento de descargas mostrados son ilustrativos y no deben tratarse como datos verificados del directorio; usa el proyecto verificado de Copilot enlazado en este artículo.
Abre la configuración de Copilot y busca el área de configuración del modelo, actualmente organizada bajo su configuración de Modelos. Agrega un modelo de chat personalizado con estos valores:
- Proveedor: Ollama.
- Modelo: el nombre exacto del modelo local reportado por
ollama ls.
- URL base:
http://localhost:11434.
- Clave API: Ollama en sí no requiere una para el acceso a localhost. Si un campo del complemento requiere un marcador de posición, sigue las instrucciones actuales de ese complemento en lugar de inventar una clave de nube.
Hay un error fácil de URL que debes evitar. Cuando pruebas Ollama manualmente, los endpoints de la API se ven como http://localhost:11434/api/chat. Sin embargo, el proveedor nativo de Ollama de Copilot espera la dirección base del servidor y construye el endpoint internamente, así que usa http://localhost:11434 a menos que el complemento actual solicite específicamente un endpoint completo. Del mismo modo, no agregues /v1 cuando uses el proveedor nativo de Ollama. La API compatible con OpenAI separada de Ollama usa /v1, pero esa es una ruta de integración diferente.
Paso 3: Prueba la fundamentación a nivel de nota antes de indexar todo tu cofre
No comiences indexando miles de notas. Primero, demuestra que la conexión básica de chat funciona con una prueba pequeña y controlada. Crea una nota temporal que contenga tres hechos fáciles de verificar, como un nombre de proyecto, una fecha límite y una decisión. Luego adjunta o menciona esa nota en Copilot y pide al modelo que resuma solo lo que dice la nota.
Un buen resultado debe reproducir esos hechos con precisión, evitar agregar afirmaciones no respaldadas y mantenerse dentro del alcance que solicitaste. Un mal resultado podría responder desde el conocimiento general ignorando la nota, inventar detalles u omitir un hecho importante que está claramente presente.
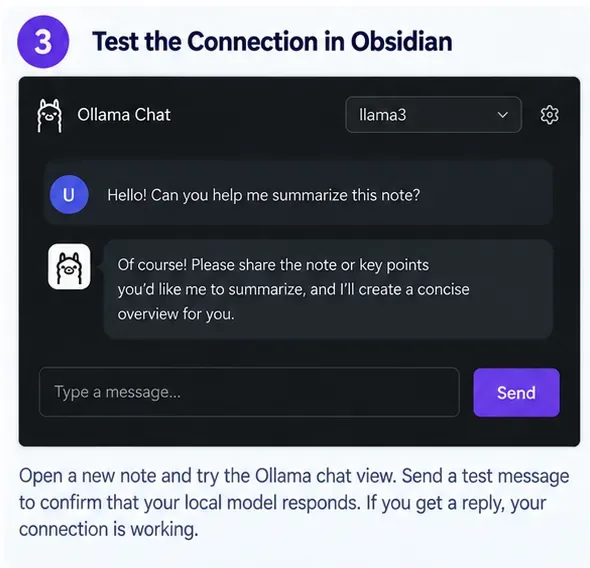
Ilustración conceptual generada por IA de una prueba de chat local en Obsidian. Demuestra el tipo de resultado a verificar, no una captura de pantalla real de una versión específica del complemento.
Si no hay respuesta, soluciona problemas desde abajo hacia arriba. Primero vuelve a ejecutar curl http://localhost:11434/api/tags. Si eso falla, el problema es Ollama, no Obsidian. Si la API funciona pero Copilot no, vuelve a verificar el nombre del modelo y la URL base. Solo después de esas comprobaciones debes investigar un problema de origen/CORS. El código actual de Copilot incluye una ruta de solicitud destinada a manejar el acceso local a Ollama, mientras que su guía de configuración local también documenta OLLAMA_ORIGINS para configuraciones que requieren acceso directo desde el origen de Obsidian. Usa el método documentado para tu versión instalada de Copilot en lugar de aplicar automáticamente soluciones antiguas de variables de entorno.
Paso 4: Agrega recuperación consciente del cofre solo si el chat a nivel de nota pasa
Para la gestión del conocimiento personal, la mayor mejora de calidad a menudo proviene de la recuperación en lugar de pasar a un modelo de chat más grande. RAG significa que el sistema primero recupera fragmentos de tus notas que parecen relevantes, luego da esos fragmentos al modelo de lenguaje como contexto. Eso permite que un modelo local responda preguntas sobre información en la que nunca fue entrenado.
Para hacer que la recuperación también sea local, usa un modelo de incrustaciones de Ollama. La documentación actual de Ollama recomienda modelos como embeddinggemma, qwen3-embedding y all-minilm. Por ejemplo:
ollama pull embeddinggemma
Configura ese modelo en la configuración de incrustaciones de búsqueda del cofre o QA de Copilot usando el proveedor de Ollama, luego construye o reconstruye el índice local. Usa el mismo modelo de incrustaciones para indexar y consultar; Ollama recomienda explícitamente esto porque los vectores producidos por diferentes modelos no son directamente intercambiables.

Ilustración conceptual generada por IA de un flujo de trabajo de notas impulsado por Ollama. Los nombres de comandos y el diseño del menú son ejemplos, no una afirmación sobre la interfaz de usuario exacta de la versión actual de Copilot.
Una vez que termine la indexación, prueba la recuperación con preguntas cuyas respuestas ya conoces. Pide un hecho que aparece en una nota, luego una relación que requiera dos notas. Finalmente, pide algo que no esté en el cofre. El mejor resultado no es la respuesta más fluida; es la que usa la evidencia correcta y se niega a inventar hechos faltantes.
Cómo juzgar si el resultado es suficientemente bueno
| Control de calidad | Señal de aprobación | Cuándo cambiar el enfoque |
|---|
| Conexión local | /api/tags funciona y el mismo modelo responde en Obsidian | Si curl falla, arregla Ollama primero; si solo Obsidian falla, inspecciona la configuración de modelo/URL del complemento |
| Fundamentación de notas | Los hechos conocidos de la nota adjunta se reproducen con precisión | Si el chat ignora la nota, arregla la selección de contexto antes de cambiar de modelos |
| Recuperación del cofre | Las notas relevantes se presentan consistentemente para preguntas con respuestas conocidas | Si la recuperación es débil, mejora las incrustaciones/indexación o reduce el alcance indexado |
| Calidad de generación | El modelo separa los hechos respaldados de la incertidumbre | Si la recuperación es buena pero las respuestas son débiles, prueba un modelo de chat más fuerte |
| Latencia | Puedes interactuar sin pausas largas repetidas | Si Ollama está mayormente limitado por CPU o escaso de memoria, usa un modelo más pequeño o menos contexto |
| Privacidad | El endpoint configurado es localhost y las funciones opcionales de nube/web están deshabilitadas | Si un endpoint remoto o herramienta web está activo, el flujo de trabajo ya no es totalmente local |
Cuándo un modelo más grande no es la solución correcta
Si las respuestas son incorrectas porque el sistema recupera las notas equivocadas, actualizar el modelo de chat puede mejorar la prosa sin arreglar la evidencia. Mejora la recuperación primero. Por el contrario, si los pasajes correctos se recuperan pero el modelo no puede sintetizarlos de manera confiable, entonces un mejor modelo de chat puede ayudar.
El hardware también establece un techo práctico. Ollama señala que los archivos de modelos pueden consumir un almacenamiento sustancial, y los contextos más grandes consumen más memoria. Usa ollama ps para ver cómo se está cargando el modelo actual. Un flujo de trabajo que técnicamente funciona pero tarda tanto que dejas de usarlo no es un sistema PKM exitoso.
Límites de privacidad y seguridad de la IA "local" de Obsidian
La API de localhost de Ollama en sí no requiere autenticación, lo cual es conveniente en una máquina pero también significa que no debes exponer casualmente el puerto 11434 a una red. Mantenlo vinculado localmente a menos que asegures deliberadamente una configuración remota.
También recuerda que "Ollama es local" no significa automáticamente que "todo el flujo de trabajo de Obsidian esté sin conexión". Los complementos comunitarios pueden contener integraciones de proveedores de nube, búsqueda web, telemetría o herramientas de agentes. Revisa la configuración actual del complemento y deshabilita las funciones que no pretendes usar. Si tu objetivo es el procesamiento estrictamente sin conexión, prueba con la red desconectada después de que todos los modelos y complementos ya estén instalados.
Autoverificación final
Tu configuración está lista para la gestión del conocimiento personal diaria cuando todas estas afirmaciones son verdaderas: la API de Ollama responde localmente; Obsidian usa el modelo local exacto que pretendías; una prueba de nota controlada devuelve los hechos correctos; la recuperación del cofre encuentra las notas correctas para preguntas con respuestas conocidas; las preguntas no respaldadas no provocan una fabricación segura; y el rendimiento es lo suficientemente rápido como para que realmente uses el flujo de trabajo.
Si solo las dos primeras afirmaciones son verdaderas, has conectado con éxito Ollama a Obsidian, pero aún no tienes un asistente de gestión del conocimiento confiable. Trata la calidad de la recuperación, el comportamiento del modelo y la configuración de privacidad como partes separadas del sistema, y cambia la parte que realmente está fallando.









