Inicio
» Dominios
»
Cómo evitar que los agentes de CrewAI ejecuten tareas redundantes: una guía práctica para la eliminación de duplicados.
Cómo evitar que los agentes de CrewAI ejecuten tareas redundantes: una guía práctica para la eliminación de duplicados.
Cuando los agentes de CrewAI parecen ejecutar la misma tarea dos veces, la causa no suele ser una única configuración de "tarea duplicada". La repetición puede deberse a descripciones de tareas superpuestas, delegación jerárquica, comportamiento de reintento, múltiples activadores de flujo, inicios de equipo repetidos o herramientas con efectos secundarios que no están protegidas por una clave de idempotencia.
Esta referencia práctica se verificó con la documentación oficial de CrewAI el 13 de septiembre de 2026. La documentación actual corresponde a CrewAI v1.15.14. La distinción más importante es la siguiente: evitar el razonamiento redundante dentro de una misma ejecución es diferente a evitar que la misma acción empresarial se repita dos veces en distintas ejecuciones . CrewAI proporciona contexto de tarea, tareas condicionales, funciones de devolución de llamada, estado de flujo, persistencia y almacenamiento en caché de herramientas, pero aún así es necesario diseñar condiciones de omisión explícitas para las tareas que deben realizarse solo una vez.
Diagnóstico rápido: ¿por qué se repite el mismo trabajo?
Síntoma
Causa probable
Primera solución para probar
Dos agentes investigan el mismo tema.
Funciones o descripciones de tareas superpuestas
Asigne un propietario a cada tarea y pase la salida anterior a través decontext
Un gerente solicita un trabajo que otro agente ya realizó.
Delegación jerárquica más responsabilidades ambiguas
Aclarar las instrucciones del gerente, las funciones de los agentes y la propiedad de las herramientas.
La misma tarea se ejecuta varias veces después de que falla la validación.
Reintentos de la barandilla
Inspeccione el error de la barandilla y redúzcalo guardrail_max_retriesdurante la depuración.
Un agente llama repetidamente a la misma herramienta.
Presupuesto de iteraciones elevado, condición de parada débil o reintentos de llamada a la herramienta.
Reduzca max_iter, ajuste la salida esperada e inspeccione los registros de pasos.
Un método de Flow se ejecuta más de una vez.
Múltiples @start()métodos o múltiples eventos previos
Utilice un único punto de entrada, un enrutador, banderas de estado o, and_cuando corresponda,
Se produce una mutación de correo electrónico/pago/API dos veces después del reinicio.
No hay guardia de idempotencia de carrera cruzada
Utilice una clave de operación determinista en el almacenamiento transaccional persistente o externo.
Habilitaste la memoria, pero las tareas aún se ejecutan.
La memoria proporciona contexto; no es un deduplicador a nivel de planificador.
Realizar un seguimiento explícito del trabajo completado en lugar de depender del recuerdo.
Habilitaste la caché, pero la tarea completa se vuelve a ejecutar.
La caché de CrewAI está documentada para los resultados de ejecución de la herramienta.
Agregue lógica de salto a nivel de tarea o un almacén de idempotencia.
1. Comience con un propietario por unidad de trabajo.
La regla antiduplicación más sencilla es también la más eficaz: cada unidad de trabajo significativa debe tener un único responsable. En un proceso secuencial de CrewAI, las tareas se ejecutan en el orden en que se declaran. Este contextatributo permite que una tarea posterior utilice el resultado de una tarea anterior en lugar de redescubrir la misma información de forma independiente.
Es más fácil razonar sobre la propiedad separada: una tarea investiga, la siguiente analiza la investigación en lugar de repetirla.
Un antipatrón común se ve así conceptualmente:
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
Las tres tareas incluyen permiso para investigar, por lo que la búsqueda repetida es predecible. Prefiero una cadena más estrecha:
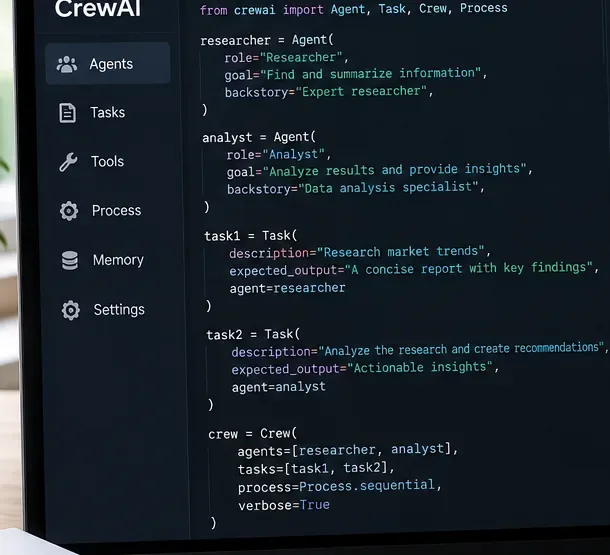
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
Lista de verificación práctica para definir los límites de las tareas.
Asigna a cada tarea un verbo diferente de los demás: investigar, normalizar, analizar, escribir, revisar.
Indica qué no debe hacer la tarea cuando la superposición de tareas resulta costosa.
Haz que el resultado esperado sea lo suficientemente concreto como para que la siguiente tarea pueda utilizarlo directamente.
Transmitir los resultados previos en contextlugar de indicar a los agentes posteriores que "investiguen si es necesario".
Restrinja las herramientas a nivel de tarea o agente cuando solo un rol deba tener permiso para buscar, escribir en una base de datos, enviar mensajes o llamar a una API externa.
2. Omitir el trabajo que ya se ha completado con ConditionalTask.
Si una tarea solo es necesaria cuando un resultado anterior está incompleto, no deje que el agente decida informalmente si repetir el trabajo. CrewAI proporciona ConditionalTaskuna condición que recibe el resultado de la tarea anterior y puede omitir la ejecución cuando la condición es falsa.
El ejemplo oficial utiliza una condición que comprueba si se han devuelto suficientes registros de eventos; si ya existen suficientes datos, se omite la tarea de obtención adicional. Consulte Tareas condicionales de CrewAI .
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
Este patrón es más eficaz que indicarle al agente "evite realizar trabajo duplicado" porque la decisión de omitir el trabajo se basa en la lógica determinista de Python, en lugar de en otro juicio del modelo de lenguaje.
3. Sepa cuándo la delegación está creando una duplicación aparente.
CrewAI admite procesos tanto secuenciales como jerárquicos. En un equipo jerárquico, un gerente asigna tareas, delega trabajo, valida los resultados y determina si la finalización de las tareas es satisfactoria. Esta flexibilidad resulta útil cuando la asignación de trabajo debe ser dinámica, pero también implica que la responsabilidad es menos explícita que en un equipo secuencial.
La documentación del agente de CrewAI actualmente indica que allow_delegationel valor predeterminado es False. Mantenga ese valor predeterminado para los especialistas a menos que un agente realmente necesite transferir trabajo a otro agente. En un proceso jerárquico, el propio gerente es responsable de la delegación. Consulte la guía del proceso jerárquico .
Un punto de partida seguro para un equipo que está generando llamadas redundantes es:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)
Luego, reincorpore la delegación solo donde genere un beneficio cuantificable. Si no se requiere orquestación jerárquica, Process.sequentialla depuración resulta más sencilla, ya que el orden de las tareas y la propiedad son explícitos.
4. No confunda los reintentos con la programación duplicada.
Se espera cierto grado de reintento en el trabajo repetido. Los mecanismos de control de tareas de CrewAI pueden validar una salida y enviar retroalimentación al agente cuando la validación falla. La documentación actual de la tarea indica que guardrail_max_retriesel valor predeterminado es 3, y un mecanismo de control fallido reintenta la tarea hasta alcanzar ese límite.
Los agentes también exponen max_retry_limiterrores de ejecución y max_iterel número máximo de iteraciones antes de producir la mejor respuesta disponible. La documentación actual de los agentes indica un valor predeterminado max_iterde 20 y un límite predeterminado de reintentos por error de 2.
Esos mecanismos resuelven problemas diferentes:
Configuración
Lo que limita
Por qué puede parecer redundante
guardrail_max_retries
Reintentos tras fallo en la validación de la salida de la tarea
La misma tarea se vuelve a ejecutar intencionalmente con retroalimentación de protección
max_retry_limit
Reintentos después de errores de ejecución
Un intento fallido puede repetir una llamada a la herramienta.
max_iter
Razonamiento del agente/iteraciones de la herramienta
Un agente inseguro puede realizar varias llamadas a herramientas similares antes de finalizar.
Durante la depuración, reduzca temporalmente estos límites. Si la repetición desaparece, analice por qué la tarea fallaba la validación o por qué el agente consideraba necesaria otra iteración de la herramienta. No establezca todos los valores de reintento a cero en producción; los reintentos pueden ser apropiados para fallos transitorios.
5. Rastrea lo que realmente se ejecutó antes de reescribir las indicaciones.
Los registros de ejecución ayudan a diferenciar una segunda ejecución de tarea real de múltiples pasos, reintentos o llamadas a herramientas dentro de una misma tarea.
CrewAI expone varios ganchos de observabilidad . A nivel de tripulación, la documentación actual incluye verbosecontroles de step_callbackrastreo . Los agentes también admiten . Estos son útiles para responder a cuatro preguntas:task_callbackoutput_log_filestep_callback
¿El planificador inició la misma tarea dos veces?
¿Realizó un mismo agente múltiples iteraciones dentro de una misma tarea?
¿Algún sistema de protección rechazó la salida y provocó un reintento?
¿Se repitió la llamada a una herramienta aunque la tarea en sí se ejecutó una sola vez?
Para una ejecución de diagnóstico inicial, active la salida detallada y un archivo de registro JSON:
Los flujos introducen otro tipo de repetición. La documentación actual de CrewAI sobre flujos indica que todos @start()los métodos que se cumplen se ejecutan cuando el flujo comienza o se reanuda. Si define varios inicios incondicionales y dos de ellos activan al mismo equipo, la duplicación se produce en el grafo, no dentro del equipo.
Asimismo, or_los oyentes pueden ejecutarse cuando cualquier método anterior emite una salida. El ejemplo de CrewAI muestra cómo el oyente se activa una vez por cada emisión anterior. Úselo and_cuando la operación posterior deba esperar hasta que se hayan completado todos los prerrequisitos, o @router()cuando deba continuar exactamente una rama.
Antes de añadir un segundo @start(), pregúntese si realmente representa un punto de entrada independiente. Si no es así, utilice un único método de inicio y oyentes explícitos.
7. Añadir una clave de finalización para la idempotencia entre ejecuciones.
Este es el patrón de producción más importante cuando una tarea produce un efecto secundario externo, como enviar un correo electrónico, realizar un cargo a un método de pago, crear un registro en el CRM, publicar un mensaje o iniciar un trabajo.
Los flujos de CrewAI admiten estado estructurado y el @persistdecorador. La persistencia permite que un flujo recupere su estado tras reinicios. Sin embargo, el estado persistente por sí solo no determina si se debe omitir una acción de negocio. Almacene su propia clave de operación determinista y verifíquela antes de realizar el efecto secundario.
La persistencia y la memoria son componentes básicos útiles, pero un flujo de trabajo de producción aún necesita una regla explícita de "¿ya se ha completado?" para las acciones que deben ocurrir una sola vez.
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
CrewAI documenta que @persistse puede almacenar el estado del flujo entre reinicios y que al reanudar con el mismo ID de estado se recarga la última instantánea. Consulte la documentación de persistencia de flujo de CrewAI .
Advertencia importante en producción: el ejemplo anterior es útil para la deduplicación de flujos de trabajo habituales, pero no es suficiente para un efecto secundario crítico desde el punto de vista financiero o legal. Un proceso puede fallar después de que la acción externa se complete con éxito, pero antes de que se guarde la clave de finalización. Para un comportamiento robusto similar al de "única vez", utilice un almacén transaccional externo o la clave de idempotencia de la API de destino, y registre la operación de forma atómica siempre que sea posible.
8. Almacene en caché las llamadas repetidas a las herramientas, pero no confunda la caché con la idempotencia de la tarea.
Los agentes y tripulaciones de CrewAI exponen información cacheque la documentación oficial describe como el almacenamiento en caché de los resultados de la ejecución de herramientas. La documentación actual del agente muestra que el almacenamiento en caché está habilitado por defecto, y la guía de rendimiento recomienda mantenerlo habilitado para el uso repetitivo de herramientas.
Esto resulta útil cuando un agente realiza la misma búsqueda costosa o llama a una herramienta determinista más de una vez. Sin embargo, llamar dos veces nocrew.kickoff() significa que la tarea del equipo se omita automáticamente. La tarea sigue perteneciendo al grafo de ejecución.
Utilice la caché para lecturas repetidas. Utilice una clave de idempotencia para escrituras repetidas.
Operación
Protección preferida
Busque en la misma documentación
caché de herramientas
Reutilizar el conocimiento previo en diferentes tareas.
Contexto de memoria o tarea
Omitir una tarea opcional cuando ya existan suficientes datos.
ConditionalTask
Evitar que una rama de Flow se active incorrectamente.
Rediseño del enrutador, la condición de estado and_o el gráfico
Evitar escrituras externas duplicadas entre reintentos/reinicios.
Clave de idempotencia persistente o almacén transaccional externo
9. La memoria reduce el descubrimiento repetido, pero no cancela las tareas.
El sistema de memoria unificada de CrewAI almacena información después de las tareas y recupera el contexto relevante antes de realizarlas. La documentación actual indica que, con la memoria de la tripulación habilitada, se extraen datos específicos de los resultados de las tareas y se incorporan los recuerdos relevantes en las indicaciones de tareas posteriores.
Esto puede reducir la necesidad de redescubrir información innecesaria, especialmente cuando un escritor debería saber qué ya encontró un investigador. Pero la memoria es el contexto de recuperación, no una señal para omitir información. Una tarea programada explícitamente se ejecuta a menos que la lógica de Crew o Flow decida lo contrario.
Utilice la memoria para "¿Qué sabemos ya?". Utilice el estado o una tarea condicional para "¿Debería ejecutarse esta operación?". Consulte Memoria de CrewAI .
10. Utilice resultados estructurados para que las decisiones de omisión sean fiables.
La salida en lenguaje natural es difícil de usar para el control determinista del flujo de trabajo. Las tareas de CrewAI pueden devolver salidas Pydantic o JSON a través de output_pydanticy output_json. Un resultado estructurado facilita la decisión de si es necesario enriquecer, revisar, escalar o realizar otra tarea.
Luego, se enruta según los campos en lugar de pedirle a otro agente que interprete un párrafo en prosa. Esto generalmente reduce tanto el trabajo duplicado como la ambigüedad de las indicaciones.
Configuración anti-redundancia recomendada
Una lista de verificación compacta resulta útil antes de aumentar la complejidad del modelo: la mayoría de los problemas de redundancia son más fáciles de resolver primero en el diseño de tareas y el flujo de control.
Para un proceso típico de investigación y elaboración de informes, comience con cautela:
Luego, agregue complejidad solo cuando un requisito lo exija:
Agregue memoria cuando los datos deban reutilizarse en diferentes tareas o ejecuciones.
Agregue una tarea condicional cuando una tarea deba ejecutarse solo si la salida anterior está incompleta.
Utilice un proceso jerárquico cuando realmente se necesite una asignación dinámica de gerentes.
Habilite la delegación únicamente para los agentes que necesiten delegar tareas a sus compañeros.
Establecer límites para la calidad de la salida, aceptando al mismo tiempo que un límite fallido provoca reintentos intencionadamente.
Agregue persistencia de flujo cuando el estado deba sobrevivir a los reinicios.
Añada una capa de idempotencia externa cuando los efectos secundarios duplicados sean inaceptables.
Lista de verificación final para la resolución de problemas
¿Aparece la misma tarea Taskdeclarada dos veces en la lista de tareas de la tripulación?
¿Dos descripciones de tareas autorizan la misma investigación o la misma solicitud de herramienta?
¿Puede una tarea posterior consumir la tarea anterior en contextsu lugar?
¿Debería ser la tarea repetida un ConditionalTask?
¿Estás utilizando una orquestación jerárquica cuando una secuencial sería suficiente?
¿Está allow_delegationhabilitado en los agentes que no lo necesitan?
¿El rechazo de la barrera de seguridad está provocando un reintento?
¿ Es max_iterlo suficientemente grande como para que una tarea realice muchas llamadas a herramientas similares?
¿Hay varios @start()métodos o or_oyentes que estén activando el mismo equipo de procesamiento posterior?
¿Representa un segundo intento kickoff()una nueva ejecución intencionada o una invocación duplicada accidental?
¿Estás utilizando la memoria o la caché como si fueran controles de idempotencia a nivel de tarea?
¿Las escrituras externas tienen una clave de idempotencia determinista?
¿Pueden los registros demostrar si la duplicación se produjo a nivel de tarea, paso del agente, herramienta o flujo?
En resumen
Detener el trabajo redundante de CrewAI es principalmente un problema de orquestación. Haga explícita la propiedad, encadene tareas con context, omita condicionalmente el trabajo que ya se haya completado, mantenga la delegación restringida, comprenda cuándo los reintentos son intencionales y rastree la ejecución antes de cambiar las indicaciones. Para flujos y efectos secundarios de producción, vaya un paso más allá: persista una clave de finalización determinista o utilice un mecanismo de idempotencia externo.
El modelo mental útil es simple: el contexto evita el redescubrimiento, las condiciones evitan tareas innecesarias, la caché evita el cálculo repetido de herramientas y la idempotencia evita los efectos secundarios repetidos . Resuelven problemas relacionados, pero no son intercambiables.