Inicio
» Dominios
»
Cómo ejecutar DeepSeek sin conexión en Windows 11 con LM Studio
Cómo ejecutar DeepSeek sin conexión en Windows 11 con LM Studio
Sí, puedes ejecutar DeepSeek completamente sin conexión en Windows 11 con LM Studio, pero necesitas una primera configuración en línea. Instala LM Studio, descarga un modelo DeepSeek compatible y el tiempo de ejecución requerido, carga el modelo una vez y luego puedes desconectarte de internet. La documentación oficial de LM Studio sobre el modo sin conexión indica que chatear con modelos descargados, chatear con documentos locales y ejecutar su servidor local no requieren acceso a internet.
Para un PC típico con Windows 11, el punto de partida más práctico no es el modelo DeepSeek más grande actual. Un modelo GGUF más pequeño como DeepSeek-R1-0528-Qwen3-8B es mucho más fácil de ejecutar localmente. LM Studio publicó soporte para ese modelo destilado de 8B en mayo de 2025 y dice que funciona en formato GGUF con LM Studio 0.3.16 o versiones posteriores. Por el contrario, la guía de agosto de 2026 de LM Studio para DeepSeek V4 Flash indica que el uso local requiere aproximadamente 156GB de memoria del sistema. Esto hace que V4 Flash sea una mala elección para la mayoría de las máquinas Windows de consumo, aunque sea más nuevo y más capaz.
Esta guía fue verificada el 11 de septiembre de 2026. El registro de cambios de LM Studio lista la versión 0.4.24 con fecha 9 de septiembre de 2026. Debido a que la interfaz de LM Studio evoluciona, un botón puede moverse ligeramente entre versiones, pero el flujo de trabajo principal—descargar un modelo, cargarlo, chatear localmente y opcionalmente exponer una API localhost—sigue estando documentado por LM Studio.
Antes de empezar: ¿Se ajusta tu PC con Windows 11?
LM Studio actualmente soporta tanto PCs Windows x64 como sistemas Windows basados en ARM. Para x64, la CPU debe soportar AVX2. LM Studio recomienda al menos 16GB de RAM y al menos 4GB de VRAM dedicada. Estas son recomendaciones a nivel de aplicación, no una promesa de que cada modelo se ajustará. El tamaño del modelo, la cuantización, la longitud del contexto y la descarga en GPU afectan todos el uso de memoria.
Lo que tienes
Recomendación práctica
Por qué
16GB de RAM, GPU modesta o gráficos integrados
Comienza con un modelo destilado de DeepSeek de 8B o menor en una variante GGUF de 4 bits
Mantiene la huella del modelo relativamente manejable mientras preserva una capacidad de razonamiento útil.
Más RAM y una GPU más potente
Prueba variantes destiladas más grandes solo después de verificar la estimación de ajuste de dispositivo de LM Studio
Los modelos más grandes pueden mejorar la calidad pero consumen sustancialmente más memoria y pueden ser mucho más lentos.
PC de juegos o portátil ordinario
No comiences con DeepSeek V4 Flash
LM Studio dice que el modelo V4 Flash local necesita al menos 156GB de memoria del sistema.
La documentación de descarga de modelos de LM Studio explica que las compilaciones cuantizadas intercambian algo de fidelidad por archivos más pequeños y menor presión de memoria. Su recomendación general es elegir una opción de 4 bits o superior cuando tu hardware pueda manejarlo. Si no estás seguro, una versión GGUF de 4 bits es una primera prueba sensata.
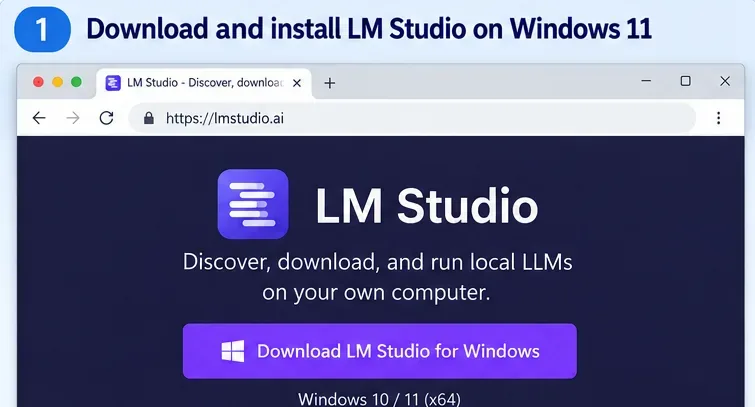
Descarga la compilación estable actual de Windows desde la página oficial de descarga de LM Studio. Usa el instalador que coincida con la arquitectura de tu Windows. En un PC x64, asegúrate de que tu procesador soporte AVX2 antes de solucionar errores de carga de modelos más adelante.
La vista de descarga para Windows de LM Studio. Elige el instalador que coincida con tu sistema Windows 11 antes de pasar a la descarga del modelo.
Inicia LM Studio mientras aún tienes una conexión a internet. Esto es importante porque la aplicación puede necesitar descargar o actualizar un LM Runtime. LM Studio describe los tiempos de ejecución como motores de inferencia empaquetados, como su tiempo de ejecución basado en llama.cpp para modelos GGUF. Las descargas de tiempos de ejecución requieren conectividad aunque la inferencia pueda funcionar sin conexión después.
Paso 2: Descarga un modelo DeepSeek que se ajuste a tu PC
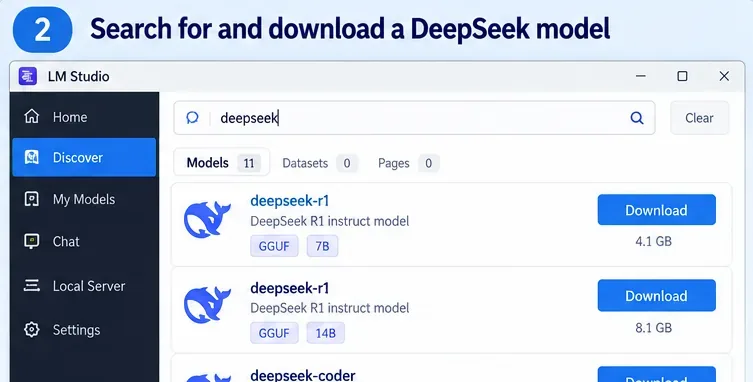
Abre el área Discover en LM Studio y busca DeepSeek. LM Studio puede buscar modelos compatibles de Hugging Face por palabra clave, por un identificador usuario/modelo, o incluso por una URL completa de Hugging Face.
Busca DeepSeek en Discover, luego elige un modelo y cuantización apropiados para tu hardware. Las entradas exactas del catálogo y los tamaños de archivo cambian con el tiempo.
¿Qué modelo DeepSeek deberías elegir?
Para la mayoría de las personas que siguen esta guía, comienza con DeepSeek-R1-0528-Qwen3-8B. LM Studio dice que este modelo destilado de 8B soporta razonamiento y uso de herramientas, está disponible como GGUF, y puede ejecutarse con mucha menos memoria que los modelos insignia de DeepSeek. La guía de Windows de LM Studio todavía recomienda 16GB de RAM para la aplicación en general, así que no trates una afirmación de baja memoria específica del modelo como un objetivo cómodo para todo el sistema.
DeepSeek también lanzó variantes destiladas R1 anteriores con 1.5B, 7B, 8B, 14B, 32B y 70B parámetros. Estas te dan margen para intercambiar velocidad y uso de memoria contra capacidad. Consulta el repositorio oficial de DeepSeek-R1 para la familia de modelos y detalles de licencia, y la nota de ejecución local de DeepSeek-R1-0528 de LM Studio para la opción de 8B.
Si te tienta DeepSeek V4 Flash porque es más nuevo, verifica primero el requisito de hardware. El artículo oficial de V4 Flash de LM Studio dice que el modelo Mixture-of-Experts de 284B necesita al menos 156GB de memoria del sistema para uso local. Es viable en estaciones de trabajo de alta memoria, no en un portátil Windows normal.
Paso 3: Carga el modelo en la memoria
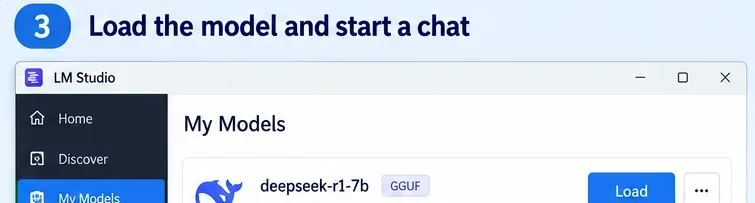
Después de que termine la descarga, ve a tus modelos descargados o abre el cargador de modelos desde Chat. Selecciona el modelo DeepSeek y cárgalo. LM Studio explica que cargar un modelo asigna memoria para los pesos del modelo y el estado relacionado del tiempo de ejecución.
Un modelo GGUF DeepSeek descargado listo para cargar. Si la carga falla, prueba un modelo más pequeño o una cuantización de menor memoria antes de cambiar configuraciones avanzadas.
Para tu primera ejecución, mantén las configuraciones de carga conservadoras. Una ventana de contexto muy grande puede consumir memoria adicional significativa, por lo que hay poca razón para maximizar el contexto inmediatamente. Carga el modelo con un contexto modesto, verifica que funcione, y expande solo cuando tu carga de trabajo lo requiera.
Si LM Studio informa que el modelo no se ajusta, la solución más fiable suele ser elegir un modelo más pequeño o una cuantización más compacta. Cerrar aplicaciones que consumen mucha memoria puede ayudar, pero no cambia la huella fundamental del modelo.
Paso 4: Desconecta internet y verifica que DeepSeek realmente funcione sin conexión
Este es el paso que separa "modelo local" de simplemente "usar un cliente de escritorio". Una vez que el modelo y su tiempo de ejecución estén instalados, apaga el Wi-Fi y desconecta el Ethernet. Luego inicia un nuevo chat y envía un prompt simple como:
Explica la diferencia entre RAM y VRAM en cinco puntos.
Si el modelo responde mientras el PC no tiene conexión de red, la inferencia es local. LM Studio establece que una vez que un LLM está en tu máquina, puede ejecutarse completamente sin conexión y que el texto introducido en chats LLM locales no sale de tu dispositivo. Su documentación sin conexión también dice que el procesamiento de documentos locales y RAG permanecen en la máquina.
Un modelo DeepSeek cargado respondiendo en LM Studio Chat. Para verificar la operación sin conexión tú mismo, desconecta el acceso a la red después de que el modelo y el tiempo de ejecución estén completamente descargados y repite un prompt simple.
Hay un límite importante: buscar modelos, descargar nuevos modelos, descargar tiempos de ejecución y buscar actualizaciones de la aplicación requieren acceso a internet. Si más adelante agregas modelos en la nube, servidores MCP remotos, herramientas web u otras integraciones de red, esas funciones también pueden requerir conectividad. Las afirmaciones de privacidad sin conexión se aplican al flujo de trabajo local, no a los servicios a los que te conectas deliberadamente después.
Paso 5: Opcional—Usa DeepSeek a través de una API local
Si quieres que otra aplicación de Windows, script, extensión de IDE o herramienta interna llame a tu modelo DeepSeek local, LM Studio puede ejecutar un servidor local. La documentación actual para desarrolladores dice que puedes iniciarlo desde la página Developer o con:
lms server start
Por defecto, el servidor está disponible en http://localhost:1234. LM Studio proporciona endpoints REST nativos y endpoints compatibles con OpenAI. El servidor en sí puede operar sin conexión siempre que el modelo y el tiempo de ejecución ya sean locales. Sin embargo, si expones el servidor más allá de localhost, revisa primero la autenticación y la configuración de acceso a la red.
Poca RAM/VRAM, contexto excesivo o CPU/tiempo de ejecución no soportados
Prueba un modelo DeepSeek más pequeño, una cuantización más pequeña o una longitud de contexto menor. En Windows x64, confirma el soporte AVX2.
LM Studio funciona en línea pero no después de desconectarse
El modelo o el tiempo de ejecución requerido no se descargó completamente
Reconecta una vez, termina todas las descargas de modelos/tiempos de ejecución, carga el modelo con éxito, luego repite la prueba sin conexión.
La generación es muy lenta
El modelo es demasiado grande para la aceleración GPU disponible y depende fuertemente de la CPU/memoria del sistema
Elige un modelo o cuantización más pequeños. Un modelo más grande no es útil si la latencia hace que el flujo de trabajo sea impracticable.
No puedes encontrar un modelo mientras estás sin conexión
La búsqueda en Discover necesita acceso a la red
Descarga modelos antes de ir sin conexión, o carga lateralmente un archivo de modelo obtenido a través de otro proceso controlado.
Esperabas que V4 Flash funcionara en un portátil normal
Su requisito de memoria local es de clase estación de trabajo
Usa un modelo destilado R1 en su lugar a menos que tu máquina tenga aproximadamente 156GB o más de memoria del sistema.
Cuándo esta configuración es adecuada
Ejecutar DeepSeek sin conexión con LM Studio es una opción sólida cuando deseas inferencia local privada, costos predecibles después de descargar el modelo, experimentación sin claves de API, o una API localhost para desarrollo. También es útil cuando tu máquina debe seguir funcionando sin acceso a internet.
Es una opción menos adecuada cuando necesitas el modelo DeepSeek más potente disponible pero solo tienes hardware de consumo, cuando necesitas un rendimiento extremadamente alto, o cuando tu carga de trabajo depende de información web en vivo. Los modelos locales solo saben lo que está en sus pesos y el contexto que proporcionas, a menos que conectes deliberadamente herramientas externas o fuentes de datos.
Lista de verificación rápida
Usa un sistema Windows 11 que cumpla con los requisitos de LM Studio; las CPUs x64 necesitan AVX2.
Mantén el acceso a internet activado para las descargas iniciales de LM Studio, tiempo de ejecución y modelos.
Comienza con un modelo GGUF DeepSeek más pequeño, especialmente un modelo destilado de clase 8B.
Elige una cuantización de 4 bits o superior si tu hardware puede soportarlo.
Carga el modelo con éxito antes de desconectar la red.
Apaga Wi-Fi/Ethernet y ejecuta un nuevo prompt para verificar la inferencia sin conexión.
Reduce el tamaño del modelo o la longitud del contexto si encuentras errores de memoria.
Usa el servidor localhost de LM Studio solo si necesitas acceso a API local.
Conclusión
La forma más fácil de ejecutar DeepSeek sin conexión en Windows 11 es emparejar LM Studio con un modelo GGUF DeepSeek más pequeño que realmente se ajuste a tu hardware. Para un PC normal, un modelo destilado R1 de clase 8B es un punto de partida mucho más realista que DeepSeek V4 Flash. Completa las descargas mientras estás en línea, carga el modelo, desconecta la red y verifica que un nuevo chat todavía responda. Una vez que eso funcione, tienes una configuración DeepSeek genuinamente local en lugar de un envoltorio de escritorio alrededor de una API en la nube.