Inicio
» Dominios
»
Cómo crear un pipeline gratuito de reutilización de contenido con IA usando n8n y Claude (lo que realmente es gratis)
Cómo crear un pipeline gratuito de reutilización de contenido con IA usando n8n y Claude (lo que realmente es gratis)
Puedes hacer que la capa de automatización de un pipeline de reutilización de contenido con IA sea gratuita autoalojando n8n Community Edition, pero un flujo de trabajo de n8n impulsado por Claude no garantiza un costo cero de extremo a extremo. Esta distinción es importante. n8n afirma que su Community Edition autoalojada se puede usar de forma gratuita indefinidamente, mientras que la API de Claude de Anthropic es un servicio de desarrollo medido. El plan de chat gratuito de Claude en el sitio web de Claude no es lo mismo que el uso de la API dentro de n8n.
A fecha del 11 de septiembre de 2026, n8n documenta Community Edition como una edición autoalojada gratuita con casi el conjunto completo de funciones principales. El precio actual de la API de Anthropic lista Claude Sonnet 5 a $2 por millón de tokens de entrada y $10 por millón de tokens de salida, y Claude Haiku 4.5 a $1 por millón de tokens de entrada y $5 por millón de tokens de salida. Los precios y modelos pueden cambiar, así que verifícalos antes de implementar. Consulta la documentación de Community Edition de n8n y la página de precios actual de Anthropic.
Por lo tanto, la versión práctica de “gratis” es: software n8n gratuito en infraestructura que tú controlas, más cualquier uso de la API de Claude que genere tu flujo de trabajo. Si ya tienes infraestructura y créditos de API, tu costo incremental puede ser temporalmente cero. Si no, espera al menos el costo de uso del modelo y posiblemente el costo de alojamiento.
Qué hará este pipeline
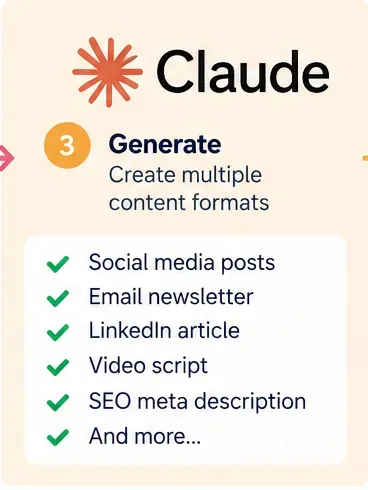
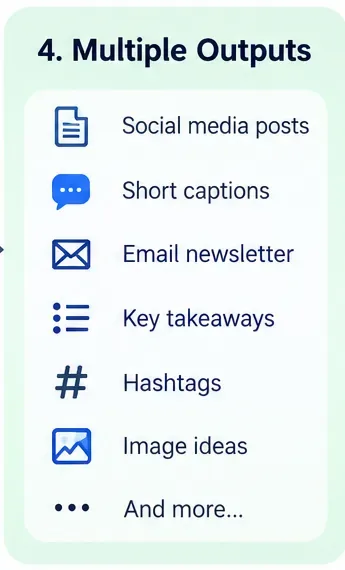
El flujo de trabajo siguiente toma un elemento de origen, como una publicación de blog, un borrador de boletín, una transcripción de podcast, una transcripción de seminario web o una nota extensa, y lo convierte en varios activos de borrador estructurados. Una salida inicial útil es:
Una publicación estilo LinkedIn
Tres publicaciones sociales cortas
Una línea de asunto de correo electrónico y una introducción
Un gancho de video corto y un guion
Cinco puntos clave
Una bandera de revisión cuando la fuente no contiene suficiente información
El pipeline produce intencionalmente borradores primero. La publicación automática se puede agregar más tarde, pero generalmente es más seguro demostrar la calidad del contenido, el formato, la fidelidad a la fuente y los permisos de destino antes de permitir que un flujo de trabajo de IA publique sin revisión.
¿Es este enfoque adecuado para ti?
Situación
Recomendación
Por qué
Reutilizas tus propios artículos o contenido de la empresa aprobado
Buena opción
La fuente está controlada y el objetivo de transformación es predecible.
Necesitas borradores consistentes para varios canales
Buena opción
n8n puede orquestar la misma transformación repetidamente.
Quieres una API de Claude permanentemente sin costo
No es adecuado como se plantea
El uso de la API de Claude se mide; el plan de chat gratuito de Claude no hace que la automatización de la API sea gratuita.
Necesitas investigación factual en vivo agregada a cada borrador
Usa una etapa separada de investigación/verificación
La reutilización no debe convertirse silenciosamente en generación de hechos.
Estás procesando páginas web no confiables o documentos de terceros
Agrega un aislamiento de entrada más fuerte y revisión
El contenido externo puede contener instrucciones que no deben controlar el flujo de trabajo.
Necesitas selección compleja de herramientas y decisiones autónomas
Considera un Agente de IA
Una Cadena LLM Básica es más simple cuando el trabajo es una transformación de texto predecible.
La arquitectura recomendada
Para una primera versión, no comiences con un agente autónomo. La Cadena LLM Básica de n8n está diseñada para pasar un prompt a un modelo de lenguaje conectado y puede adjuntar un analizador de salida. Eso es suficiente para un flujo de trabajo determinista de “fuente de entrada, borradores formateados de salida”. Consulta la documentación de la Cadena LLM Básica de n8n.
Un pipeline limpio se ve así:
Disparador → Validar entrada → Normalizar fuente → Cadena LLM Básica → Modelo de Chat de Anthropic → Analizador de Salida Estructurada → Puerta de revisión → Guardar borradores
Paso 1: Autoaloja n8n Community Edition
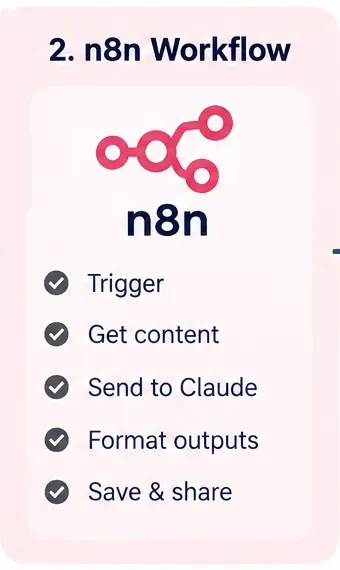
Ilustración generada por IA de una etapa de flujo de trabajo de n8n; no es una captura de pantalla real de n8n.
La documentación actual de n8n admite el autoalojamiento con Docker y describe Community Edition como gratuita. Docker es un buen punto de partida porque hace que la instancia de n8n sea fácil de reproducir y te proporciona un volumen persistente para los datos de flujo de trabajo y credenciales.
La guía oficial de Docker crea un volumen n8n_data, expone el puerto 5678, establece variables de entorno relacionadas con la zona horaria y monta el directorio de datos persistente. Para n8n 2.x, la documentación indica que N8N_RUNNERS_ENABLED está obsoleto y ya no es necesario configurarlo. Usa el comando actual de la guía de instalación de Docker de n8n en lugar de copiar un comando antiguo de un tutorial.
Para una prueba de concepto local, abrir http://localhost:5678 es suficiente. Para una instancia de producción expuesta a Internet, no expongas simplemente el puerto local públicamente. Sigue la guía de alojamiento y seguridad de n8n para HTTPS, autenticación, copias de seguridad y configuración de proxy inverso.
Usa este paso si: te sientes cómodo manteniendo tu propio host Docker. Si no quieres parchear, asegurar, hacer copias de seguridad y monitorear un servidor, n8n Cloud es más fácil, pero no es la opción permanentemente gratuita descrita aquí.
Paso 2: Elige cómo comienza el flujo de trabajo
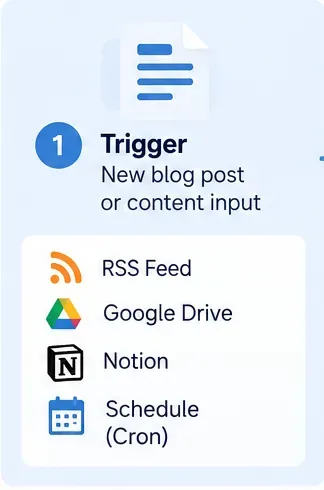
Ilustración generada por IA de posibles disparadores de flujo de trabajo y fuentes de contenido; la disponibilidad y configuración reales de los nodos de n8n deben verificarse en tu instancia.
Usa un Webhook cuando otra aplicación deba enviar contenido a n8n bajo demanda. Usa un Disparador de Programación cuando n8n deba buscar contenido en un momento fijo o intervalo.
El nodo Webhook de n8n proporciona URLs de prueba y de producción separadas. La URL de prueba está diseñada para el desarrollo; la URL de producción se registra cuando se publica el flujo de trabajo. El nodo Webhook también admite opciones de autenticación, incluida la autenticación básica, la autenticación de encabezado y la autenticación JWT. Consulta la documentación de Webhook de n8n.
Para la reutilización programada, el Disparador de Programación de n8n se ejecuta en momentos o intervalos fijos, y n8n establece que el flujo de trabajo debe guardarse y publicarse para que la programación funcione. Consulta la documentación del Disparador de Programación de n8n.
Ejemplo: si tu CMS puede llamar a un webhook después de que un editor aprueba un artículo, usa el webhook. Si mantienes contenido de origen aprobado en una carpeta y quieres un lote cada mañana de día laborable, una programación puede ser más simple.
Paso 3: Define un contrato de entrada limpio
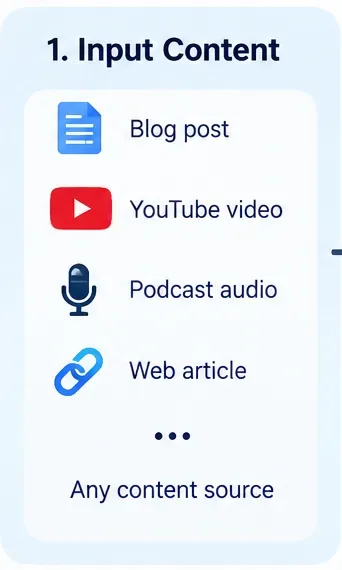
Ilustración generada por IA de tipos de contenido de origen que pueden alimentar un flujo de trabajo de reutilización; no representa una pantalla real de n8n.
No dejes que cada fuente llegue en una forma diferente. Normaliza las entradas a una estructura interna antes de llamar a Claude. Una carga útil JSON práctica es:
{
  "source_id": "post-2026-0911-001",
  "title": "Título del artículo original",
  "source_text": "Texto de origen aprobado completo...",
  "source_url": "https://example.com/original",
  "audience": "Propietarios de pequeñas empresas en EE. UU.",
  "brand_voice": "claro, práctico, sin exageraciones",
  "outputs": [
    "linkedin_post",
    "short_posts",
    "email_intro",
    "video_script"
  ]
}
Pasa el texto de origen real siempre que sea práctico. Una URL por sí sola no es lo mismo que contenido de origen verificado. Obtener y analizar una página agrega otro punto de falla y puede introducir navegación, cookies, publicidad o texto no relacionado en el prompt.
También mantén las instrucciones separadas del material de origen. Si ingieres páginas de terceros, correos electrónicos o documentos subidos, trata sus contenidos como datos no confiables en lugar de comandos de flujo de trabajo. La guía de seguridad de Anthropic describe explícitamente la inyección de prompt indirecta como instrucciones maliciosas incrustadas en el contenido que lee el modelo. Consulta la guía de mitigación de inyección de prompt de Anthropic.
Paso 4: Valida y normaliza antes de la llamada al modelo
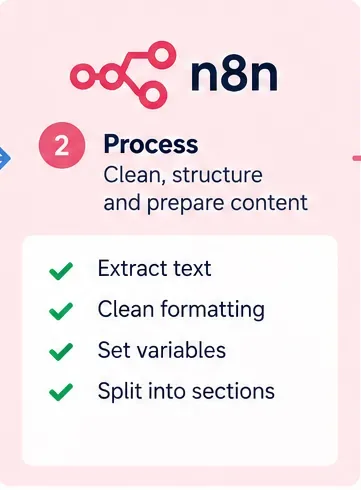
Ilustración generada por IA de una etapa de preprocesamiento; no es una captura de pantalla real del flujo de trabajo de n8n.
Antes de gastar tokens, rechaza entradas incorrectas. Como mínimo, verifica que source_id, title y source_text existan y que source_text no esté vacío. Normaliza el ruido de formato obvio, pero preserva hechos, citas, URLs, encabezados y otros detalles de la fuente que Claude pueda necesitar.
Una etapa de preprocesamiento útil puede:
Recortar espacios en blanco iniciales y finales
Convertir líneas en blanco repetidas a un formato consistente
Establecer valores predeterminados de audiencia y voz
Rechazar texto de origen por debajo de una longitud útil mínima
Crear un source_id estable para la deduplicación
Registrar los tipos de salida solicitados
No dividas un artículo normal en muchas llamadas al modelo a menos que realmente lo necesites. Múltiples llamadas aumentan la complejidad de la orquestación y pueden producir un tono inconsistente. Para material de origen grande, considera resumir o dividir deliberadamente en lugar de truncar accidentalmente la entrada.
Paso 5: Conecta Claude correctamente y entiende el costo
Ilustración generada por IA del rol de Claude en el flujo de trabajo; no es una captura de pantalla de la Consola de Anthropic ni de n8n.
n8n proporciona un nodo Modelo de Chat de Anthropic y credenciales de Anthropic que usan una clave API. La documentación de credenciales de n8n dirige a los usuarios a crear una clave en la Consola de Anthropic y almacenarla en la credencial de n8n en lugar de codificarla rígidamente en el texto del flujo de trabajo. Consulta la documentación de credenciales de Anthropic de n8n y la documentación del Modelo de Chat de Anthropic de n8n.
Para este pipeline, conecta el Modelo de Chat de Anthropic a una Cadena LLM Básica. Una elección práctica de modelo depende de tu objetivo de calidad y costo:
Elección de modelo
Cuándo tiene sentido
Precio actual de la API verificado el 11 de sep. de 2026
Claude Haiku 4.5
Reescrituras simples y borradores iniciales de alto volumen
$1/MTok de entrada; $5/MTok de salida
Claude Sonnet 5
Predeterminado más fuerte para reutilización matizada de múltiples formatos
$2/MTok de entrada; $10/MTok de salida
Claude Opus 5
Solo cuando la tarea realmente necesita un razonamiento más profundo
$5/MTok de entrada; $25/MTok de salida
Los precios anteriores provienen de la página de precios actual de Anthropic y pueden cambiar. También evita copiar IDs de modelos antiguos de tutoriales antiguos. Anthropic mantiene una página de descontinuación de modelos porque los modelos se descontinúan y retiran periódicamente. Consulta la documentación de descontinuación de modelos de Anthropic antes de codificar rígidamente un nombre de modelo.
Paso 6: Usa un prompt que preserve la fidelidad a la fuente
Ilustración generada por IA de generación de contenido de múltiples formatos; las salidas listadas son ejemplos, no características garantizadas del producto.
El prompt debe hacer explícito el límite de la transformación: Claude puede reformular y comprimir la fuente, pero no debe inventar hechos que no estén presentes. La guía actual de prompts de Anthropic recomienda instrucciones claras y etiquetas estructuradas para entradas complejas. Consulta la documentación de mejores prácticas de prompts de Anthropic.
Un mensaje de sistema práctico es:
Eres un editor de reutilización de contenido.
Usa solo afirmaciones factuales respaldadas por la fuente suministrada.
No inventes estadísticas, citas, resultados de clientes, fechas o capacidades de productos.
Preserva el significado original mientras adaptas el formato y el tono.
Si una salida requiere información no presente en la fuente, establece needs_review en true
y explica la información faltante en review_notes.
Devuelve solo los campos estructurados solicitados.
Luego construye el mensaje de usuario desde las expresiones de n8n:
Ejemplo: si la fuente dice que un producto se lanzó en mayo pero nunca da números de clientes, Claude puede convertir el hecho del lanzamiento en una publicación más corta, pero no debe agregar “10,000 clientes” para hacer que la publicación suene más fuerte.
Paso 7: Fuerza la salida estructurada en lugar de analizar prosa
Ilustración generada por IA de salidas de contenido estructurado; no es una captura de pantalla de la respuesta de la API de Claude.
El texto libre es difícil de enrutar. Si Claude devuelve encabezados que cambian de una ejecución a la siguiente, los nodos posteriores se vuelven frágiles. El Analizador de Salida Estructurada de n8n puede devolver campos basados en un JSON Schema, y la Cadena LLM Básica puede requerir un formato de salida específico. Consulta la documentación del Analizador de Salida Estructurada de n8n.
Si eliges llamar a la API de Mensajes de Claude directamente con el nodo de Solicitud HTTP de n8n en lugar de usar la integración del Modelo de Chat de Anthropic, Anthropic también admite salidas estructuradas nativas a través de output_config.format en modelos compatibles. Consulta la documentación de Salidas Estructuradas de Anthropic y la referencia de la API de Mensajes de Claude.
Paso 8: Guarda borradores, revísalos y luego automatiza la publicación
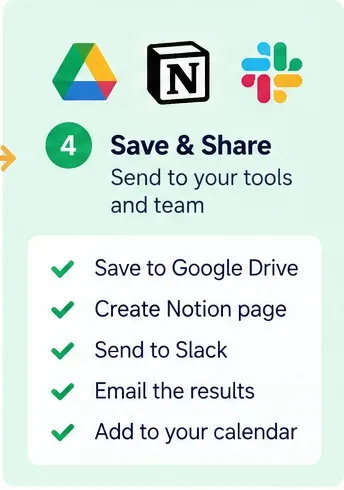
Ilustración generada por IA de destinos de borradores; no es una captura de pantalla de una integración en vivo ni una prueba de que alguna cuenta esté conectada.
Para la primera versión de producción, almacena los campos generados en una ubicación de revisión en lugar de enviarlos directamente a canales públicos. Los destinos comunes incluyen una base de datos, Google Drive, Google Sheets, Notion, un borrador de CMS o un mensaje de revisión interno.
Usa needs_review como una puerta estricta. También considera un paso de revisión humana para cualquier cosa que envíe un mensaje externo o cambie un sistema de producción. n8n actualmente admite la aprobación humana en el bucle para llamadas de herramientas de IA, donde un revisor puede aprobar o denegar acciones seleccionadas. Consulta la documentación de humano en el bucle de n8n.
Despliegue recomendado:
Semana 1: genera solo borradores.
Semana 2: compara las salidas con la fuente y corrige fallos de prompt/esquema.
Semana 3: permite que los borradores aprobados se muevan automáticamente a carpetas de borradores de destino.
Solo después de que el flujo de trabajo sea estable: considera la publicación automática para formatos de bajo riesgo.
Un flujo de trabajo n8n concreto de extremo a extremo
Para una versión simple impulsada por webhook, crea estos nodos en orden:
#
Nodo
Propósito
1
Webhook
Recibir el elemento de origen aprobado.
2
Editar Campos / Código
Normalizar nombres de campos y valores predeterminados.
3
Si
Rechazar texto de origen faltante o vacío.
4
Cadena LLM Básica
Contener las instrucciones de reutilización y el contenido de origen dinámico.
5
Modelo de Chat de Anthropic
Generar los borradores reutilizados.
6
Analizador de Salida Estructurada
Aplicar campos JSON estables.
7
Si
Enrutar needs_review=true a revisión manual.
8
Nodo de destino
Guardar la salida aprobada como borradores.
9
Responder al Webhook
Devolver el estado y el ID de registro generado al llamador.
Si prefieres un pipeline programado, reemplaza el Webhook con un Disparador de Programación y agrega un nodo de fuente que recupere elementos aprobados no procesados.
Cómo evitar reutilizar la misma fuente dos veces
Agrega un source_id inmutable a cada elemento y almacena los IDs procesados. Antes de que se ejecute Claude, verifica si ese ID ya se ha completado con éxito. Esta es la idempotencia básica: repetir el mismo disparador no debe crear borradores duplicados a menos que solicites explícitamente una nueva versión.
Para revisiones, usa una clave compuesta como source_id + source_revision. Eso permite que la versión 2 de un artículo genere nuevos borradores sin pretender que es la misma fuente que la versión 1.
Cómo reducir el costo de la API de Claude
La elección del modelo es solo una palanca. El mayor costo evitable suele ser enviar texto innecesario o generar salidas innecesariamente largas.
Elimina la navegación, el texto estándar y el HTML no relacionado antes de la llamada al modelo.
Solicita solo los formatos que realmente necesitas.
Establece restricciones de longitud de salida razonables en el prompt.
Usa Haiku 4.5 para transformaciones simples de alto volumen cuando la calidad sea suficiente.
Usa Sonnet 5 cuando la fuente requiera más matiz o una adaptación más fuerte entre formatos.
No envíes la misma guía de marca larga en cada llamada si puedes representarla con instrucciones estables concisas.
Mide el uso de tokens y el costo en lugar de asumir que un flujo de trabajo corto es barato.
Anthropic también ofrece almacenamiento en caché de prompts y procesamiento por lotes para cargas de trabajo aplicables, pero esas características tienen sus propios requisitos y precios. No las agregues al primer flujo de trabajo a menos que el contexto repetido o el procesamiento de alto volumen no urgente haga que la complejidad adicional valga la pena.
Tres modos de falla para probar antes de publicar
1. Hechos alucinados
Alimenta el flujo de trabajo con una fuente que omita intencionalmente una estadística. El comportamiento esperado es que la salida no invente una. Si lo hace, fortalece las instrucciones de fidelidad a la fuente y la puerta de revisión.
2. Salida estructurada rota
Prueba cada campo requerido, matrices vacías, texto de origen inusualmente largo y caracteres especiales. Un pipeline no es confiable simplemente porque una salida de demostración atractiva pareció correcta.
3. Ejecuciones duplicadas
Envía el mismo source_id dos veces. La segunda ejecución debe detenerse, actualizar el registro existente o crear intencionalmente una revisión según tu diseño, no duplicar silenciosamente cada borrador.
¿Necesitas un Agente de IA para esto?
Generalmente, no. Un Agente de IA es útil cuando el modelo debe decidir qué herramientas llamar o tomar diferentes acciones basadas en un objetivo abierto. La reutilización de contenido es normalmente una transformación predecible, por lo que una cadena es más fácil de inspeccionar, probar y controlar.
Muévete a un agente solo cuando tengas una necesidad concreta como elegir dinámicamente herramientas de investigación, decidir qué destino recibe un borrador o pedir a un humano información faltante. Incluso entonces, mantén las acciones de publicación irreversibles detrás de una revisión explícita hasta que el flujo de trabajo esté bien probado.
Lista de verificación final de construcción
Autoaloja n8n Community Edition si quieres que la capa de software n8n permanezca gratuita.
No describas el uso de la API de Claude como permanentemente gratuito.
Usa un Webhook para procesamiento bajo demanda o un Disparador de Programación para lotes temporizados.
Normaliza cada fuente en un contrato de entrada.
Pasa el texto de origen, no solo una URL.
Almacena la clave API de Anthropic en las credenciales de n8n.
Usa un modelo Claude activo y revisa la página de descontinuación periódicamente.
Usa una Cadena LLM Básica para reutilización predecible.
Requiere un esquema de salida estructurada.
Agrega needs_review y notas de revisión al esquema.
Deduplica con un ID de fuente estable.
Guarda borradores antes de habilitar la publicación automática.
Prueba alucinaciones, entradas malformadas, disparadores duplicados y rutas de falla.
Monitorea el uso de tokens y los costos de servicios externos.
La mejor primera versión es deliberadamente aburrida: una entrada limpia, una llamada controlada a Claude, una respuesta JSON validada y un destino de borrador. Esa arquitectura es fácil de depurar y barata de operar. Una vez que funcione de manera confiable con material de origen real, puedes agregar más canales, programación, aprobaciones humanas, análisis o integraciones de publicación sin reconstruir el pipeline central.