Reducir la factura de una API de LLM en un 50% es posible en muchas cargas de trabajo, pero no es una garantía universal. El resultado depende de dónde proviene su gasto: tokens de entrada sin caché, tokens de entrada con caché, tokens de salida, tokens de razonamiento, llamadas a herramientas o reintentos. La compresión de prompts funciona mejor cuando las entradas largas o repetitivas representan una parte significativa de la factura. Por lo tanto, el objetivo práctico no es "hacer que cada prompt sea la mitad de largo". Es "eliminar los tokens que no cambian la respuesta, preservar los tokens que sí lo hacen y verificar los ahorros en tráfico real".
Esta guía utiliza cuatro pasos de implementación: medir la línea base, eliminar la redundancia de entrada, organizar los prompts para la reutilización de la caché y mover las instrucciones de salida verbosas a controles estructurados donde la API los admita. Los ejemplos son ilustrativos y no afirmaciones de referencia. Los precios de los proveedores y el comportamiento de la caché cambian con el tiempo, por lo que verifique las tarifas actuales antes de realizar una estimación de producción.
¿Qué requiere realmente una reducción del 50% en los costos de la API?
Comience con la ecuación de facturación de su modelo. Para una carga de trabajo de texto simple, el costo total de la solicitud es aproximadamente el costo de la entrada sin caché más la entrada con caché más la salida. Algunos modelos o funciones agregan otras categorías facturables. Las respuestas actuales de la API de OpenAI exponen el uso de tokens de entrada y salida, incluidos los detalles de los tokens con caché, y sus páginas de modelos publican tarifas separadas para la entrada, la entrada con caché y la salida.
| Carga de trabajo ilustrativa | Tokens de entrada | Tokens de salida | Resultado relativo |
|---|
| Solicitud de línea base | 10,000 | 1,000 | 100% del costo de línea base |
| Solo se reduce la entrada a la mitad | 5,000 | 1,000 | Menos del 50% de ahorro total cuando la salida permanece sin cambios |
| Se reduce tanto la entrada como la salida a la mitad | 5,000 | 500 | Aproximadamente un 50% menos de costo basado en tokens cuando las tarifas permanecen sin cambios |
Para un ejemplo concreto actual, la página oficial del modelo GPT-5.6 Sol listaba, el 11 de septiembre de 2026, $4 por millón de tokens de entrada, $0.40 por millón de tokens de entrada con caché y $20 por millón de tokens de salida. A esas tarifas, una solicitud de 10,000 de entrada/1,000 de salida cuesta aproximadamente $0.06 antes de otras tarifas. Reducir solo la entrada a 5,000 tokens lleva ese ejemplo a aproximadamente $0.04, una reducción del 33%. Reducir tanto la entrada como la salida a la mitad lo lleva a aproximadamente $0.03, una reducción del 50%. Estos precios pueden cambiar, así que trate la aritmética como un método, no como una cotización permanente. Consulte la página oficial del modelo GPT-5.6 Sol para ver los precios actuales.
Referencia rápida: las cuatro acciones de mayor valor
| Técnica | Mejor ajuste | Riesgo principal | Qué medir |
|---|
| Auditoría de tokens | Cualquier carga de trabajo de producción | Optimizar el componente incorrecto | Entrada, entrada con caché, salida, reintentos, costo por tarea exitosa |
| Eliminación de redundancia | Prompts de sistema largos, políticas repetidas, ejemplos verbosos | Eliminar una restricción que realmente importa | Éxito de la tarea y paridad en el seguimiento de instrucciones |
| Diseño amigable con la caché | Solicitudes repetidas que comparten instrucciones o contexto estables | Baja reutilización de la caché porque el texto dinámico aparece demasiado pronto | Proporción de tokens con caché y latencia |
| Controles de salida estructurada | Extracción JSON, clasificación, formatos de respuesta fijos | Esquema demasiado rígido para la tarea | Tokens de salida, fallos de análisis, reintentos |
Paso 1: Medir la línea base real de tokens antes de cambiar los prompts
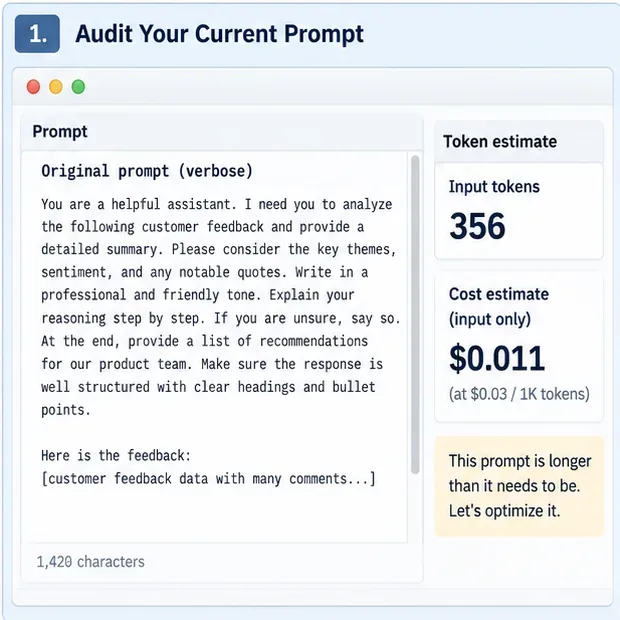
Leyenda: Una interfaz ilustrativa de auditoría de tokens registra el tamaño original del prompt y una estimación de costos de muestra antes de la compresión; las cifras no son los precios actuales del proveedor.
Recopile una muestra representativa de solicitudes de producción en lugar de optimizar un prompt seleccionado a mano. Como mínimo, registre los tokens de entrada, los tokens de entrada con caché cuando estén disponibles, los tokens de salida, el nombre del modelo, la latencia, los reintentos y si la respuesta final pasó su verificación de calidad empresarial. Si su proveedor ofrece un punto final de conteo de tokens de entrada, úselo antes de enviar solicitudes cuando necesite una presupuestación determinista. OpenAI documenta actualmente un punto final de conteo de tokens de entrada de Responses en su referencia oficial de la API.
Calcule el costo por tarea exitosa, no solo el costo por llamada a la API. Un prompt comprimido que cause más reintentos puede ser más caro incluso si cada solicitud es más corta. Segmente también la línea base por tipo de tarea: resumen, extracción, respuesta a preguntas RAG, uso de herramientas agénticas y conversaciones largas suelen tener perfiles de tokens diferentes.
Paso 2: Eliminar la redundancia sin borrar información crítica para la decisión

Leyenda: Un prompt ilustrativo de antes y después mantiene las mismas salidas solicitadas mientras elimina el lenguaje repetido y las instrucciones de proceso innecesarias.
La primera pasada de compresión más segura es la deduplicación semántica. Elimine descripciones de roles repetidas, restricciones duplicadas, relleno educado, explicaciones de formatos obvios y ejemplos que enseñan el mismo patrón más de una vez. Fusione reglas superpuestas en una sola instrucción. Prefiera una oración precisa sobre varias oraciones que reiteran el mismo requisito.
Antes
Eres un asistente útil que es un experto en análisis de productos.
Necesito que analices los siguientes comentarios de clientes y proporciones
un resumen detallado. Por favor, identifica los temas clave, el sentimiento general,
citas notables y recomendaciones para nuestro equipo de producto. Asegúrate
de que tu respuesta sea profesional, clara, concisa y bien estructurada.
Después
Analiza los comentarios de los clientes.
Devuelve: temas clave, sentimiento general, citas notables y recomendaciones de producto.
Sé conciso y factual.
No comprima excepciones, límites de políticas, definiciones de dominio, reglas de seguridad de herramientas o requisitos de evidencia simplemente porque son largos. Esos suelen ser tokens de alto valor. Una prueba útil es preguntar: "Si elimino esta oración, ¿puede cambiar la salida aceptable?" Si es así, manténgala a menos que un control de API o un esquema puedan imponer el mismo comportamiento de manera más confiable.
Paso 3: Poner el contenido estable primero y el contenido dinámico al final
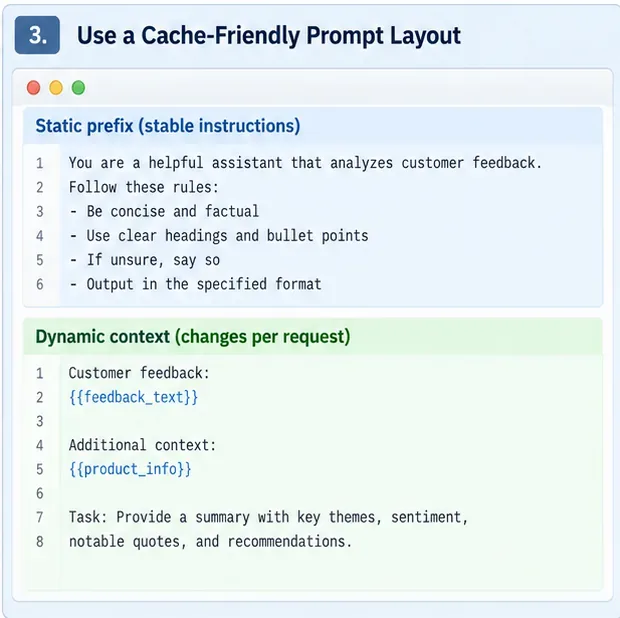
Leyenda: Un diseño de prompt ilustrativo coloca instrucciones estables en un prefijo reutilizable y añade el contexto específico de la solicitud más tarde.
El almacenamiento en caché de prompts no reduce el recuento bruto de tokens, pero puede reducir la cantidad facturada a la tarifa normal de entrada y disminuir la latencia de procesamiento del prompt. Esto hace que el diseño del prompt sea parte de la optimización de costos. Agrupe las instrucciones del sistema, los ejemplos compartidos, la guía de herramientas y otro contenido estable juntos. Ponga los hechos específicos de la solicitud, los pasajes recuperados, los datos del usuario y la pregunta actual más tarde.
La guía del modelo de OpenAI recomienda explícitamente poner el contenido estático primero y el contenido dinámico al final para mejorar la reutilización de la caché de prompts, y su objeto de uso de respuestas expone información de tokens con caché para la medición. Consulte la guía oficial del modelo y la referencia de la API de Responses.
Evite cambiar espacios en blanco inofensivos, el orden de los ejemplos, marcas de tiempo, IDs aleatorios o texto por usuario dentro de un prefijo por lo demás reutilizable, a menos que la semántica de caché del proveedor indique que esos cambios son seguros. Mida los aciertos de caché desde la respuesta de la API en lugar de asumir que un prompt se está reutilizando.
Paso 4: Reemplazar la prosa sobre el formato con controles de salida estructurada
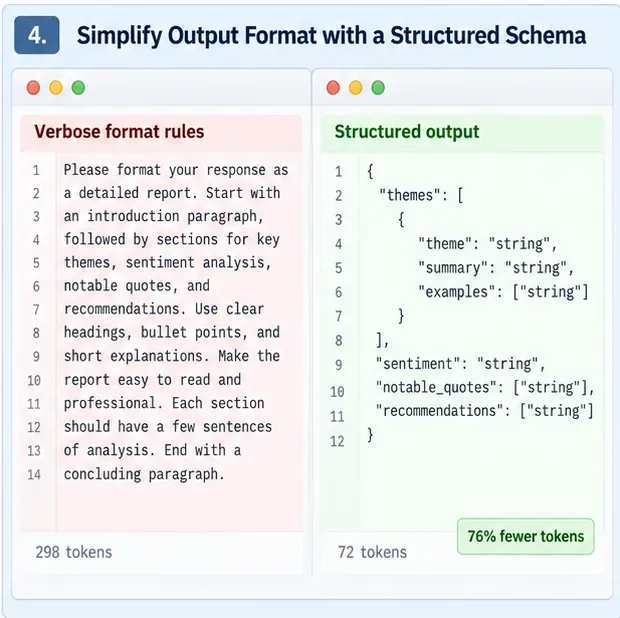
Leyenda: Una vista ilustrativa de salida estructurada muestra cómo un esquema puede reemplazar muchas líneas de prosa que describen repetidamente la misma forma de respuesta.
Los prompts de extracción y clasificación a menudo desperdician tokens describiendo campos JSON, valores permitidos, anidamiento, orden y reglas de validación en lenguaje natural. Cuando la API admite salidas estructuradas o argumentos de herramientas tipados, mueva tanto de ese contrato como sea posible a la interfaz estructurada y mantenga la instrucción en lenguaje natural enfocada en el significado.
La guía actual de OpenAI recomienda específicamente eliminar las definiciones de esquema de salida del prompt cuando sea posible y usar Salidas Estructuradas en su lugar. Esto puede reducir el texto del prompt y también reducir los reintentos por salida mal formada. El mecanismo exacto varía según el proveedor, así que no copie un formato de solicitud específico de OpenAI en otra API sin verificar la documentación de ese proveedor.
Compresión avanzada para RAG, documentos largos y conversaciones
Después de que los cuatro pasos básicos sean estables, los ahorros más grandes suelen provenir de reducir el contexto en lugar de pulir la redacción de las oraciones. En los sistemas RAG, recupere menos pasajes pero más relevantes, deduplique fragmentos casi idénticos y evite adjuntar documentos que no puedan afectar la respuesta. Para conversaciones largas, mantenga hechos duraderos y decisiones no resueltas, pero resuma o elimine turnos que ya no influyen en la tarea actual. Para sistemas de agentes, exponga solo las herramientas y descripciones de herramientas relevantes para la etapa actual cuando su arquitectura lo permita de manera segura.
Los compresores de prompts aprendidos son otra opción para contextos muy largos. El proyecto de código abierto de Microsoft, LLMLingua, implementa la compresión de prompts a nivel de token. El artículo original de LLMLingua informó ratios de compresión de hasta 20× con una degradación limitada de la referencia en sus entornos evaluados. LongLLMLingua se dirige a tareas de contexto largo, mientras que LLMLingua-2 utiliza un compresor aprendido agnóstico a la tarea. Esos son resultados de investigación, no una promesa de que los mismos ratios preservarán la calidad en sus datos. Realice pruebas de referencia en sus propias tareas, idiomas, modelos y tipos de prompts antes de implementar una compresión agresiva.
Cómo demostrar que la optimización es realmente mejor
Ejecute una evaluación A/B en las mismas solicitudes representativas. Las versiones de línea base y comprimidas deben usar el mismo modelo, configuraciones de razonamiento, herramientas, entradas de recuperación y criterios de éxito. Cambie una técnica de compresión a la vez cuando sea posible para que pueda identificar qué causó una regresión.
| Métrica | Por qué importa | Interpretación sugerida |
|---|
| Reducción de tokens de entrada | Muestra la reducción bruta del prompt | Útil, pero no suficiente por sí sola |
| Proporción de tokens con caché | Muestra si los prefijos estables se reutilizan | Más alto suele ser mejor cuando la calidad permanece sin cambios |
| Reducción de tokens de salida | Puede cambiar materialmente el costo total | Verifique que la salida concisa aún complete la tarea |
| Costo por tarea exitosa | Incluye reintentos y fallos | Esta es la métrica empresarial principal |
| Éxito de la tarea / precisión | Detecta la pérdida de información | Establezca un umbral de no inferioridad aceptable antes de probar |
| Latencia p50 y p95 | Muestra el impacto real en el usuario | El preprocesamiento de compresión puede compensar los ahorros de inferencia |
No declare la victoria porque un prompt sea un 50% más corto. La condición de aceptación más fuerte es: la configuración comprimida reduce el costo medido aproximadamente en su objetivo mientras permanece dentro de sus tolerancias predefinidas de calidad, latencia y confiabilidad.
¿Cuándo debe dejar de comprimir?
Deténgase o retroceda cuando la siguiente reducción elimine hechos necesarios para decisiones correctas, aumente las alucinaciones, cause errores en las llamadas a herramientas, debilite el cumplimiento de políticas o aumente los reintentos lo suficiente como para borrar los ahorros. La compresión también puede agregar latencia si ejecuta un modelo separado para comprimir cada prompt. Un estudio de 2026 sobre la compresión de prompts en entornos de inferencia del mundo real encontró que la sobrecarga de preprocesamiento puede cancelar las ganancias de inferencia fuera de regímenes favorables de longitud de prompt y hardware, lo que es otra razón para medir el rendimiento de extremo a extremo en lugar de solo el recuento de tokens.
Para prompts pequeños, la limpieza manual y la organización amigable con la caché suelen ser más fáciles de justificar que agregar un modelo de compresión dedicado. Para cargas útiles RAG grandes o flujos de trabajo de múltiples documentos, la selección de contexto y la compresión aprendida se vuelven más atractivas porque el volumen de tokens removibles es mucho mayor.
Lista de verificación rápida de implementación
- Capture una línea base de producción con entrada, entrada con caché, salida, latencia, reintentos y éxito de la tarea.
- Elimine primero instrucciones duplicadas, prosa de bajo valor y ejemplos redundantes.
- Preserve definiciones de dominio, excepciones, requisitos de evidencia y restricciones de seguridad.
- Ponga el contenido estable del prompt antes del contenido dinámico específico de la solicitud cuando la semántica de caché recompense los prefijos reutilizables.
- Use salidas estructuradas o esquemas de herramientas en lugar de describir repetidamente formatos de respuesta fijos en prosa.
- Para RAG, reduzca el contexto irrelevante y duplicado antes de intentar la compresión a nivel de token.
- Limite la longitud de la salida solo cuando la tarea aún pueda completarse correctamente.
- Compare el costo por tarea exitosa, no solo el recuento de tokens del prompt.
- Ejecute pruebas de regresión antes y después de cada cambio significativo de compresión.
- Revise los precios del proveedor y las reglas de caché cada vez que cambie de modelos o versiones de API.
Conclusión
Una reducción del 50% es un objetivo de ingeniería razonable para algunas cargas de trabajo verbosas y con mucho contexto, pero debe tratarse como un resultado a validar, no como una expectativa predeterminada. La ruta más confiable es medir primero, eliminar texto semánticamente redundante, maximizar la reutilización segura de la caché, acortar los contratos de salida con controles estructurados y luego atacar los bloques de contexto restantes más grandes con poda de recuperación, resumen o un compresor de prompts probado. Si el costo final por tarea exitosa disminuye mientras la calidad permanece dentro de su banda de aceptación, la compresión está funcionando. Si la calidad o los reintentos se deterioran, restaure la información faltante y optimice una parte diferente de la solicitud.
Referencias principales








